正则表达式
发布于 2026-04-06更新于 2026-11-141475 字16 分钟 · 阅读时间
2024-12-4 ~ 2024-12-11(这玩意居然被我拖了一周……)
就是一种规则,用于匹配文本
几乎所有现代编程语言都支持正则表达式,方式可能略有不同。
常见缩写为 regex 或 RegExp
和通配符的区别:
就是两种不同的字符匹配规则。通配符较简单,正则较全面。在规则上,通配符大多相当于正则表达式的子集,
在 JS 中 正则表达式通过以下两种方式表述,因此下述的表格等都用两个斜杠来表示它是一个正则表达式
var re = /ab+c/;var re = new RegExp("ab+c");| 字符 | 含义 | |
|---|---|---|
\ |
转义字符,用于匹配一些保留的字符[](){}.*+?^$|本身是特殊字符会转义成字面意思,本身不是特殊字符,但有特殊意思的会转义成特殊字符如:\$与\n== |
|
^ |
从开始行开始匹配匹配输入字符串开始的位置 | |
$ |
从末端开始匹配 匹配输入字符串结尾的位置 | |
* |
匹配前面的子表达式零次或多次。例如,zo* 能匹配 "z" 以及 "zoo"。* 等价于 {0,}。 | |
+ |
匹配前面的子表达式一次或多次。例如,zo+ 能匹配 "zo" 以及 "zoo",但不能匹配 "z"。+ 等价于 {1,}。 | |
? |
匹配前面的子表达式零次或一次。例如,do(es)? 可以匹配 "do" 、 "does"、 "doxy" 中的 "do" 和 "does"。? 等价于 {0,1}。 * 和 + 限定符都是贪婪的,因为它们会尽可能多的匹配文字,只有在它们的后面加上一个 ? 就可以实现非贪婪或最小匹配,比如 <h1>这是一个h1大小的标题</h1> ,使用 <.*> 匹配==<h1>RUNOOB-菜鸟教程<h1>==使用<.*?> 匹配 <h1>RUNOOB-菜鸟教程<h1> |
|
. |
匹配除换行符(\n)之外的任何单个字符,相等于 [^\n] |
|
(x) |
像下面的例子展示的那样,它会匹配 'x' 并且记住匹配项。其中括号被称为捕获括号。模式 /(foo) (bar) \1 \2/ 中的 '(foo)' 和 '(bar)' 匹配并记住字符串 "foo bar foo bar" 中前两个单词。模式中的 \1 和 \2 表示第一个和第二个被捕获括号匹配的子字符串,即 foo 和 bar,匹配了原字符串中的后两个单词。注意 \1、\2、...、\n 是用在正则表达式的匹配环节,详情可以参阅后文的 \n 条目。而在正则表达式的替换环节,则要使用像$1、$2、...、$n 这样的语法,例如,'bar foo'.replace(/(...) (...)/, '$2 $1')。$& 表示整个用于匹配的原字符串。 |
|
(?:x) |
匹配 'x' 但是不记住匹配项。这种括号叫作非捕获括号,使得你能够定义与正则表达式运算符一起使用的子表达式。看看这个例子 /(?:foo){1,2}/。如果表达式是 /foo{1,2}/,{1,2} 将只应用于 'foo' 的最后一个字符 'o'。如果使用非捕获括号,则 {1,2} 会应用于整个 'foo' 单词。更多信息,可以参阅下文的 [使用括号的子字符串匹配` 条目。 |
|
x(?=y) |
匹配'x'仅仅当'x'后面跟着'y'.这种叫做先行断言。例如,/Jack(?=Sprat)/会匹配到'Jack'仅当它后面跟着'Sprat'。/Jack(?=Sprat|Frost)/匹配‘Jack’仅当它后面跟着'Sprat'或者是‘Frost’。但是‘Sprat’和‘Frost’都不是匹配结果的一部分。 |
|
(?<=y)x |
匹配'x'仅当'x'前面是'y'.这种叫做后行断言。例如,/(?<=Jack)Sprat/会匹配到' Sprat '仅仅当它前面是' Jack '。/(?<=Jack|Tom)Sprat/匹配‘Sprat ’仅仅当它前面是'Jack'或者是‘Tom’。但是‘Jack’和‘Tom’都不是匹配结果的一部分。 | |
x(?!y) |
仅仅当'x'后面不跟着'y'时匹配'x',这被称为正向否定查找。例如,仅仅当这个数字后面没有跟小数点的时候,/\d+(?!.)/ 匹配一个数字。正则表达式/\d+(?!.)/.exec("3.141") 匹配‘141’而不是‘3.141’ | |
(?<!*y*)*x* |
仅仅当'x'前面不是'y'时匹配'x',这被称为反向否定查找。例如,仅仅当这个数字前面没有负号的时候,/(?<!-)\d+/ 匹配一个数字。 /(?<!-)\d+/.exec('3') 匹配到 "3". /(?<!-)\d+/.exec('-3') 因为这个数字前有负号,所以没有匹配到。 |
|
| `x | y` | 匹配‘x’或者‘y’。例如,/green|red/匹配“green apple”中的‘green’和“red apple”中的‘red’ |
{n} |
n 是一个非负整数,匹配了前面一个字符刚好出现了 n 次。 数学的 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲n,n]比如, /a{2}/ 不会匹配“candy”中的'a',但是会匹配“caandy”中所有的 a,以及“caaandy”中的前两个'a'。 | |
{n,} |
n 是一个非负整数,匹配前一个字符至少出现了 n 次。数学的 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲n,+∞)例如,/a{2,}/ 匹配 "aa", "aaaa" 和 "aaaaa" 但是不匹配 "a"。 | |
{n,m} |
n 和 m 都是整数。匹配前面的字符至少 n 次,最多 m 次。数学的 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲n,m]如果 n 或者 m 的值是 0,这个值被忽略。例如,/a{1, 3}/ 并不匹配“cndy”中的任意字符,匹配“candy”中的 a,匹配“caandy”中的前两个 a,也匹配“caaaaaaandy”中的前三个 a。注意,当匹配”caaaaaaandy“时,匹配的值是“aaa”,即使原始的字符串中有更多的 a。 | |
[xyz] |
一个字符集合。匹配方括号中的任意字符,包括转义序列。你可以使用破折号(-)来指定一个字符范围。对于点(.)和星号(*)这样的特殊符号在一个字符集中没有特殊的意义。他们不必进行转义,不过转义也是起作用的。 例如,[abcd] 和 [a-d] 是一样的。他们都匹配"brisket"中的‘b’,也都匹配“city”中的‘c’。/[a-z.]+/ 和/[\w.]+/与字符串“test.i.ng”匹配。 | |
[^xyz] |
一个反向字符集。也就是说, 它匹配任何没有包含在方括号中的字符。你可以使用破折号(-)来指定一个字符范围。任何普通字符在这里都是起作用的。例如,[^abc] 和 [^a-c] 是一样的。他们匹配"brisket"中的‘r’,也匹配“chop”中的‘h’。 |
|
[a-z] |
字符范围。匹配指定范围内的任意字符。例如,'[a-z]' 可以匹配 'a' 到 'z' 范围内的任意小写字母字符。(用连字号可以表示一个字符的范围) | |
[^a-z] |
负值字符范围。匹配任何不在指定范围内的任意字符。例如,'[^a-z]' 可以匹配任何不在 'a' 到 'z' 范围内的任意字符。 |
|
[\b] |
匹配一个退格 (U+0008)。(不要和\b 混淆了。) | |
\b |
匹配一个词的边界。一个词的边界就是一个词不被另外一个“字”字符跟随的位置或者前面跟其他“字”字符的位置,例如在字母和空格之间。注意,匹配中不包括匹配的字边界。换句话说,一个匹配的词的边界的内容的长度是 0。(不要和 [\b] 混淆了)使用"moon"举例: /\bm/匹配“moon”中的‘m’; /oo\b/并不匹配"moon"中的'oo',因为'oo'被一个“字”字符'n'紧跟着。 /oon\b/匹配"moon"中的'oon',因为'oon'是这个字符串的结束部分。这样他没有被一个“字”字符紧跟着。 /\w\b\w/将不能匹配任何字符串,因为在一个单词中间的字符永远也不可能同时满足没有“字”字符跟随和有“字”字符跟随两种情况。备注: JavaScript 的正则表达式引擎将[特定的字符集`定义为“字”字符。不在该集合中的任何字符都被认为是一个断词。这组字符相当有限:它只包括大写和小写的罗马字母,十进制数字和下划线字符。不幸的是,重要的字符,例如“é”或“ü”,被视为断词。 |
|
\B |
匹配一个非单词边界。匹配如下几种情况:字符串第一个字符为非“字”字符字符串最后一个字符为非“字”字符两个单词字符之间两个非单词字符之间空字符串例如,/\B../匹配"noonday"中的'oo', 而/y\B../匹配"possibly yesterday"中的’yes‘ | |
\cX |
匹配字符串中的一个控制符。例如,/\cM/ 匹配一个 control-M (U+000D)或回车符。x 的值必须为 A-Z 或 a-z 之一。否则,将 c 视为一个原义的 'c' 字符 |
|
\d |
匹配一个数字。等价于 [0-9]。例如, /\d/ 或者 /[0-9]/ 匹配"B2 is the suite number."中的'2'。 |
|
\D |
匹配一个非数字字符。等价于 [^0-9]。例如, /\D/ 或者 /[^0-9]/ 匹配"B2 is the suite number."中的'B' 。 |
|
\f |
匹配一个换页符 (U+000C)。等价于 \x0c 和 \cL。 | |
\n |
匹配一个换行符 (U+000A)。等价于 \x0a 和 \cJ。 | |
\r |
匹配一个回车符 (U+000D)。等价于 \x0d 和 \cM。 | |
\s |
匹配一个空白字符,包括空格、制表符、换页符和换行符。等价于 [ \f\n\r\t\v],注意 Unicode 正则表达式会匹配全角空格符,等价于 [\f\n\r\t\v\u0020\u00a0\u1680\u180e\u2000-\u200a\u2028\u2029\u202f\u205f\u3000\ufeff]。例如,/\s\w*/ 匹配"foo bar."中的' bar'。经测试,\s 不匹配"[\u180e`",在当前版本 Chrome(v80.0.3987.122) 和 Firefox(76.0.1) 控制台输入/\s/.test("\u180e") 均返回 false。 |
|
\S |
匹配一个非空白字符。等价于 [^\f\n\r\t\v\u0020\u00a0\u1680\u180e\u2000-\u200a\u2028\u2029\u202f\u205f\u3000\ufeff]。例如,/\S\w*/ 匹配"foo bar."中的'foo'。 |
|
\t |
匹配一个水平制表符 (U+0009)。等价于 \x09 和 \cI。 |
|
\v |
匹配一个垂直制表符 (U+000B)。等价于 \x0b 和 \cK。 |
|
\w |
匹配字母、数字、下划线。等价于[A-Za-z0-9_]。 |
|
\W |
匹配非字母、数字、下划线。等价于 [^A-Za-z0-9_]。 |
|
\n |
在正则表达式中,它返回最后的第 n 个子捕获匹配的子字符串 (捕获的数目以左括号计数)。比如 /apple(,)\sorange\1/ 匹配"apple, orange, cherry, peach."中的'apple, orange,' 。 |
|
\0 |
匹配 NULL(U+0000)字符,不要在这后面跟其他小数,因为 \0<digits> 是一个八进制转义序列。 |
|
\xhh |
匹配一个两位十六进制数(\x00-\xFF)表示的字符。例如,'\x41' 匹配 "A"。'\x041' 则等价于 '\x04' & "1"。正则表达式中可以使用 ASCII 编码。 | |
\uhhhh |
匹配一个四位十六进制数表示的 UTF-16 代码单元。 | |
\u{hhhh}或\u{hhhhh} |
(仅当设置了 u 标志时)匹配一个十六进制数表示的 Unicode 字符。 |
正则表达式有六个可选参数 (flags) 允许全局和不分大小写搜索等。这些参数既可以单独使用也能以任意顺序一起使用,并且被包含在正则表达式实例中。
| 标志 | 含义 | 描述 |
|---|---|---|
i |
ignore - 不区分大小写 | 不区分大小写搜索。 |
g |
global - 全局匹配 | 全局搜索。 |
m |
multi line - 多行匹配 | 多行搜索。 |
s |
single line - 单行匹配 | 将整个文本(字符串)看做是一行 => 允许 . 匹配换行符(\n)。 |
u |
unicode - 万国码 | 使用 unicode 码的模式进行匹配。 |
y |
sticky search - 粘性 | 执行“粘性 (sticky)”搜索,匹配从目标字符串的当前位置开始。 |
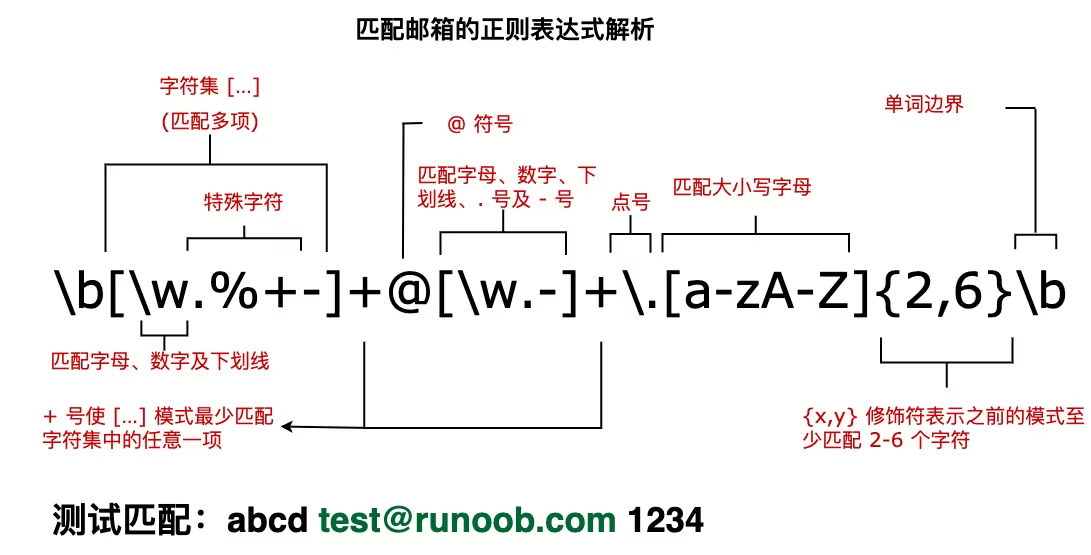
| 运算符 | 描述 | |
|---|---|---|
\ |
转义符 | |
(), (?:), (?=), [] |
圆括号和方括号 | |
*, +, ?, {n}, {n,}, {n,m} |
限定符 | |
^,$, \任何元字符、任何字符 |
定位点和序列(即:位置和顺序)(\任何元字符就是\\、\*、\^等等)(\任何字符就是a、b、c、z等等,比如直接输入abc来查询) |
|
| ` | ` | 替换,"或"操作字符具有高于替换运算符的优先级,使得"m|food"匹配"m"或"food"。若要匹配"mood"或"food",请使用括号创建子表达式,从而产生"(m|f)ood"。 |
分享你的想法,与大家交流讨论
Twikoo 加载失败
Twikoo 脚本加载失败