数据结构与算法 网课
发布于 2026-04-06更新于 2026-11-148806 字108 分钟 · 阅读时间
三模 2023-10-20~2024-- 2025-5-5最后更新日期
定义全局数组可以减少传来传去的烦恼
2024-8-14:除非要使用
dfs,否则不推荐使用全局数组
void quick_sort(int q[], int l, int r){ if (l >= r) return; int i = l - 1, j = r + 1, x = q[l + r >> 1]; while (i < j) { do i ++ ; while (q[i] < x); do j -- ; while (q[j] > x); if (i < j) swap(q[i], q[j]); } quick_sort(q, l, j), quick_sort(q, j + 1, r);}快速排序用的是分治思维
分治思维:
先将大问题拆开,然后逐个解决,最后合并
通常用于解决那些可以自然地分解成多个子问题的问题,如归并排序、快速排序、二分查找、大整数乘法等
主要思想
l,右r,中间的任意值x(随机的,一般为最中点)l x r|__________________________________________________________|
l ≤x x ≥x r|__________________________________________________________|
如下使用两个指针i,j来排序,交换
l x r|__________________________________________________________|
⬆ ⬆
i j
满足条件后用swap(a[i], a[j])来交换
// l=left(左), r=right(右), x为任意值,一般为中值// 这是从小到大排的void quick_sort(int q[], int l, int r){ // 当左≥右时,提前结束(数据为0或1)(因为主函数中传的是n-1) // quick_sort(q,0,n-1);(数组从0开始数) if (l >= r) return; // 因为是先移动后比较,所以要先移动一位才能保证全都排到 // 使用 >>1 而非 /2 是因为它更接近底层,更快 int i = l - 1, j = r + 1, x = q[l + r >> 1]; //当i,j这两个指针重合后,停止 while (i < j) { //递增i/递减j,比较q[i/j]是否>/<中间值(x),没达成条件,继续递增/减,直到达成后停止 do i ++ ; while (q[i] < x); do j -- ; while (q[j] > x); // 直到两个指针指向的数都满足条件后就交换这两个数 if (i < j) swap(q[i], q[j]); } // 分成两份的循环完后,递归循环,四份的,八份的……,直到满足第一个if的条件 // 这里若要将j改成i-1的话,上面的的x也要改成别的,不要让它取到左边界 quick_sort(q, l, j),; quick_sort(q, j + 1, r);}快速排序的平均时间复杂度为 ()
但特殊情况下,可达到 ,比如已经有序时等等
空间复杂度:
快速排序相比于归并排序的稳定性也更差一些
(排序)稳定性:
{5a,2,5b,1,4}; ,其中 5a 和 5b 是相等元素{1,2,4,5a,5b} 时,我们就叫它是稳定的(相等元素的相对顺序不变){1,2,4,5a,5b} 或{1,2,4,5b,5a}时,我们就叫它是不稳定的(相等元素的相对顺序可能改变)实例:
#include <bits/stdc++.h>using namespace std; const int N=1000010;int q[N]; void quick_sort(int q[],int l,int r) { if(l>=r) return; int i=l-1,j=r+1,x=q[l+r>>1]; while(i<j) { do{i++;} while(q[i]<x); do{j--;} while(q[j]>x); if(i<j){swap(q[i],q[j]);} } quick_sort(q,l,j),quick_sort(q,j+1,r);}int main() { int n; scanf("%d",&n); for(int i=0;i<n;i++){scanf("%d",&q[i]);} quick_sort(q,0,n-1); for(int i=0;i<n;i++){printf("%d ",q[i]);} return 0;} void merge_sort(int q[], int l, int r){ if (l >= r) return; int mid = l + r >> 1; merge_sort(q, l, mid); merge_sort(q, mid + 1, r); int k = 0, i = l, j = mid + 1; while (i <= mid && j <= r) if (q[i] <= q[j]) tmp[k ++ ] = q[i ++ ]; else tmp[k ++ ] = q[j ++ ]; while (i <= mid) tmp[k ++ ] = q[i ++ ]; while (j <= r) tmp[k ++ ] = q[j ++ ]; for (i = l, j = 0; i <= r; i ++, j ++ ) q[i] = tmp[j];}主要思想就是字面意思
l mid r|_____________________________|____________________________|
i
⬇l mid|_____________________________|mid+1 r|_____________________________|
⬆
j
如:a[左]:1 3 5 7 9
a[右]:2 4 5 8 10
t[ ] = { 1,2,3,4,5,5,7,8,9,10 }
就是 i 指向 1,j 指向 2,a[i]≤a[j]时,将 a[i]也就是 1 放入 t 中,然后移动 i,同理,将所有数放入。如果相等一般放入上面的(左边的),以保持稳定性。如果上面的指针先走完,则将下面剩下的直接放入最后,下面的先走完同理(因为这两堆是已经排好的,同一堆的后面的一定大于前面的)。
void merge_sort(int q[], int l, int r){ // 停止条件 if (l >= r) return; // 取中值 int mid = l + r >> 1; // 继续细分 merge_sort(q, l, mid); merge_sort(q, mid + 1, r); // 定义两个指针i j int k = 0, i = l, j = mid + 1; // 开始合并左右(上下) // 当i在上,j在下进行下一步 (用上面的图) while (i <= mid && j <= r) // 比较上面的还是下面的要放到中介数组(tmp)中 // "Temporary"(临时的)常用于储存临时数据 if (q[i] <= q[j]) tmp[k ++ ] = q[i ++ ]; else tmp[k ++ ] = q[j ++ ]; // 上面的循环有一个到头后,进行下面的循环 // 将指针没到头的那个的剩余部分放入tmp数组中 while (i <= mid) tmp[k ++ ] = q[i ++ ]; while (j <= r) tmp[k ++ ] = q[j ++ ]; // 将tmp数组放回q数组中去 for (i = l, j = 0; i <= r; i ++, j ++ ) q[i] = tmp[j];}也和上面快速排序一样,会一分为二,二分为四……
所以时间复杂度也为,但最坏情况下也是这个时间
空间复杂度:需要一个额外数组来储存,所以需要 的额外空间
稳定性:稳定
中的 表示排序序列的长度, 表示递归的层数。每次要分为两份,要分为 n 份要分次 ()(第一层为,第二层为两个,共份,下面的层同理)
使用树来排序
c++中自带的 sort 就是先用快速排序划分开一定程度,然后用插入排序或堆排序来排(自动选择),以减少出现快速排序中的情况
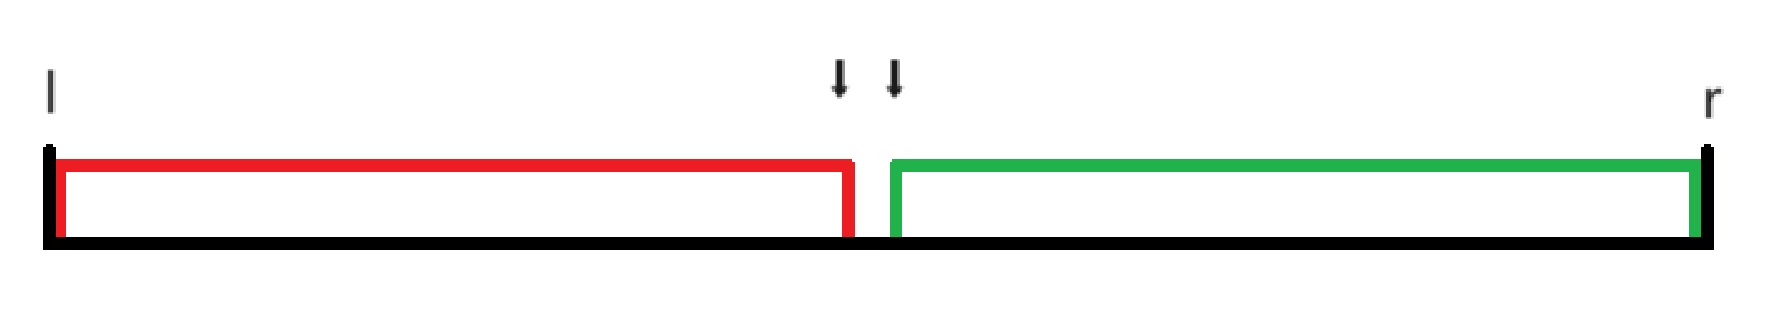
bool check(int x) {/* ... */} // 检查x是否满足某种性质 // 用下面两个要看所求是左边界还是右边界,左边界用第一个,右边界用第二个(如下图) // 区间[l, r]被划分成[l, mid]和[mid + 1, r]时使用:int bsearch_1(int l, int r){ while (l < r) { int mid = l + r >> 1; if (check(mid)) r = mid; // check()判断mid是否满足性质 else l = mid + 1; } return l;}// 区间[l, r]被划分成[l, mid - 1]和[mid, r]时使用:int bsearch_2(int l, int r){ while (l < r) { int mid = l + r + 1 >> 1; if (check(mid)) l = mid; else r = mid - 1; } return l;}如下,左边界是绿色上面的箭头,右边界是红色上面的箭头
bool check(double x) {/* ... */} // 检查x是否满足某种性质 double bsearch_3(double l, double r){ // eps 表示精度,取决于题目对精度的要求 // 一般精度取所求的精度-2(如:要四位小数:1e-6,要六位小数:1e-8) // 当然了,直接for(int i=0;i<100;i++),用for循环100次也可以 const double eps = 1e-6; while (r - l > eps) { double mid = (l + r) / 2; if (check(mid)) r = mid; else l = mid; } return l;}只有 C++要,java 和 python 不用学,它们自带
一般分为:
大整数怎么存:
a[0]存个位,a[1]存十位……,因为进位时,加到数组后面好加一些如何运算:
主要思想:
// 这里用引用(&)是为了加快速度,减少大量复制操作(引用传递)vector<int> add(vector<int> &A,vector<int> &B){ // C为所求(a与b的求和) vector<int> C; // t用于加法与进位的操作,初始为0 int t=0; // 循环遍历,当A和B都到底(没数)之后,停止 for(int i=0;i<A.size() || i<B.size();i++) { // 将A与B同位的加到t上,t本身为进位 // 比如“123”和“12”,i=3时,A还有位,相加;B没有百位,不加了 if(i<A.size()){t+=A[i];} if(i<B.size()){t+=B[i];} // 将t的个位压入C数组中 C.push_back(t%10); // 将t的十位当作下一位的进位 t/=10; } // 如果最后还有进位(没放入C中),则将它压入C末尾 if(t){C.push_back(1);} // 返回C return C;} int main(){ // 通过字符串来输入,加快速度 string a,b; // 创建并输入两个可变数组A,B,用于储存字符串中的数 vector<int> A,B; cin>>a>>b; // 将个位放前面,较大的位放后面,因为之后进位好加一些 // a.size()-1是因为数组是从0开始的 for(int i=a.size()-1;i>=0;i--) {A.push_back(a[i]-'0');} for(int i=b.size()-1;i>=0;i--) {B.push_back(b[i]-'0');} // 用于自动推导类型,也可以直接写成vector<int> auto C =add(A,B); // 从后往前输出(先输出较大位的) for(int i=C.size()-1;i>=0;i--) {printf("%d",C[i]);} return 0;}实例:
#include <bits/stdc++.h>using namespace std;vector<int> add(vector<int> &A,vector<int> &B) { vector<int> C; int t=0; for(int i=0;i<A.size() || i<B.size();i++) { if(i<A.size()){t+=A[i];} if(i<B.size()){t+=B[i];} C.push_back(t%10); t/=10; } if(t){C.push_back(1);} return C;}int main() { string a,b; vector<int> A,B; cin>>a>>b; for(int i=a.size()-1;i>=0;i--){A.push_back(a[i]-'0');} for(int i=b.size()-1;i>=0;i--){B.push_back(b[i]-'0');} auto C =add(A,B); for(int i=C.size()-1;i>=0;i--){printf("%d",C[i]);} return 0;}与加法同理
以下只展示函数部分:
顾名思义,就是可以快速的算出一段序列的和 ( )
比如对于 区间内的一段序列 其区间内的和是
如上,因为有 ,因此需要有 ,所以前缀和的数组要比 多一个 ( ),并且从 开始数更好。
for(int i=1;i<=n;i++)cin>>a[i];for(int i=1,i<=n;i++)s[i]=s[i-1]+a[i];就是左上角 a[1][1] 到右下角 a[i][i] 的和
计算方法:
for(int i=1;i<=n;i++) for(int j=1;j<=m;j++) s[i][j]=s[i-1][j]+s[i][j-1]-s[i-1][j-1]+a[i][j];一个区间的和:
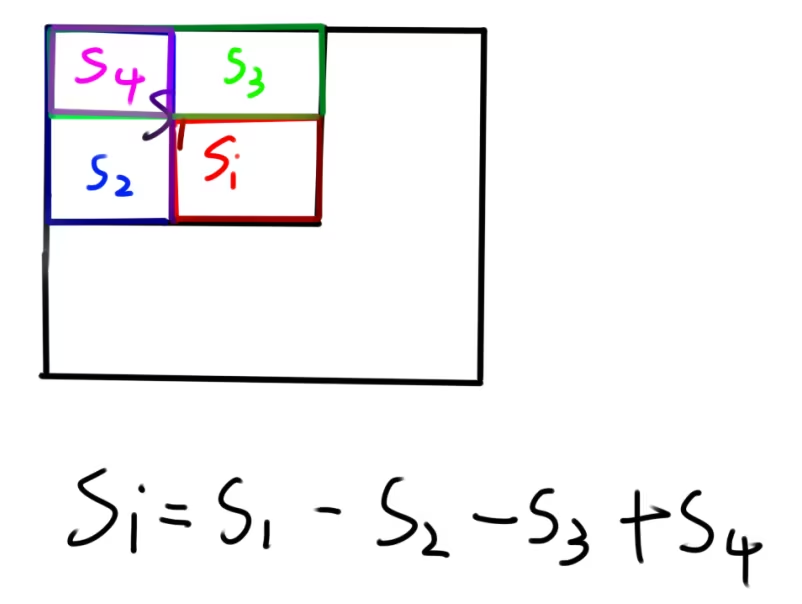
// 区间(x1,y1)~(x2,y2) 左上角到右下角的前缀和S=s[x2][y2]-s[x1-1][y2]-s[x2][y1-1]+s[x1-1][y1-1];还有,合在一个for中算还是分开,时间复杂度是不会改变的
当然,将二维数组的前缀和通过单独计算每一行还有每一列的方法,可以将其压缩成一维的
这个和上面求前缀和一样也是要输入完全部后再差分/求前缀和
就是前缀和的逆运算 (是的前缀和,是的差分)
差分与前缀和思维的本质是通过加减前后两项,然后通过循环迭代来重新刷新一遍,来快速改变原数组的数
比如上下面的题都是先将要求的转化为可以通过加减前后两项,最后还原回来的方法,来改变原数组
给出一串数组,然后求其 ()
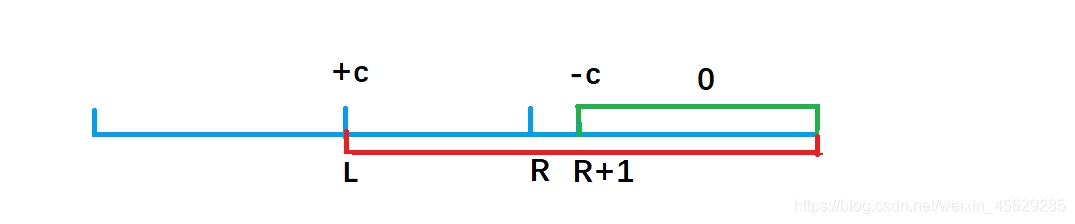
题目:给 s[n]区间[l, r]中的每个数加上 c(进行 m 次),然后再输出全部数组 s[n]:
// 先求出a[n](差分),然后再对差分相加减,// 最后重新求前缀和,算出s[n]a[l] += c, a[r + 1] -= c在下图的竖线条()中加了 c,等于对红横线(~)部分加了 c
int main(){ int n,m; cin>>n>>m; vector<int> a(n+10),s(n+10); for(int i=1;i<=n;i++) cin>>s[i]; for(int i=1;i<=n;i++) { a[i]=s[i]-s[i-1]; } while(m--) { int l,r,c; cin>>l>>r>>c; a[l]+=c;a[r+1]-=c; } for(int i=1;i<=n;i++) { s[i]=s[i-1]+a[i]; cout<<s[i]<<" "; } return 0;}记得数组开大一点不会死,n+1 之前报错了,最好 n+10 之类的
给以(x1, y1)为左上角,(x2, y2)为右下角的子矩阵中的所有元素加上 c:
题目:给 s[n][m]区间[x1, y1]~[x2,y2]中的每个数加上 c(进行 q 次),然后再输出全部数组 s\[n][m]:
// 如下图,右下角整体+c,绿-c,紫色-c,红+c <==> 小蓝框+ca[x1, y1] += c, a[x2 + 1, y1] -= c, a[x1, y2 + 1] -= c, a[x2 + 1, y2 + 1] += c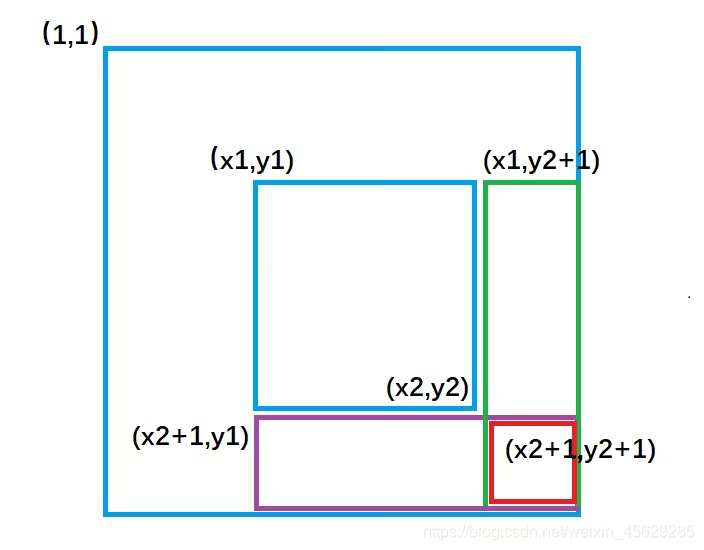
int main(){ int n,m,q; cin>>n>>m>>q; int a[n+10][m+10]={},s[n+10][m+10]={}; for(int i=1;i<=n;i++) { for(int j=1;j<=m;j++) { cin>>s[i][j]; } } for(int i=1;i<=n;i++) { for(int j=1;j<=m;j++) { a[i][j]=s[i][j]-s[i-1][j]-s[i][j-1]+s[i-1][j-1]; } } while(q--) { int x1,y1,x2,y2,c; cin>>x1>>y1>>x2>>y2>>c; a[x1][y1]+=c; a[x2+1][y1]-=c; a[x1][y2+1]-=c; a[x2+1][y2+1]+=c; } for(int i=1;i<=n;i++) { for(int j=1;j<=m;j++) { s[i][j]=a[i][j]+s[i-1][j]+s[i][j-1]-s[i-1][j-1]; cout<<s[i][j]<<" "; } cout<<endl; } return 0;}通用模板
for(int i=0;j=0;i<n;i++){ while(j<i && check(i,j))j++; // 代码code}核心思想:将 优化到
做法:先想一个暴力的方法,然后再想一想有没有关系可以让它使用双指针算法,如果可以的话,就使用
适用条件:
Q:求二进制中 1 的个数
int lowbit(int x){ return x & (-x);} void solve(){ int n; cin >> n; while(n --){ int x; cin >> x; int res = 0; while(x) { int k=lowbit(x); x -= k; res ++; } cout << res << " "; }}如一个数是 其二进制是
它的最后一个 在第 位,则x&-x会获取到
然后 并重复操作,直到 暂停循环
位运算就是直接对二进制数按每一位进行操作,而不考虑整体含义,
就是将二进制的 0 或 1 看成逻辑的真或假来向竖式一样进行逻辑运算
C++中的位运算符包括:
此外,还有移位运算符:
例如 1(位运算符):
对于二进制数a=1010和b=1111,(10 和 15)
其按位与运算的结果为 1010 & 1111 = 1010,(a & b)
按位或运算的结果为 1010 | 1111 = 1111,(a | b)
异或运算的结果为 1010 ^ 1111 = 0101,(a ^ b)(0101:5)
取反运算的结果为 ~1010 = 0101。 (~a)
例如 2(移位运算符):
对于二进制数a=1010,
其左移 1 位的结果为 10100,(a<<1)(10100:20)
右移 1 位的结果为 101。 (a>>1) (101:5)
注:1. << >> 还是输入输出流的分隔符
2. 其实上面的位移结果在内存中是
0000 0000 0000 0000 0000 0000 0001 0100和
0000 0000 0000 0000 0000 0000 0000 0101
3. 其实
a<<n 就相当于 a×2 的 n 次方,
a>>n 就相当于 a 整除 2 的 n 次方。
4. ~A=-A-1 (这里的 A 是一个二非一进制数,而个像上面一样的变量)
如 n&(n−1) 可以判断一个数是否是二的幂次方 如果一个数n是2的幂次方,那么它的二进制表示中只有一位是1,其他位都是0。例如,2、4、8、16等。如果我们将n-1,它的二进制表示中除了最高位是1之外,其他位都变成了1。例如,如果n=8(1000),则n-1=7,它的二进制表示为0111。那么,当我们对n和n-1进行按位与运算时,得到的结果就是0。因为这时n和n-1的二进制表示中,它们的最高位都是1,其他对应位都不同,所以它们的按位与运算结果必定是0。 综上所述,如果n&(n−1)的结果等于0,那么n就是2的幂次方。// n&(n−1) 还可以用来去掉一个数的由二进制表示并从末尾开始数的最后一个1特指整数有序的离散化
离散化,就是当我们只关心数据的大小关系时,用排名代替原数据进行处理的一种预处理方法。离散化本质上是一种哈希,它在保持原序列大小关系的前提下把其映射成正整数。当原数据很大或含有负数、小数时,难以表示为数组下标,一些算法和数据结构(如 BIT)无法运作,这时我们就可以考虑将其离散化。
比如说一个前缀和的题,但是有用的数据范围比较大,如果直接用前缀和,会超时,所以要先把有用的数据去映射一遍,然后记录数据,下标,其有用的数据的前缀和等等,最后再输出
说白了,就是手动映射。还不如直接用 map
// 将所有存在交集的区间合并void solve(){ int n; cin>>n; vector<pair<int,int>> a(n),b; for(int i=0;i<n;i++)cin>>a[i].first>>a[i].second; sort(a.begin(),a.end()); int begin=INT_MIN,end=INT_MIN; for(auto i:a) { if(end<i.first) { if(end!=-2e9) b.push_back({begin,end}) ; begin=i.first,end=i.second ; } else if(end<i.second) end=i.second ; } b.push_back({begin,end}); ll sum=0; for(int i=1;i<b.size();i++){ sum+=(b[i].second-b[i].first); } cout<<sum;}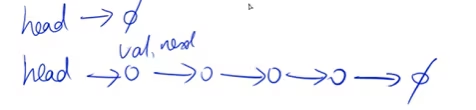
数组来模拟的话就是二维数组(或两个数组)
第一排是数,第二排是指针
// 注意是从0开始数的,有点数要-1(add(k-1,x);) // head存储链表的头指针,e[]存储节点的值,ne[]存储节点的next指针,idx指向当前用到了哪个节点,最后一个节点指针指向-1int head, e[N], ne[N], idx; // 初始化void init(){ head = -1; idx = 0;} // 在链表头插入一个数avoid insert(int a){ e[idx] = a; // 导入数到其中 ne[idx] = head; // 它指向头节点指向的位置(下一个节点) head = idx; // 将头节点指向它 idx++; // idx被用过了,要指向下一个} // 将x这个数插到下标是k的点后面void add(int x,int k){ e[idx]=x; // 添加x ne[idx]=ne[k]; // 它指向k原来指向的位置 ne[k]=idx; // k指向它 idx++;} // 将头结点删除,需要保证头结点存在void removeHead(){ head = ne[head];} // 删除k的后一个节点void remove(int k){ ne[k]=ne[ne[k]]; // 从指向下一个到指向下下个} // 遍历链表int main(){ for(int i=head;i!=-1;i=ne[i]) { cout<<e[i]<<' '; } return 0;}就是有两个节点,一个指向左边,一个指向右边
// e[]表示节点的值,l[]表示节点的左指针,r[]表示节点的右指针,idx表示当前用到了哪个节点int e[N], l[N], r[N], idx; // 初始化void init(){ /* 0是左端点,1是右端点(改为-1什么的都可以,只是 下面也要改,这里只是模拟初始的两种情况)(这两个 是边界,不是实质内容) */ r[0] = 1, l[1] = 0; idx = 2; // 0和1被预留位边界,所以从2开始分配节点(上面单链表部分idx=0是因为head头节点被单独提了出来,没用数组中的值来表示)} // 在节点k的右边插入一个数xvoid insert(int k, int x){ e[idx] = x; // 添加x l[idx] = k; // 左指针指向k原来指向的位置 r[idx] = r[k];// 右指针指向点k下一个数的指针 l[r[k]] = idx;// k的下一个数的左指针指向x的指针 r[k] = idx; // k的右指针指向x的指针 idx ++;} // 删除节点avoid remove(int a){ l[r[a]] = l[a]; // 左指向右,右指向左 r[l[a]] = r[a]; // 这样中间就“消失”了}// 创建一个栈(t表示栈顶)int stack[N],t=0; // 向栈顶插入一个数stack[++t] = x; // 从栈顶弹出一个数t-- ; // 栈顶的值stack[t]; // 判断栈是否为空,如果 t > 0,则表示不为空if (t > 0){ }// 创建一个队列(h 表示队头,t 表示队尾(tail))int queue[N], h = 0, t = -1; // 头>尾为空 // 向队尾插入一个数queue[++t] = x; // 同“栈” // 从队头弹出一个数h++ ; // 队头的值queue[h]; // 判断队列是否为空,如果 h <= t,则表示不为空if (h <= t) // h>t为空{ }意思是栈中的一堆数是按顺序单调递增或递减的,如下题:
给定一个长度为 N 的整数数列,输出每个数左边第一个比它小的数,如果不存在则输出 −1。
输入:
5
3 4 2 7 5输出:
-1 3 -1 2 2
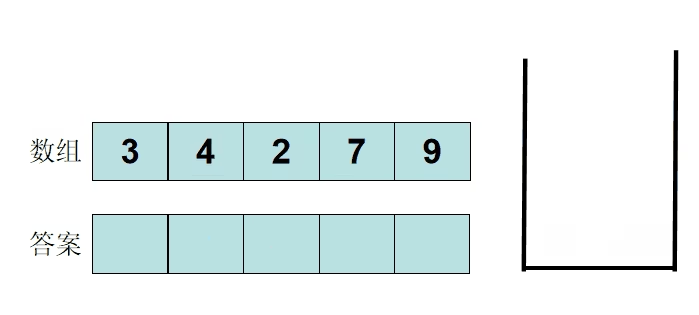
题解
int main(){ int n; cin>>n; int x; stack<int> t; for (int i = 0; i < n; i ++ ){ cin>>x; // 栈顶≥当前数时弹出栈顶 while(!t.empty() && t.top()>=x) t.pop(); if(t.empty()) cout<<"-1 "; else cout<<t.top()<<' '; t.push(x); } return 0;}模板
stack<int> t;for(int i=0;i<n;i++){ // 当t不为空,且栈顶与当前数达成某种条件时成立 while(!t.empty() && check(t.top,a[i])) a.pop(); // ...... t.push(a[i]);}同上,队列中的元素保持单调性
滑动窗口:
给定一个大小为 n≤10^6^ 的数组。有一个大小为 k 的滑动窗口,它从数组的最左边移动到最右边。
你只能在窗口中看到 k 个数字。每次滑动窗口向右移动一个位置。某数组为
[1 3 -1 -3 5 3 6 7],k 为 3。
窗口位置 最小值 最大值 [1 3 -1] -3 5 3 6 7 -1 3 1 [3 -1 -3] 5 3 6 7 -3 3 1 3 [-1 -3 5] 3 6 7 -3 5 1 3 -1 [-3 5 3] 6 7 -3 5 1 3 -1 -3 [5 3 6] 7 3 6 1 3 -1 -3 5 [3 6 7] 3 7 你的任务是确定滑动窗口位于每个位置时,窗口中的最大值和最小值。
输入: n,k,n 个整数
8 3
1 3 -1 -3 5 3 6 7输出:第一行为每个窗口的最小值,第二行为最大值
-1 -3 -3 -3 3 3
3 3 5 5 6 7
题解
const int N = 1000010;int a[N];int main(){ int n, k; cin >>n>>k; for(int i=1;i<=n;i++) cin>>a[i];//读入数据 deque<int> q; for(int i=1;i<=n;i++) { // 新进入窗口的值小于队尾元素,则队尾出队列 while(!q.empty() && q.back()>a[i]) q.pop_back(); //将新进入的元素入队 q.push_back(a[i]); //若队头是否滑出了窗口,队头出队 if(i-k>=1 && q.front()==a[i-k]) q.pop_front(); //当滑动窗口完全存在时,输出队头对应的值 if(i>=k) cout<<q.front()<<' '; } q.clear(); cout << endl; //最大值亦然 for(int i=1;i<=n;i++) { while(q.size() && q.back() < a[i]) q.pop_back(); q.push_back(a[i]); if(i-k>=1 && a[i-k]==q.front()) q.pop_front(); if(i>=k) cout<<q.front()<<' '; } return 0;}模板
deque<int> q;for(int i=0;i<n;i++){ while(!q.empty()&&check(q.back(),a[i])) q.pop_back(); q.push_back(i); // ......}q.clear(); // 清空队列(若要重复用的话)KMP 为三个创始人的手写字母,
其算法是一种字符串匹配算法。
它的主要目标是在一个文本字符串中查找一个模式字符串的出现位置(可多次出现)。
通过空间换时间,减少回溯,降低时间复杂度
时间复杂度 (n=s.size(),m=p.size())
string s,p;// s为文本字符串(有的也用text)// p为模板字符串(pattern:模板)(较短)模板
void KMP(string &s,string &p){ vector<int> prefix(p.size(),0); for(int i=1,j=0;i<p.size();i++) { while(j>0 && p[j]!=p[i]) j=prefix[j-1]; if(p[j]==p[i]) j++; prefix[i]=j; } for(int i=0,j=0;i<s.size();i++) { while(j>0 && p[j]!=s[i]) j=prefix[j-1]; if(p[j]==s[i]) j++; if(j==p.size()) { cout<<"找到p在s的起始下标在"<<i+1-p.size()<<'\n'; j=prefix[j-1]; } }} int main(){ string text = "abxabcabcabyabc"; string pattern = "abcaby"; KMP(text, pattern); return 0;}解释
void KMP(string &s,string &p){ // 这里是计算从前往后数,p字符串本身的前后缀相同的情况 // (数到哪,字符串就有多长) /* / 例1:abcddedabc abc前缀-abc后缀 / 例2:abcdedcba a前缀-a后缀 / 例3:abadeabcdaba a前缀-a后缀、ab前-ab后、aba前-aba后 / 001001200123 (prefix数组) / 0指从当前位置向前数,有0个字母与0个字母前缀匹配 / 同理,2指从当前位置向前数有两个字母(正着数的后缀 ab)与 2个字母的前缀(ab)相同 */ // 求prefix数组(模式串的部分匹配表) vector<int> prefix(p.size());// prefix 前缀 (即next数组) prefix[0]=0; // 看例3,第一个字符的部分匹配值总是0 // i指向文本p,j指向模板p // 因为第一个字符如上,在prefix[]的值总为0,因此可以i=2直接跳过,但因为不与下面统一,也不好记 for(int i=1,j=0;i<p.size();i++) { // 当p[j]!=p[i]时,回溯j (例3) // 因为要一直与真·前缀比,又因为之前在prefix数组中记录了之前部分有多少个匹配。 // j>0 也可改成单独一个j while(j>0 && p[j]!=p[i]) j=prefix[j-1]; // 当p[j]==p[i]时,j+1 (例3) if(p[j]==p[i]) j++; // 记录j的值(记录有几个字母与前缀相同) prefix[i]=j; } // 所求文本字符串与模板字符串之间匹配(上下两个for只是p与所匹配的对象不同(p-p,p-s)) // i指向文本s,j指向模板p for(int i=0,j=0;i<s.size();i++) { // 如下例子,一个一个试就明白了 /* / abxabcabcabyabc s / abcaby p / 000120 prefix[] */ while(j>0 && p[j]!=s[i]) j=prefix[j-1]; if(p[j]==s[i]) j++; // 如果在s中找到了匹配一串字符串, if(j==p.size()) { // 这时指向上例的y处,因此要减去p的长度,+1是因为i从0开始,但p.size()是从1开始的,加上后才是正确的从s开始从0数的下标 cout<<"找到模板串p在s的起始下标在:"<<i+1-p.size()<<'\n'; // 然后回溯j,准备去寻找下一个匹配的位置 j=prefix[j-1]; } }} int main(){ string text = "abxabcabcabyabc"; string pattern = "abcaby"; KMP(text, pattern); return 0;} // 输出:找到模板串p的起始下标在:6又称前缀树 / 单词查找树 / Trie 树。是一种用于储存字符串的数据结构。字典树的每个节点表示一个字符串(也可能是前缀),
其通过利用字符串的公共前缀来比较、查询、自动补全等;
其通过在每个节点的子节点表示该字符串后添加一个字符后获得到的新字符串
前缀树的 3 个基本性质:
字典字符串统计
维护一个字符串集合,支持两种操作:
I x向集合中插入一个字符串 x;Q x询问一个字符串在集合中出现了多少次。共有 N 个操作,所有输入的字符串总长度不超过 105105,字符串仅包含小写英文字母。
输入格式
第一行包含整数 N,表示操作数。
接下来 N 行,每行包含一个操作指令,指令为
I x或Q x中的一种。输出格式
对于每个询问指令
Q x,都要输出一个整数作为结果,表示 x 在集合中出现的次数。每个结果占一行。
数据范围
1≤N≤2∗104
输入输出 如下解释中
模板
#define N (int) 10e5+10 int son[N][26],cnt[N],idx=0; void insert(string &s){ int p=0; for(int i=0;s[i];i++) { int c=s[i]-'a'; if(!son[p][c]) son[p][c]=++idx; p=son[p][c]; } cnt[p]++;} int query(string &s){ int p=0; for(int i=0;s[i];i++) { int c=s[i]-'a'; if(!son[p][c]) return 0; p=son[p][c]; } return cnt[p];} int main(){ int T=1; cin>>T; while(T--) { char op; string s; cin>>op>>s; if(op=='I') insert(s); else cout<<query(s)<<'\n'; } return 0;}模板的解释
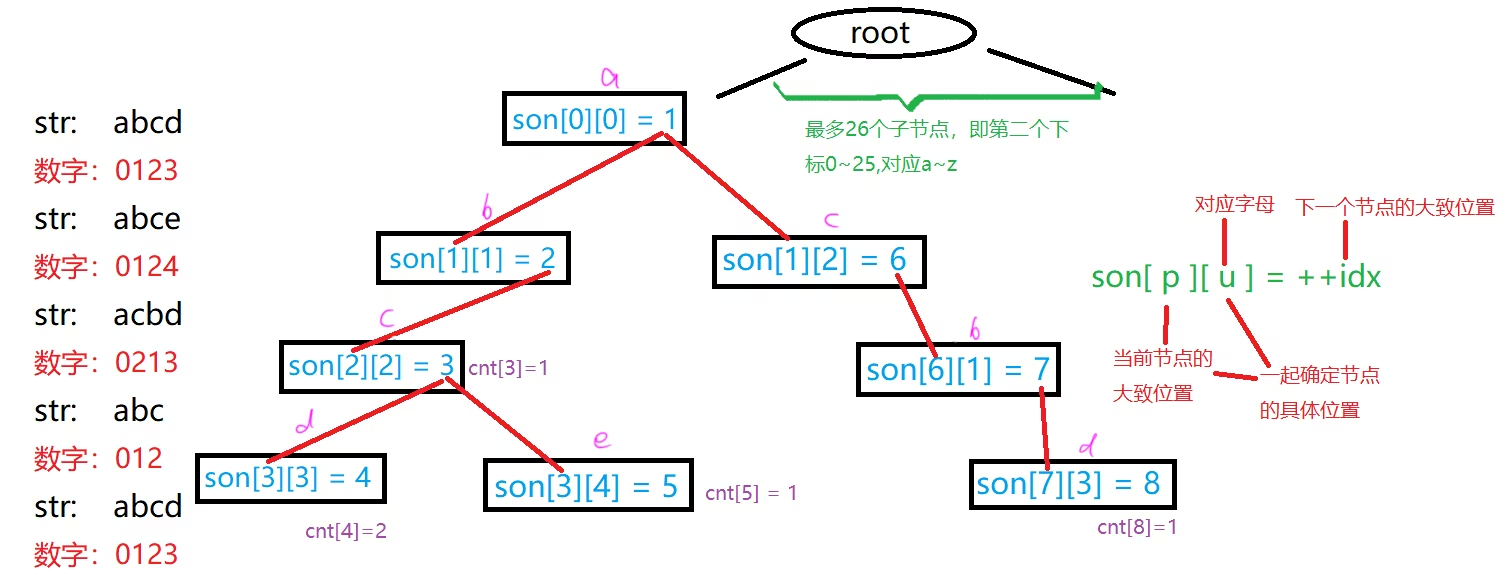
#define N (int)10e5+10// son[][]存储树中每个节点的子节点,初始为0// 0号点既是根节点,又是空节点// cnt[]存储以每个节点结尾的单词数量,初始为0// idx用于记录字典树中节点的数量,初始为0 (index 索引)// 这个实现是假设所有的字符串都是由小写字母组成的,因此每个节点有26个子节点,对应26个小写字母。int son[N][26], cnt[N], idx; // 插入一个字符串void insert(string &s){ int p = 0; // 首先将当前节点p设置为根节点(0号点) pointer 指针 for (int i = 0; s[i]; i ++ ) // str[i]='\0' 时,结束 { int c = s[i] - 'a'; // 当前字符所对应的数字 // 如果不存在,说明这是最后一个字符,因此就创建一个新的节点son[p][c]并更新idx // idx原本指向上一个字符(还没更新),因此需要先+1更新后才是指向当前位置 if (!son[p][c]) son[p][c] = ++idx; p = son[p][c]; // 将当前节点指针p指向c号子节点(每次都做) } cnt[p] ++ ; // 并在字符串插入完成后,增加以当前节点结尾的单词数量。} // 查询字符串出现的次数int query(string &s) // query 查询{ int p = 0; for (int i = 0; s[i]; i ++ ) { int c = s[i] - 'a'; if (!son[p][c]) return 0; // 如果查询到最后都不存在,出现次数就为0 p = son[p][c]; } return cnt[p];} int main(){ int T=1; cin >> T; while(T--) { char op; string s; cin>>op>>s; if(op == 'I') insert(s); else cout<<query(s)<<'\n'; } return 0;}// 输入:5I abcQ abcQ abI abQ ab// 输出:101标准字典树结构
// 定义字典树的节点结构struct TrieNode { TrieNode* children[26]; // 存储每个节点的子节点,每个子节点对应一个小写字母 bool isEndOfWord; // 标记是否为某个单词的结尾 // 构造函数,初始化节点 TrieNode() { isEndOfWord = false; // 初始时,节点不是任何单词的结尾 for (int i = 0; i < 26; i++) children[i] = nullptr; // 初始时,所有子节点都为空 }}; // 插入一个单词到Trie树中void insert(TrieNode* root, std::string key) { TrieNode* node = root; // 从根节点开始 for (int i = 0; i < key.length(); i++) { // 遍历单词的每个字符 int index = key[i] - 'a'; // 计算字符对应的索引 if (!node->children[index]) // 如果对应的子节点不存在 node->children[index] = new TrieNode(); // 创建一个新的子节点 node = node->children[index]; // 移动到子节点 } node->isEndOfWord = true; // 标记单词的结尾} // 在Trie树中搜索一个单词bool search(TrieNode* root, std::string key) { TrieNode* node = root; // 从根节点开始 for (int i = 0; i < key.length(); i++) { // 遍历单词的每个字符 int index = key[i] - 'a'; // 计算字符对应的索引 if (!node->children[index]) // 如果对应的子节点不存在 return false; // 单词不存在 node = node->children[index]; // 移动到子节点 } // 如果单词存在,返回true;否则,返回false return (node != nullptr && node->isEndOfWord);} int main() { // 创建一个Trie树的根节点 TrieNode* root = new TrieNode(); // 插入一些单词 insert(root, "hello"); insert(root, "world"); insert(root, "hi"); insert(root, "word"); insert(root, "hell"); // 搜索一些单词 std::cout << (search(root, "world") ? "已找到" : "未找到") << std::endl; // 输出:已找到 std::cout << (search(root, "wor") ? "已找到" : "未找到") << std::endl; // 输出:未找到 std::cout << (search(root, "hell") ? "已找到" : "未找到") << std::endl; // 输出:已找到 std::cout << (search(root, "hello") ? "已找到" : "未找到") << std::endl; // 输出:已找到 std::cout << (search(root, "hi") ? "已找到" : "未找到") << std::endl; // 输出:已找到 return 0;}就是 合并、查找集合的简称(Union-Find)。其是一种用于处理集合中的合并和查找问题的数据结构。通常用于解决连通性问题。并查集支持两种操作:union(合并)和 find(查找)。
#define N (int)1e5+10//存储每个点的祖宗节点(根节点)int p[N]; // 返回x的祖宗节点int find(int x){ if (p[x] != x) p[x] = find(p[x]); return p[x];} // 初始化,假定节点编号是1~nfor (int i = 1; i <= n; i ++ ) p[i] = i; // 合并a和b所在的两个集合:p[find(a)] = find(b);解释
#define N (int)1e5+10int p[N]; // 默认全为0 (parent 父母) // 返回的是x的祖宗节点// 这里还会路径压缩/关系传递/* 路径压缩的思想是:在执行查找操作时,将从当前节点到根节点路径上的所有节点的父节点都直接设置为根节点。这样,下次查找这些节点时,就可以直接找到根节点,大大提高了查找速度。 */int find(int x){ if(p[x]!=x){p[x]=find(p[x]);} return p[x]; } int main(){ int n; cin>>n; // 先赋值/初始化,假定节点编号是1~n。就是下面make函数的功能,只不过先全部进行了一遍 for(int i=1;i<=n;i++) p[i]=i; int k,a,b,q; // k次合并,q次询问 cin>>k; for(int i=0;i<k;i++) { cin>>a>>b; // 合并a和b所在的两个集合 // 这里反过来写也是可以的。如:p[find(b)]=find(a); p[find(a)]=find(b); } cin>>q; for(int i=0;i<q;i++) { cin>>a>>b; // 如果 含有a的集合与含有b的集合的祖宗节点相同,说明它们都属于同一个集合 if(find(a)==find(b)) puts("YES"); else puts("NO"); } return 0;}规范点的写法
#define N (int)1e5+10int p[N]; int find(int x){ if(p[x]!=x){ p[x]=find(p[x]);} return p[x]; } // find_setvoid union_set(int a,int b) { p[find(a)]=find(b); } // 不直接使用union,是因为union是共用体的关键字void make(int x) { p[x]=x; } // make_set int main(){ make(1); // 创造含有1的集合 make(2); make(3); union_set(2, 1); // 合并 含有2的集合 和 含有1 的集合 union_set(1,3); cout<<find(1)<<' '<<find(2)<<' '<<find(3); // 输出结果为:“3 3 3” return 0;} #define N (int)1e5+10//p[]存储每个点的祖宗节点, size[]其表示祖宗节点所在集合中的点的数量int p[N], size[N]; // 同上int find(int x){ if (p[x] != x) p[x] = find(p[x]); return p[x];} // 初始化,假定节点编号是1~nfor (int i = 1; i <= n; i ++ ){ p[i] = i; size[i] = 1;} // 合并a和b所在的两个集合:p[find(a)] = find(b);size[find(b)] += size[find(a)];解释
#define N (int)1e5+10//p[]存储每个点的祖宗节点, 只有size[]中的值是祖宗节点的才有意义,其表示祖宗节点所在集合中的点的数量int p[N], size[N]; // 同上int find(int x){ if (p[x] != x) p[x] = find(p[x]); return p[x];} // 初始化,假定节点编号是1~nfor (int i = 1; i <= n; i ++ ){ p[i] = i; size[i] = 1; // 初始都只有1个} // 合并a和b所在的两个集合:p[find(a)] = find(b); // 将a的根节点指向b的根节点size[find(b)] += size[find(a)]; // 所以需要更新b的根节点的集合大小/* 反过来想,将b的根节点指向a的根节点,需要相应地更新a的根节点的集合大小,即size[find(a)] += size[find(b)];,然后将p[find(b)] = find(a);。因此如果需要将一个更改过来,另一个也要更改*/int p[N], d[N];//p[]存储每个点的祖宗节点, d[x]存储x到p[x]的距离 // 返回x的祖宗节点int find(int x){ if (p[x] != x) { int u = find(p[x]);// 将p[x] = find(p[x]);分开,因为下面还要用到p[x],不要先改了 d[x] += d[p[x]]; // 将x到其父节点p[x]的距离加上p[x]到p[p[x]]的距离,得到新的x到p[p[x]]的距离,并将其存储在d[x]中 /* 因为每次合并都会改变祖宗节点,因此距离每次都要改 */ p[x] = u; } return p[x];} // 初始化,假定节点编号是1~nfor (int i = 1; i <= n; i ++ ){ p[i] = i; d[i] = 0;} // 合并a和b所在的两个集合:p[find(a)] = find(b);d[find(a)] = distance; // 根据具体问题,初始化find(a)的偏移量解释
int p[N], d[N]; // distance 距离//p[]存储每个点的祖宗节点, d[x]存储x到p[x]的距离 // 返回x的祖宗节点int find(int x){ if (p[x] != x) { int u = find(p[x]); d[x] += d[p[x]]; p[x] = u; } return p[x];} // 初始化,假定节点编号是1~nfor (int i = 1; i <= n; i ++ ){ p[i] = i; d[i] = 0; // 初始时是自己到自己,因此距离为0} // 合并a和b所在的两个集合:p[find(a)] = find(b);d[find(a)] = distance; // a的祖宗节点到b的祖宗节点的距离初始为多少,要根据题意设置,如下例子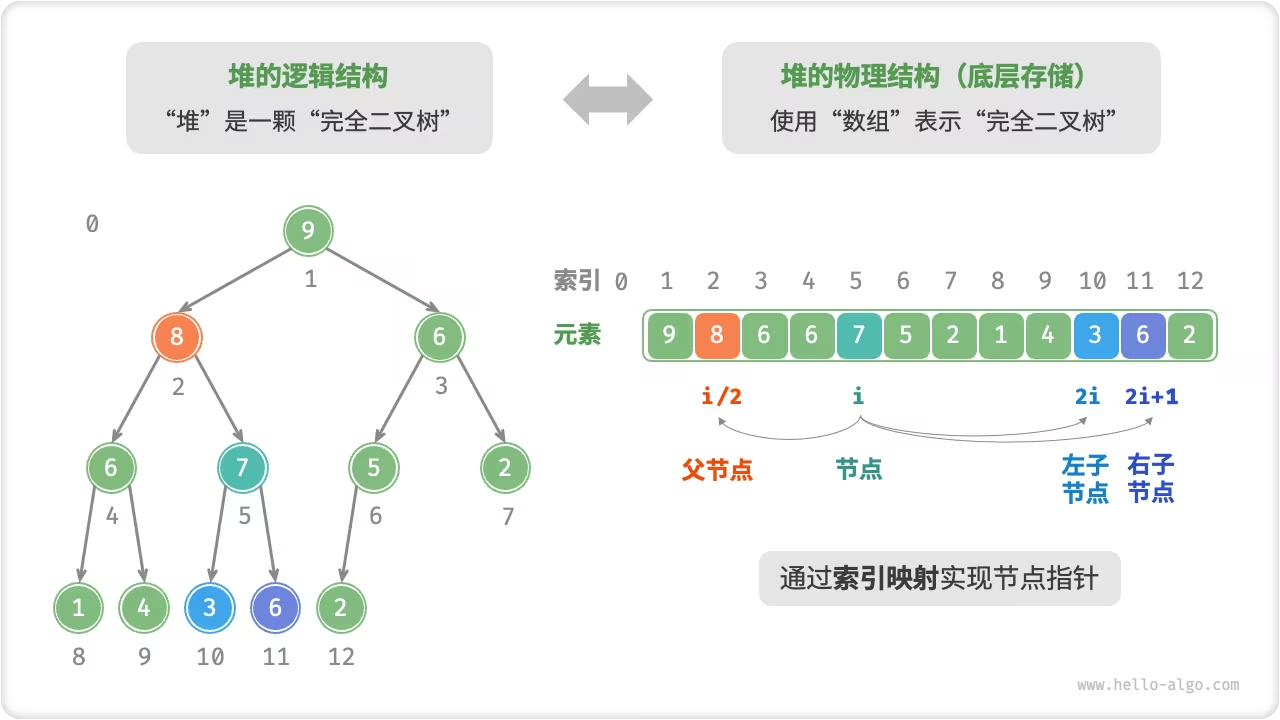
注:这是从 1 开始的,这和之前笔记中的不同,那个是从 0 开始的
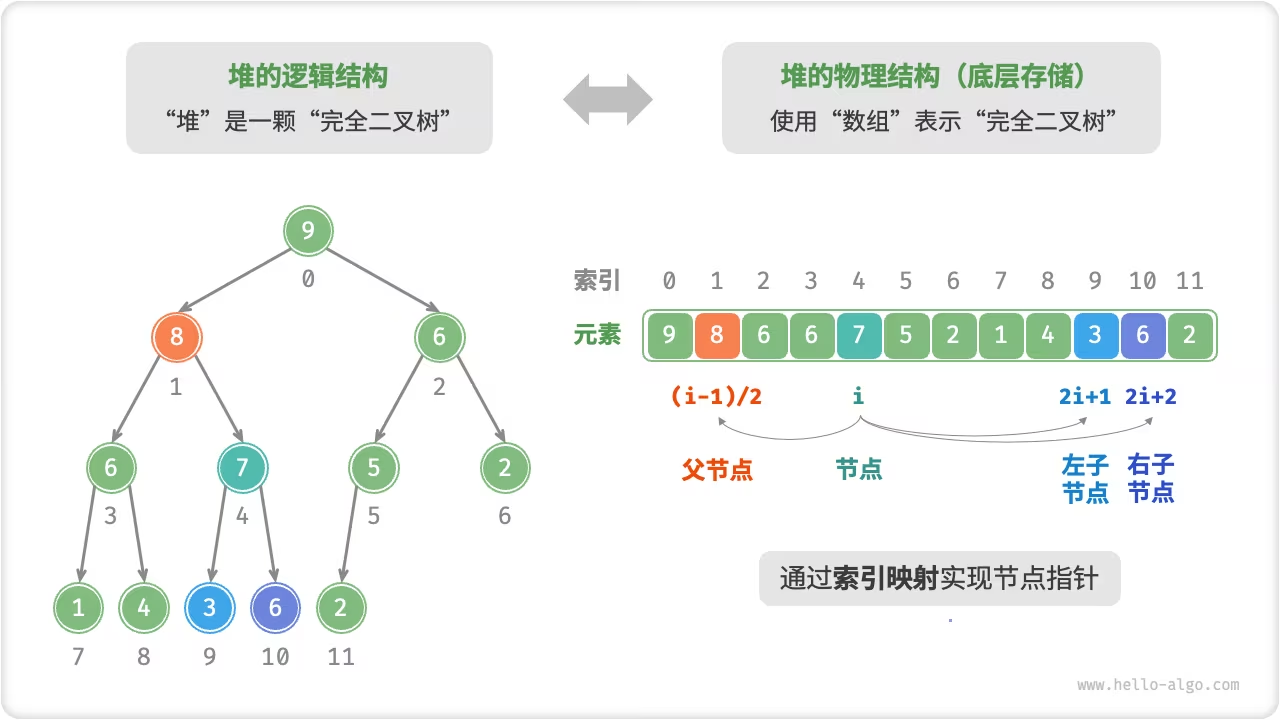
// h[]存储堆中的值,h[1]是堆顶,x的左子树是2x,右子树是2x+1// ph[]用于记录元素在堆中的位置 (第k个元素(ph[k])在堆中的位置)// ih[]用于记录插入顺序 (第k个元素(ih[k])是第几个插入的)// size为堆的大小 (1~n) (若和size()冲突,可以改成len等)/* heap:堆 position in heap: x的位置在堆中 insert heap:x第几个插入的*/int h[N], ph[N], hp[N], size;插入新元素时,需要更新 ph[] 来记录新元素在堆中的位置
cin>>x;cnt++; //用来记录插入的数的个数,默认为初始集合的大小h[++size]=x;ph[cnt]=size; // 新插入的元素默认先插入到最后ih[size]=cnt;up(size);修改第 k 个插入的数,将其变为 x 时,需要使用 ph[] 来快速的查找到位置
cin>>k>>x;h[ph[k]]=x; // 第k个插入的数变为xdown(ph[k]); // 从第k个插入的数开始向下堆化up(ph[k]);删除第 k 个插入的数时,使用 ih[] 可快速的查找到位置。
cin>>k;int t=ph[k]; //这要先记录第k个插入的数的原位置heap_swap(t,size);//与末尾交换 (如下没有ih,ph的赋值法就更简单了)size--;up(t);down(t);/* 获取左子节点索引 */int left(int &i) { return 2*i; }/* 获取右子节点索引 */int right(int &i) { return 2*i+1;}/* 获取父节点索引 */int parent(int &i){ return i/2; } // 向下取整/* 访问堆顶元素 */int top() {return h[1]; }无注释的
vector<int> a(N),h(N);heap=a; for(int i=size/2;i>0;i++) down(i);注释版
vector<int> a(N),h(N); // heap 堆 // 先将数据导入到堆中 (如果本身就是使用a[]作为堆,就不用导入了)h=a;// 堆化操作(从顶至底)/* 堆化除叶节点以外的其他所有节点(因为叶节点没有子节点,天然就是合法的子堆,因此无需堆化,所以只需要从它的父节点开始倒序遍历即可) *//* parent(size())为最后一个父节点,如上图的heap[6]=5 */for(int i=parent(size;i>0;i++) down(i);// 因此还可以写成for(int i=size/2;i>0;i++) down(i);大顶堆只要将 ≤/< 换成 ≥/> 即可
从顶至底
void down(int x){ int t=x; if (x*2<=size && h[x*2]<h[t]) t=x*2; if (x*2+1<=size && h[x*2+1]<h[t]) t=x*2+1; if (x!=t) { heap_swap(x,t); down(t); }}解释
// 将元素出堆,或者将一列表的元素入堆使用这种方法void down(int x){ // l=x*2,r=x*2+1; int maxn=x,l=left(x),r=right(x); if (l<=size && h[l]<h[maxn]) maxn=l; //如果l存在,并且... if (r<=size && h[r]<h[x_copy]) maxn=r; if (x!=maxn) // 如果x为最大值,就结束 { heap_swap(x,maxn); //否则交换x与最大值所对应的数 down(maxn); //并且继续向下找有没有更大的,再去交换 }}// 另一个笔记是while递归的方法从底至顶
void up(int x){ while(x/2 && h[x]<h[x/2]) { heap_swap(x,x/2); x>>=1; }}解释
// 将元素单个单个入堆,使用这个方法void up(int x){ while(ture) // while(1) { // 获取其的父节点 (fa=x/2) int fa=parent(x); // 当fa>0(父节点存在) && 堆中位置x的元素比其父节点小时(即违反了小顶堆的性质),继续。否则结束循环 if(fa>0 && h[x]<h[fa]){} else{break;} heap_swap(x,x/2); // 将其与父节点交换 x=p; // 然后递归地向上调整(变成它的父节点) // x>>=1 <==> x=x>>1 }}交换操作
// 交换堆中位置为a和b的两个元素,同时更新它们的映射关系(先后顺序随便)void heap_swap(int a,int b){ swap(h[a],h[b]); // 在堆中交换a与b的值 swap(ih[a],ih[b]); // 它们第几个插入的这个信息也要交换 swap(ph[a],ph[b]); // 交换它们在堆中的位置}// 具体的入堆push()与出堆pop()的操作去看另一个笔记去 //1. 插入一个数 heap[++size]=x;up(size);//2. 求集合中的最小值 heap[1];//3. 删除最小值(堆顶) heap[1]=heap[size];size--;down(1);//4. 删除任意一个元素 heap[k]=heap[size];size--;up(k);down(k);//5. 修改任意一个元素 heap[k]=x;up(k);down(k);链式地址法(拉链法)
#define N (int)ie5+3 // 这是一个大质数 int h[N],e[N],ne[N],idx=0; // 数组模拟邻接表。 (hash 哈希;element 元素;next 下一个) void insert(int x){ int k=(x%N+N)%N; // c++中如果是负数 那他取模也是负的 所以加 N 再 %N 就一定是一个正数, 不然直接 x%N 即可 e[idx]=x; ne[idx]=h[k]; h[k]=idx++; // 用于将-1(false) 改为其他数(true) (从没有存数改为存了数)} bool find(int x){ int k=(x%N+N)%N; // 先获取映射值 for(int i=h[k];i!=-1;i=ne[i]) // 如果第k个h(h[k])中存了数,则不为-1,这里是赋值i为最后一个存在这个链表头的数,然后在通过ne[i]倒着来寻找之前先存在这个链表头中的数,可以看下面的例子来理解 if(e[i]==x]) return true; // 找到就返回“有” return flase;} memset(h, -1, sizeof h); // 如上原因,因此要将h[]先全部初始化赋值成-1后才能正常使用// main函数被省略了// I 为输入 Q 为寻找,每次寻找后都会打印 ( for(int i=0;i<3;i++) cout<<h[i]<<' '<<e[i]<<' '<<ne[i]<<'\n'; )// 下面都是输入的是被100003整除后为1的值I 1Q 1 -1 1 -1 0 0 0 -1 0 0YesI 100004Q 100004 -1 1 -1 1 100004 0 -1 0 0YesI 200007Q 200007 -1 1 -1 2 100004 0 -1 200007 1Yes开放寻址法
const int N=2e5+3 // 一个大质数,因为哈希冲突后会向后寻找可储存的位置,因此数组要开大2~3倍,以减少冲突与聚焦现象const int null=0x3f3f3f3f // INF=106109567 用大于数据范围的数作为空指针(因为数据可能是负数) int h[N]; int find(int x){ int k=(x%N+N)%N; while(h[k]!=null && h[k]!=x) // 如果h[k]中存了数(不能继续存),并且不为要找的数(已经存了)时则继续 { k++; // 线性探测法 if(k==N) k=0; // 如果k探测到数组底部了,就从0开始探测 } return k; // 如果它是空的,就返回它应该存储的位置,否则返回的是查找到的数} // 存储h[find(x)]=x; // 已经存了或是空的时就存储 // 查找if(h[find(x)]!=null) puts("Yes"); // 如果找到了(不为空时),则输出yeselse puts("No");作用:用于查询某个字符串的子串的是否相同(通过以下方法减少哈希冲突以提高准确率)
#define ULL unsigned long longconst int N = 1e5+5,P = 131; // N为大质数,P为P进制数 (P这里取131是因为在很多次询问下都几乎不会出现冲突)ULL h[N],p[N]; // p[]用于存储计算哈希的基数P的幂,如下继续看就知道了 // 通过求区间前缀和的方法来求出子串的哈希值/* 取出前r个字符的哈希值h[r],然后减去前l-1个字符的哈希值乘以P的r-l+1次方。这样得到的结果就是子串str[l ~ r]的哈希值 *//* 因为如下获取整个字符串的哈希值时,P都会×2,因此先计算出P每次×2的前缀和,就方便之后求子串时的相乘与相减*/ULL get(string &s,int l,int r) { return h[r]-[l-1]*p[r-l+1]; }; int main(){ int len,Q; cin>>len>>Q; string s; cin>>s; // 获取整个字符串的哈希值 for(int i=0;i<len;i++) { h[i+1]=h[i]*P+s[i]; // 通过前缀和算法来计算前n个字母为P进制的情况下的哈希值 p[i+1]=p[i]*P; // 如上解释,计算哈希的基数P的幂 } // Q次询问 while(Q--) { int l1,r1,l2,r2; cin>>l1>>r1>>l2>>r2; if( get(l1,r1)==get(l2,r2) ) puts("Yes"); // 如果两子串的哈希值相同,说明其相同(暂且不考虑哈希冲突的问题) else puts("No\n"); } } vector, 可变数组/列表,倍增的思想 size() 返回元素个数 empty() 返回是否为空 clear() 清空 front()/back() push_back()/pop_back() begin()/end() [] 支持比较运算,按字典序 pair<int, int> first, 第一个元素 second, 第二个元素 支持比较运算,以first为第一关键字,以second为第二关键字(字典序) string,字符串 size()/length() 返回字符串长度 empty() clear() substr(起始的下标,(子串的长度) ) 作用:返回子串 c_str() 返回字符串所在字符数组的起始地址 queue, 队列 size() empty() push() 向队尾插入一个元素 front() 返回队头元素 back() 返回队尾元素 pop() 弹出队头元素 priority_queue, 优先队列,默认是大根堆 size() empty() push() 插入一个元素 top() 返回堆顶元素 pop() 弹出堆顶元素 定义成小根堆的方式:priority_queue<int, vector<int>, greater<int>> q; stack, 栈 size() empty() push() 向栈顶插入一个元素 top() 返回栈顶元素 pop() 弹出栈顶元素 deque, 双端队列 size() empty() clear() front()/back() push_back()/pop_back() push_front()/pop_front() begin()/end() [] 支持像数组一样使用[]来选择某一个元素并改变它,queue和stack都不支持这种随机访问,都只提供了有限的操作 // set,map的元素是唯一的。multiset, multimap的元素是可以重复的// set,map中重复的 元素/键 不会合并。而multiset, multimap中重复的 元素/键 会合并// set 集合,用于存储元素。map是哈希表,用于存储键值对set, map, multiset, multimap, 基于平衡二叉树(红黑树),动态维护有序序列 size() empty() clear() begin()/end() ++, -- 返回前驱和后继,时间复杂度 O(logn) set/multiset insert() 插入一个数 find() 查找一个数 count() 返回某一个数的个数 erase() (1) 输入是一个数x,删除所有x O(k + logn) (2) 输入一个迭代器,删除这个迭代器 lower_bound()/upper_bound() lower_bound(x) 返回大于等于x的最小的数的迭代器(包括x) upper_bound(x) 返回大于x的最小的数的迭代器(不包括x) map/multimap insert() 插入的数是一个pair erase() 输入的参数是pair或者迭代器 find() [] 注意multimap不支持此操作。 时间复杂度是 O(logn) lower_bound()/upper_bound() unordered_set, unordered_map, unordered_multiset, unordered_multimap, 这四个是基于哈希表,而不是基于红黑树的,因此它们中的元素是无序的 和上面类似,增删改查的时间复杂度是 O(1) 所以不支持 lower_bound()/upper_bound(), 迭代器的++,-- bitset, 用于位运算,其相比与直接使用bool类型的数组,会节省8倍内存空间(真正的一个bool值占1位,而不是一个字节) bitset<10000> s; 这个中间是个数 bitset<8> bs(42); 42的二进制表示是00101010,其中记录的是b[1]:1,b[3]:1,b[5]:1。直接输出bs会输出 00101010 ~, &, |, ^ >>, << ==, != [] count() 返回有多少位为1 any() 判断是否至少有一个1 none() 判断是否全为0 set() 把所有位置成1 set(k, v) 将第k位变成v(v为0或1) reset() 把所有位变成0 flip() 等价于~(¬)(反转所有位) flip(k) 把第k位取反树是一种特殊的图,与图的存储方式相同。
对于无向图中的边 ab,存储两条有向边 a->b, b->a。
因此我们可以只考虑有向图的存储。
g[a][b] 存储边 a->b方法一创建:
// 对于每个点k,开一个单链表,存储k所有可以走到的点。h[k]存储这个单链表的头结点int h[N], e[N], ne[N], idx; // 添加一条边a->bvoid add(int a, int b){ e[idx] = b, ne[idx] = h[a], h[a] = idx ++ ;} // 初始化idx = 0;memset(h, -1, sizeof h);方法二创建:
// 在C++中,这将创建一个大小为100000的数组,每个元素都是一个 vector<int>。这种结构常常被用于创建邻接表来表示图。 vector<int> a[100000];// 创建动态的:vector<vector<int>> a(节点数);使用栈(递归)来搜索
空间复杂度
特点:回溯、剪枝
使用方法一的邻接表:
int dfs(int x){ vis[x] = true; // vis[x] 表示点x已经被遍历过 for (int i=h[x];i!=-1;i=ne[i]) { int j = e[i]; if (!vis[j]) dfs(j); }}使用队列来搜索
空间复杂度
特点:有最短路的特性
使用方法一的邻接表:
queue<int> q;vis[1] = true; // 表示1号点已经被遍历过q.push(1); while (q.size()){ int t = q.front(); q.pop(); for (int i=h[t];i!=-1;i=ne[i]) { int j = e[i]; if (!vis[j]) { vis[j] = true; // 表示点j已经被遍历过 q.push(j); } }}#include <bits/stdc++.h>using namespace std; vector<vector<int>> a(100); // adj_list 邻接表vector<bool> visited(100, false); // 已访问 // DFSvoid dfs(int node) { visited[node] = true; cout << node << ' '; for (int i=0;i<a[node].size(); i++) { int next_node = a[node][i]; if (!visited[next_node]) { dfs(next_node); } }} // BFSvoid bfs(int start_node) { queue<int> q; q.push(start_node); visited[start_node] = true; while (!q.empty()) { int node = q.front(); q.pop(); cout << node << ' '; for (int i = 0; i < a[node].size(); i++) { int next_node = a[node][i]; if (!visited[next_node]) { q.push(next_node); visited[next_node] = true; } } }} int main() { // 添加边和节点到邻接表 // ... // 执行DFS cout << "DFS: "; dfs(0); // 从节点0开始 cout << endl; // 重置visited数组 fill(visited.begin(), visited.end(), false); // 执行BFS cout << "BFS: "; bfs(0); // 从节点0开始 cout << endl; return 0;}topology sort
时间复杂度为 ,表示顶点数, 表示边数
用于确定各种东西的依赖关系,如谁是谁的必要条件等
#include <vector>#include <queue>using namespace std; // n为节点的数量vector<int> topoSort(int n, vector<pair<int, int>>& a) { vector<vector<int>> adj(n, vector<int>()); // 将输入变为邻接表 vector<int> cnt(n, 0); vector<int> res; // 结果数组 queue<int> q; // 记录当前节点有多少的指向它的边(入度) for (auto &i : a) { adj[i.second].push_back(i.first); // 将键值对输入通过邻接表来储存 cnt[i.first]++; } // 将入度为0的点放入队列中 for (int i = 0; i < n; i++) { if (cnt[i] == 0) { q.push(i); } } // 广度优先遍历啦~ while (!q.empty()) { int now = q.front(); q.pop(); // 有时now也用current->curr当前的 来表示 res.push_back(now); for (auto &next : adj[now]) { if (--cnt[next] == 0) { // 因为这里每次减1,若有环的情况会把环拆掉,因此不会出现死循环的情况 q.push(next); } } } // 之后判断是否是一个有向无环图,否则说明图中存在环 if (res.size() != n) { return {}; } return res;}无注释版
#include <vector>#include <queue>using namespace std; // n为节点的数量vector<int> topoSort(int n, vector<pair<int, int>>& a) { vector<vector<int>> adj(n, vector<int>()); vector<int> cnt(n, 0); vector<int> res; queue<int> q; for (auto &i : a) { adj[i.second].push_back(i.first); cnt[i.first]++; } for (int i = 0; i < n; i++) if (cnt[i] == 0) q.push(i); while (!q.empty()) { int now = q.front(); q.pop(); res.push_back(now); for (auto &next : adj[now]) if (--cnt[next] == 0) q.push(next); } if (res.size() != n) { return {}; } return res;}求最短路的算法属于图论中的路径算法。
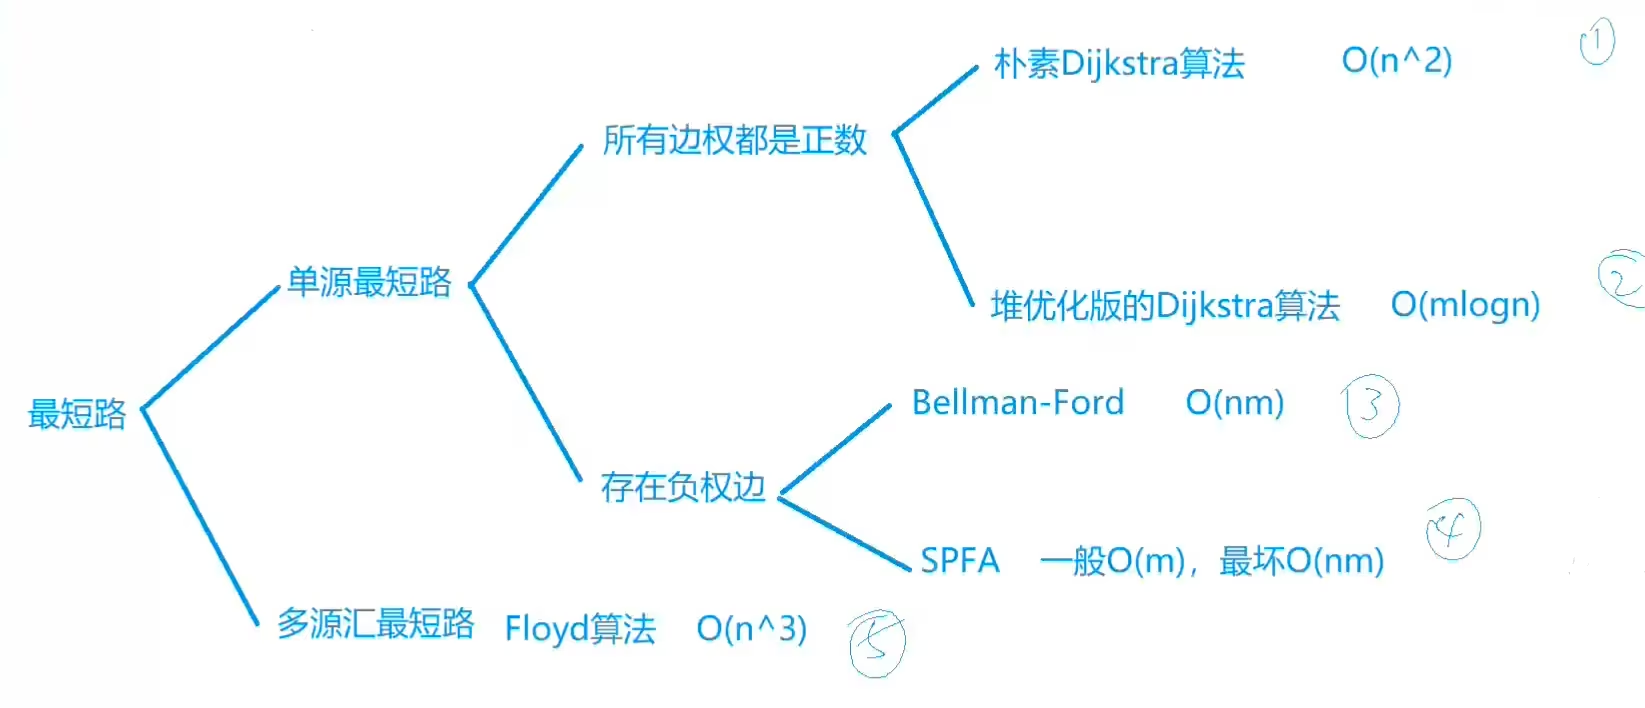
适用于单源最短路径问题,且边的权重不为负
时间复杂是 , 表示点数, 表示边数
贪心算法
#include <bits/stdc++.h>using namespace std; // n为节点的数量// 求某单点到其他点的最短路算法,start为起点// 使用pair来储存指向的点与其权重vector<int> dijkstra(int start, vector<vector<pair<int, int>>> &a) { int len = a.size(); vector<int> res(len, INT_MAX); // 定义结果数组 res[start] = 0; // 起点到起点的距离为0 vector<bool> visited(len, false); // 是否检查过某一点 for (int i = 0; i < len; ++i) { // 取出没检查过的,到所求点距离最短的桥梁点 int minDistance = INT_MAX; int minIndex = -1; for (int j = 0; j < len; j++) { if (!visited[j] && res[j] < minDistance) { minDistance = res[j]; minIndex = j; } } // 如果取不出来,说明已循环完所有点(顶点数<数组大小)结束循环 if (minIndex == -1) {break;} visited[minIndex] = true; for (auto &edge : a[minIndex]) { int vertex = edge.first; // 桥梁点(vertex顶点) int weight = edge.second; if (res[minIndex] + weight < res[vertex]) { res[vertex] = res[minIndex] + weight; } } } return res;} int main() { vector<vector<pair<int, int>>> a = { {{1, 2}, {3, 6}}, {{0, 2}, {2, 3}, {3, 2}}, {{1, 3}, {3, 2}}, {{0, 6}, {1, 2}, {2, 2}} }; vector<int> result = dijkstra(0,a); for (int i : result) { cout << i << endl; } return 0;}时间复杂是 , 表示点数, 表示边数
// 1. 创建一个优先队列,用于存放待处理的节点,节点的排序基于其到起始节点的距离。// 2. 创建一个距离数组,用于存放起始节点到每个节点的最短距离,初始时,起始节点到自身的距离为0,到其他节点的距离为无穷大。// 3. 将起始节点加入优先队列。// 4. 当优先队列不为空时,执行以下操作:// - 从优先队列中取出距离最短的节点。// - 遍历该节点的所有邻居,如果通过当前节点到达邻居的距离小于已知的最短距离,那么更新最短距离,并将邻居节点加入优先队列。#include <vector>#include <queue>#include <limits> using namespace std; typedef pair<int, int> pii; vector<int> dijkstra(int start, vector<vector<pii>>& adj) { int n = adj.size(); vector<int> dist(n, INT_MAX); priority_queue<pii, vector<pii>, greater<pii>> heap; dist[start] = 0; heap.push({0, start}); while (!pq.empty()) { int u = heap.top().second; heap.pop(); for (auto& i : adj[u]) { if (dist[i.first] > dist[u] + i.second) { dist[i.first] = dist[u] + i.second; heap.push({dist[i.first], i.first}); } } } return dist;} // 这个函数接受两个参数:起始节点的索引(`start`)和一个邻接列表(`adj`)。邻接列表中的每个元素是一个 pair,其中 `first` 是邻居节点的索引,`second` 是边的权重。函数返回一个包含所有节点的最短距离的列表。适用于单源最短路径问题,
可以处理包含负权重的边,但不能处理包含负权重循环的图。时间复杂是 , 表示点数, 表示边数
Bellman-Ford 算法的基本步骤如下:
初始化所有顶点的距离值。源顶点的距离值设为 0,所有其他顶点的距离值设为无穷大(表示我们还没有找到到达它们的路径)。
对图中的所有边进行|V|-1 次迭代(V 是顶点的数量)。在每次迭代中,我们都会检查所有的边,并尝试通过这些边进行松弛操作。松弛操作是指,如果我们可以通过某条边找到一条到达某个顶点的更短路径,我们就更新这个顶点的距离值。
松弛: dist[b] = min(dist[b], backup[a] + w);最后,我们再次检查所有的边,看看是否存在负权重的循环。如果存在,我们就报告错误,因为在这种情况下,最短路径是未定义的。如果不存在,算法就成功完成了。
如果图中存在负权重的循环,那么最短路径就无法定义,因为我们可以无限次地遍历这个循环,每次都会得到一个更短的路径。因此,Bellman-Ford 算法在主循环之后会进行一次额外的迭代,检查是否存在负权重的循环。如果存在,算法就会报告错误。
#include <iostream>#include <vector>#include <limits> using namespace std; // 点A,点B,点A到点B的距离(权重)struct Edge { int a, b, w;}; vector<Edge> edges = { {0, 1, -1}, {0, 2, 4}, {1, 2, 3}, {1, 3, 2}, {1, 4, 2}, {3, 1, 1}, {3, 2, 5}, {4, 3, -3}}; // V是顶点,Edge是边,src为初始顶点void bellmanFord(int V, int start) { // dist[x]存储1到x的最短路距离 vector<int> dist(V, INT_MAX); dist[start] = 0; // 放松所有边缘V-1次 for (int i = 1; i <= V - 1; i++) { for (int j=0; j < edges.size(); j++) { int a = edges[j].a; int b = edges[j].b; int w = edges[j].w; if (dist[b] > dist[a] + w && dist[a] != INT_MAX) { dist[b] = dist[a] + w; } } } // 检查负重周期 for (int i=0; i < edges.size(); i++) { int a = edges[i].a; int b = edges[i].b; int w = edges[i].w; if (dist[b] > dist[a] + w && dist[a] != INT_MAX) { cout << "图包含负重周期" << endl; return; } } // 打印最短的距离 for (int i = 0; i < V; i++) { cout << "从源点到顶点" << i << "的最短距离是" << dist[i] << endl; }} int main() { int V = 5; // 图中的顶点数 int start = 0; // 源顶点 bellmanFord(V, start); return 0;}时间复杂度 ,最坏为
SPFA(Shortest Path Faster Algorithm)是一种用于寻找图中最短路径的算法。它是 Bellman-Ford 算法的一种改进,通过使用队列优化了 Bellman-Ford 算法的效率。
这个算法的优点是实现简单,适用范围广,可以处理负权边,而且在稀疏图上的效率比 Dijkstra 算法更高。但是,它也有一些缺点,比如在处理负权环时可能会陷入无限循环,需要特殊处理。
步骤:
实现:
#include <bits/stdc++.h>using namespace std;const int MAXN = 1000; // 或者说是总顶点数Nconst int INF = 1e9;vector<pair<int, int>> adj[MAXN]; // 邻接表,存储边的信息int dist[MAXN]; // 距离数组bool in_queue[MAXN]; // 记录节点是否在队列中queue<int> q; void spfa(int s) { // s为开始点 fill(dist, dist + MAXN, INF); memset(in_queue, 0, sizeof(in_queue)); dist[s] = 0; q.push(s); in_queue[s] = true; while (!q.empty()) { int now = q.front(); q.pop(); in_queue[now] = false; for (auto &i : adj[now]) { int v = i.first, w = i.second; // v为now的邻接节点 if (dist[v] < dist[now] + w) { dist[v] = dist[now] + w; if (!in_queue[v]) { q.push(v); in_queue[v] = true; } } } }} int main() { // 添加边的信息到邻接表 // 调用 spfa 函数 spfa(0); // 假设起点为 0 return 0;}对于非负的自环,因为权重为正,因此它无法被构成最短路径,所以不用处理。
但对于负环,就如下判断
❤为多加的
在使用 SPFA 算法时,如果图中存在负权环,算法可能会陷入无限循环。为了解决这个问题,我们可以在算法中添加一个检测负权环的步骤。
一种常见的方法是使用一个计数器数组,记录每个节点进入队列的次数。如果某个节点进入队列的次数超过节点总数,那么就存在负权环。
#include <bits/stdc++.h>using namespace std;const int MAXN = 1000;const int INF = 1e9;vector<pair<int, int>> adj[MAXN]; // 邻接表,存储边的信息int dist[MAXN]; // 距离数组bool in_queue[MAXN]; // 记录节点是否在队列中int cnt[MAXN]; // 记录节点进入队列的次数queue<int> q; bool spfa(int s, int n) { fill(dist, dist + MAXN, INF); memset(in_queue, 0, sizeof(in_queue)); memset(cnt, 0, sizeof(cnt)); // ❤ dist[s] = 0; q.push(s); in_queue[s] = true; while (!q.empty()) { int u = q.front(); q.pop(); in_queue[u] = false; for (auto &p : adj[u]) { int v = p.first, w = p.second; if (dist[u] + w < dist[v]) { dist[v] = dist[u] + w; if (!in_queue[v]) { q.push(v); in_queue[v] = true; if (++cnt[v] > n) return false; // 存在负权环❤ } } } } return true; // 不存在负权环 ❤} int main() { // 添加边的信息到邻接表 // 调用 spfa 函数 int n = 5; // 假设节点总数为 5 bool noNegativeCycle = spfa(0, n); // 假设起点为 0 ❤ if (!noNegativeCycle) { cout << "存在负权环" << endl; } return 0;}时间复杂度是 , 表示点数
它属于动态规划
Floyd-Warshall 算法是一种用于找到给定加权图中所有顶点对之间的最短路径的算法。它可以处理正权和负权边,但不能处理负权环。
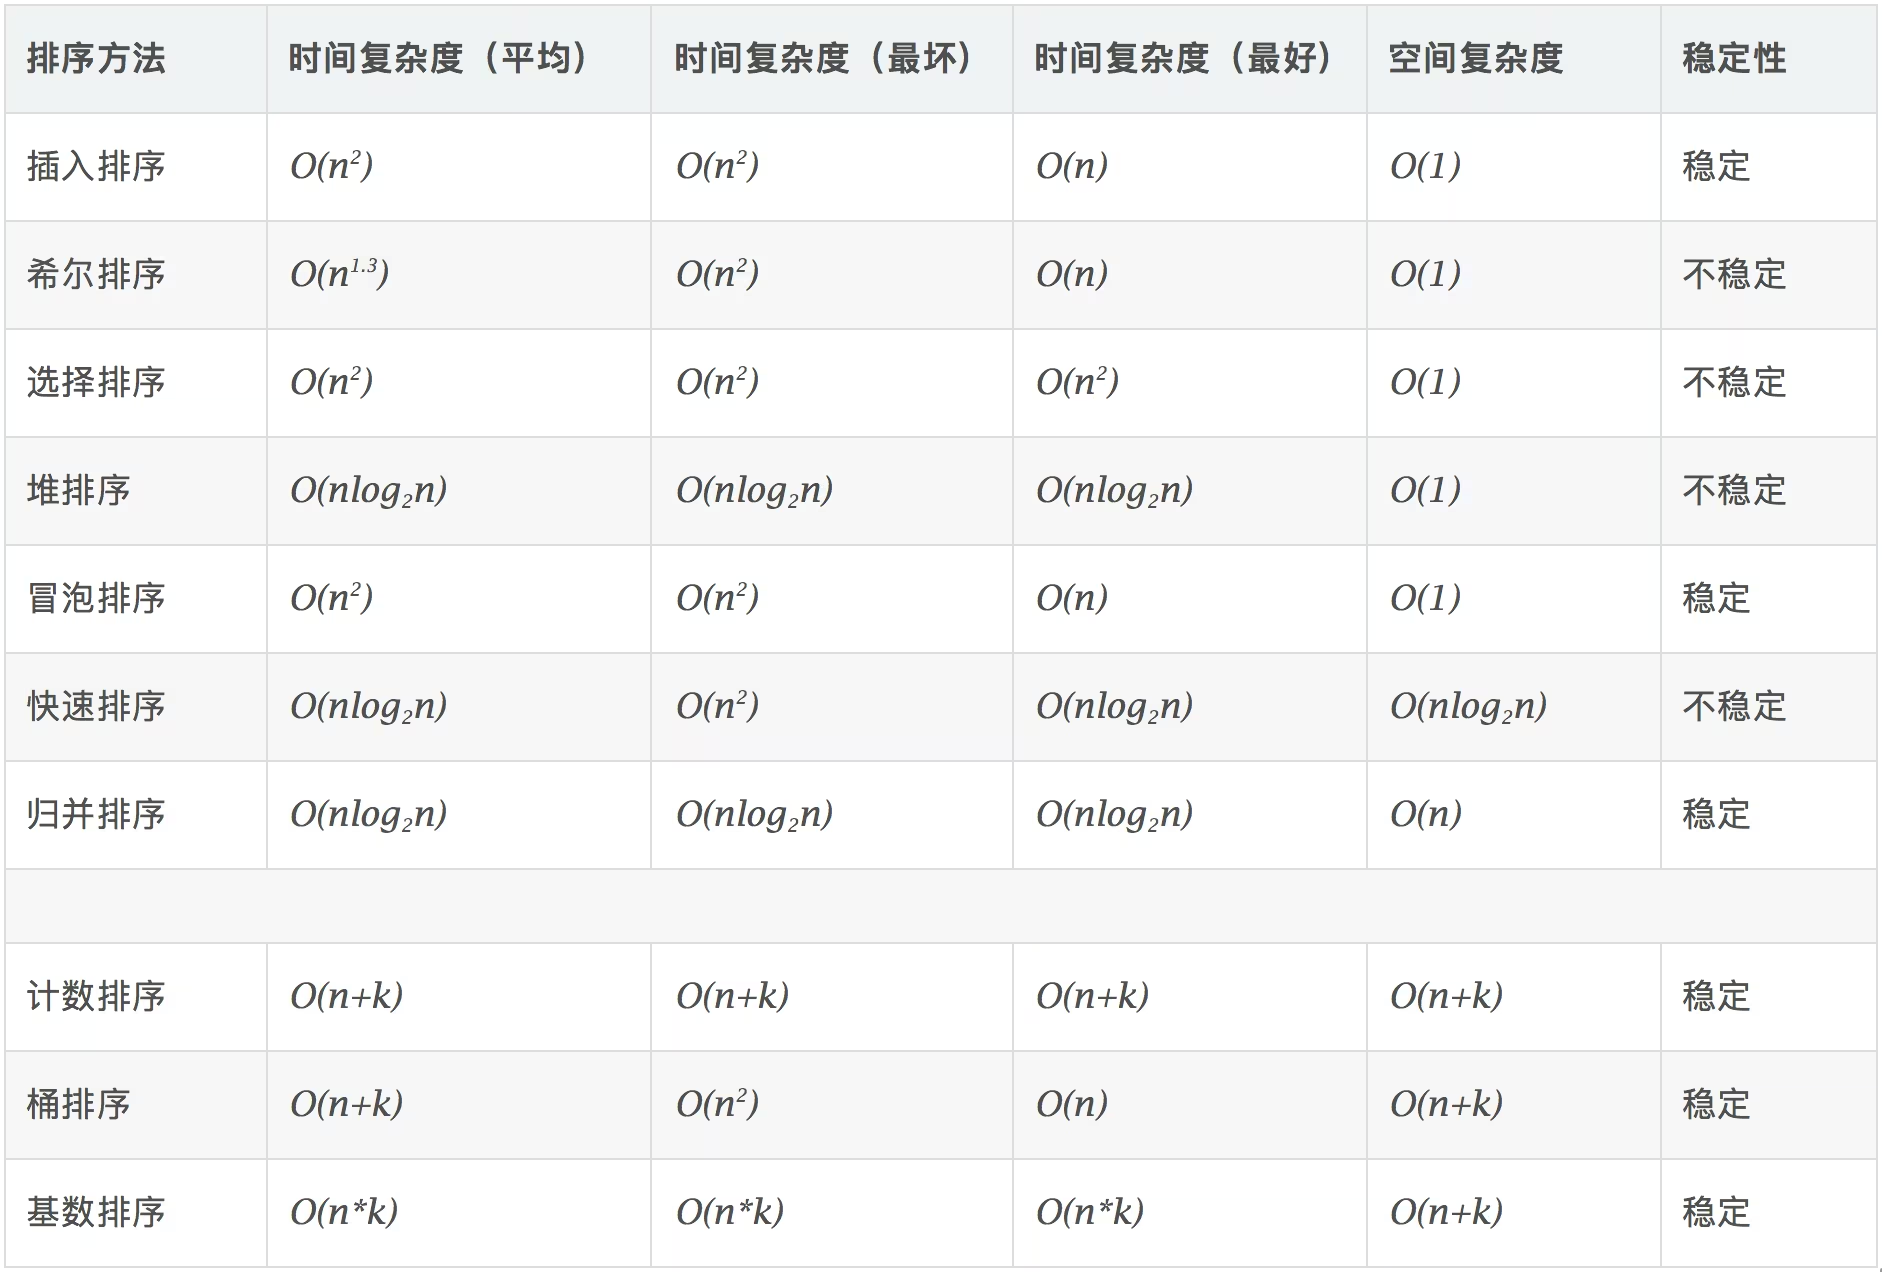
#include <bits/stdc++.h>using namespace std;const int MAXN = 500;const int INF = 1e9;int dist[MAXN][MAXN]; // 使用的是邻接矩,因为方便存储与更新 void floydWarshall(int n) { for (int k = 0; k < n; k++) { for (int i = 0; i < n; i++) { for (int j = 0; j < n; j++) { if (dist[i][k] < INF && dist[k][j] < INF) dist[i][j] = min(dist[i][j], dist[i][k] + dist[k][j]); } } }} int main() { int n = 5; // 假设节点总数为 5 // 初始化距离邻接矩阵 for (int i = 0; i < n; i++) { for (int j = 0; j < n; j++) { if (i == j) dist[i][j] = 0; else dist[i][j] = INF; // 默认为两点间没有边 } } // 添加边的信息到距离数组 // 调用 floydWarshall 函数 floydWarshall(n); // n 为顶点数 return 0;}图片版:
文字版:
这四种算法都是用于求解图中最短路径问题的,但它们各有适用的场景和优势:
所以,哪种算法“更好”取决于具体的问题和图的特性。例如,如果你需要求解单源最短路径问题,并且图中没有负权边,那么 Dijkstra 算法可能是最好的选择。如果图中有负权边,但没有负权环,那么 Bellman-Ford 或 SPFA 算法可能更适合。如果你需要求解所有节点对之间的最短路径问题,那么 Floyd-Warshall 算法可能是最好的选择。
最小生成树(Minimum Spanning Tree,MST)是图论中的一个重要概念。在一个连通图中,生成树是这个图的一棵包含所有顶点的无环连通子图。而最小生成树则是所有生成树中,所有边的权重和最小的一棵。
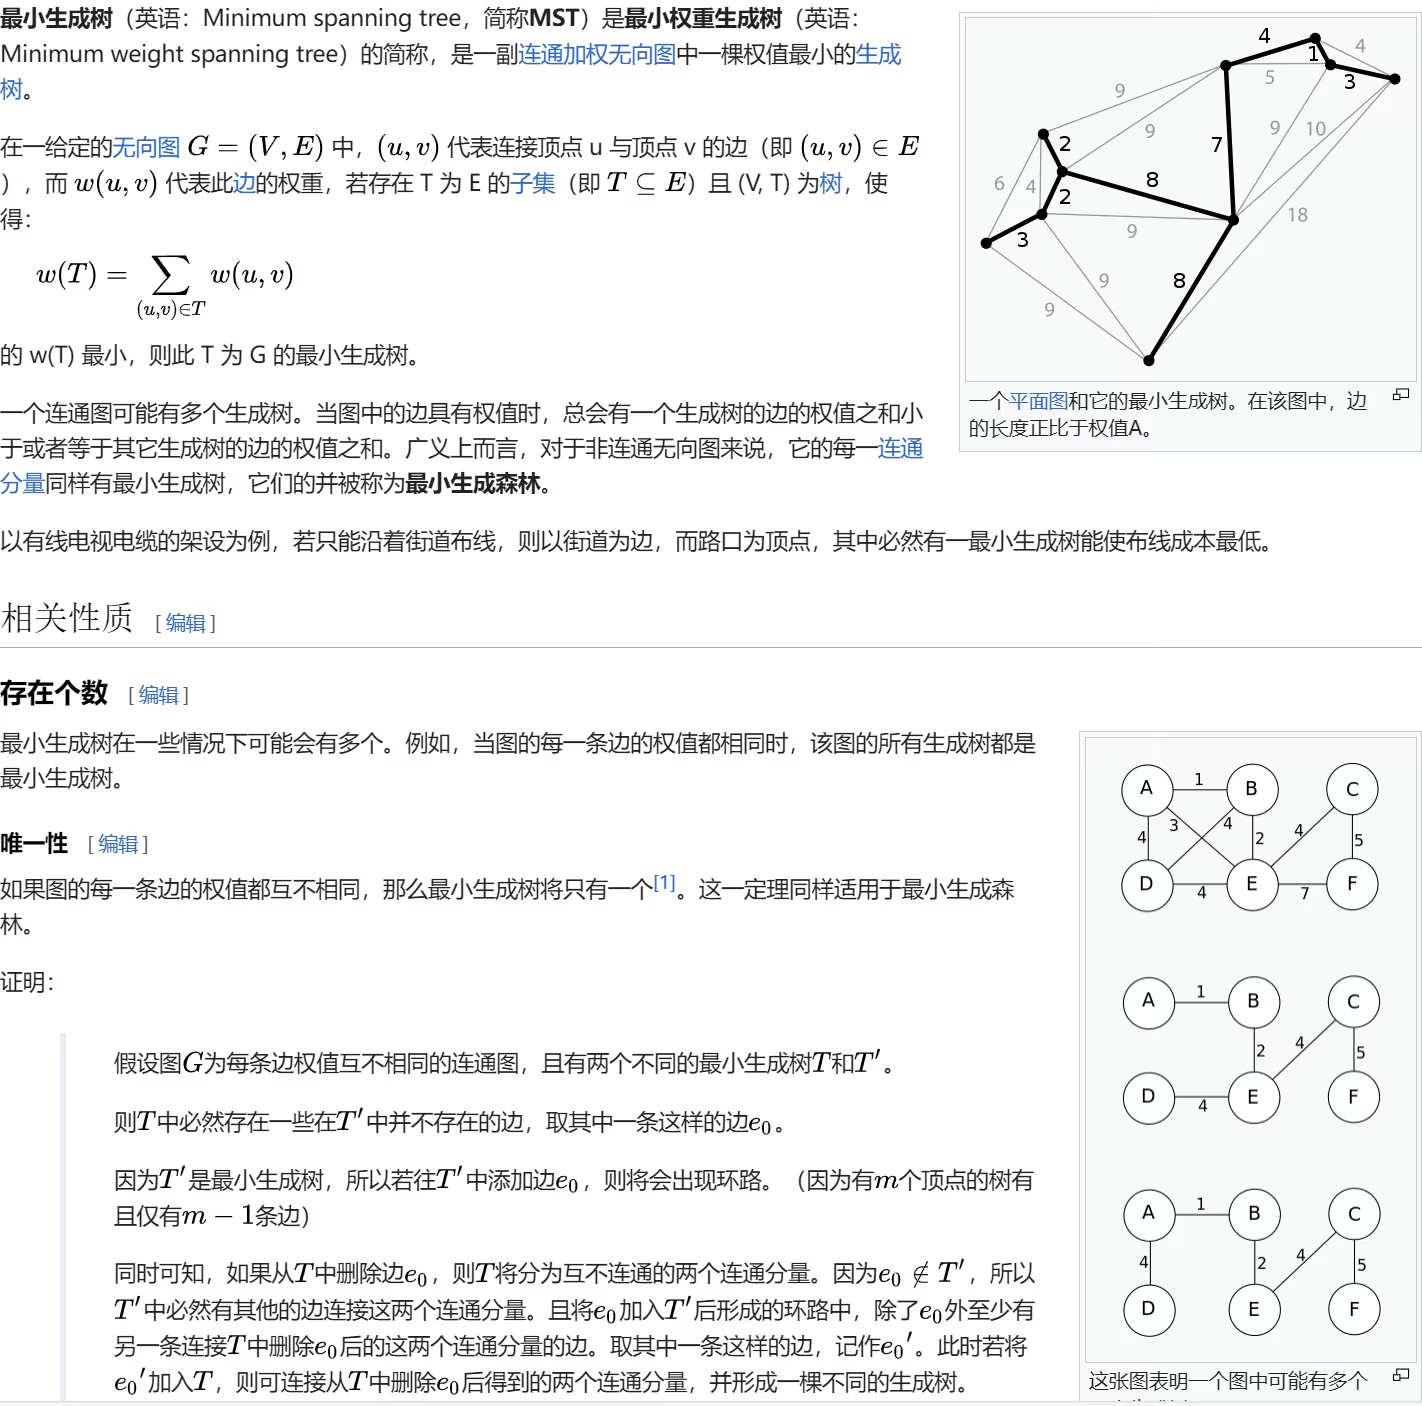
求解最小生成树的常用算法有 Kruskal 算法和 Prim 算法。这两种算法都是贪心算法,通过在每一步选择局部最优解(最小的边),来达到全局最优解(最小生成树)。
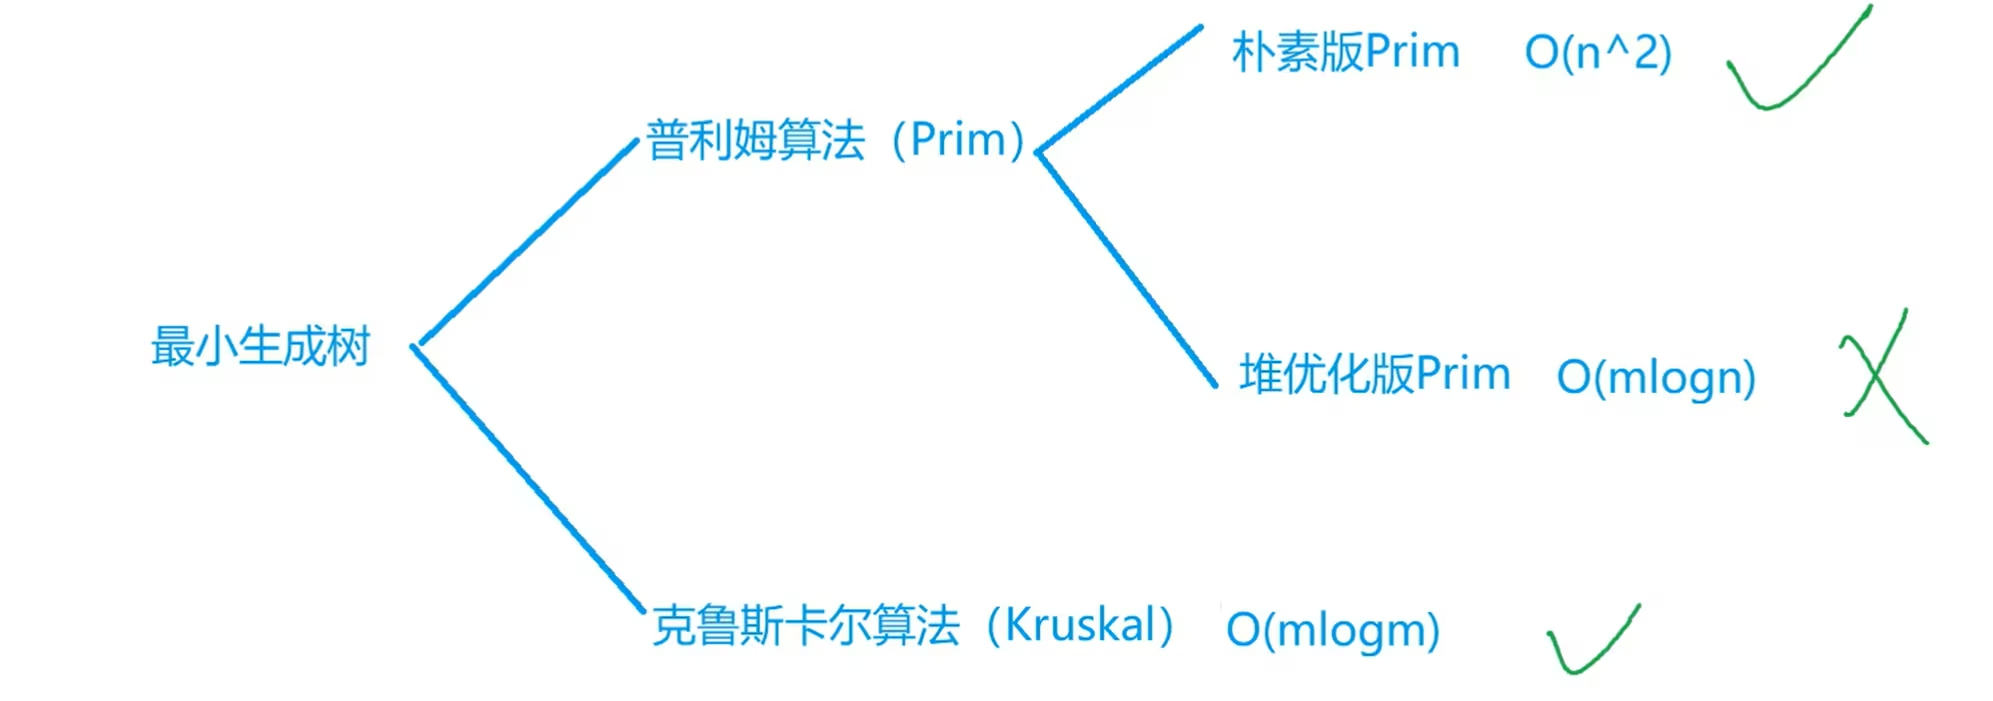
最小生成树问题中,不包含负权重的边
因为在最小权重生成树中,权值最短的边一定在最小生成树中,
又因为贪心算法的属性:一个局部最优解也是全局最优解,
因此解决最小生成树问题的算法,使用最多的都是贪心算法(因为也最快)
这里的邻接表换成邻接矩阵的空间复杂度也差不多
至于为什么不用堆优化版的,因为太复杂的在竞赛中不好写
#include <bits/stdc++.h>using namespace std;const int MAXN = 500;const int INF = 1e9;int dist[MAXN];bool visited[MAXN];vector<pair<int, int>> adj[MAXN]; // 邻接表,存储每个节点的邻居和对应的边的权重 void prim(int n) { for (int i = 0; i < n; i++) { dist[i] = INF; visited[i] = false; } dist[0] = 0; for (int i = 0; i < n; i++) { int now = -1; // now有时又叫u for (int j = 0; j < n; j++) { if (!visited[j] && (now == -1 || dist[j] < dist[now])) { now = j; } } if (dist[now] == INF) { cout << "图不连通" << endl; return; } visited[now] = true; for (auto &e : adj[now]) { int v = e.first, w = e.second; if (!visited[v] && w < dist[v]) { dist[v] = w; } } }} int main() { int n = 5; // 假设节点总数为 5 // 添加边的信息到邻接表 // 调用 prim 函数 prim(n); return 0;}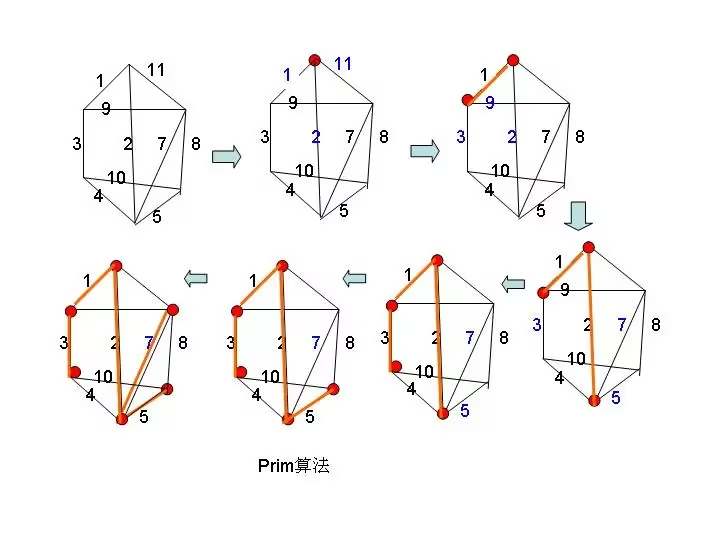
#include <bits/stdc++.h>using namespace std;const int MAXN = 500;// 存储每条边的权重和两个端点// 要先储存权重,因为下面的sort是根据权重来排序的vector<pair<int, pair<int, int>>> edges;int parent[MAXN]; // 并查集数组,用于判断两个节点是否在同一个连通分量中int cnt=0; int find(int x) { if (parent[x] != x) { parent[x] = find(parent[x]); } return parent[x];} void kruskal(int n) { sort(edges.begin(), edges.end()); for (int i = 0; i < n; i++) { parent[i] = i; } for (auto &i : edges) { int w = i.first, u = i.second.first, v = i.second.second; // 合并集合 int u = find(u), v = find(v); if (u != v) { // 如果条件成立这条边是最小生成树的一部分,可以将其添加到结果中 parent[u] = v; cnt ++ ; // 若要问最小生成树的树边权重之和,这里每次新增都可以加一下(res+=w),最后结尾时return返回一下即可 } } if (cnt < n - 1){ cout << "图不连通" << endl; return; }} int main() { int n = 5; // 假设节点总数为 5 // 添加边的信息到 edges 数组 // 调用 kruskal 函数 kruskal(n); return 0;}Kruskal 算法和 Prim 算法都是用于求解最小生成树问题的贪心算法,但它们的工作方式有所不同。
工作原理:
数据结构:
适用场景:
处理负权重边:
总的来说,Kruskal 算法和 Prim 算法各有优势,适用于不同的场景。在实际使用时,可以根据具体的问题特性来选择合适的算法。
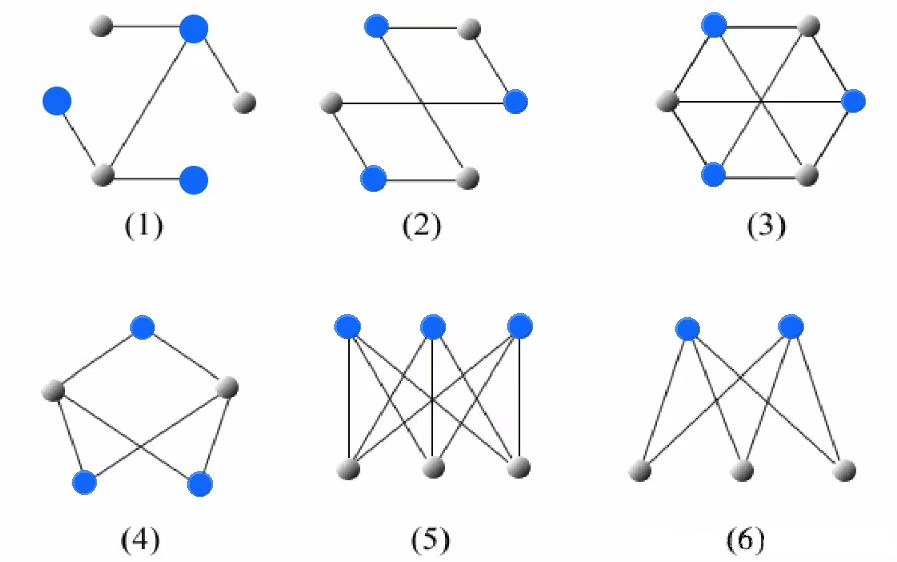
在离散数学中又称二部图。
把一个图的顶点划分为两个不相交子集 ,使得每一条边都分别连接两个集合中的顶点的图就是二分图
如下 图(1) ,被分为了灰色与蓝色两组,并且同组的点不与同组的点相连
为什么二分图中不存在奇数环
二分图的定义是:图的所有顶点可以分成两个互不相交的集合,使得每条边的两个端点分别属于这两个不同的集合。换句话说,二分图中的任何一条简单路径(没有重复的顶点和边)都是从一个集合跳到另一个集合,然后再跳回来。
如果二分图中存在一个奇数长度的环,那么这个环的起点和终点必然在同一个集合中,这与二分图的定义矛盾。因为在奇数长度的环中,经过奇数次跳跃后,你会回到起始点,这意味着起始点和终点在同一个集合中。
因此,二分图中不存在奇数环。
如上也可以发现,任意每个环的边都是偶数个的
二分图常用的算法
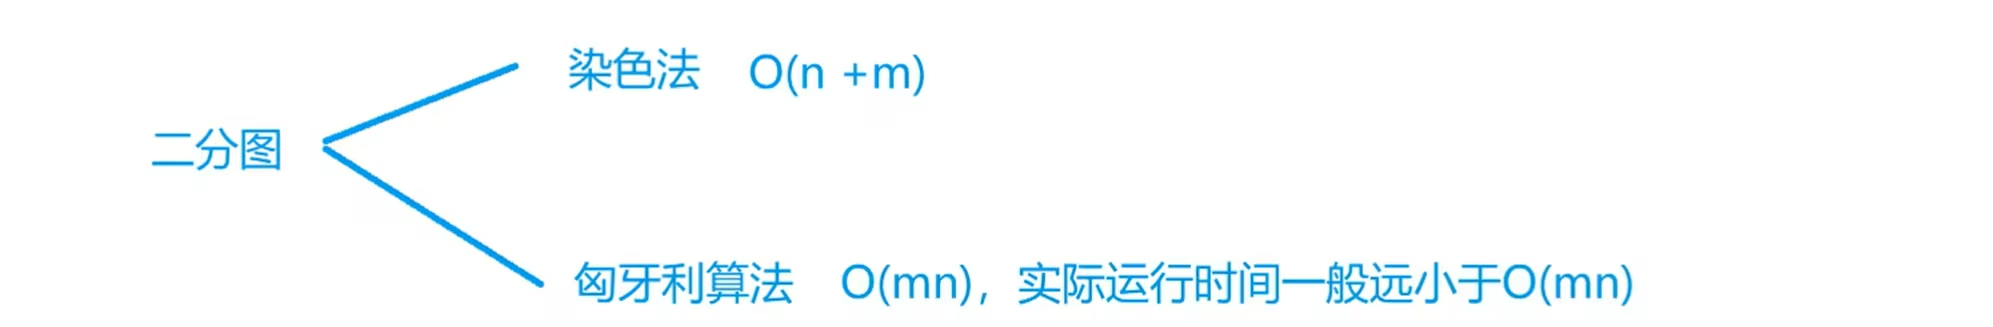
时间复杂度
由上定义可知
两被一条边连接的顶点(相邻顶点),一定是不同颜色的,这样才是二分图
因此,代码如下:
#include <bits/stdc++.h>using namespace std;const int MAXN = 500;vector<int> a[MAXN]; // 邻接表表示图int color[MAXN]; // 存储每个节点的颜色 bool dfs(int u, int c) { color[u] = c; // 将节点u染色为c for (int v : a[u]) { // 如果相邻的节点v已被染色,且颜色与u相同,则返回false // 如果相邻的节点v未被染色,尝试染成-c,如果失败则返回false if (color[v] == c || (!color[v] && !dfs(v, -c))) { return false; } } return true;} bool isBipartite(int n) { // n是节点数 // 这里是默认为0,染色为1与-1,因为“!(-1)==!(1)==0” memset(color, 0, sizeof(color)); for (int i = 1; i <= n; i++) { // 如果没染色,就去染色再判断;否则若已经染色,就跳过 if (!color[i] && !dfs(i, 1)) { return false; } } return true;}xiōng
时间复杂度 ,实际运行时间一般远小于
匈牙利算法是一种用于解决最大二分匹配问题的经典算法。二分匹配问题是这样的问题:给定一个二分图,找到一种方式,使得图中的边连接的两个顶点之间没有其他的连接边,并且这样的边是尽可能多的。
假如你是红娘,可以撮合任何一对有暧昧关系的男女,那么你最多能成全多少对情侣?(数学表述:在二分图中最多能找到多少条没有公共端点的边)
匈牙利算法的基本思想是,从一个未匹配的点开始,沿着增广路径寻找可能的匹配。增广路径是一条交替的路径,它从一个未匹配的点开始,然后走到一个匹配的边,再走到一个未匹配的边,如此反复,直到另一个未匹配的点。找到增广路径后,就可以通过交换匹配和未匹配的边来增加匹配的数量。
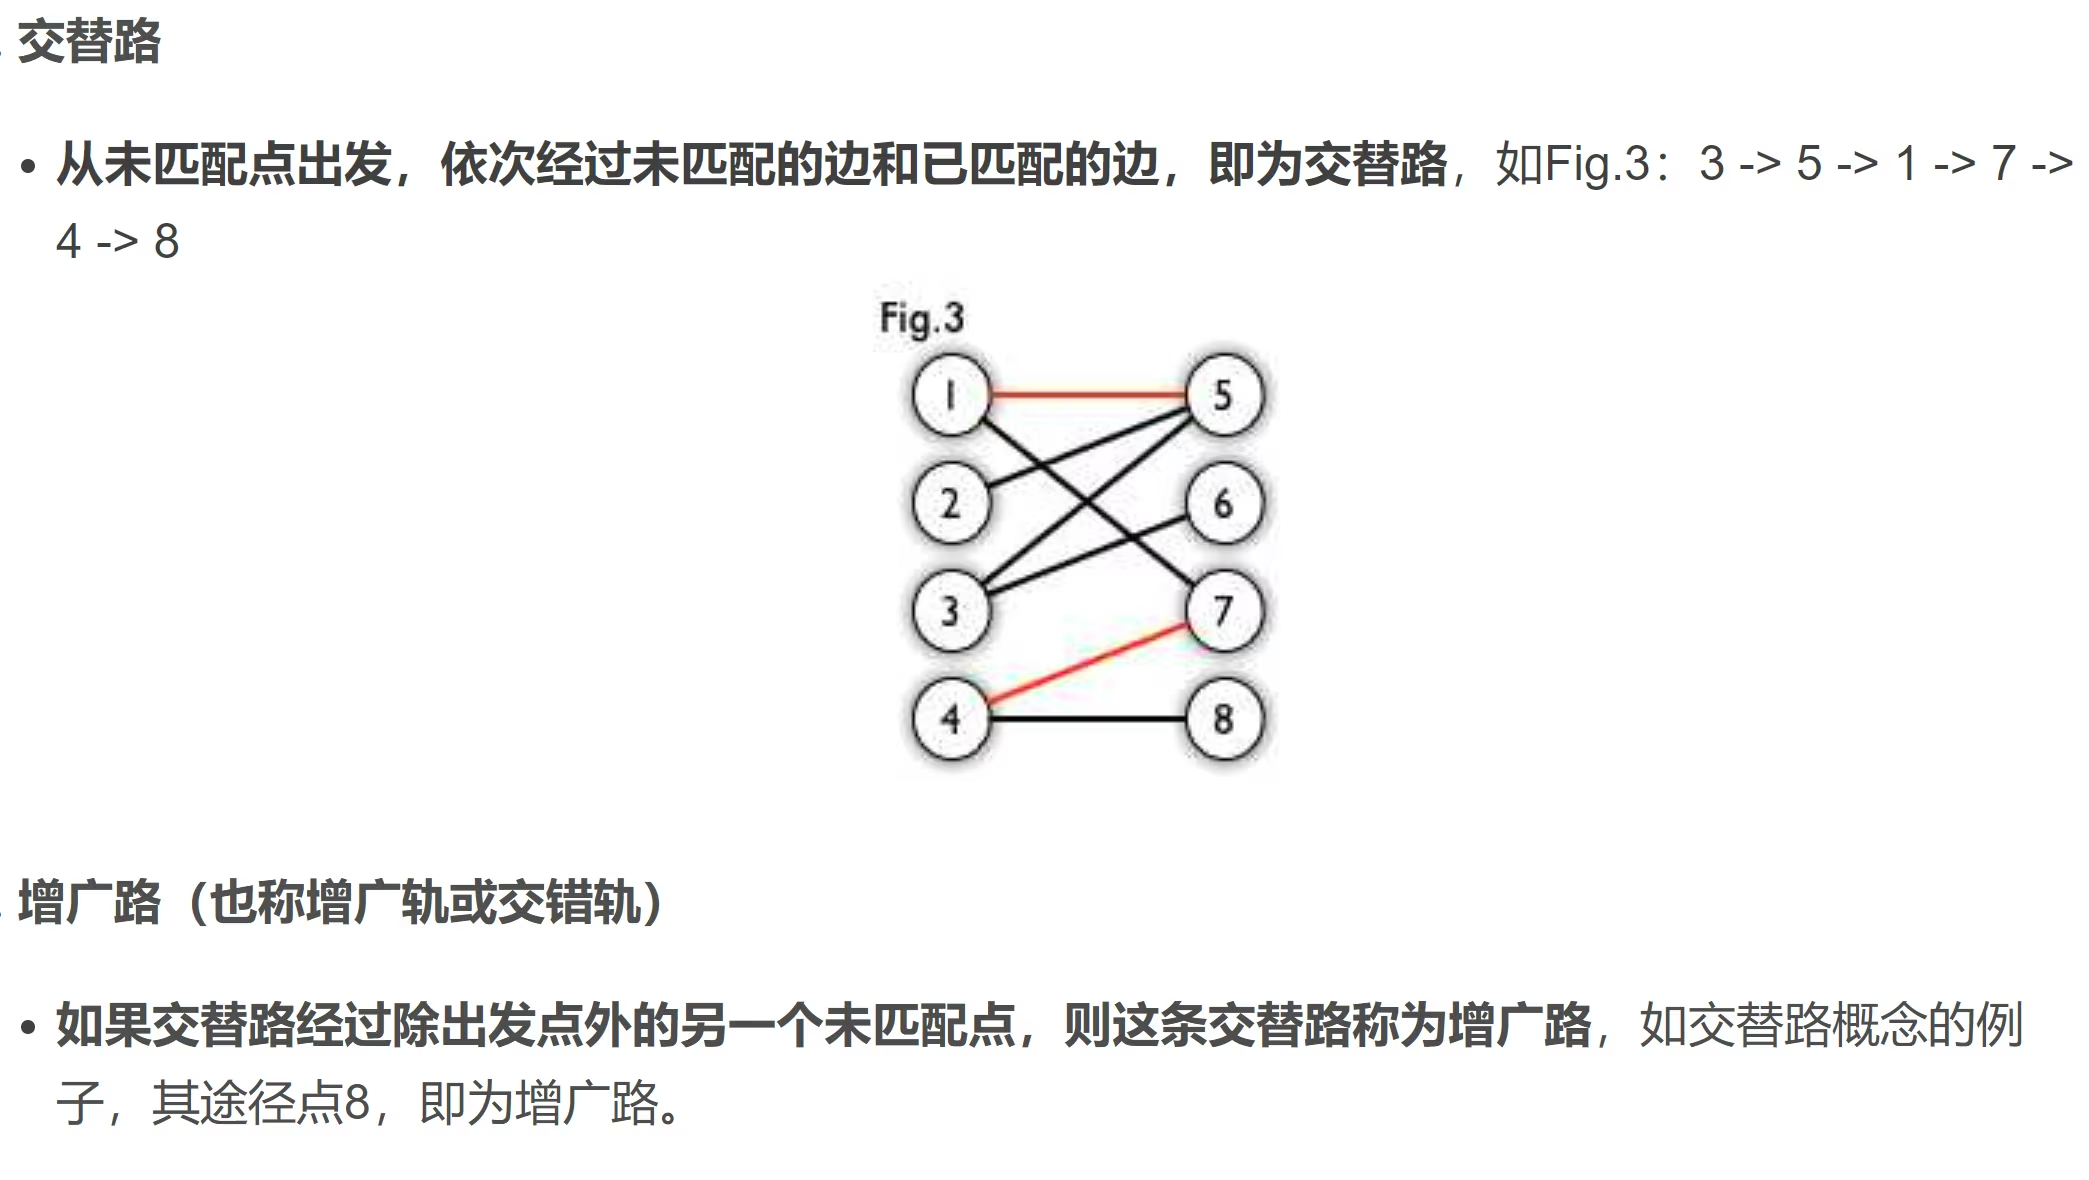
以下是使用深度优先搜索实现的匈牙利算法的 C++代码:
#include <bits/stdc++.h>using namespace std;const int MAXN = 500;vector<int> G[MAXN]; // 邻接表表示图int match[MAXN]; // 存储匹配的节点bool visited[MAXN]; // DFS中节点是否被访问 bool dfs(int u) { used[u] = true; for (int v : G[u]) { int w = match[v]; if (!w || (!visited[w] && dfs(w))) { match[u] = v; match[v] = u; return true; } } return false;} int hungarian(int n) { // n是节点数 int res = 0; memset(match, 0, sizeof(match)); for (int u = 0; u < n; u++) { if (!match[u]) { memset(visited, 0, sizeof(visited)); if (dfs(u)) { res++; } } } return res; // 返回二分图的最大匹配数}C++int match[MAXN];// 下面的是同一个意思memset(match, -1, sizeof(match)); fill(match, match + MAXN, -1);fill_n(match, MAXN, -1);
bool isPrime(int x){for(int i=2;i*i<=x;i++)if(x%i==0)return 0;return 1;}同上,通过一个个去试来获取其的所有质因数
map<int,int> mp;void divide(int n){ for(int i=2;i*i<=n;i++) while(n%i==0){ mp[i]++;n/=i; } if(n!=1) mp[n]++; // 到最后还是没有除完,说明这是一个很大的质数}时间复杂度为 ,但实际上远小于这个值
基本思想是:首先假设所有的数都是素数,然后从最小的素数 2 开始,将其所有的倍数都标记为非素数。接着找到下一个还未被标记为非素数的数,重复这个过程,直到所有小于或等于给定数的数都被处理过。
const int N = 1e6; // 可以根据需要调整int primes[N], cnt; // primes[]存储所有素数bool is_prime[N];void get_primes(int n) { fill(is_prime, is_prime + n, true); is_prime[0] = is_prime[1] = false; for (int i = 2; i * i <= n; i++) { if (is_prime[i]) { for (int j = i + i; j <= n; j += i) { is_prime[j] = false; } } else primes[cnt++] = i; }}时间复杂度为 O(n)。
线性筛法的基本思想是:对于每个数,用它的最小质因数去筛它的倍数。
const int N = 1e6; // 可以根据需要调整int primes[N], cnt; // primes数组用于存储质数,cnt用于计数质数的个数bool is_prime[N]; // is_prime[i]表示i是否为质数 void get_primes(int n) { for (int i = 2; i <= n; i++) { if (!is_prime[i]) {primes[cnt++] = i;} for (int j = 0;primes[j] <= n / i; j++) { is_prime[i * primes[j]] = true; if (i % primes[j] == 0) break; } }}约数与质因数的区别是什么
- 约数:如果整数 a 能被整数 b(b≠0)整除,或者说 b 能整除 a,那么我们就说 b 是 a 的约数。例如,1、2、3、4、6 和 12 都是 12 的约数。
- 质因数:质因数是指能整除给定数的质数。质数是指除了 1 和它本身以外,不能被其他正整数整除的数。例如,12 的质因数有 2 和 3。
总的来说,约数包括了所有能整除给定数的数,而质因数只包括能整除给定数的质数。
vector<int> get_divisors(int x){ vector<int> res; for (int i = 1; i*i <= x; i ++ ) if (x % i == 0) { res.push_back(i); if (i != x / i) res.push_back(x / i); } sort(res.begin(), res.end()); return res;}ParseError: KaTeX parse error: No such environment: flalign at position 7: \begin{̲f̲l̲a̲l̲i̲g̲n̲}̲ 如果:& N = {p_1}…
对于约数个数:
对于约数之和:
先求出所有约数的表mp
若数据量小:
若数据量大:
while循环来通过等比数列递推公式来求 %mod 取模 const int mod=1e9+7; // map为红黑树,查询的时间复杂度为O(log n) // unordered_map为哈希表,查询的时间复杂度为O(1) unordered_map<int,int> ump; int sum_of_divisors(int n){ ll ans=1; for(auto i:ump){ ll p=i.first,k=i.second; ll sum=1; while(k--){ // 最后%mod与每次%mod效果相同 // +1是为了将这个项加到总和中,如下 sum=(sum*p+1)%mod; } ans=ans*sum%mod; } return ans; } 注:
Q:为什么
while(k--)中,+1可以将这项加到 中?A:
ParseError: KaTeX parse error: No such environment: flalign at position 7: \begin{̲f̲l̲a̲l̲i̲g̲n̲}̲ 第一次while循环:\\ …
欧几里得算法求最大公约数
int gcd(int a, int b) { return b ? gcd(b, a % b) : a; }int phi(int x){ int res = x; for (int i = 2; i <= x / i; i ++ ) if (x % i == 0) { res = res / i * (i - 1); while (x % i == 0) x /= i; } if (x > 1) res = res / x * (x - 1); return res;}int primes[N], cnt; // primes[]存储所有素数int euler[N]; // 存储每个数的欧拉函数bool st[N]; // st[x]存储x是否被筛掉 void get_eulers(int n){ euler[1] = 1; for (int i = 2; i <= n; i ++ ) { if (!st[i]) { primes[cnt ++ ] = i; euler[i] = i - 1; } for (int j = 0; primes[j] <= n / i; j ++ ) { int t = primes[j] * i; st[t] = true; if (i % primes[j] == 0) { euler[t] = euler[i] * primes[j]; break; } euler[t] = euler[i] * (primes[j] - 1); } }}int qmi(int m, int k, int p){ int res = 1 % p, t = m; while (k) { if (k&1) res = res * t % p; t = t * t % p; k >>= 1; } return res;}// 求x, y,使得ax + by = gcd(a, b)int exgcd(int a, int b, int &x, int &y){ if (!b) { x = 1; y = 0; return a; } int d = exgcd(b, a % b, y, x); y -= (a/b) * x; return d;}// a[N][N]是增广矩阵int gauss(){ int c, r; for (c = 0, r = 0; c < n; c ++ ) { int t = r; for (int i = r; i < n; i ++ ) // 找到绝对值最大的行 if (fabs(a[i][c]) > fabs(a[t][c])) t = i; if (fabs(a[t][c]) < eps) continue; for (int i = c; i <= n; i ++ ) swap(a[t][i], a[r][i]); // 将绝对值最大的行换到最顶端 for (int i = n; i >= c; i -- ) a[r][i] /= a[r][c]; // 将当前行的首位变成1 for (int i = r + 1; i < n; i ++ ) // 用当前行将下面所有的列消成0 if (fabs(a[i][c]) > eps) for (int j = n; j >= c; j -- ) a[i][j] -= a[r][j] * a[i][c]; r ++ ; } if (r < n) { for (int i = r; i < n; i ++ ) if (fabs(a[i][n]) > eps) return 2; // 无解 return 1; // 有无穷多组解 } for (int i = n - 1; i >= 0; i -- ) for (int j = i + 1; j < n; j ++ ) a[i][n] -= a[i][j] * a[j][n]; return 0; // 有唯一解}// c[a][b] 表示从a个苹果中选b个的方案数for (int i = 0; i < N; i ++ ) for (int j = 0; j <= i; j ++ ) if (!j) c[i][j] = 1; else c[i][j] = (c[i - 1][j] + c[i - 1][j - 1]) % mod;首先预处理出所有阶乘取模的余数fact[N],以及所有阶乘取模的逆元infact[N]如果取模的数是质数,可以用费马小定理求逆元int qmi(int a, int k, int p) // 快速幂模板{ int res = 1; while (k) { if (k & 1) res = (LL)res * a % p; a = (LL)a * a % p; k >>= 1; } return res;} // 预处理阶乘的余数和阶乘逆元的余数fact[0] = infact[0] = 1;for (int i = 1; i < N; i ++ ){ fact[i] = (LL)fact[i - 1] * i % mod; infact[i] = (LL)infact[i - 1] * qmi(i, mod - 2, mod) % mod;} 若p是质数,则对于任意整数 1 <= m <= n,有: C(n, m) = C(n % p, m % p) * C(n / p, m / p) (mod p) int qmi(int a, int k, int p) // 快速幂模板{ int res = 1 % p; while (k) { if (k & 1) res = (LL)res * a % p; a = (LL)a * a % p; k >>= 1; } return res;} int C(int a, int b, int p) // 通过定理求组合数C(a, b){ if (a < b) return 0; LL x = 1, y = 1; // x是分子,y是分母 for (int i = a, j = 1; j <= b; i --, j ++ ) { x = (LL)x * i % p; y = (LL) y * j % p; } return x * (LL)qmi(y, p - 2, p) % p;} int lucas(LL a, LL b, int p){ if (a < p && b < p) return C(a, b, p); return (LL)C(a % p, b % p, p) * lucas(a / p, b / p, p) % p;}当我们需要求出组合数的真实值,而非对某个数的余数时,分解质因数的方式比较好用: 1. 筛法求出范围内的所有质数 2. 通过 C(a, b) = a! / b! / (a - b)! 这个公式求出每个质因子的次数。 n! 中p的次数是 n / p + n / p^2 + n / p^3 + ... 3. 用高精度乘法将所有质因子相乘 int primes[N], cnt; // 存储所有质数int sum[N]; // 存储每个质数的次数bool st[N]; // 存储每个数是否已被筛掉 void get_primes(int n) // 线性筛法求素数{ for (int i = 2; i <= n; i ++ ) { if (!st[i]) primes[cnt ++ ] = i; for (int j = 0; primes[j] <= n / i; j ++ ) { st[primes[j] * i] = true; if (i % primes[j] == 0) break; } }} int get(int n, int p) // 求n!中的次数{ int res = 0; while (n) { res += n / p; n /= p; } return res;} vector<int> mul(vector<int> a, int b) // 高精度乘低精度模板{ vector<int> c; int t = 0; for (int i = 0; i < a.size(); i ++ ) { t += a[i] * b; c.push_back(t % 10); t /= 10; } while (t) { c.push_back(t % 10); t /= 10; } return c;} get_primes(a); // 预处理范围内的所有质数 for (int i = 0; i < cnt; i ++ ) // 求每个质因数的次数{ int p = primes[i]; sum[i] = get(a, p) - get(b, p) - get(a - b, p);} vector<int> res;res.push_back(1); for (int i = 0; i < cnt; i ++ ) // 用高精度乘法将所有质因子相乘 for (int j = 0; j < sum[i]; j ++ ) res = mul(res, primes[i]);给定 n 个 0 和 n 个 1,它们按照某种顺序排成长度为 2n 的序列,满足任意前缀中 0 的个数都不少于 1 的个数的序列的数量为:
规则:ICG 没有固定的游戏规则,而是指任何一种由两名玩家交替行动、在有限步骤内达到终局状态的游戏,
- 由两名玩家交替行动;
- 在游戏进程的任意时刻,可以执行的合法行动与轮到哪名玩家无关;
- 不能行动的玩家判负;
包括:NIM 游戏、有向图游戏等等(像是围棋,象棋,井字棋,跳棋都不是,它们都不满足第二点“公平”)
NIM 游戏是一种两人游戏,通常使用一堆物品(如石子或棋子)和一组规则来定义,每个玩家轮流从堆中取走一些物品(不能不取),直到没有物品可取的那方玩家输掉游戏。
NIM 博弈只有先手必胜或先手必败两种情况
先手必胜策略:
**奇异性:**题目所给的每堆石子( ) 的异或和 (xor) 都不为 0,则它是奇异的;
**保持游戏的奇异性:**先手玩家每次的移动都会使游戏的奇异性保持不变。也就是说,他会使得游戏的状态从奇异变为非奇异,或者从非奇异变为奇异。
强制对手陷入非奇异状态:在每一步中,先手玩家可以通过合适的移动,让游戏状态变为奇异状态,迫使对手面临不利情况。
**定理:**当 时,NIM 博弈先手必胜
^ ^ ^
给定一个有向无环图,图中有一个唯一的起点,在起点上放有一枚棋子。两名玩家交替地把这枚棋子沿有向边进行移动,每次可以移动一步,无法移动者判负。该游戏被称为有向图游戏。
任何一个公平组合游戏都可以转化为有向图游戏。具体方法是,把每个局面看成图中的一个节点,并且从每个局面向沿着合法行动能够到达的下一个局面连有向边。
设 S 表示一个非负整数集合。定义 mex(S)为求出不属于集合 S 的最小非负整数的运算,即:
mex(S) = min{x}, x 属于自然数,且 x 不属于 S
在有向图游戏中,对于每个节点 x,设从 x 出发共有 k 条有向边,分别到达节点 y1, y2, …, yk,定义 SG(x)为 x 的后继节点 y1, y2, …, yk 的 SG 函数值构成的集合再执行 mex(S)运算的结果,即:
SG(x) = mex({SG(y1), SG(y2), …, SG(yk)})
特别地,整个有向图游戏 G 的 SG 函数值被定义为有向图游戏起点 s 的 SG 函数值,即 SG(G) = SG(s)。
设 G1, G2, …, Gm 是 m 个有向图游戏。定义有向图游戏 G,它的行动规则是任选某个有向图游戏 Gi,并在 Gi 上行动一步。G 被称为有向图游戏 G1, G2, …, Gm 的和。
有向图游戏的和的 SG 函数值等于它包含的各个子游戏 SG 函数值的异或和,即:
SG(G) = SG(G1) ^ SG(G2) ^ … ^ SG(Gm)
有向图游戏的某个局面必胜,当且仅当该局面对应节点的 SG 函数值大于 0。
有向图游戏的某个局面必败,当且仅当该局面对应节点的 SG 函数值等于 0。
int res = 0;for(int i=1;i<1<<m;i++){ int t = 1,sign = -1; for(int j=0;j<m;j++){ if(i&1<<j){ if((ll)t*prim[j]>n){ t = 0; break; } sign = -sign; t*=prim[j]; } } if(t) res = res + n/t*sign;}分享你的想法,与大家交流讨论
Twikoo 加载失败
Twikoo 脚本加载失败