数据结构与算法
发布于 2026-04-06更新于 2026-11-1479499 字489 分钟 · 阅读时间
虽然第一次学习是在 C++笔记中
第二次复习是在 2023-10-23 ~ 2023-12-18
2026-4-7:当时是先看 hello-algo 学习的,因此这些图片也是从这里截取的
我也推荐你们去 https://www.hello-algo.com/ 去看一下,不知道还能不能找到我的评论
算法:计算方法
「算法 algorithm」是在有限时间内解决特定问题的一组指令或操作步骤
分为:
暴力解答(选择优秀的方法来暴力,如深度还是广度优先还是其他等)
公式解答(先计算出公式,以大量节约时间空间)
或一起用上面的方法
数据结构:简洁的存储数据的结构
「数据结构 data structure」是计算机中组织和存储数据的方式
数据结构设计是一个充满权衡的过程。如果想要在某方面取得提升,往往需要在另一方面作出妥协。
它们的关系
相互依存的

| 数据结构与算法 | 拼装积木 |
|---|---|
| 输入数据 | 未拼装的积木 |
| 数据结构 | 积木组织形式,包括形状、大小、连接方式等(抽象/建模) |
| 算法 | 把积木拼成目标形态的一系列操作步骤(解决/渲染) |
| 输出数据 | 积木模型 |
它们是独立于编程语言的,所有只要会不同语言的语法后,就会一通百通
它们共同简称为算法
在算法设计中,一般要先后满足以下目标
找到问题解法
找到最优解(又快又省)
时间效率高
空间效率高
评估效率有两种方法
实际测试 - 输入不同数据量的数据来测试
理论估算 - 复杂度分析 (在极大数据量下更优)
复杂度分析:
分析所要消耗的时间或空间资源
反映了数据量与运行效率之比
反映了时间或空间增长的快慢(k 值)
重复执行某个任务与算法复杂度密切相关
想要重复执行,常用两种基本结构——迭代与递归
它是最常见的迭代形式之一,适合预先知道迭代次数时使用
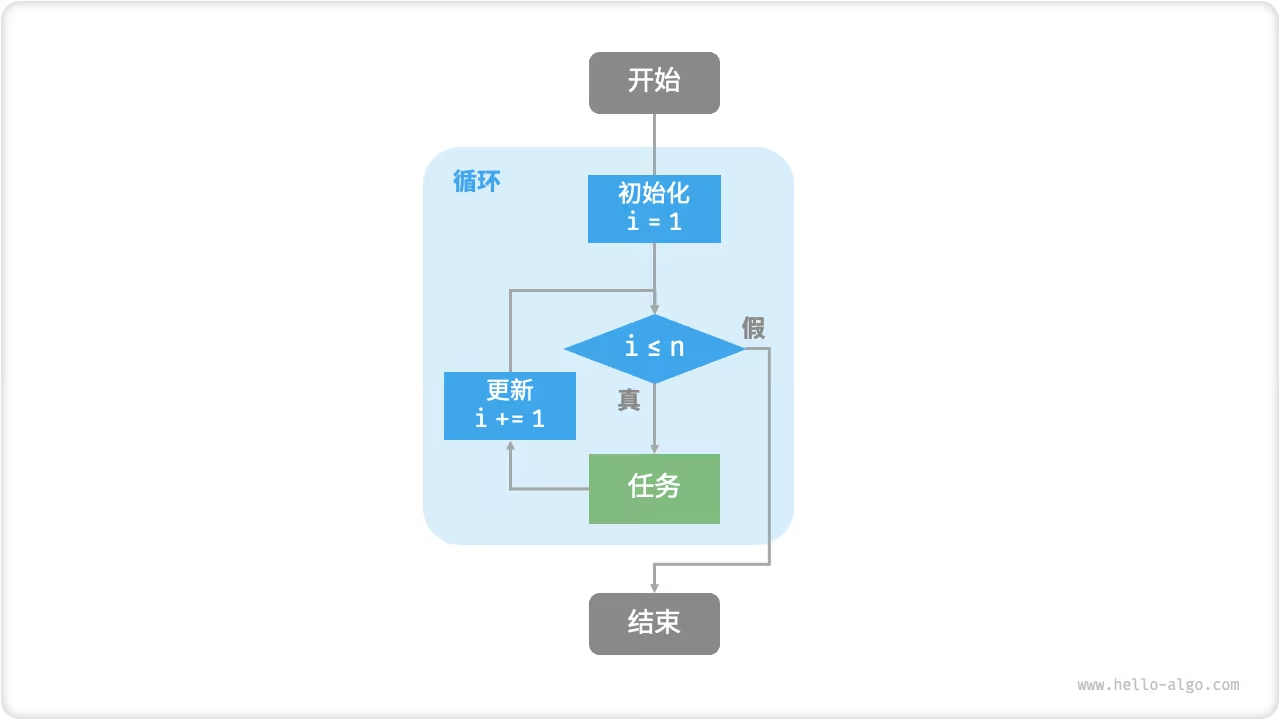
其的时间复杂度为
先检查条件是否满足,再执行循环或结束循环当然,c++中还有do...while
for 的代码更紧凑清晰,while 的代码更自由灵活
循环中内嵌套一个循环
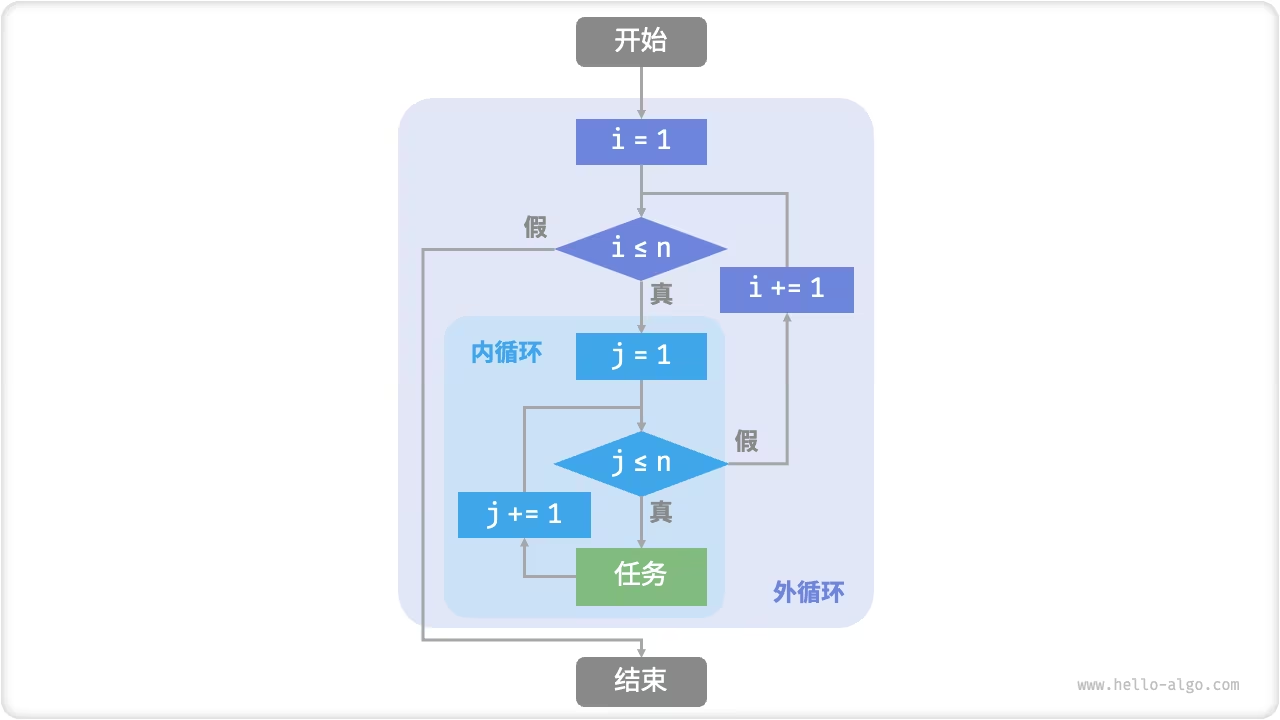
时间复杂度为, 其中每嵌套一次循环,时间复杂度增加一次方
「递归 recursion」通过函数调用自身来解决问题
其中包含
终止条件:决定何时从“递”到“归”
递归调用:对应“递”,通常传入简化/小的参数
返回结果:对应“归”
/* 递归 */int recur(int n){ // 终止条件 if (n == 1) {return 1;} // 递:递归调用 int res = recur(n - 1); // resule(结果)的简称 // 归:返回结果 return n + res;} 
递归与迭代分别代表了两种完全不同的思考与解决问题的方式
迭代:“自下而上”地解决问题,从最基础开始重复/累加,直到达成条件
递归:“自上而下”地解决问题,将原问题分成更小的子问题,它们都有相同的形式,直到基本情况/达成条件/获得已知解后,停止
例:求和
迭代:在循环中模拟求和的过程,从一遍历到,直到获得
递归:将问题分解成相同的子问题 ,不断(递归的)分解下去,直到基本情况 时终止
递归每次调用自身时,需要系统额外分配内存空间,用于储存局部变量,调用地址和其他信息等,因此:
函数数据会储存到“栈帧空间”的内存区域中,直到结束才释放,让递归通常比迭代更费内存空间
它调用函数时会额外耗时间,使递归通常比迭代的时间效率更低
如下,递归深度为
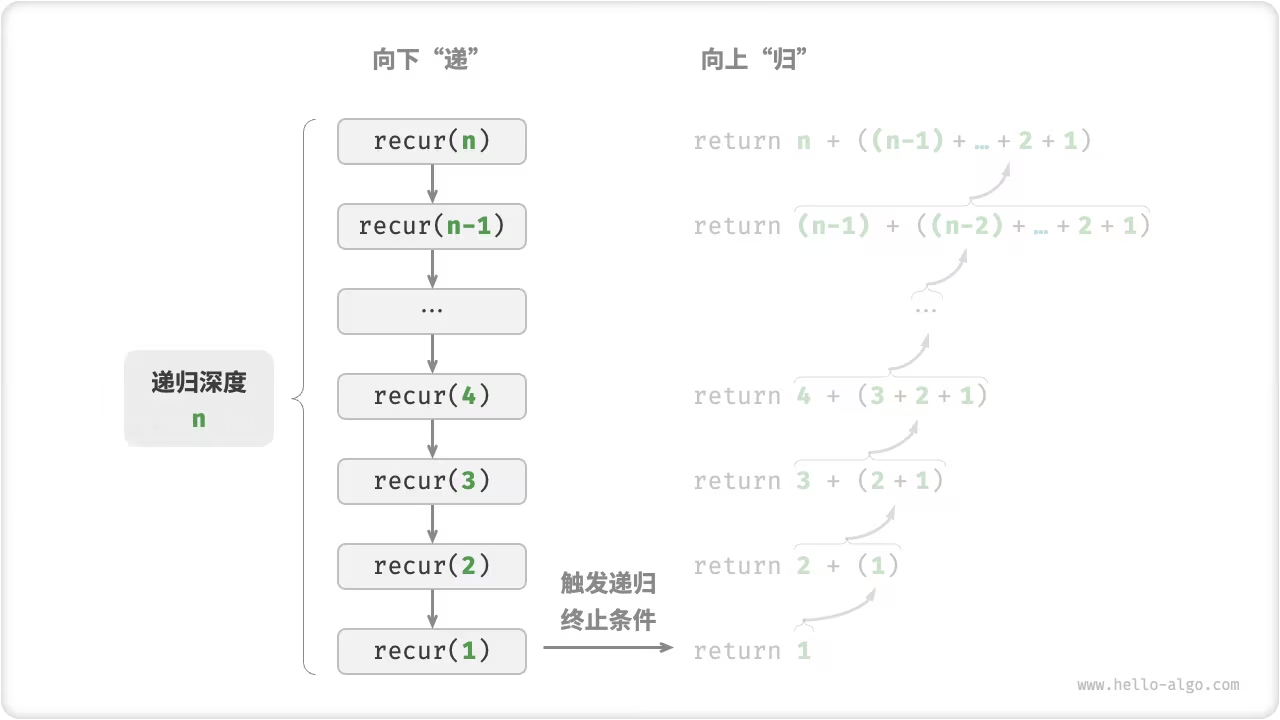
在实际中,过深的递归可能会导致栈溢出报错
如果函数只有在最后一步才进行递归调用,则它前面的步骤可能被编译器优化到空间效率 递归的,这时被称为「尾递归 tail recursion」
普通递归:当函数返回上一层的函数后,需要继续执行代码,因此需要保存上一层调用的上下文
尾递归,只有最后一步才调用,且返回上一层后不做其他操作,因此不用保存上一层的上下文
/* 尾递归 */int tail_recur(int n, int res){ // 终止条件 if (n == 0) {return res;} // 尾递归调用 return tail_recur(n - 1, res + n);} 对比上下的图,可以发现:
普通递归:求和是在“归”中进行的,返回时都要执行一次求和操作
尾递归:求和是在“递”中进行的,“归”时只要返回结果

注:像是
Python是默认不支持尾递归优化的,PyPy3可以
当处理“分治”相关的算法问题时,递归往往比迭代的思路更加直观,代码更加易读,
以“斐波拉契数列”为例:
给一个斐波那契数列,求该数列的第 个数字
解:
设第个数字为,则
和
因此:
/* 斐波那契数列:递归 */int fib(int n) { //fibonacci sequence // 终止条件 f(1) = 1, f(2) = 1 // 注:有些题的fib是 0、1、1、2、3、5,从0开始的 if (n == 1 || n == 2) {return 1;} // 递归调用 f(n) = f(n-1) + f(n-2) int res = fib(n - 1) + fib(n - 2); // 返回结果 f(n) return res;}可发现,我们调用了两个函数,这说明每一次调用会产生两个调用分治,直到产生一个层数为 的递「递归树 recursion tree」

从中可以看到递归的本质——“将问题分解成更小的子问题”的思维,这种分治策略是很重要的
从算法来看,搜索、排序、回溯、分治、动态规划等算法都直接间接的使用了这种思维方式
从数据结构来看,递归天然适合处理链表、树、图的相关问题,因为它们非常适合使用分治思想进行分析
| 迭代 | 递归 | |
|---|---|---|
| 实现方式 | 循环结构 | 函数调用自身 |
| 时间效率 | 效率通常较高,无函数调用开销 | 每次函数调用都会产生开销 |
| 适用问题 | 通常使用固定大小的内存空间 | 累积函数调用可能使用大量的栈帧空间 |
| 适用问题 | 适用于简单循环任务,代码直观、可读性好 | 适用于子问题分解,如树、图、分治、回溯等,代码结构简洁、清晰 |
内在联系——栈
可以使用“栈”来使用递归模拟递归
/* 使用迭代模拟递归 */int forLoopRecur(int n){ // 使用一个显式的栈来模拟系统调用栈 stack<int> stack; int res = 0; // 递:递归调用 for (int i = n; i > 0; i--) { // 通过“入栈操作”模拟“递” stack.push(i); } // 归:返回结果 while (!stack.empty()) { // 通过“出栈操作”模拟“归” res += stack.top(); stack.pop(); } // res = 1+2+3+...+n return res;} 但这会导致:
可读性差
模拟耗费的时间空间高,高于原生的(都有了原生的递归方法,还模拟干嘛)
总的来说,选择哪种方法还是要看问题的性质
想要获取算法的运行时间,就要
+ 需要 1 ns ,乘法操作 * 需要 10 ns ,打印操作 print() 需要 5 ns 等(Python)例:输入的数据大小为
// 在某运行平台下void algorithm(int n){ int a = 2; // 1 ns a = a + 1; // 1 ns a = a * 2; // 10 ns // 循环 n 次 for (int i = 0; i < n; i++) // 1 ns,每轮都要执行 i++ {cout << 0 << endl;} // 5 ns}可知运行时间 ns
但在实际上不能用这种方法,因为各种平台(硬件)不同,编程软件不同等,因此需要其他的方法
因为统计准确的时间不行,所以我们可以通过统计变化率或大数据来估计
时间复杂度就是分析统计算法的运行时间随数据量变大时的增长趋势,而不是算法运行时间
例:输入的数据大小为
// 算法 A 的时间复杂度:常数阶void algorithm_A(int n){ cout << 0 << endl;}// 算法 B 的时间复杂度:线性阶void algorithm_B(int n){ for (int i = 0; i < n; i++) {cout << 0 << endl;}}// 算法 C 的时间复杂度:常数阶void algorithm_C(int n){ for (int i = 0; i < 1000000; i++) {cout << 0 << endl;}} 其中:
算法A和算法C与输入的 无关,因此它们的时间复杂度为 “常数阶”
算法B的运行时间随 的增大呈线性增长,因此称为 “线性阶”

时间复杂度,相比于直接统计算法的运行时间的特点:
能够有效评估算法效率,可以比较在不同 的情况下算法的优劣
推算方法更加简便,在计算时,将所有计算和执行时间都视为相同的 "单位时间",从而将“计算操作的运行时间的统计”转换成“数量的统计”,降低了难度
但也有局限性,当 比较小时,就不好比了,比如A和C,它们在时间复杂度上相同
输入的数据大小为
void algorithm(int n){ int a = 1; // +1 a = a + 1; // +1 a = a * 2; // +1 // 循环 n 次 for (int i = 0; i < n; i++) // +1(每轮都执行 i ++) {cout << 0 << endl;} // +1 } 设这个算法的操作数量是一个关于 的函数,记为 ,因此:
这个一次函数的时间复杂度是线性阶,
我们将线性阶的时间复杂度记为
这个数学符号称为「大记号 big-$O$notation」,表示函数 的「渐近上界 asymptotic upper bound」
时间复杂度分析本质上是计算“操作数量函数 ”的渐近上界,其具有明确的数学定义。
定义:若存在正实数 和实数 ,使得对于所有的 ,均有 ,则可认为 给出了 的一个渐近上界,记为 。
如下图所示,计算渐进上界就是寻找一个函数 比如: 、、 等等,是的当 时, 和 处于相同的增长级别,仅相差一个常数项 的倍数

由上可知,推算时间复杂度的方法就是找到渐进上界
忽略常数项 如: 的
忽略所有系数 如: 的
循环嵌套时使用乘法
void algorithm(int n){ int a = 1; // +0(技巧 1) a = a + n; // +0(技巧 1) // +n(技巧 2) for (int i = 0; i < 5 * n + 1; i++) {cout << 0 << endl;} // +n*n(技巧 3) for (int i = 0; i < 2 * n; i++) { for (int j = 0; j < n + 1; j++) {cout << 0 << endl;} }}如上,
时间复杂度由多项式 中最高阶的项来决定
因为当 时,最高阶的项将发挥主导作用,其他的就可以忽略了
如上,最后推出时间复杂度为
| 操作数量 | 时间复杂度 |
|---|---|
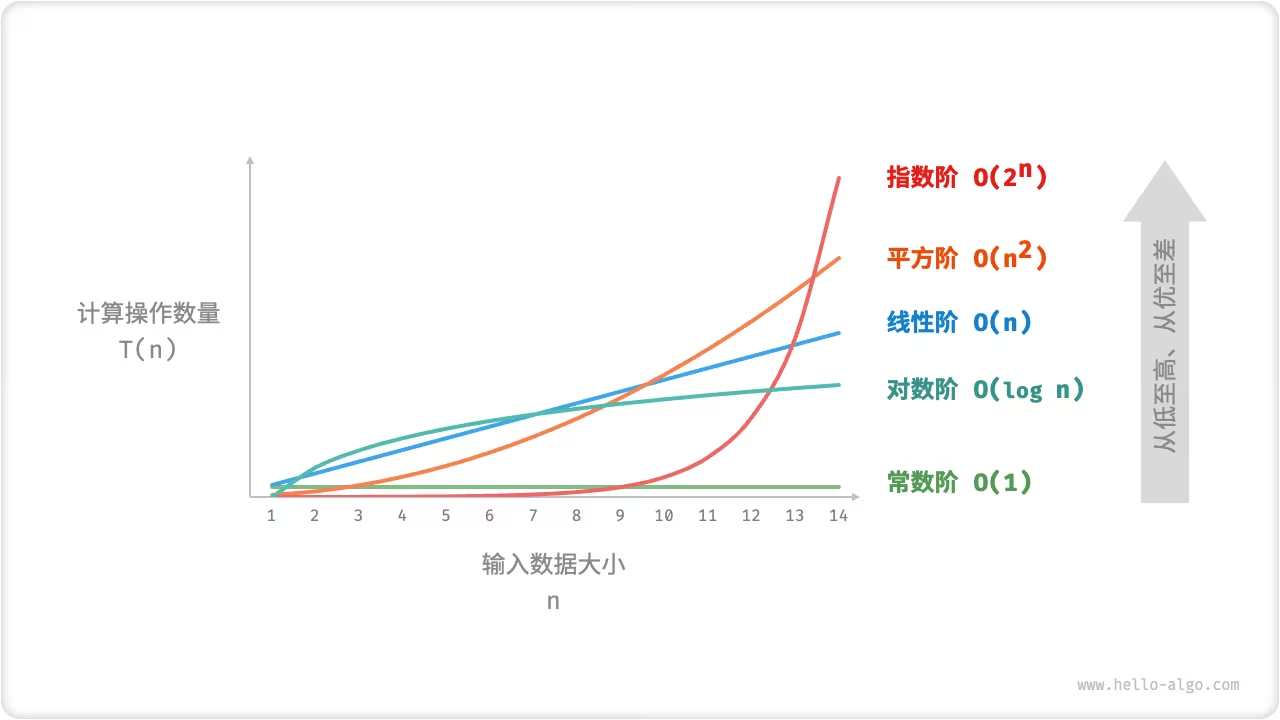
与 无关
/* 常数阶 */int constant(int n){ int count = 0; int size = 100000; for (int i = 0; i < size; i++) // size与n无关 {count++;} return count;}随 以线性增长
常见的有遍历数组和遍历链表, 为数组或链表的长度
/* 线性阶 */int linear(int n){ int count = 0; for (int i = 0; i < n; i++) {count++;} return count;}随 以平方级别增长
常出现在嵌套循环中,内层和外层循环都是 ,因此总体是
/* 平方阶 */int quadratic(int n){ int count = 0; // 循环次数与数组长度成平方关系 for (int i = 0; i < n; i++) { for (int j = 0; j < n; j++) {count++;} } return count;}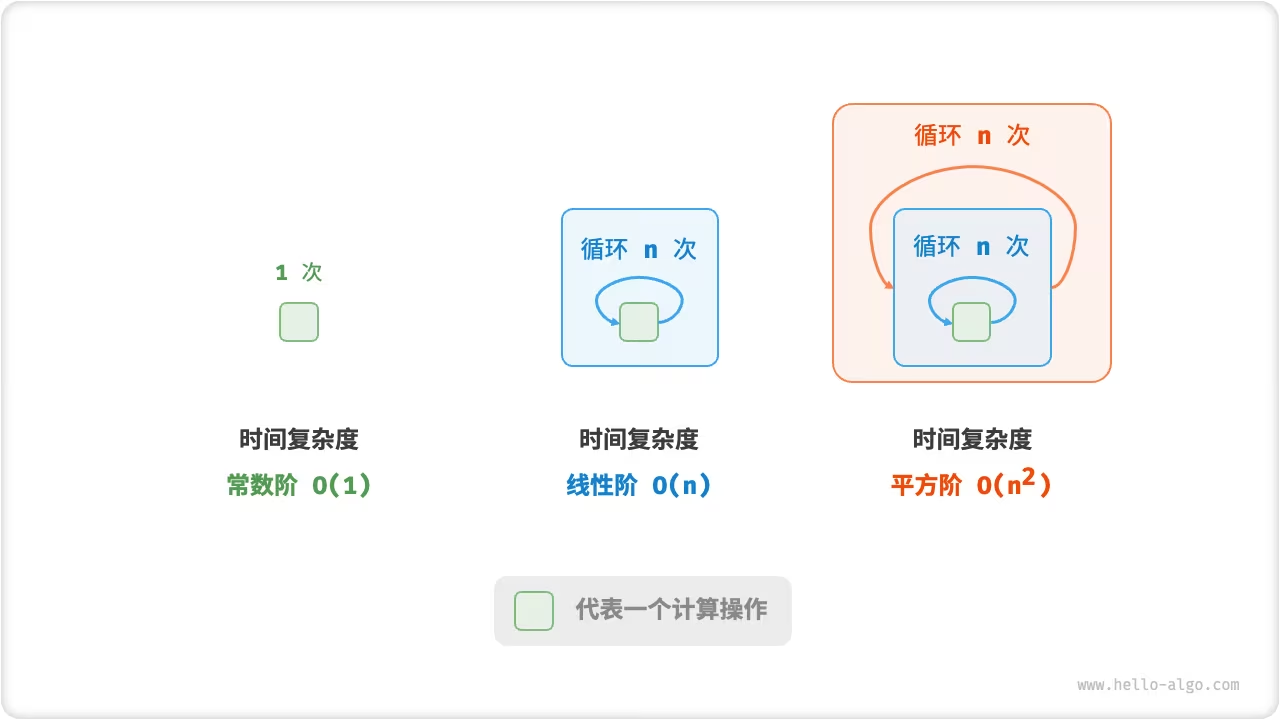
以冒泡排序为例,外层循环执行 次,内层循环执行 次,平均为 次,因此时间复杂度为
/* 平方阶(冒泡排序) */int bubbleSort(vector<int> &nums){ int count = 0; // 计数器 // 外循环:未排序区间为 [0, i] for (int i = nums.size() - 1; i > 0; i--) { // 内循环:将未排序区间 [0, i] 中的最大元素交换至该区间的最右端 for (int j = 0; j < i; j++) { if (nums[j] > nums[j + 1]) { // 交换 nums[j] 与 nums[j + 1] int tmp = nums[j]; nums[j] = nums[j + 1]; nums[j + 1] = tmp; count += 3; // 元素交换包含 3 个单元操作 } } } return count;}其常在穷举法(暴力搜索、回溯等)中比较常见,对应数据较大的问题,指数阶是不可接受的,通常要用动态规划或贪心等算法来解决
比如细胞分裂
/* 指数阶(循环实现) */int exponential(int n){ int count = 0, base = 1; // 细胞每轮一分为二,形成数列 1, 2, 4, 8, ..., 2^(n-1) for (int i = 0; i < n; i++) { for (int j = 0; j < base; j++) {count++;} base *= 2; } // count = 1 + 2 + 4 + 8 + .. + 2^(n-1) = 2^n - 1 return count;} 
其常出现在递归函数中
如下递归地一分为二,直到 次后才停止的代码
/* 指数阶(递归实现) */int expRecur(int n){ if (n == 1) {return 1;} return expRecur(n - 1) + expRecur(n - 1) + 1;}与指数阶刚好相反,对数阶是“每轮缩减到一半”的情况,由于此,让循环的次数是 (简称 ),即 的反函数
/* 对数阶(循环实现) */int logarithmic(float n){ int count = 0; while (n > 1) { n = n / 2; count++; } return count;}
与指数阶类似,对数阶也常出现在递归函数中,
如下是一个高度为 的递归树:
/* 对数阶(递归实现) */int logRecur(float n){ if (n <= 1) {return 0;} return logRecur(n / 2) + 1;} 对数阶常出现在基于分治策略的算法中,体现了 “一分为多” 和 “化繁为简” 的算法思想。它增长缓慢,是仅次于常数阶的理想的时间复杂度
的底数是多少?
准确来说,“一分为 ”对应的时间复杂度是 。而通过对数换底公式,我们可以得到具有不同底数的、相等的时间复杂度:
也就是说,底数 可以在不影响复杂度的前提下转换。因此我们通常会省略底数 ,将对数阶直接记为 。
其常出现在嵌套循环中,如下两层循环的时间复杂度分别为
/* 线性对数阶 */int linearLogRecur(float n){ if (n <= 1) {return 1;} int count=linearLogRecur(n/2)+linearLogRecur(n/2); for (int i = 0; i < n; i++) {count++;} return count;}
常见主流的排序算法的时间复杂度通常为 ,如:快速排序、归并排序、堆排序等
常见的有 “全排列” 问题
阶层常用递归实现,如下
/* 阶乘阶(递归实现) */int factorialRecur(int n){ if (n == 0) {return 1;} int count = 0; // 从 1 个分裂出 n 个 for (int i = 0; i < n; i++) {count += factorialRecur(n - 1);} return count;} 
因为当 时恒有 ,所以阶层阶会比指数阶增长的更快,在 n 较大时最好寻找其他方法
算法的时间效率往往不是固定的,而是与输入数据的分布有关
比如要在一个不重复随机打乱的数组中寻找到
如果 在末尾,则达到了最差时间复杂度
如果 在首个,则达到了最佳时间复杂度
其中,最差的对应函数的渐近上界,使用 表示;最佳的对应函数的渐近下界,用 表示
/* 生成一个数组,元素为 { 1, 2, ..., n },顺序被打乱 */vector<int> randomNumbers(int n){ vector<int> nums(n); // 生成数组 nums = { 1, 2, 3, ..., n } for (int i = 0; i < n; i++) {nums[i] = i + 1;} // 使用系统时间生成随机种子 unsigned seed = chrono::system_clock::now().time_since_epoch().count(); // 随机打乱数组元素 shuffle(nums.begin(),nums.end() , default_random_engine(seed)); return nums;} /* 查找数组 nums 中数字 1 所在索引 */int findOne(vector<int> &nums){ for (int i = 0; i < nums.size(); i++) { // 当元素 1 在数组头部时,达到最佳时间复杂度 O(1) // 当元素 1 在数组尾部时,达到最差时间复杂度 O(n) if (nums[i] == 1) {return i;} } return -1;} 因为最佳的情况很少才能发生,所以常用最差的,用于给出一个效率的安全值,让我们放心的使用算法
因为最佳与最差的情况的概率都很小,所以常用平均时间复杂度
平均时间复杂度可以体现栓发在睡觉输入数据下的运行效率,使用 记号
( 的大写)
平均时间复杂度在上述中为
因为 相比于 好读又好写,因此常直接用 表示
和时间的一样,只是将“运行时间”替换成“占用内存空间”
主要包括以下几种:
输入空间:用于存储算法的输入数据
暂存空间:用于存储运行时的变量、对象、函数上下文等空间
暂存数据:用于保存各种常量、变量、对象等
栈帧空间:用于保存调用函数的上下文数据 系统在每次调用函数时都会在栈顶创建一个栈帧,当函数返回后,这个栈帧空间就会被释放
指令空间:用于保存编译后的程序命令,在实际统计中常忽略不计
输出空间:用于存储算法的输出数据
一般,空间复杂度只统计 “暂存空间” + “输出空间”再细分可以分为:统计 “暂存数据”、“栈帧空间” 和 ”输出数据“ 三部分

如:
/* 结构体 */struct Node{ int val; Node *next; Node(int x) : val(x), next(nullptr) {}}; /* 函数 */int func(){ // 执行某些操作... return 0;} int algorithm(int n) // 输入数据{ const int a = 0; // 暂存数据(常量) int b = 0; // 暂存数据(变量) Node* node = new Node(0); // 暂存数据(对象) int c = func(); // 栈帧空间(调用函数) return a + b + c; // 输出数据}统计对象从 ”操作数量“ 转为 ”使用空间大小“
但区别是,我们通常只关注最差空间复杂度,因为内存空间是硬性要求,需要确保有足够的内存空间预留
如下,有两种最差的情况:
nums 占用 空间;因此最差空间复杂度为 nums 时,程序占用 空间;因此最差空间复杂度为 void algorithm(int n){ int a = 0; // O(1) vector<int> b(10000); // O(1) if (n > 10) {vector<int> nums(n);} // O(n)}在递归函数中,需要注意统计栈帧空间。
如下:
函数 loop() 在循环中调用了 次 function() ,每轮中的 function() 都返回并释放了栈帧空间,因此空间复杂度仍为
递归函数 recur() 在运行过程中会同时存在 个未返回的 recur() ,从而占用 的栈帧空间
int func(){ // 执行某些操作 return 0;}/* 循环 O(1) */void loop(int n){ for (int i = 0; i < n; i++) {func();}}/* 递归 O(n) */void recur(int n){ if (n == 1) {return;} return recur(n - 1);}
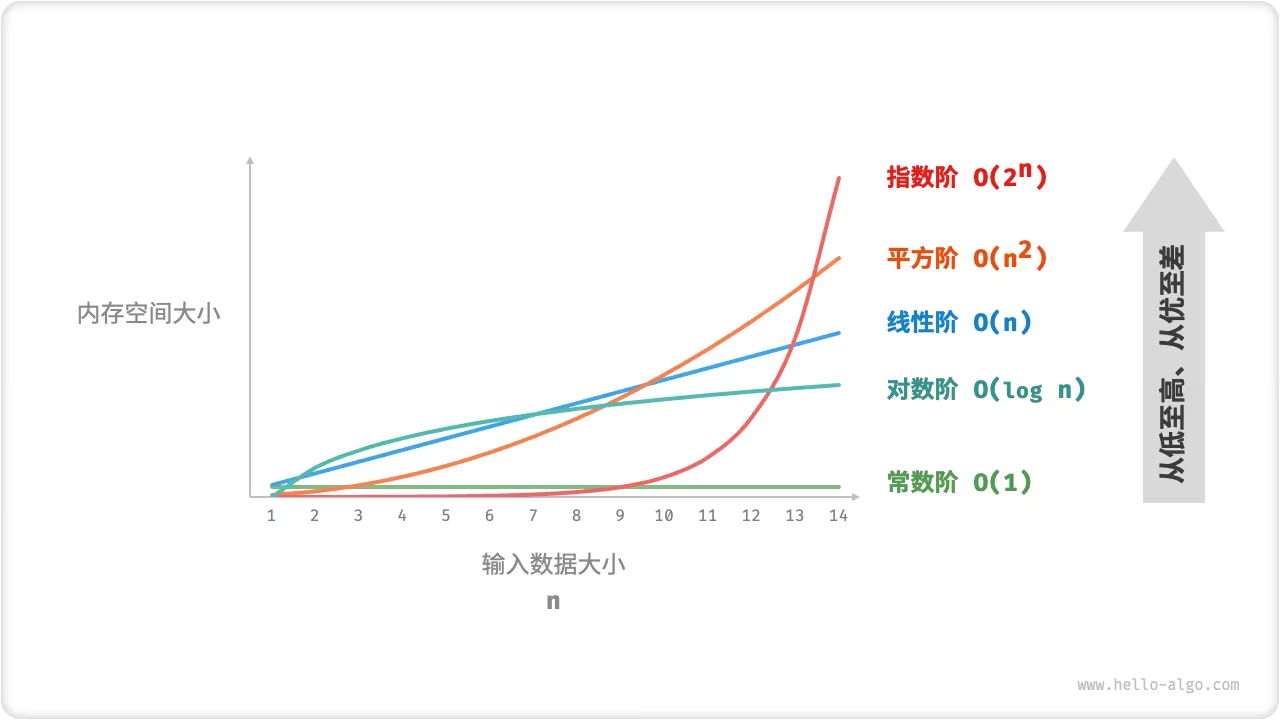
常见于数量与输入的数据大小 无关的常量、变量、对象
/* 函数 */int func(){ // 执行某些操作 return 0;} /* 常数阶 */void constant(int n){ // 常量、变量、对象占用 O(1) 空间 const int a = 0; int b = 0; vector<int> nums(10000); ListNode node(0); // 循环中的变量占用 O(1) 空间 for (int i = 0; i < n; i++) {int c = 0;} // 循环中的函数占用 O(1) 空间 for (int i = 0; i < n; i++) {func();}}因为上面循环中初始化变量和调用函数而占用的内存,在进入下一轮循环后就被释放了,因此不会积累占用空间,所以空间复杂度仍然为
其常见于数组、链表、栈、队列等
/* 线性阶 */void linear(int n){ // 长度为 n 的数组占用 O(n) 空间 vector<int> nums(n); // 长度为 n 的列表占用 O(n) 空间 vector<ListNode> nodes; for (int i = 0; i < n; i++) {nodes.push_back(ListNode(i));} // 长度为 n 的哈希表占用 O(n) 空间 unordered_map<int, string> map; for (int i = 0; i < n; i++) {map[i] = to_string(i);}} 如下的递归深度为 ,即同时存在 个未返回的 linear_recur() 函数,使用了 大小的栈帧空间
/* 线性阶(递归实现) */void linearRecur(int n){ cout << "递归 n = " << n << endl; if (n == 1) {return;} linearRecur(n - 1);}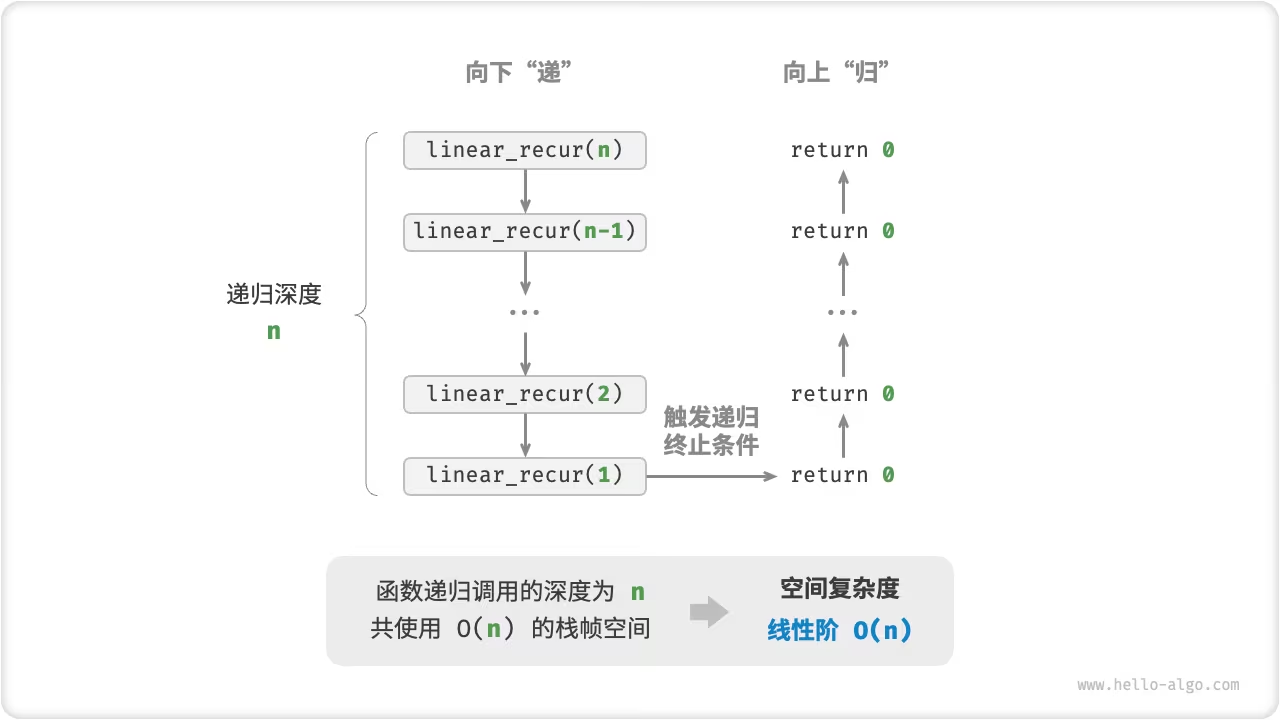
常见于二维数组、矩阵、图等,元素数量与 成平方关系
/* 平方阶 */void quadratic(int n){ // 二维列表占用 O(n^2) 空间 vector<vector<int>> numMatrix; for (int i = 0; i < n; i++) { vector<int> tmp; for (int j = 0; j < n; j++) {tmp.push_back(0);} numMatrix.push_back(tmp); }} 如下,该函数的递归深度为 ,在每个递归函数中都初始化了一个数组,长度分别为 ,平均长度为 ,因此总体占用 的空间
/* 平方阶(递归实现) */int quadraticRecur(int n){ if (n <= 0) {return 0;} vector<int> nums(n); cout << "递归 n = " << n << " 中的 nums 长度 = " << nums.size() << endl; return quadraticRecur(n - 1);} 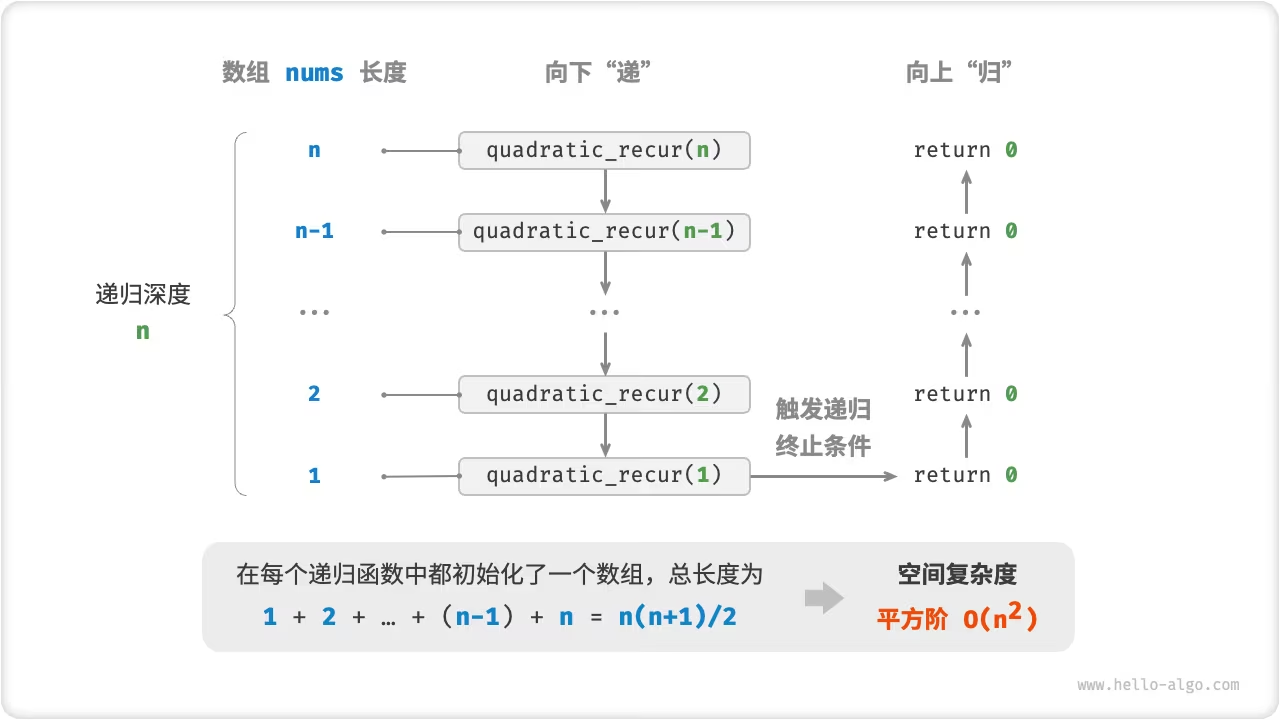
常见于二叉树
如下一个高度为 的 “满二叉树” 的节点数量为 ,占用 空间
/* 指数阶(建立满二叉树) */TreeNode *buildTree(int n){ if (n == 0) {return nullptr;} TreeNode *root = new TreeNode(0); root->left = buildTree(n - 1); root->right = buildTree(n - 1); return root;} 
常见于分治算法,
比如:
归并排序,输入长度为 的数组,每轮递归将数组从中点划分为两半,形成高度为 的递归树,使用了 的空间
将数组转化为字符串,输入一个正整数 ,它的位数为 ,因此空间复杂度为
理想情况下,都想要时空复杂度达到最优,但实际上这是很困难的
一般而言,降低时间复杂度通常要以提升空间复杂度为代价的,反之亦然。
常称这种方法叫:“以空间换时间” 或 “以时间换空间”
一般而言,时间比空间宝贵,因此常用 “以空间换时间” ,当然了也不是绝对的,比如数量量很大时
过程式编程(函数),面向对象编程(方法)
C C++ / Python Java / C#
函数(function)可以被独立执行,所有参数都以显式传递。方法(method)与一个对象关联,被隐式传递给调用它的对象,能够对类的实例中包含的数据进行操作。
下面以几个常见的编程语言来说明。
C 语言是过程式编程语言,没有面向对象的概念,所以只有函数。但我们可以通过创建结构体(struct)来模拟面向对象编程,与结构体相关联的函数就相当于其他语言中的方法。
Java 和 C# 是面向对象的编程语言,代码块(方法)通常都是作为某个类的一部分。静态方法的行为类似于函数,因为它被绑定在类上,不能访问特定的实例变量。
C++ 和 Python 既支持过程式编程(函数),也支持面向对象编程(方法)。
常见的数据结构包括数组、链表、栈、队列、哈希表、树、堆、图,它们可以从 “逻辑结构” 和 “物理结构” 两个维度进行分类
逻辑结构揭示了数据元素之间的逻辑关系
有些是线性关系,有些是祖先与后代的派生关系,有些是网络关系
线性数据结构:数组、链表、栈、队列、哈希表
非线性数据结构:树、堆、图、哈希表

还可以按照对应关系来分:
线性结构:数组、链表、队列、栈、哈希表,元素之间是一对一的顺序关系
树形结构:树、堆、哈希表,元素之间是一对多的关系
网状结构:图,元素之间是多对多的关系
计算机中,主要用硬盘和内存来存储数据
硬盘:长期存储,容量较大(TB 级别),速度较慢
内存:暂存数据,容量较小(GB 级别),速度较快
在算法运行过程中,相关数据都存储在内存中
系统通过内存地址来访问目标位置的数据。每个内存空间都有唯一的内存地址

内存是所有程序的共享资源,当某块内存被某个程序占用时,则无法被其他程序同时使用了。因此在数据结构与算法的设计中,内存资源是一个重要的考虑因素。
比如:算法所占用的内存峰值不应超过系统剩余空闲内存;如果缺少连续大块的内存空间,那么所选用的数据结构必须能够存储在分散的内存空间内。
物理结构翻译了数据在计算机内存中的存储方式,
可分为:
连续空间存储(数组) 连续空间,时间较短
分散空间存储(链表) 分散空间,时间较长
物理结构从底层决定了数据的访问、更新、增删等操作方法,同时在时间与空间效率上存在互补的特点

注意:所有的数据结构都是基于数组、链表或两者的组合实现的
例如:栈和队列可以使用数组实现,也可基于链表实现,而哈希表的实现可能同时包含数组和链表
基于数组可实现:栈、队列、哈希表、树、堆、图、矩阵、张量(维度 的多维数组)等
基于链表可实现:栈、队列、哈希表、树、堆、图等
基于数组实现的数据结构被称为 “静态数据结构” ,意味着此类数据结构在初始化后长度不可变
基于链表实现的数据结构被称为 “动态数据结构” ,它们在初始化后,长度仍可以改变
像是文本、图片、3D 模型等各种形式都是由各种基本数据类型构成的
**基本数据类型是 CPU 可以进行运算的类型,**在算法中直接被使用,主要包括以下几种类型
整数类型:byte、short、int、long
浮点类型:float、double,用于表示小数
字符类型:char,用于表示包括表情符号等的符号
布尔类型:bool,用于表示 “是” 与 "否" 判断
注:不同编程语言可能使用不同的符号来表示这些数
**基本数据类型以二进制的形式存储在计算机中。**一个二进制位(一位)为 比特。一般 字节(byte)= 比特(bits)
基本数据类型的取值范围取决于其占用空间的大小,
以 Java 为例:
整数类型 byte 占用 byte = bits ,可以表示 个数字。
整数类型 int 占用 bytes = bits ,可以表示 个数字。
| 类型 | 符号 | 占用空间 | 最小值 | 最大值 | 默认值 |
|---|---|---|---|---|---|
| 整数 | byte | 1 byte | |||
| short | 2 byte | ||||
| int | 4 byte | ||||
| long | 8 byte | ||||
| 浮点数 | float | 4 byte | |||
| double | 8 byte | ||||
| 字符 | char | 2 /1 byte | |||
| 布尔 | bool | 1 byte |
注:
C/C++中没有明确基本数据类型的大小,根据平台各异
字符 char 在 C/C++中为 字节,其他语言中要看字符的编码方法
布尔类型虽然只要 位( 或 ),但在内存中常被存储为 字节,因为现代计算机的 CPU 常将 字节作为最小寻址内存单元
基本数据类型与数据结构的关系:
数据结构是在计算机中组织与存储数据的方式。它的主语是 “结构” 而非 “数据”,换句话说,基本数据类型提供了数据的 “内容类型”,而数据结构提供了数据的 “组织方式”
// 使用多种基本数据类型来初始化数组int numbers[5];float decimals[5];char characters[5];bool bools[5];由上可知,byte 的取值范围是 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲-128,127]
因为内存存储分为原码、反码、补码
数字是以“补码”的形式存储在计算机中的
**原码:**将数字的二进制表示的最高位视为符号位。 表示正数, 表示负数,其余表示数字的值
**反码:**正数的反码 其原码,负数的反码是 其原码除符号位以外的位取反
**补码:**正数的补码 其原码,负数的补码 其反码+1
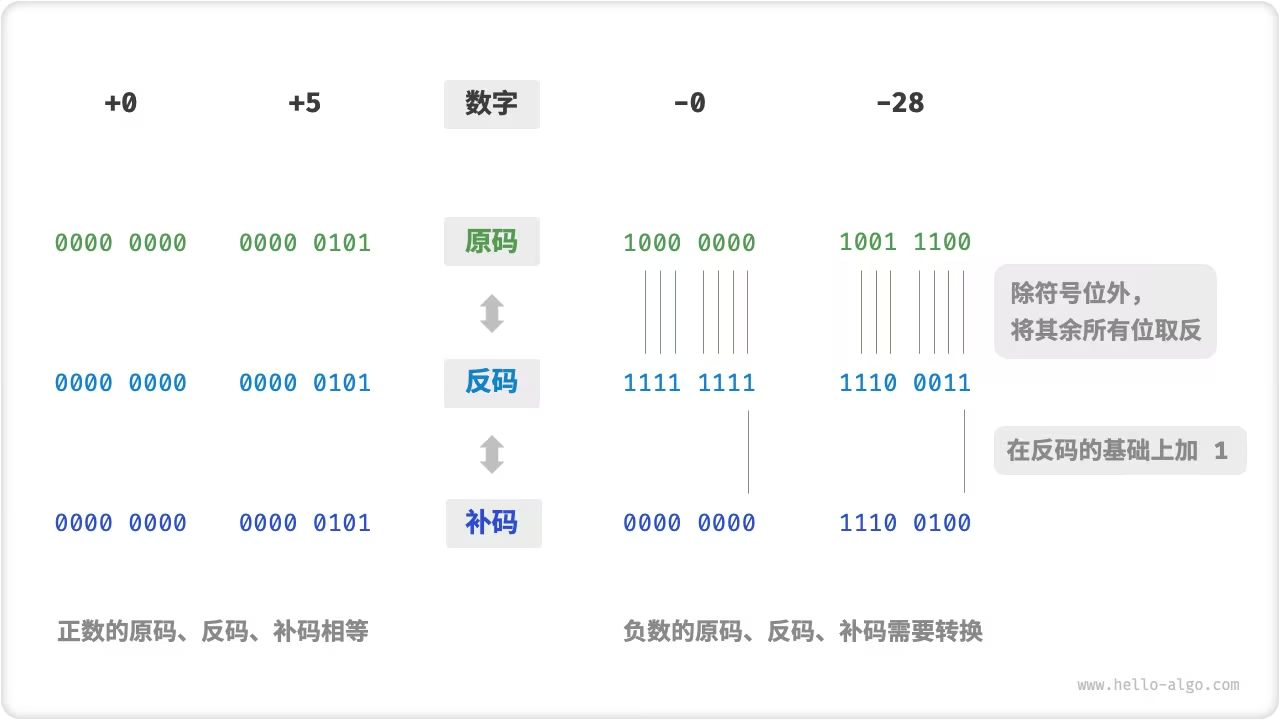
「原码 true form」的优点是直观,缺点是负数的原码不能用于运算
例如计算:
因此引入了「反码 1's complement code」,这样就可以计算了
例如计算:
但缺点是 有 和 两种表示方式,会在比如条件判断中没有区分的话判错
因此引入了「补码 2's complement code」
ParseError: KaTeX parse error: Expected group as argument to '\=' at position 73: …码)} \newline \= ̲; & 1111 ; 1111…
因为 byte 的长度只有 8 位,溢出的第九位就被舍弃了,因此负零的补码为 ,与正零的补码相同,该问题也得到了解决
但补码 没有对应的原码,根据转换方法它的原码是 即 ,因此人为定义它为 。因为 在补码中的计算结果就是
计算机内部的硬件电路主要是基于加法运算设计的,因为它硬件实现起来简单,更容易并行化处理。当然,也可以将加法与基本逻辑运算结合,这样就能够实现各种其他的数学运算,比如 转换为 或多次加法变为乘法,计算多次减法变为除法。
因此,设计补码的根本原因是可以简化正数与负数的加法,不用设计特殊的硬件电路来处理减法与 ±0 歧义问题,简化了硬件设计,提高了运算效率
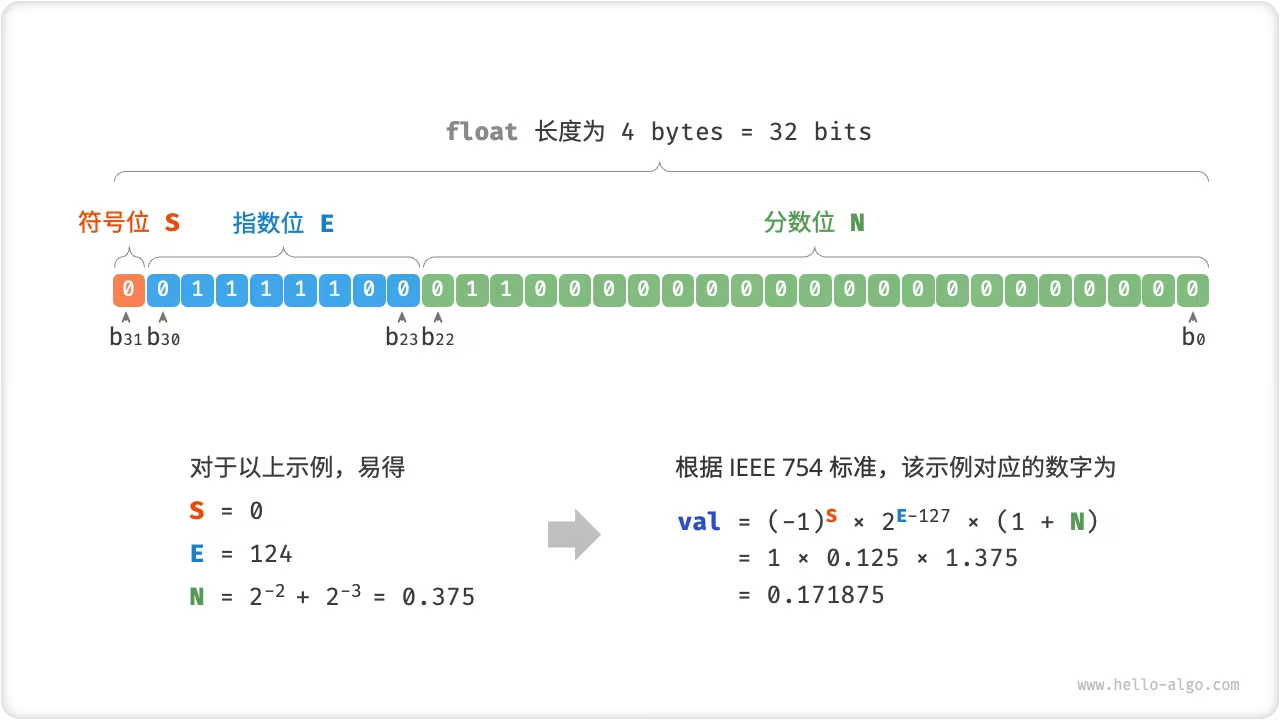
浮点数 float 使用了与 int 不同的编码方式,用了 IEEE 754 编码标准
设一个 32-bit 长度的二进制数为:
根据其标准,它由以下三部分组成:
符号位 :占 1 bit , 对应
指数位 :占 8 bits, 对应
分数位 :占 23 bits,对应
因此二进制数 float 对应的值 val 的计算方法是:
转化到十进制的计算公式是:
其中各项的取值范围是:
ParseError: KaTeX parse error: Undefined control sequence: \[ at position 163: …^{-i}) \subset \̲[̲1, 2 - 2^{-23}]…
其他:
改变指数位的符号就可以得到负数
float 通过指数位提高了取值范围,但也导致了其精度被牺牲了它的数值越大,相邻的两个数字之间的差值也就会趋向越大
指数位 和 有特殊含义,用于表示 ,、
( 没有的数/未定义的数/无效的数/非法操作得到的数)
| 指数位 E | 分数位 | 分数位 | 计算公式 |
|---|---|---|---|
| 次正规数 | |||
| 正规数 | 正规数 | ||
次正规数显著的提高了浮点数的精度,因为次正规数就是小数部分,它本身就有 的精度,再乘以指数部分得到正规数的话,精度就更高了
最小的正 正规数为 ,最小的正 次正规数为 ()
次正规数是指浮点数中,两个相邻的浮点数之间的距离最小的那个数(两个数之间的精度)正规数是指浮点数中,相邻两个浮点数之间的距离相等的一组数。换句话说,正规数是浮点数表示法中能够被准确表示的所有实数的集合。
它俩的区别就是:正规数的精准度比次正规数的精度更高一些
double 的也和 float 的表示方法一样,只是位数变多了,精度变大了
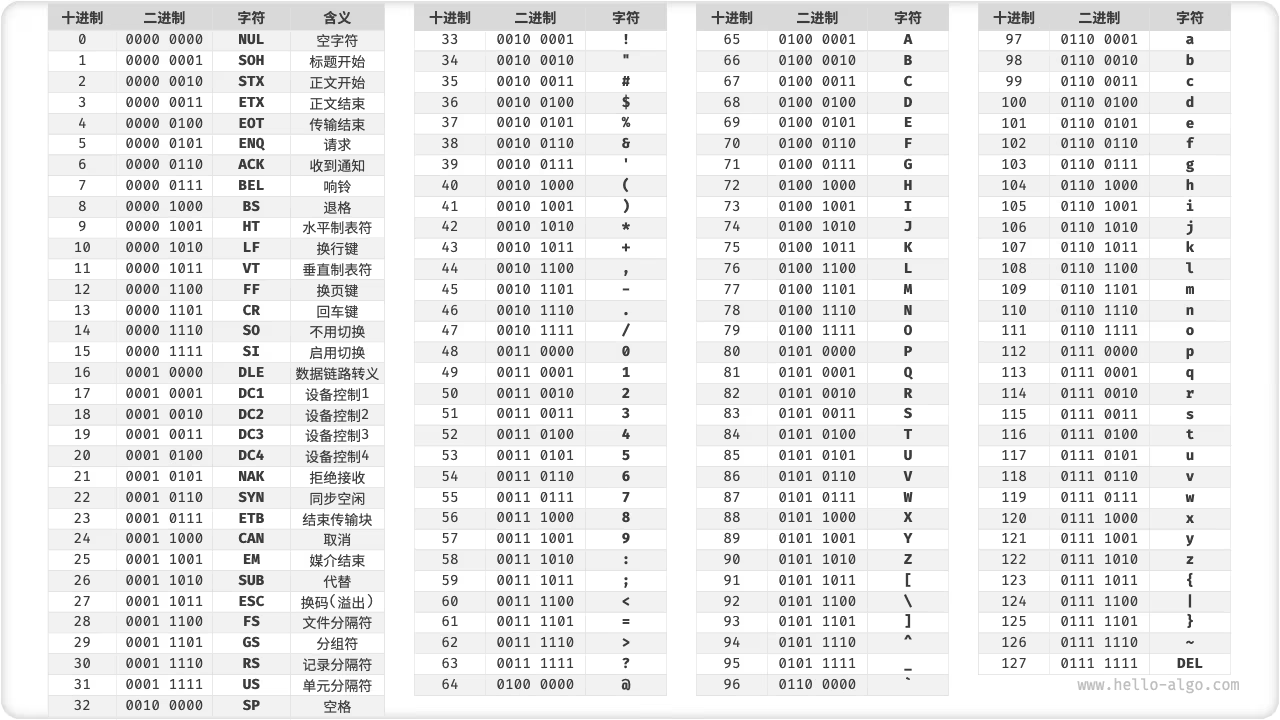
为了在计算机中通过二进制表示字符,因此人们建立了一套 “字符集” ,来表示字符——通过查表查询每个字符与二进制之间的关系,来表示它
「ASCII 码」是最早出现的字符集,全称是 “美国信息交换标准代码”,它使用了一个字节的低 7 位标识一个字符(最高位一直是 0 )。通过这种方式,可以标识 128 种不同的字符,包括英文字母的大小写、数字 0~9、一些标点符号和控制字符(包括换行符或制表符)
因为 ASCII 码只能表示英文,因此人们通过将首位的 0,改为 1 ,新增了后 128 位用于表示其他字符 其叫「EASCII」。它在每个公司或每个国家的定义都不同,以适应不同语言的需求
因为 EASCII 码仍然无法满足许多语言的字符数量要求。比如汉字大约有近 10 万个,因此在 1980 年诞生了「GB2312」字符集(GB 为中国国家标准)
其收录了 6763 个汉字和其他的一些字符,它也是 ASCII 码的扩展
但在之后诞生了「GBK」字符集,以满足处理罕见字与生僻字的需要,共包含了 21886 个汉字,还有一些其他的字符。因为它是由 GB2312 扩展出来的,因此可以直接兼容它。
在 GBK 中,ASCII 字符使用一个字节表示,汉字使用两个直接表示
当然,在后面 2000 年的时候,出现了以 GBK 扩展而来的 GB18030,其包括 2.7 万个汉字
为了统一字符集与编码标准,解决跨语言环境传输与乱码问题,人们推出了一个足够完整的字符集,将世界范围内的所有语言和符号都收录其中,其叫 “Unicode”
「Unicode」的全称为“统一字符编码”,最多可容纳 100 多万个字符,现在它已包含 14 万个字符,包括各种语言的字符、符号、表情包等,也包含了 8 万多个汉字。在其中,常用的字符占用 2 字节,生僻的字符占 3 或 4 字节
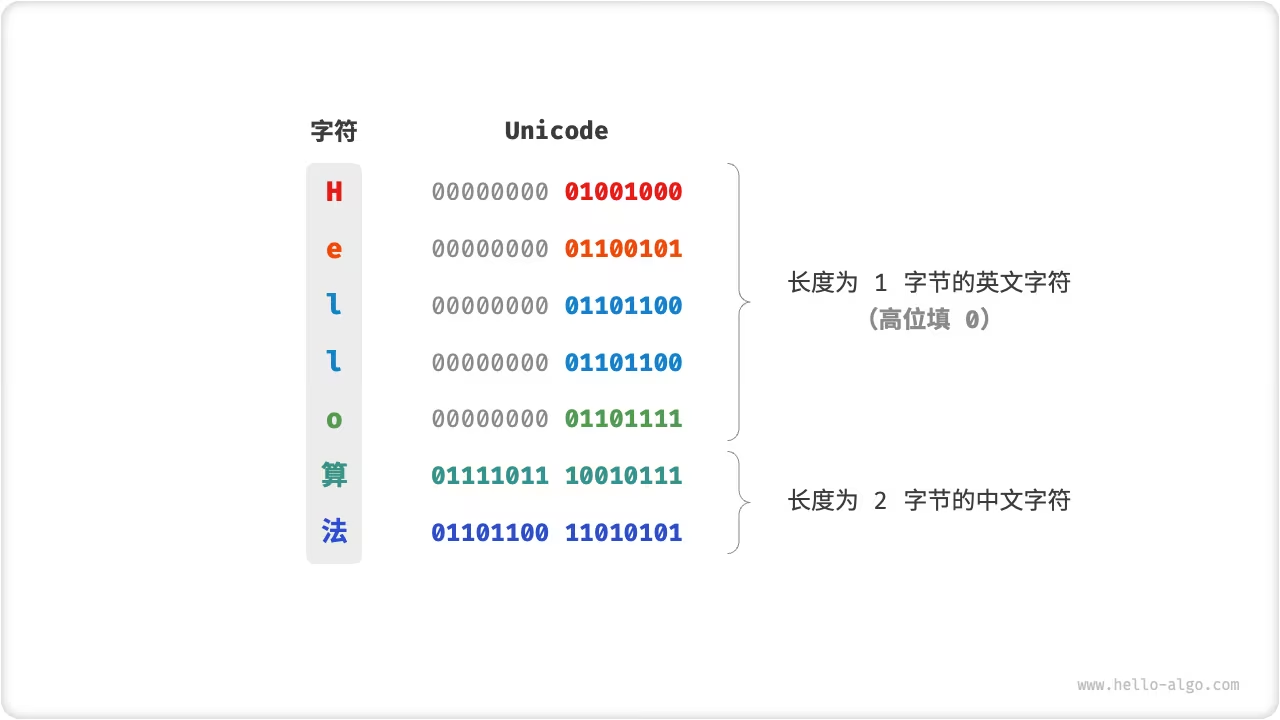
因为 Unicode 它只是一种字符集标准,只是给每个字符分配一个编号(称为“码点”)的一张表,但它并没有规定在计算机中如何存储这些字符码点,因此出现了很多种编码标准用于解析字符
其中一种最简单的方法(Unicode 默认编码)就是将所有字符存储为等长的编码,占 1 字节的在 2 字节中就高位填 0
因为上面的编码方法太占内存空间了,因此出现了更加高效的不同的编码方法
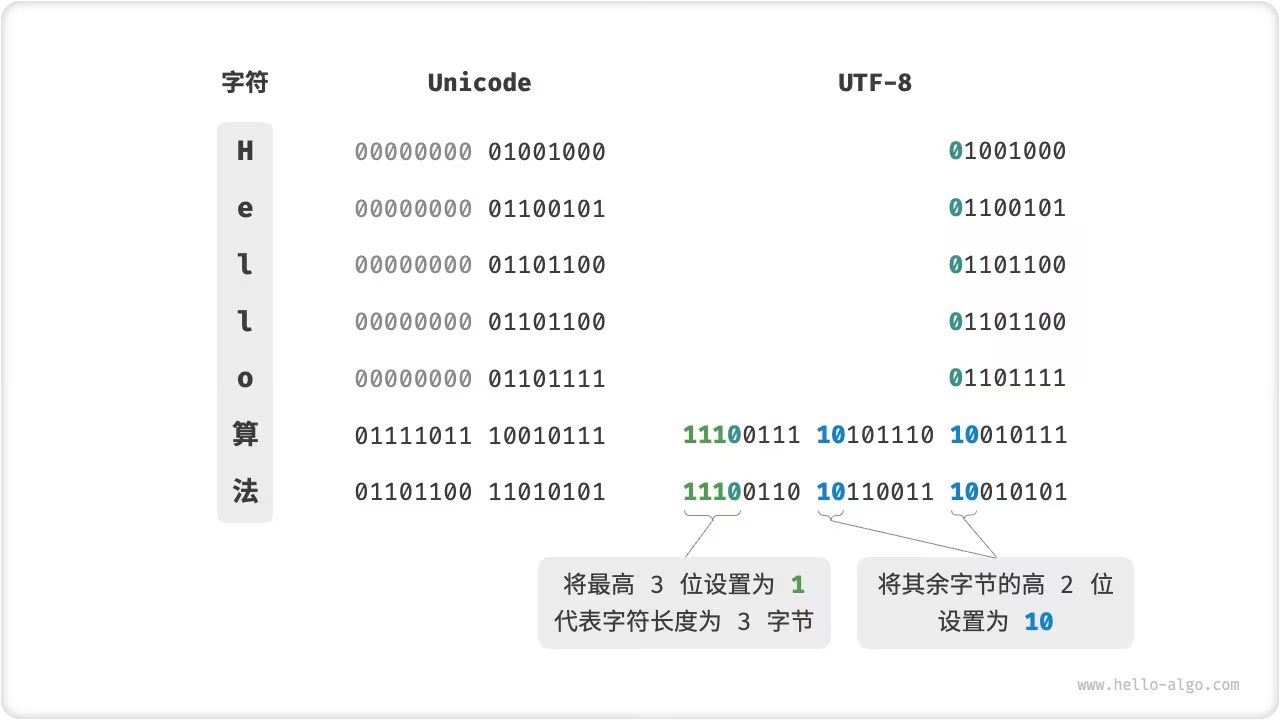
目前,它是最广泛使用的 Unicode 编码方法,它是一种可变长的编码,使用 1 到 4 个字符来表示一个字符,更据字符的复杂度来变
ASCII 字符只需要 1 个字节,拉丁字母和希腊字母需要 2 个字节,常用的中文字符需要 3 个字节,其他的一些生僻字符需要 4 个字节。
其通过下面的方式来编码:
对于长度为 1 字节的字符,将最高位设置为 、其余 7 位设置为 Unicode 码点。值得注意的是,ASCII 字符在 Unicode 字符集中占据了前 128 个码点。也就是说,UTF-8 编码可以向下兼容 ASCII 码。这意味着我们可以使用 UTF-8 来解析年代久远的 ASCII 码文本。
对于长度为 字节的字符(其中 ),将首个字节的高 位都设置为 、第 位设置为 ;从第二个字节开始,将每个字节的高 位都设置为 ;其余所有位用于填充字符的 Unicode 码点。
这种方法的绿色,最高 位都被设置为 ,因此系统可以通过读取最高位 的个数来解析出字符的长度为 。
它的蓝色,也就是 是校验符,之所以将 当作校验符,是因为在 UTF-8 编码规则下,不可能有字符的最高两位是 。这个结论可以用反证法来证明:假设一个字符的最高两位是 ,说明该字符的长度为 ,对应 ASCII 码。而 ASCII 码的最高位应该是 ,与假设矛盾。
因为 UTF-8 编码的前 128 位为 ASCII 码,因此UTF-8 编码可以向下兼容 ASCII 码
除了 UTF-8 之外,还有两种常用的编码方法:
**UTF-16 编码:**使用 2 或 4 个字节来表示一个字符,ASCII 字符和常用的字符都使用 2 字节表示,其他的使用 4 字节表示,对于 2 字节的字符,UTF-16 编码和 Unicode 码点相等
**UTF-32 编码:**所有字符都使用 4 个字节表示,相比于上面的编码,缺点就是更占用空间
相比之下,UTF-8 表示英文更高效 并且通用性更佳,UTF-16 表示中文等更高效(UTF-16 中文 2 字节,UTF-8 可能要三字节)
UTF-16 或 UTF-32 这类等长的编码的优点:它们可以将字符串看作数组来处理,这种做法的优点是:
**随机访问:**因为它们不是可变长编码。因此,要找到第 个字符,只需要计算就好了。但 UTF-8 的话,要重头开始遍历到第 个字符,这需要 的时间
**字符计数:**同上,计算长度只要 ,但 UTF-8 看要遍历整个字符串
**字符串操作:**很多字符串操作(如分割、连接、插入、删除等)都更容易进行,但 UTF-8 中要额外的计算,以保证不会产生无效的 UTF-8 编码
一些常见的编程语言的编码:
C/C++ 没有默认编码
Java 它的String 类型使用 UTF-16 编码。因为它在设计之初时,就认为 16 位已经够用了,因此,当超过 16 位时,会用两个(一对)16 位的值表示(简称 “代理对” )
JavaScript 和 TypeScript使用了 UTF-16 编码,它们与 Java 的理由类似
C# 使用 UTF-16 编码,因为 .NET 平台是由 Microsoft 设计的,而它的很多技术,包括 Windows 系统,都广泛使用了 UTF-16 编码
由于以上编程语言对字符数量的低估,它们不得不采取“代理对”的方式来表示超过 16 位长度的 Unicode 字符。这是一个不得已为之的无奈之举。一方面,包含代理对的字符串中,一个字符可能占用 2 字节或 4 字节,从而丧失了等长编码的优势。另一方面,处理代理对需要增加额外代码,这增加了编程的复杂性和 Debug 难度。
因此,其他的语言使用了其他的方法:
Python 中的 str 使用 Unicode 编码,但按照每个字符串的最大长度来决定使用 1 个字节,还是 2 或 4 个字节
Go 语言的 string 类型在内部使用 UTF-8 编码。它还提供 rune 类型,用于表示单个 Unicode 码点
Rust 语言的 str 和 String 类型(不可变和可变类型)在内部使用 UTF-8 编码,它还提供 char 类型,用于表示单个 Unicode 码点
但以上只是在编程语言中打开、运行时的存储方式,在网络传输或文件中存储时,会使用 UTF-8 编码,以节约空间、提高传输效率
数据结构的世界如同一堵厚实的砖墙。
数组的砖块整齐排列,逐个紧贴。链表的砖块分散各处,连接的藤蔓自由地穿梭于砖缝之间。
「数组 array」是一种线性数据结构,它的本质是将相同类型的元素存储在连续的内存空间中。常将元素在数组中的位置称为该元素的「索引 index」
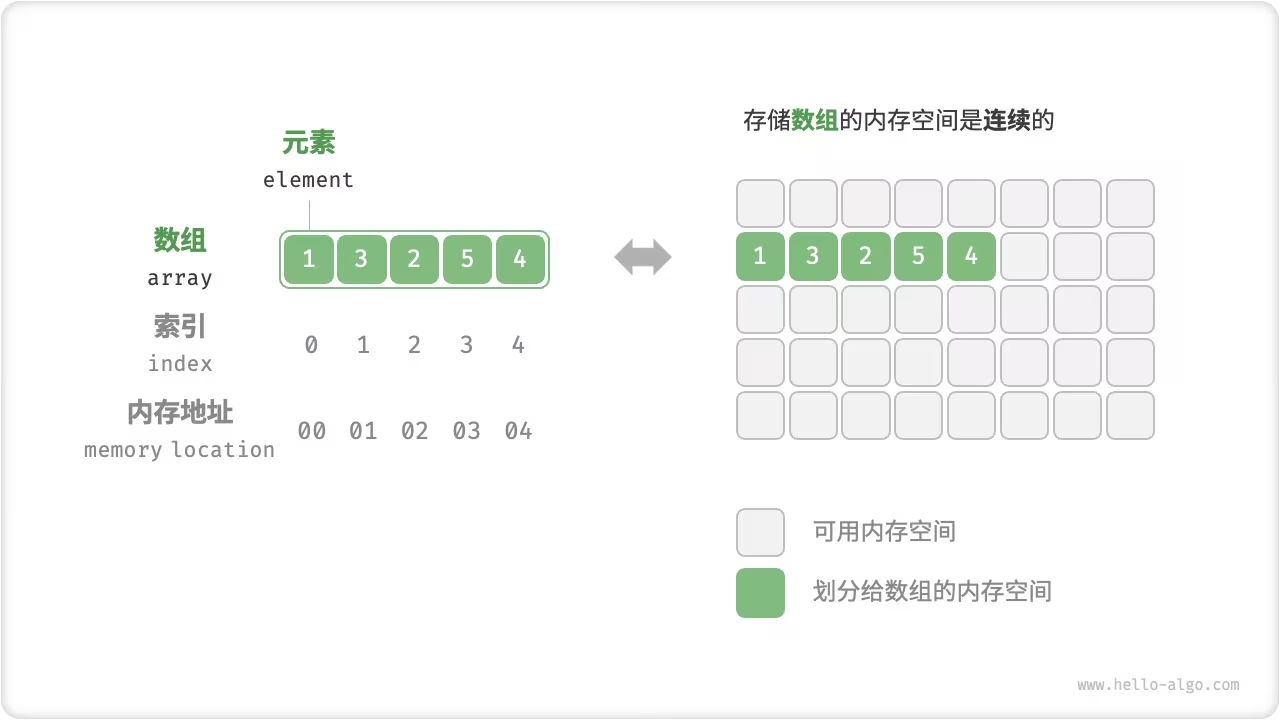
可以通过两种方法初始化数组
无初始值 (有的会默认为 0,有点会含有垃圾值)
给定初始值
/* 初始化数组 */// 存储在栈上int arr[5];int nums[5] = { 1, 3, 2, 5, 4 };// 存储在堆上(需要手动释放空间)int* arr1 = new int[5];int* nums1 = new int[5] { 1, 3, 2, 5, 4 };因为数组元素是被存储在连续的内存空间中,因此只要知道数组内存地址(首元素的内存地址)和某个元素的索引,就可以使用以下的公式得到该元素的内存地址,从而直接访问此元素
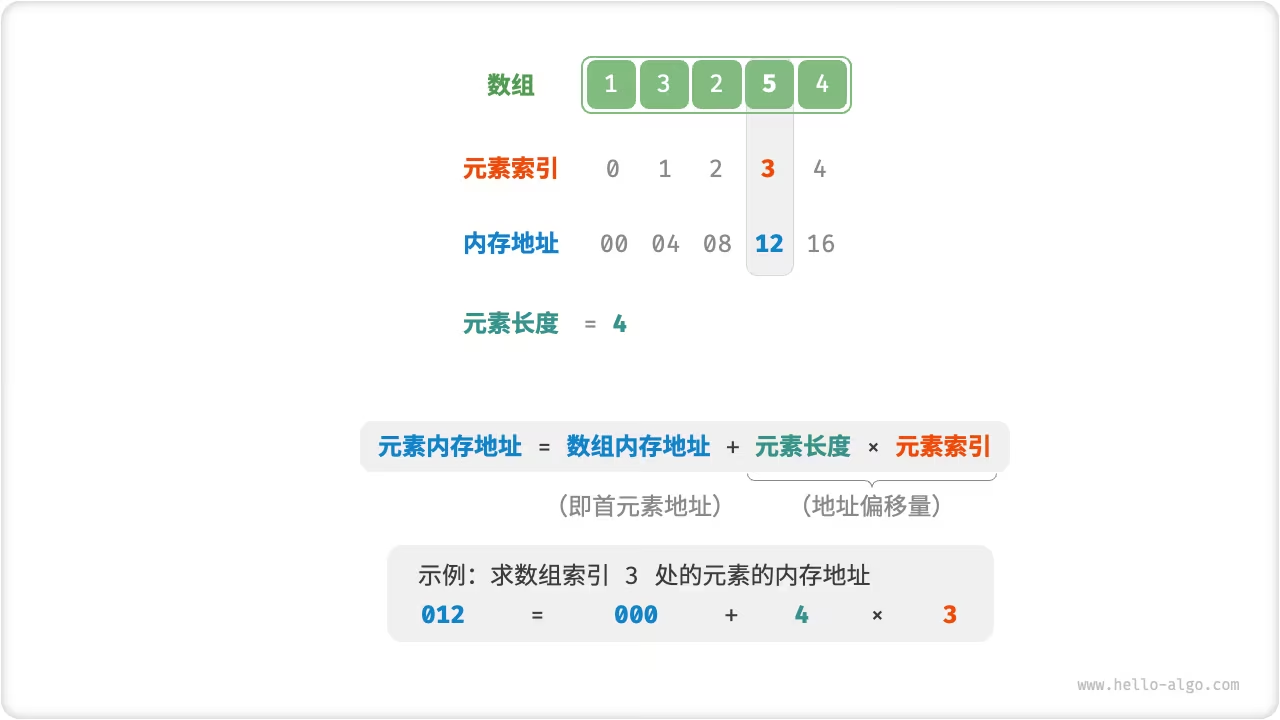
数组首个元素的索引为 ,因为索引的本质是内存地址的偏移量
在数组中访问元素是非常高效的,可以在 的时间内随机访问数组中任意一个元素
/* 随机访问元素 */int randomAccess(int[] nums) { // 在区间 [0, nums.length) 中随机抽取一个数字 int randomIndex = ThreadLocalRandom.current().nextInt(0, nums.length); // 获取并返回随机元素 int randomNum = nums[randomIndex]; return randomNum;}因为数组在内存中是“紧挨着的”,因此想要在数组中插入一个元素,则需要将该元素后的索引元素向后移动一位,灾后再把元素赋值给该索引
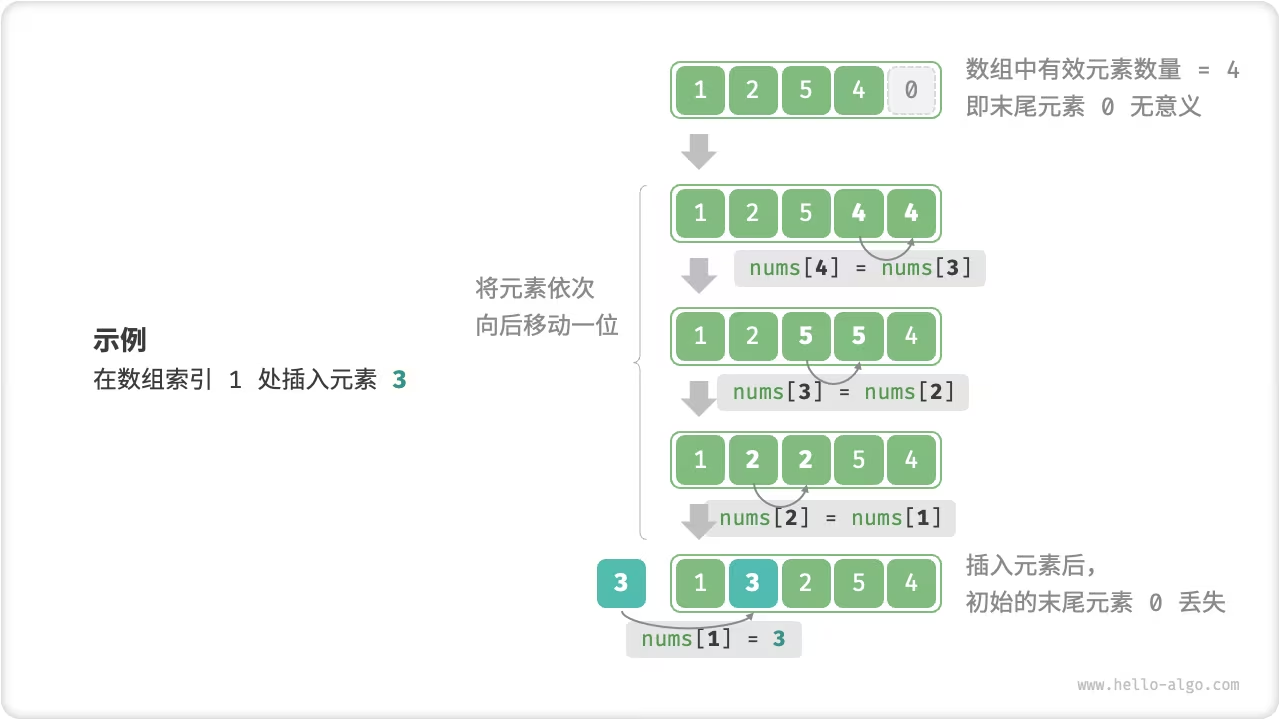
因为数组的长度是固定的,因此若数组末尾没有提前留下额外空间,则插入一个元素,必定导致数组尾部的元素“丢失”
/* 在数组的索引 index 处插入元素 num */void insert(int *nums, int size, int num, int index) { // 把索引 index 以及之后的所有元素向后移动一位 for (int i = size - 1; i > index; i--) { nums[i] = nums[i - 1]; } // 将 num 赋给 index 处元素 nums[index] = num;}同理,要想删除索引 处的元素,就将 之后的元素都向前移动一位
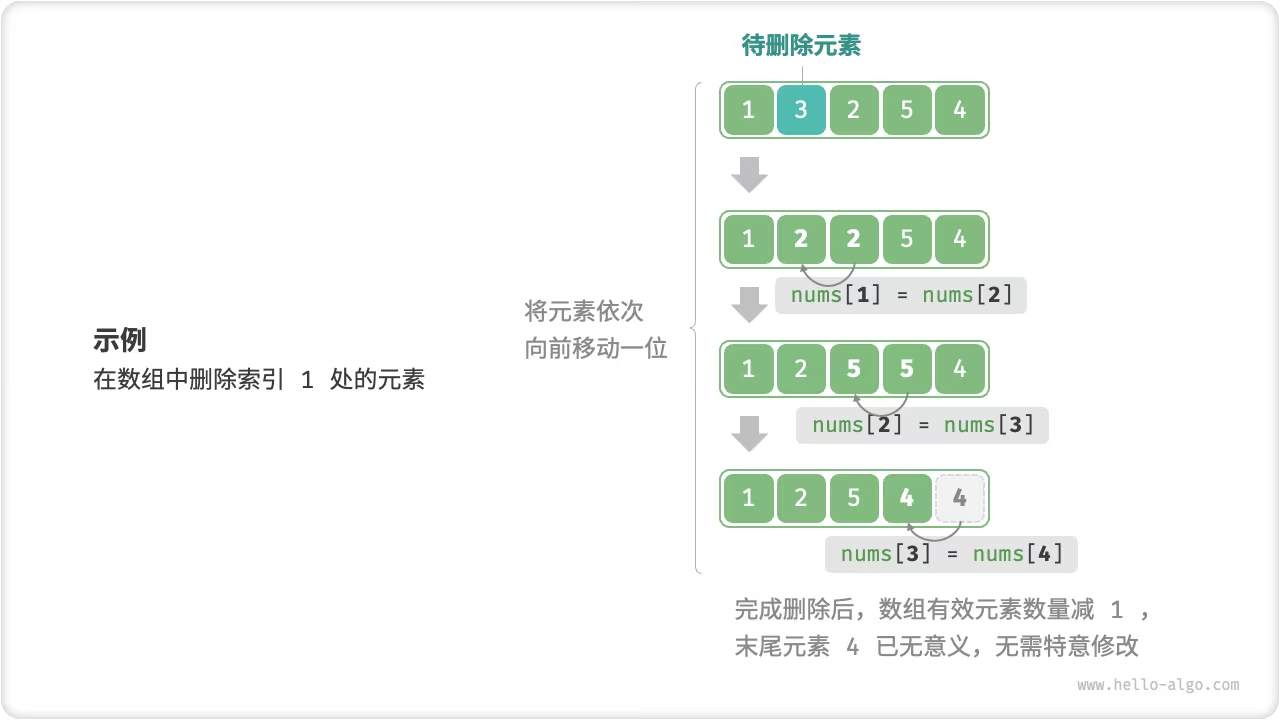
/* 删除索引 index 处元素 */void remove(int *nums, int size, int index) { // 把索引 index 之后的所有元素向前移动一位 for (int i = index; i < size - 1; i++) { nums[i] = nums[i + 1]; }}数组的插入与删除有以下缺点
时间复杂度高,平均都为 , 为数组长度
丢失元素,插入后丢失末尾元素
内存浪费,无论是初始一个长数组,只用前面,已防止丢失元素,还是删除元素后后的空余元素,都会造成内存空间的浪费
我们可以通过索引遍历数组,也可以直接遍历获取数组中的每一个元素
/* 遍历数组 */void traverse(int *nums, int size){ int count = 0; // 通过索引遍历数组 for (int i = 0; i < size; i++) { count++; } // 直接遍历数组 for (auto num : nums) { count++; }}// 以上只是一个示例,并没有展示如何处理数组元素。// 实际情况通常会在循环中对数组元素进行读取或处理,而不仅仅是增加一个意义不明的计数器。因为数组是线性数据结构,因此在数组中通过遍历数组来查找指定元素的方法叫 “线性查找”
/* 在数组中查找指定元素 */int find(int[] nums, int target){ for (int i = 0; i < nums.length; i++) { if (nums[i] == target) {return i;} } return -1;}在大多数编程语言中,数组的长度是不可变的
想要扩容数组,就要新建一个更大的数组,然后把原数组元素依次复制到新数组中。时间复杂度为
/* 扩展数组长度 */int *extend(int *nums, int size, int enlarge) { // 初始化一个扩展长度后的数组 int *res = new int[size + enlarge]; // 将原数组中的所有元素复制到新数组 for (int i = 0; i < size; i++) { res[i] = nums[i]; } // 释放内存 delete[] nums; // 返回扩展后的新数组 return res;} 因为数组的元素类型相同,且在连续的内存空间中,因此
优点:
空间效率高:数组是连续的内存块,无需额外的结构开销
支持随机访问:数组可以在 的时间内访问任何元素
缓存局部性(局部性原理):因为缓存的工作方式中有一点是会将之后可能访问的附近的元素放到高速缓存中,因此在访问数组的元素时,它周围的其他数据也会被计算机缓存到高速缓存中,可以立即被访问,提升执行速度
但连续空间也是双刃剑
缺点:
插入删除效率低:当数组中元素较多时,插入或删除操作要移动大量的元素
长度不可变:扩容数组要将所有数据复制到新数组中,开销很大
空间浪费:若数组分配的空间超过了实际所需,那么多余的空间就被浪费了
数组要求同类型是因为可以对齐,可以通过计算偏移量来计算对应元素位置
其频繁的应用于各类算法,或用于实现各种复杂的数据结构
随机访问:如果要随机抽取一些样本,可以通过数组将这些样本存储,并生成一个随机序列,然后根据索引实现样本的随机抽取
排序与搜索:像是快速排序、归并排序、二分查找等都主要在数组上进行
查找表:当我们需要查找一个元素,或查找一个元素的对应关系时(键值对),可以使用数组的快速访问特性作为查找表。
机器学习:神经网络中大量使用了向量、矩阵、张量之间的线性代数运算,这些数据都是以数组的形式构建的。数组是神经网络编程中最常使用的数据结构
数据结构实现:数组可以用于实现栈、队列、哈希表、堆、图等数据结构。例如,图的邻接矩阵表示实际上是一个二维数组。
因为内存空间是所有程序的公共资源,在开启了很多的程序后,空闲的内存空间可能散落在内存各处。又因为当没有足够大的连续空间用于在内存中存储数组时,链表的灵活性就体现出来了
「链表 linked list」也是一种线性数据结构,其中的每个元素都是一个节点的对象,各个节点通过 “引用(指针)” 相连接。“引用” 就是指向一个变量或对象的别名,这里是指向下一个节点的指针(内存地址)(以下都叫指针了,而不叫引用),通过它可以从当前节点访问到下一个节点
因此,它的各个节点可以被分散到内存的各处,而不用连续的内存空间

如上,链表的组成单位是「节点 node」对象。每个节点都包含两项数据:节点的 “值” 和指向下一节点的 “指针” 。
链表的首个节点叫 “头节点” ,最后一个节点叫 “尾节点”
尾节点指向的是 “空” ,它在 Java、C++、Python 中分别被标记为 、 和 。
TreeNode *cur = root;while (cur != nullptr) //这就是指向空的意思{ /*我是代码*/}// 注:nullptr是C++11新增的,用于替代“NULL”,防止出现问题,当然,使用“NULL”也可以除了非支持 “指针” 的语言外,都叫 “引用”
因为链表除了要包含一个值以外,还要包含一个指针,因此在相同的数据量的情况下,链表比数组会占用更多的内存空间
/* 链表节点结构体 */struct ListNode{ int val; // 当前节点的值 ListNode *next; // 指向下一节点的指针 ListNode(int x) : val(x), next(nullptr) {} // 构造函数,用于初始化节点的数值,并将下一个节点的指针初始化为空};建立链表分为两步
初始化各个节点的对象
构建指针指向下一节点的关系
/* 初始化链表 1 -> 3 -> 2 -> 5 -> 4 */// 初始化各个节点ListNode* n0 = new ListNode(1);ListNode* n1 = new ListNode(3);ListNode* n2 = new ListNode(2);ListNode* n3 = new ListNode(5);ListNode* n4 = new ListNode(4);// 构建引用指向n0->next = n1;n1->next = n2;n2->next = n3;n3->next = n4;数组整体是一个变量,比如数组a 包含a[0] 、a[1] 等
而链表因为是由多个独立的节点组成的,因此我们通常将头节点当作链表的代称,比如上述链表可记为 “链表n0”
如果在两个相邻的节点 n0 和 n1 中要插入一个新节点 p ,则只需要改变两个节点的指针即可,时间复杂度为
相比之下,数组插入一个元素的时间复杂度为 ,若数据量大则效率低

/* 在链表的节点 n0 之后插入节点 P */void insert(ListNode *n0, ListNode *P){ ListNode *n1 = n0->next; P->next = n1; n0->next = P;}删除节点同理,只需要改变一个节点的指针即可
如下图,只是删除了 n0 指向 p 的指针,改成了指向 n1 的,虽然没有删除 p 指向 n1 的,但遍历此链表时,已经无法访问 p 了,因此可认为 p 已经不属于当前链表了

/* 删除链表的节点 n0 之后的首个节点 */void remove(ListNode *n0){ if (n0->next == nullptr) return; // n0 -> P -> n1 ListNode *P = n0->next; ListNode *n1 = P->next; n0->next = n1; // 释放内存 delete P;}有些语言上面的 p 是会自动当作垃圾回收的,但有些不会
因为在链表访问节点的效率较低,要访问第 个节点要循环遍历前面的节点一共 轮,因此时间复杂度为
但数组只要
/* 访问链表中索引为 index 的节点 */ListNode *access(ListNode *head, int index){ for (int i = 0; i < index; i++) { if (head == nullptr) {return nullptr;} head = head->next; } return head;}也和上面一样,是线性查找,和数组的时间复杂度一样,为
/* 在链表中查找值为 target 的首个节点 */int find(ListNode *head, int target){ int index = 0; { if (head->val == target) {return index;} head = head->next; index++; } return -1;}| 数组 | 链表 | |
|---|---|---|
| 存储方式 | 连续内存空间 | 分散内存空间 |
| 缓存局部性 | 友好 | 不友好 |
| 容量扩展 | 长度不可变 | 可灵活扩展 |
| 内存效率 | 占用内存少、浪费部分空间 | 占用内存多 |
| 访问元素 | ||
| 添加元素 | ||
| 删除元素 |
添加是 但,如果先查找再添加就不是 了,是
**单向链表:**即上述介绍的链表,首个节点称为头节点,最后一个叫尾节点,指向空
**环形链表:**首尾相连,任意一个节点都可以视为头节点
**双向链表:**每个节点指向了两个前后方向的节点(前驱节点和后继节点)的指针,它相比于单向链表更灵活,但更费空间
/* 双向链表节点结构体 */struct ListNode{ int val; // 节点值 ListNode *next; // 指向后继节点的指针 ListNode *prev; // 指向前驱节点的指针 ListNode(int x) : val(x), next(nullptr), prev(nullptr) {} // 构造函数};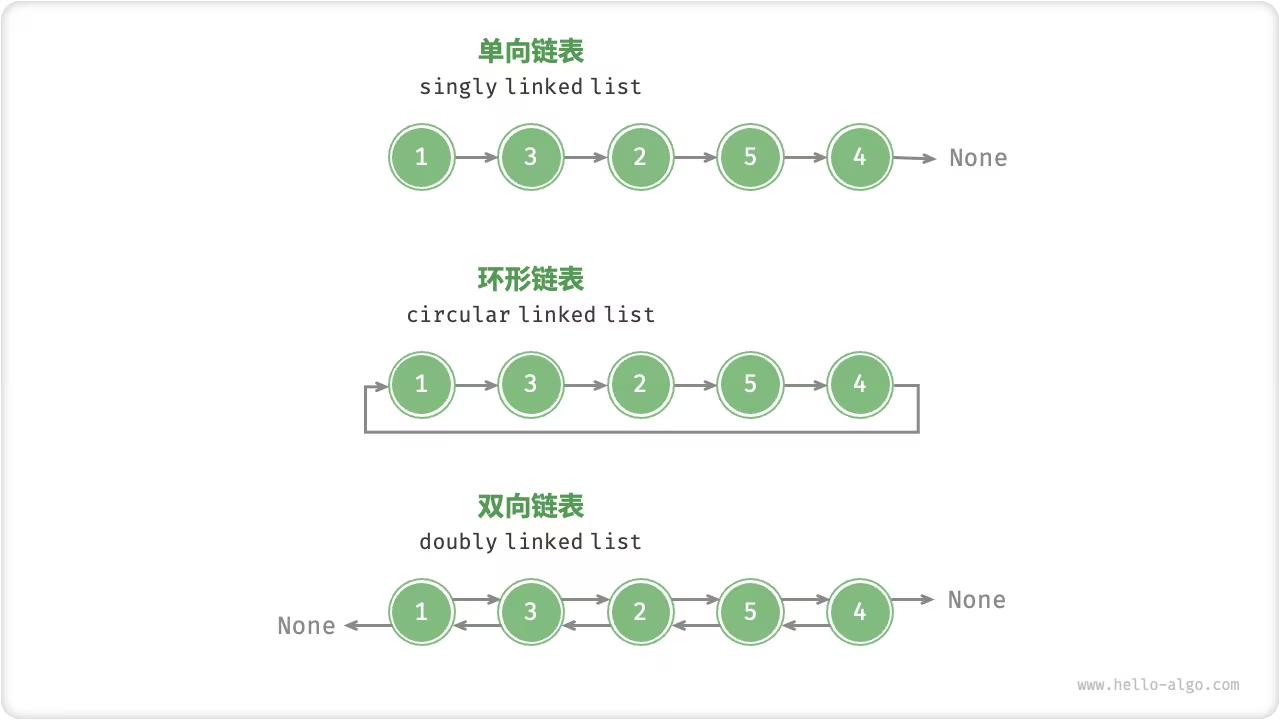
单向链表:
**栈与队列:**当插入和删除在链表的同一端进行时,它表现就是先进后出的特性,对应栈;当插入与删除分别在链表的两端进行时,他表现出先进先出的特性,对应队列
**哈希表:**使用 “链地址法” 是解决哈希冲突的主流方案之一
图:比如邻接表,在其中,图的每一个顶点都与一个链表相连,链表中的每个元素都代表与该顶点相连的其他顶点
**双向链表:**常用于要快速查找前后项的场景
**高级数据结构:**比如红黑树、B 树中,可以通过在每个元素中都保存一个指向父节点的指针来实现,类似双向链表
**浏览器历史:**当点击前进或后退按钮时,浏览器需要知道用户访问过的前一个和后一个网页,通过双向链表可以让实现变得很容易
**LRU 算法:**即缓存淘汰算法,其需要快速找到最近最少使用的数据,以及支持快速地添加和删除节点,这时用双向链表就非常合适
**循环链表:**常用于要周期性的操作
**时间片轮调度算法:**是一种常见的 CPU 调度算法,将每个进程被赋予一个时间片,当时间片用完时,CPU 将切换到下一个进程。这种循环的操作就可以通过循环链表来实现。
**数据缓冲区:**比如歌单循环播放
「列表 list」是一個抽象的数据结构概念,它表示元素的有序集合,无需考虑容量限制问题。列表可以基于链表或数组实现
链表天然可以被看作是一个列表
数组因长度不可变,只能被看作是一个举要长度限制的列表
因此使用数组来实现,会因长度不可变让其的实用性降低,所以我们通常使用「动态数组 dynamic array」来实现列表
像是 Python 中的 list 、Java 中的 ArrayList 、C++ 中的 vector 和 C# 中的 List 等的列表都是基于动态数组实现的(但不是唯一实现策略,长度大了,有一些可能使用红黑树等等来扩容),因此 “列表” 和 “动态数组” 可简单视为是同一种概念(至少在下面,列表都只动态数组)
C++中:<list>用于表示双向链表(doubly linked list)
常用 “有初始值” 和 “无初始值(默认为 0)” 这两种初始化方法
/* 初始化列表 */// 需注意,C++ 中 vector 即是本文描述的 nums// 无初始值vector<int> nums1;// 有初始值vector<int> nums = { 1, 3, 2, 5, 4 };因为列表本质是数组(大多数语言中),因此可以在 时间访问和更新元素,效率很高
/* 访问元素 */int num = nums[1]; // 访问索引 1 处的元素 /* 更新元素 */nums[1] = 0; // 将索引 1 处的元素更新为 0在列表尾部添加元素的时间复杂度为 ,但插入和删除元素的效率仍然和数组相同,为
但如果要先扩容再插入到尾部就不是 了,而是
/* 清空列表 */nums.clear(); /* 尾部添加元素 */nums.push_back(1);nums.push_back(3);nums.push_back(2);nums.push_back(5);nums.push_back(4); /* 中间插入元素 */nums.insert(nums.begin() + 3, 6); // 在索引 3 处插入数字 6 /* 删除元素 */nums.erase(nums.begin() + 3); // 删除索引 3 处的元素与数组一样,可以用索引或直接遍历各元素
/* 通过索引遍历列表 */int count = 0;for (int i = 0; i < nums.size(); i++){ count++;} /* 直接遍历列表元素 */count = 0;for (int num : nums){ count++;}可以将一个列表拼接到原列表的尾部(C++是用插入的方式拼接的)
/* 拼接两个列表 */vector<int> nums1 = { 6, 8, 7, 10, 9 };// 将列表 nums1 拼接到 nums 之后nums.insert(nums.end(), nums1.begin(), nums1.end());当排序完列表后,我们便可以使用在数组类算法题中经常考察的 “二分查找” 和 “双指针” 算法
/* 排序列表 */sort(nums.begin(), nums.end()); // 排序后,列表元素从小到大排列sort(nums.rbegin(), nums.rend()); // 排序后,列表元素从大到小排列非用一个编程语言自带的,而是手动实现
要设计一个简易版的列表,以下三个是重点
初始容量:要选取一个合理是数组初始容量,以下选取 10 作为初始容量
数量记录:我们声明一个变量 size ,用于记录当前列表的元素数量,并随着元素插入和删除实时更新,因此我们也可以定位列表尾部,以及判断是否需要扩容
扩容机制:先按照倍数(如 2 倍)创建一个更大的数组,然后在将旧数组移动到新数组中(因此可能与初始内容小于初始容量一样,导致内存空间浪费)
/* 列表类简易实现 */class MyList { private: int *arr; // 数组(存储列表元素) int arrCapacity = 10; // 列表容量 int arrSize = 0; // 列表长度(即当前元素数量) int extendRatio = 2; // 每次列表扩容的倍数 public: /* 构造方法 */ MyList() { arr = new int[arrCapacity]; } /* 析构方法 */ ~MyList() { delete[] arr; } /* 获取列表长度(即当前元素数量)*/ int size() { return arrSize; } /* 获取列表容量 */ int capacity() { return arrCapacity; } /* 访问元素 */ int get(int index) { // 索引如果越界则抛出异常,下同 if (index < 0 || index >= size()) throw out_of_range("索引越界"); return arr[index]; } /* 更新元素 */ void set(int index, int num) { if (index < 0 || index >= size()) throw out_of_range("索引越界"); arr[index] = num; } /* 尾部添加元素 */ void add(int num) { // 元素数量超出容量时,触发扩容机制 if (size() == capacity()) extendCapacity(); arr[size()] = num; // 更新元素数量 arrSize++; } /* 中间插入元素 */ void insert(int index, int num) { if (index < 0 || index >= size()) throw out_of_range("索引越界"); // 元素数量超出容量时,触发扩容机制 if (size() == capacity()) extendCapacity(); // 将索引 index 以及之后的元素都向后移动一位 for (int j = size() - 1; j >= index; j--) { arr[j + 1] = arr[j]; } arr[index] = num; // 更新元素数量 arrSize++; } /* 删除元素 */ int remove(int index) { if (index < 0 || index >= size()) throw out_of_range("索引越界"); int num = arr[index]; // 索引 i 之后的元素都向前移动一位 for (int j = index; j < size() - 1; j++) { arr[j] = arr[j + 1]; } // 更新元素数量 arrSize--; // 返回被删除元素 return num; } /* 列表扩容 */ void extendCapacity() { // 新建一个长度为原数组 extendRatio 倍的新数组 int newCapacity = capacity() * extendRatio; int *tmp = arr; arr = new int[newCapacity]; // 将原数组中的所有元素复制到新数组 for (int i = 0; i < size(); i++) { arr[i] = tmp[i]; } // 释放内存 delete[] tmp; arrCapacity = newCapacity; } /* 将列表转换为 Vector 用于打印 */ vector<int> toVector() { // 仅转换有效长度范围内的列表元素 vector<int> vec(size()); for (int i = 0; i < size(); i++) { vec[i] = arr[i]; } return vec; }}; 数组与链表这两种基础且重要的数据结构,它们分别代表了“连续存储” 和“分散存储”两种物理结构
实际上,物理结构在很大程度上决定了程序对内存和缓存的使用效率,进而影响算法程序的整体性能。
计算机中包括三种类型的存储设备:「硬盘 hard disk」、「内存 random-access memory, RAM」、「缓存 cache memory」。表 4-2 展示了它们在计算机系统中的不同角色和性能特点。
| 硬盘 | 内存 | 缓存 | |
|---|---|---|---|
| 用途 | 长期存储数据,包括操作系统、程序、文件等 | 临时存储当前运行的程序和正在处理的数据 | 存储经常访问的数据和指令,减少 CPU 访问内存的次数 |
| 易失性 | 断电后数据不会丢失 | 断电后数据会丢失 | 断电后数据会丢失 |
| 容量 | 较大,TB 级别 | 较小,GB 级别 | 非常小,MB 级别 |
| 速度 | 较慢,几百到几千 MB/s | 较快,几十 GB/s | 非常快,几十到几百 GB/s |
| 价格 | 较便宜,几毛到几元 / GB | 较贵,几十到几百元 / GB | 非常贵,随 CPU 打包计价 |
我们可以将计算机存储系统想象为下图所示的金字塔结构。越靠近金字塔顶端的存储设备的速度越快、容量越小、成本越高。这种多层级的设计并非偶然,而是计算机科学家和工程师们经过深思熟虑的结果。
硬盘难以被内存取代。首先,内存中的数据在断电后会丢失,因此它不适合长期存储数据;其次,内存的成本是硬盘的几十倍,这使得它难以在消费者市场普及。
缓存的大容量和高速度难以兼得。随着 L1、L2、L3 缓存的容量逐步增大,其物理尺寸会变大,与 CPU 核心之间的物理距离会变远,从而导致数据传输时间增加,元素访问延迟变高。在当前技术下,多层级的缓存结构是容量、速度和成本之间的最佳平衡点。
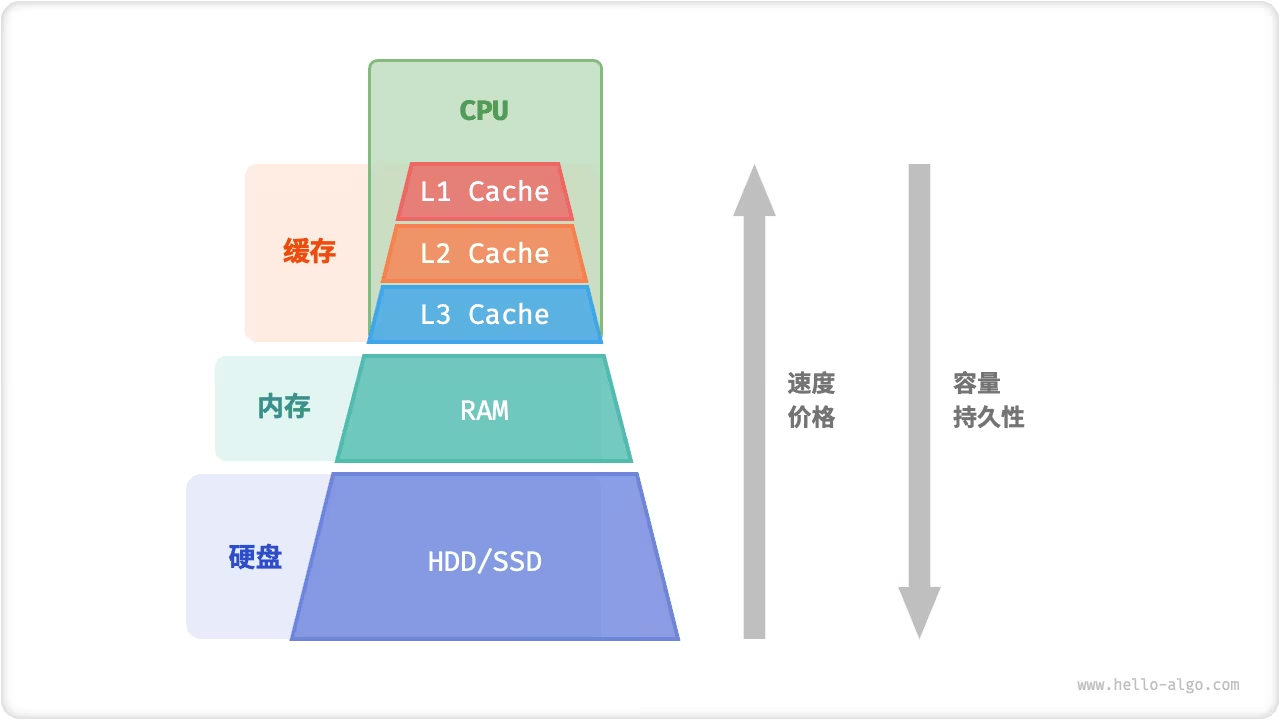
计算机的存储层次结构体现了速度、容量和成本三者之间的精妙平衡。实际上,这种权衡普遍存在于所有工业领域(所有工程问题),它要求我们在不同的优势和限制之间找到最佳平衡点。
总的来说,硬盘用于长期存储大量数据,内存用于临时存储程序运行中正在处理的数据,而缓存则用于存储经常访问的数据和指令,以提高程序运行效率。三者共同协作,确保计算机系统高效运行。
如下图所示,在程序运行时,数据会从硬盘中被读取到内存中,供 CPU 计算使用。缓存可以看作 CPU 的一部分,它通过智能地从内存加载数据,给 CPU 提供高速的数据读取,从而显著提升程序的执行效率,减少对较慢的内存的依赖。

在内存空间利用方面,数组和链表各自具有优势和局限性。
一方面,内存是有限的,且同一块内存不能被多个程序共享,因此我们希望数据结构能够尽可能高效地利用空间。数组的元素紧密排列,不需要额外的空间来存储链表节点间的引用(指针),因此空间效率更高。然而,数组需要一次性分配足够的连续内存空间,这可能导致内存浪费,数组扩容也需要额外的时间和空间成本。相比之下,链表以“节点”为单位进行动态内存分配和回收,提供了更大的灵活性。
另一方面,在程序运行时,随着反复申请与释放内存,空闲内存的碎片化程度会越来越高,从而导致内存的利用效率降低。数组由于其连续的存储方式,相对不容易导致内存碎片化。相反,链表的元素是分散存储的,在频繁的插入与删除操作中,更容易导致内存碎片化。
所以说在物理上,内存中通常是使用数组的形式存储的。如果是动态内存等的话就是链表了(链表中也可以包含数组呀,当然,反过来也是可以的(哈希表))
缓存虽然在空间容量上远小于内存,但它比内存快得多,在程序执行速度上起着至关重要的作用。由于缓存的容量有限,只能存储一小部分频繁访问的数据,因此当 CPU 尝试访问的数据不在缓存中时,就会发生「缓存未命中 cache miss」,此时 CPU 不得不从速度较慢的内存中加载所需数据。
显然,“缓存未命中”越少,CPU 读写数据的效率就越高,程序性能也就越好。我们将 CPU 从缓存中成功获取数据的比例称为「缓存命中率 cache hit rate」,这个指标通常用来衡量缓存效率。
为了尽可能达到更高的效率,缓存会采取以下数据加载机制。
缓存行:缓存不是单个字节地存储与加载数据,而是以缓存行为单位。相比于单个字节的传输,缓存行的传输形式更加高效。
预取机制:处理器会尝试预测数据访问模式(例如顺序访问、固定步长跳跃访问等),并根据特定模式将数据加载至缓存之中,从而提升命中率。
空间局部性:如果一个数据被访问,那么它附近的数据可能近期也会被访问。因此,缓存在加载某一数据时,也会加载其附近的数据,以提高命中率。
时间局部性:如果一个数据被访问,那么它在不久的将来很可能再次被访问。缓存利用这一原理,通过保留最近访问过的数据来提高命中率。
实际上,数组和链表对缓存的利用效率是不同的,主要体现在以下几个方面。
占用空间:链表元素比数组元素占用空间更多,导致缓存中容纳的有效数据量更少。
缓存行:链表数据分散在内存各处,而缓存是“按行加载”的,因此加载到无效数据的比例更高。
预取机制:数组比链表的数据访问模式更具“可预测性”,即系统更容易猜出即将被加载的数据。
空间局部性:数组被存储在集中的内存空间中,因此被加载数据附近的数据更有可能即将被访问。
总体而言,数组具有更高的缓存命中率,因此它在操作效率上通常优于链表。这使得在解决算法问题时,基于数组实现的数据结构往往更受欢迎。
需要注意的是,高缓存效率并不意味着数组在所有情况下都优于链表。实际应用中选择哪种数据结构,应根据具体需求来决定。例如,数组和链表都可以实现“栈”数据结构,但它们适用于不同场景。
在做算法题时,我们会倾向于选择基于数组实现的栈,因为它提供了更高的操作效率和随机访问的能力,代价仅是需要预先为数组分配一定的内存空间。
如果数据量非常大、动态性很高、栈的预期大小难以估计,那么基于链表实现的栈更加合适。链表能够将大量数据分散存储于内存的不同部分,并且避免了数组扩容产生的额外开销。
数组存储在栈上和存储在堆上,对时间效率和空间效率是否有影响?
存储在栈上和堆上的数组都被存储在连续内存空间内,数据操作效率是基本一致的。然而,栈和堆具有各自的特点,从而导致以下不同点。
C++ STL 里面的 std::list 已经实现了双向链表,但好像一些算法的书上都不怎么直接用这个,是不是有什么局限性呢?
一方面,我们往往更青睐使用数组实现算法,而只有在必要时才使用链表,主要有两个原因。
空间开销:由于每个元素需要两个额外的指针(一个用于前一个元素,一个用于后一个元素),所以 std::list 通常比 std::vector 更占用空间。
缓存不友好:由于数据不是连续存放的,std::list 对缓存的利用率较低。一般情况下,std::vector 的性能会更好。
另一方面,必要使用链表的情况主要是二叉树和图。栈和队列往往会使用编程语言提供的 stack 和 queue ,而非链表。
在 Python 中初始化 n = [1, 2, 3] 后,这 3 个元素的地址是相连的,但是初始化 m = [2, 1, 3] 会发现它们每个元素的 id 并不是连续的,而是分别跟 n 中的相同。这些元素地址不连续,那么 m 还是数组吗?
假如把列表元素换成链表节点 n = [n1, n2, n3, n4, n5] ,通常情况下这五个节点对象也是被分散存储在内存各处的。然而,给定一个列表索引,我们仍然可以在 �(1) 时间内获取到节点内存地址,从而访问到对应的节点。这是因为数组中存储的是节点的引用,而非节点本身。
与许多语言不同的是,在 Python 中数字也被包装为对象,列表中存储的不是数字本身,而是对数字的引用。因此,我们会发现两个数组中的相同数字拥有同一个 id ,并且这些数字的内存地址是无须连续的。
在删除节点中,需要断开该节点与其后继节点之间的引用指向吗?
从数据结构与算法(做题)的角度看,不断开没有关系,只要保证程序的逻辑是正确的就行。从标准库的角度看,断开更加安全、逻辑更加清晰。如果不断开,假设被删除节点未被正常回收,那么它也会影响后继节点的内存回收。
栈如同叠猫猫,而队列就像猫猫排队
两者分别代表着先入后出和先入先出的逻辑关系
「栈 stack」是一种遵循先入后出的逻辑的线性数据结构
如下图,是一些栈的规则、名词

如下所示,具体的名称还要根据所使用的编程语言决定
| 方法 | 描述 | 时间复杂度 |
|---|---|---|
| push() | 元素入栈(添加至栈顶) | |
| pop() | 栈顶元素出栈 | |
| peek() | 访问栈顶元素 |
如果编程语言内置了栈,则可以直接使用,但如果没有(如Python),则可以将数组或链表当作栈来使用,并再程序逻辑上忽略与栈无关的操作
/* 初始化栈 */stack<int> stack; /* 元素入栈 */stack.push(1);stack.push(3);stack.push(2);stack.push(5);stack.push(4); /* 访问栈顶元素 */int top = stack.top(); /* 元素出栈 */stack.pop(); // 无返回值 /* 获取栈的长度 */int size = stack.size(); /* 判断是否为空 */bool empty = stack.empty();自己实现一个栈类
因为栈先入后出的原则,我们可以将栈视为一个受限制的数组或链表
将头节点视为栈顶,尾节点视为栈底
因此入栈只需要在链表头部插入元素,这种方法叫 “头插法” ,所以要进行出栈操作时,只需要将头节点从链表中删除即可

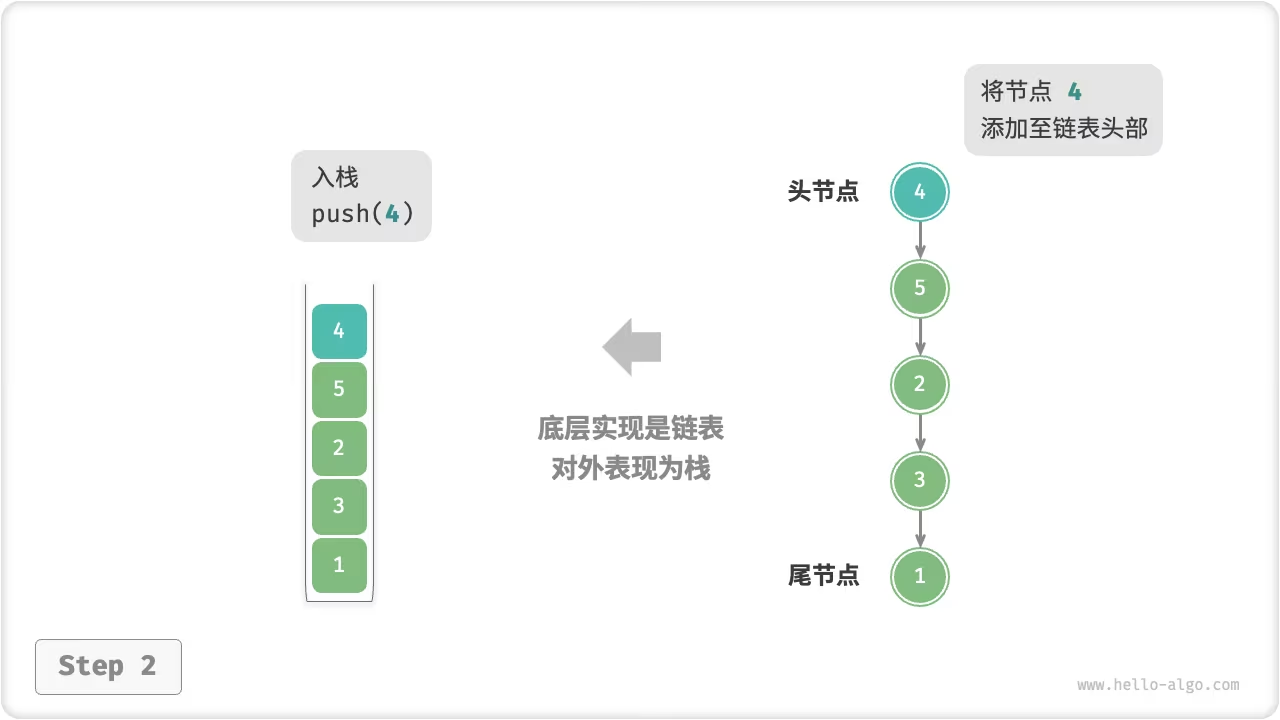
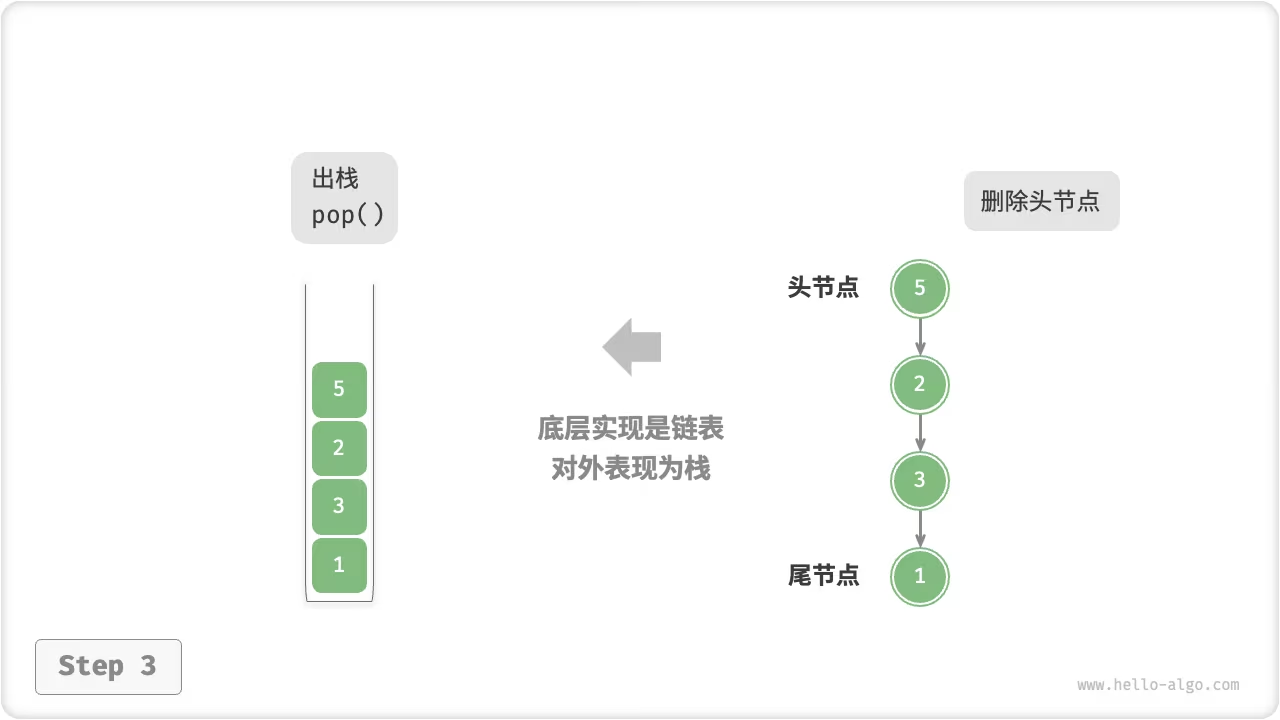
/* 基于链表实现的栈 */class LinkedListStack { private: ListNode *stackTop; // 将头节点作为栈顶 int stkSize; // 栈的长度 public: LinkedListStack() { stackTop = nullptr; stkSize = 0; } ~LinkedListStack() { // 遍历链表删除节点,释放内存 freeMemoryLinkedList(stackTop); } /* 获取栈的长度 */ int size() { return stkSize; } /* 判断栈是否为空 */ bool isEmpty() { return size() == 0; } /* 入栈 */ void push(int num) { ListNode *node = new ListNode(num); node->next = stackTop; stackTop = node; stkSize++; } /* 出栈 */ void pop() { int num = top(); ListNode *tmp = stackTop; stackTop = stackTop->next; // 释放内存 delete tmp; stkSize--; } /* 访问栈顶元素 */ int top() { if (isEmpty()) throw out_of_range("栈为空"); return stackTop->val; } /* 将 List 转化为 Array 并返回 */ vector<int> toVector() { ListNode *node = stackTop; vector<int> res(size()); for (int i = res.size() - 1; i >= 0; i--) { res[i] = node->val; node = node->next; } return res; }};使用数组实现栈时,将数组的尾部作为栈顶,因此入栈和出栈的操作时间复杂度都为
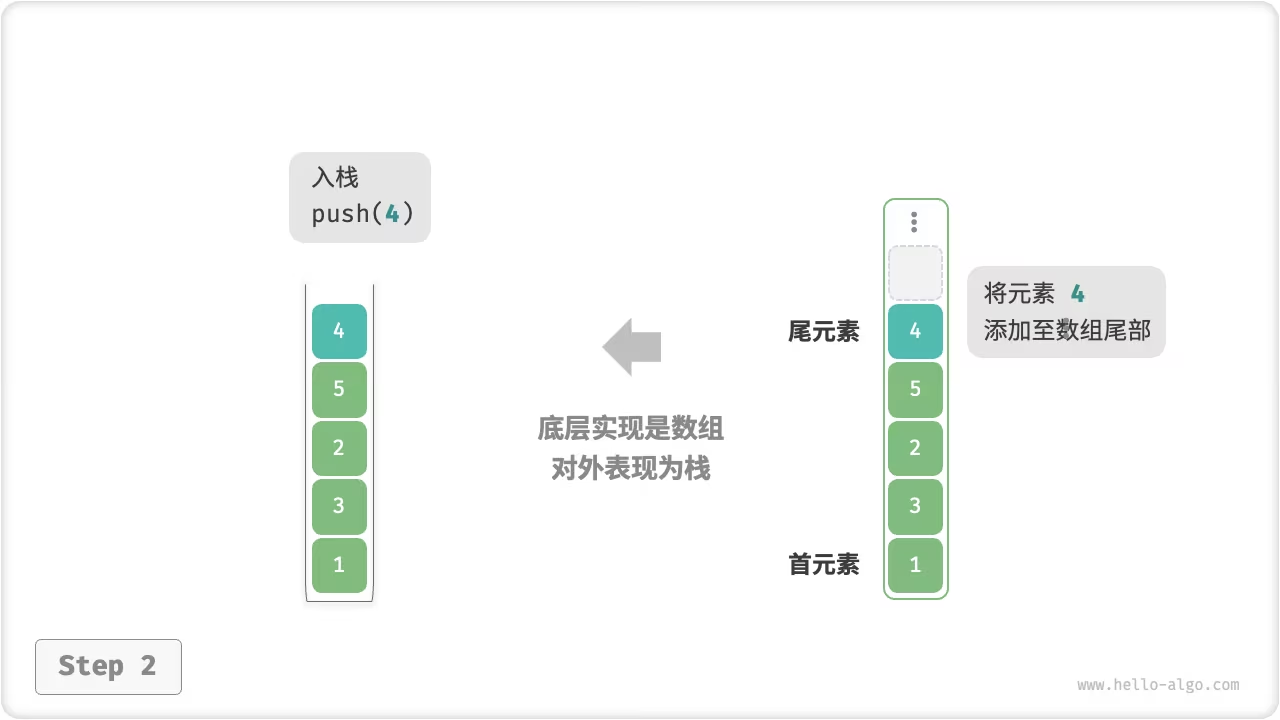
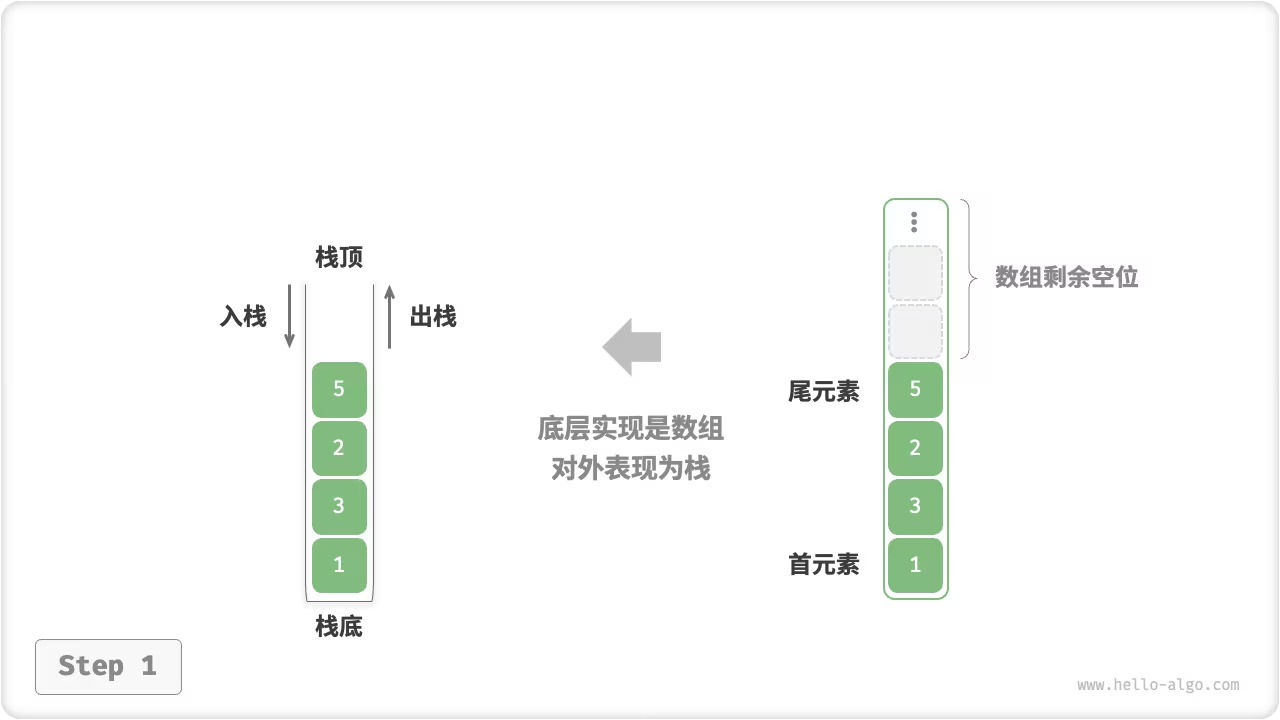
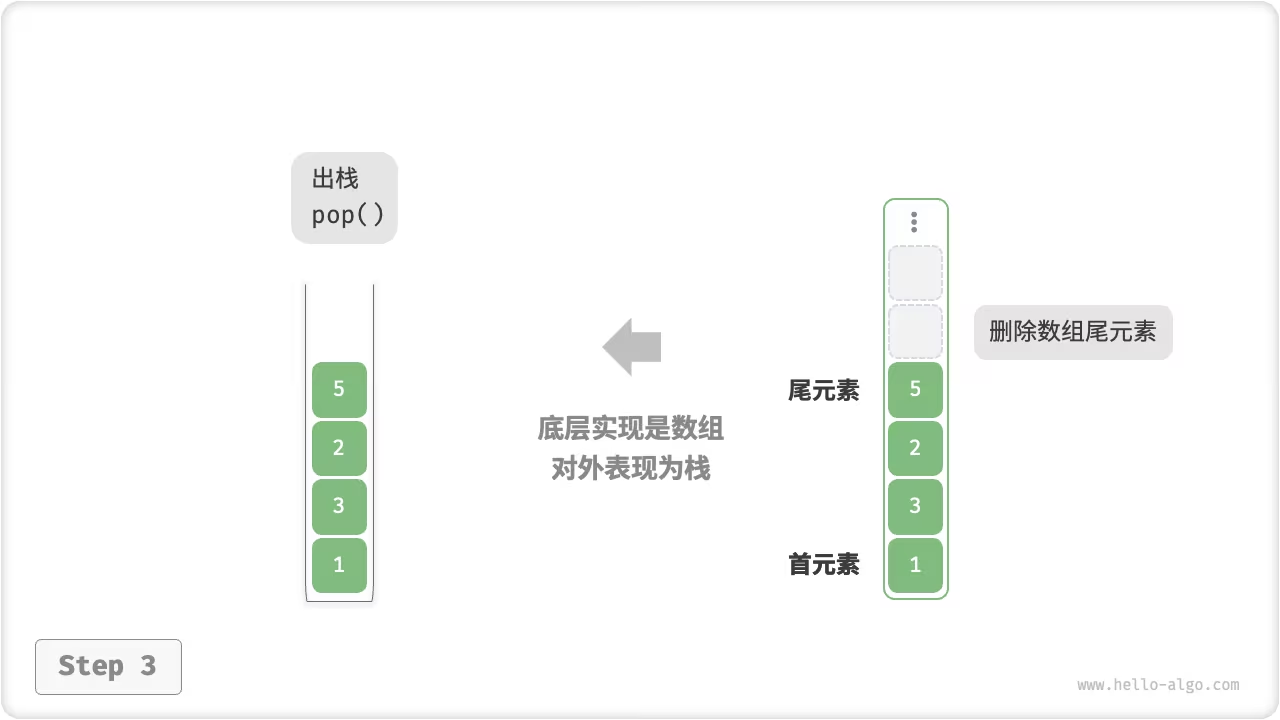
当然,使用动态数组就无需自行处理数组扩容问题了
/* 基于数组实现的栈 */class ArrayStack { private: vector<int> stack; public: /* 获取栈的长度 */ int size() { return stack.size(); } /* 判断栈是否为空 */ bool isEmpty() { return stack.size() == 0; } /* 入栈 */ void push(int num) { stack.push_back(num); } /* 出栈 */ void pop() { int oldTop = top(); stack.pop_back(); } /* 访问栈顶元素 */ int top() { if (isEmpty()) throw out_of_range("栈为空"); return stack.back(); } /* 返回 Vector */ vector<int> toVector() { return stack; }};时间效率
如果在数组预先分配好的内存中进行,则效率较高 ,对于大多数操作(入栈、出栈、查看栈顶元素),时间复杂度为 。但如果要扩容后再入栈的话,那么入栈操作的时间复杂度可能会达到====,其中 n 是数组的大小。(但扩容操作较低频)
链表的话就非常灵活了,但入栈时初始化节点修改指针会导致效率相对上面数组的较低,对于大多数操作,时间复杂度为 ,包括入栈、出栈、查看栈顶元素。 (虽然操作是 O(1),但 O(1)不一定效率大于 O(n))
因此:数组的平均效果更高,链表更稳定
空间效率
基于数组实现可能在扩容或初始容量是造成一些空间的浪费,空间复杂度为====,其中 n 是栈的最大容量。
但链表需要额外的空间存储指针,占用的空间相对较大,空间复杂度为====,其中 n 是栈中元素的数量。(2n 的 2 被约掉了)
因此:空间效率要根据具体情况进行分析
总的来说,它们没有优劣之分,复杂度都差不多,主要还是看具体的需求和操作场景
**浏览器的后退与前进、软件中的撤销与反撤销。**若要同时支持撤销与反撤销,则要两个栈来配合实现
撤销(undo)和反撤销(redo)具体是如何实现的?
使用两个堆栈,栈
A用于撤销,栈B用于反撤销。
- 每当用户执行一个操作,将这个操作压入栈
A,并清空栈B- 当用户执行“撤销”时,从栈
A中弹出最近的操作,并将其压入栈B- 当用户执行“反撤销”时,从栈
B中弹出最近的操作,并将其压入栈 A
**程序的内存管理。**通过调用函数时,系统都会在栈顶添加一个栈帧,用于记录函数的上下文信息,比如用于递归的向下递推与向上回溯
「队列 queue」是一种遵循先入先出规则的线性数据结构。顾名思义,队列就是模拟排队现象,先来的先走,后来的在后面排队
常见操作如下:
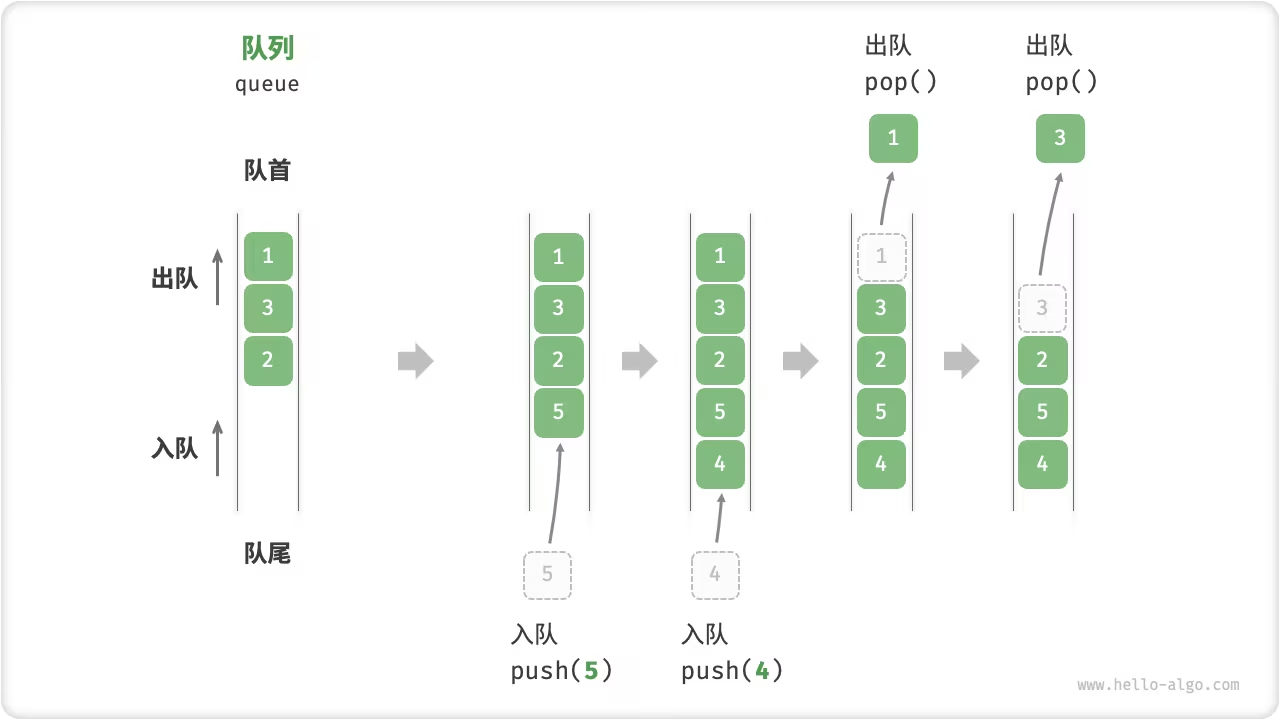
如下图,但不同编程语言可能不同或没有
| 方法名 | 描述 | 时间复杂度 |
|---|---|---|
| push() | 元素入队,即将元素添加至队尾 | |
| pop() | 队首元素出队 | |
| peek() | 访问队首元素 |
当然,我们可以直接使用编程语言中现成的队列类
# 在 Python 中,我们一般将双向队列类 deque 看作队列使用# 虽然 queue.Queue() 是纯正的队列类,但不太好用,因此不建议/* 初始化队列 */queue<int> queue; /* 元素入队 */queue.push(1);queue.push(3);queue.push(2);queue.push(5);queue.push(4); /* 访问队首元素 */int front = queue.front(); /* 元素出队 */queue.pop(); /* 获取队列的长度 */int size = queue.size(); /* 判断队列是否为空 */bool empty = queue.empty();“头节点” 视为 “队首”,“尾节点” 视为 “队尾”

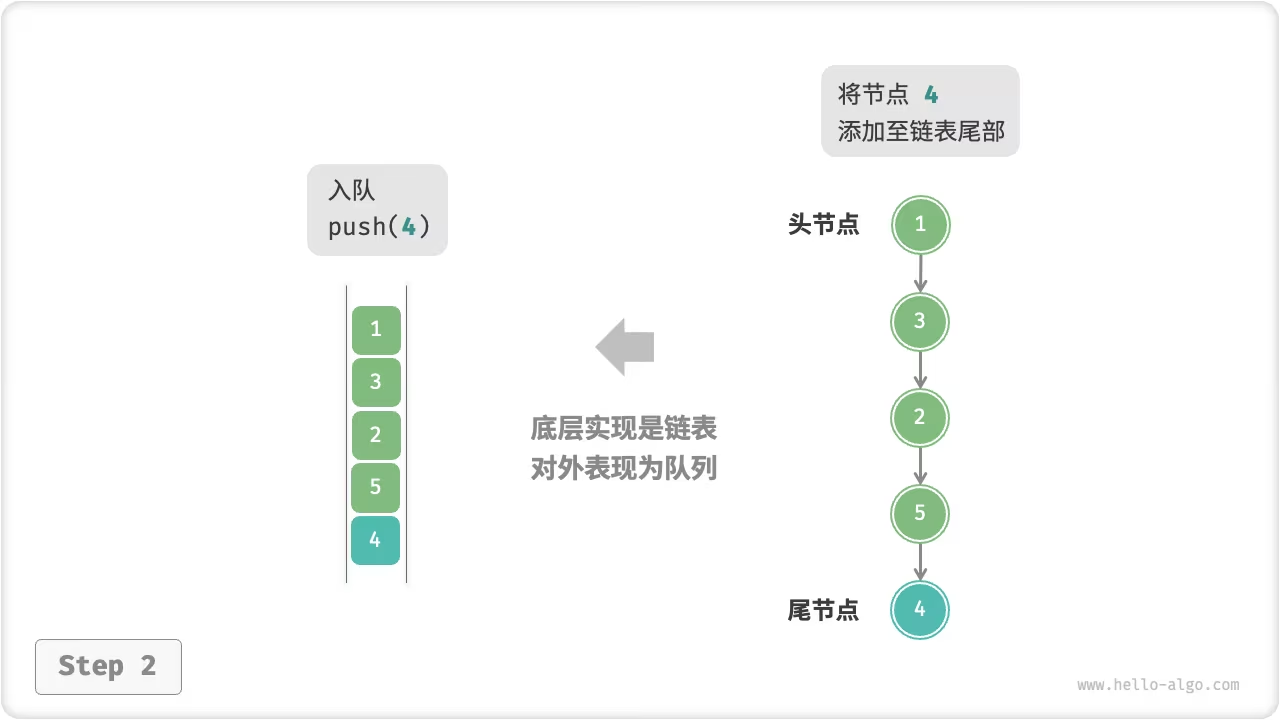
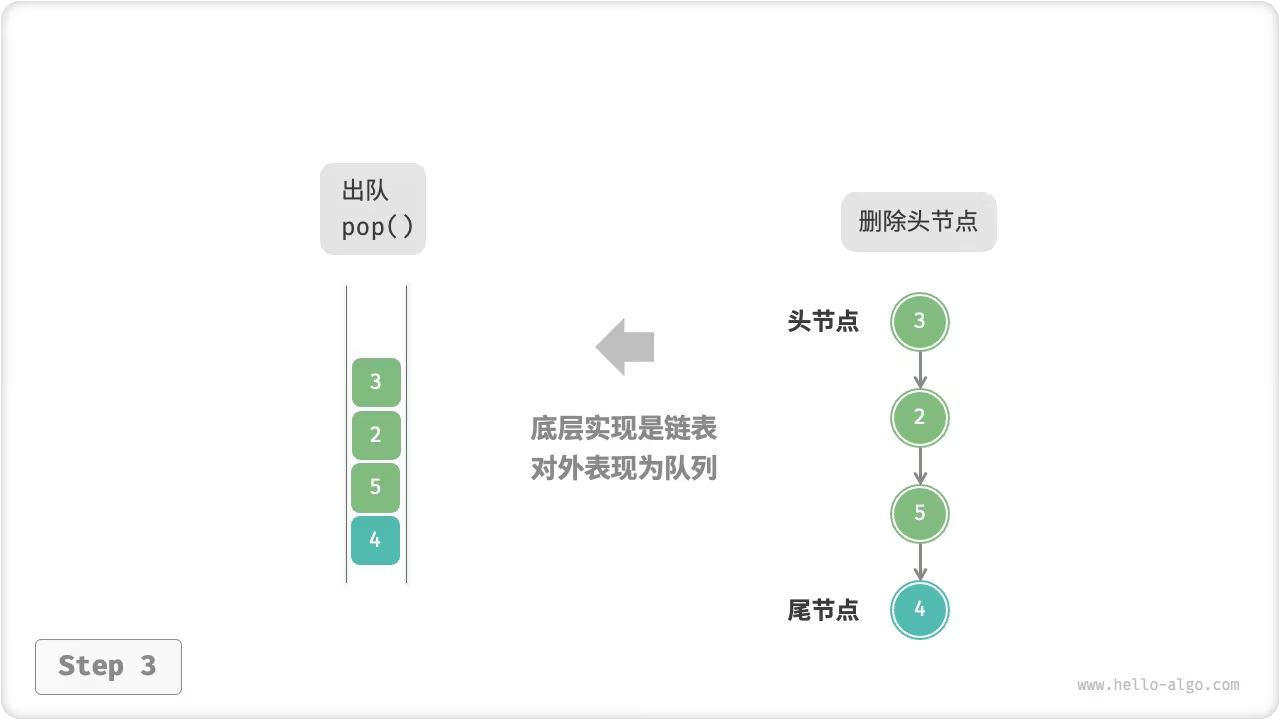
以下是用链表实现队列的代码
/* 基于链表实现的队列 */class LinkedListQueue { private: ListNode *front, *rear; // 头节点 front ,尾节点 rear int queSize; public: LinkedListQueue() { front = nullptr; rear = nullptr; queSize = 0; } ~LinkedListQueue() { // 遍历链表删除节点,释放内存 freeMemoryLinkedList(front); } /* 获取队列的长度 */ int size() { return queSize; } /* 判断队列是否为空 */ bool isEmpty() { return queSize == 0; } /* 入队 */ void push(int num) { // 尾节点后添加 num ListNode *node = new ListNode(num); // 如果队列为空,则令头、尾节点都指向该节点 if (front == nullptr) { front = node; rear = node; } // 如果队列不为空,则将该节点添加到尾节点后 else { rear->next = node; rear = node; } queSize++; } /* 出队 */ void pop() { int num = peek(); // 删除头节点 ListNode *tmp = front; front = front->next; // 释放内存 delete tmp; queSize--; } /* 访问队首元素 */ int peek() { if (size() == 0) throw out_of_range("队列为空"); return front->val; } /* 将链表转化为 Vector 并返回 */ vector<int> toVector() { ListNode *node = front; vector<int> res(size()); for (int i = 0; i < res.size(); i++) { res[i] = node->val; node = node->next; } return res; }};我们可以使用双指针来将数组实现的队列的时间复杂度从 变到
可以使用一个变量 front 指向队首元素的索引,并维护一个变量 size 用于记录队列长度。定义 rear = front + size ,这个公式计算出的 rear 指向队尾元素之后的下一个位置。
基于此设计,数组中包含元素的有效区间为 [front, rear - 1]
入队操作:将输入元素赋值给 rear 索引处,并将 size 增加 1 。
出队操作:只需将 front 增加 1 ,并将 size 减少 1 。
可以看到,入队和出队操作都只需进行一次操作,时间复杂度均为 。
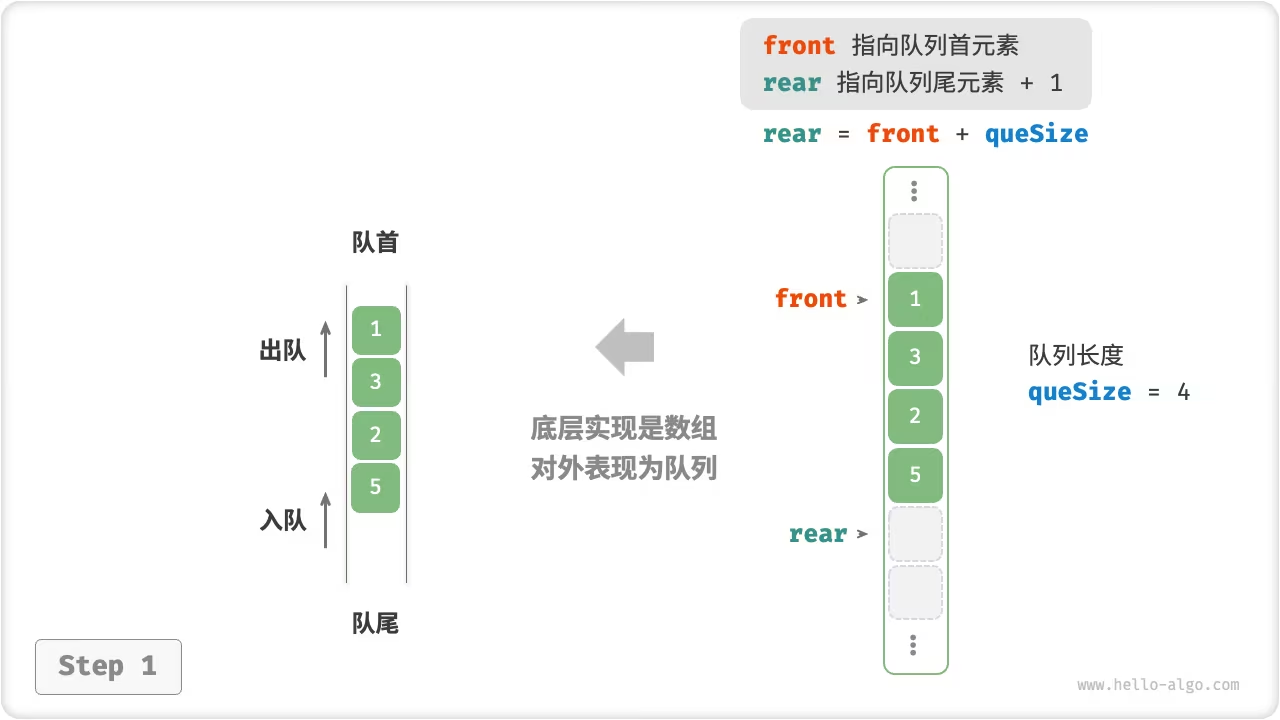
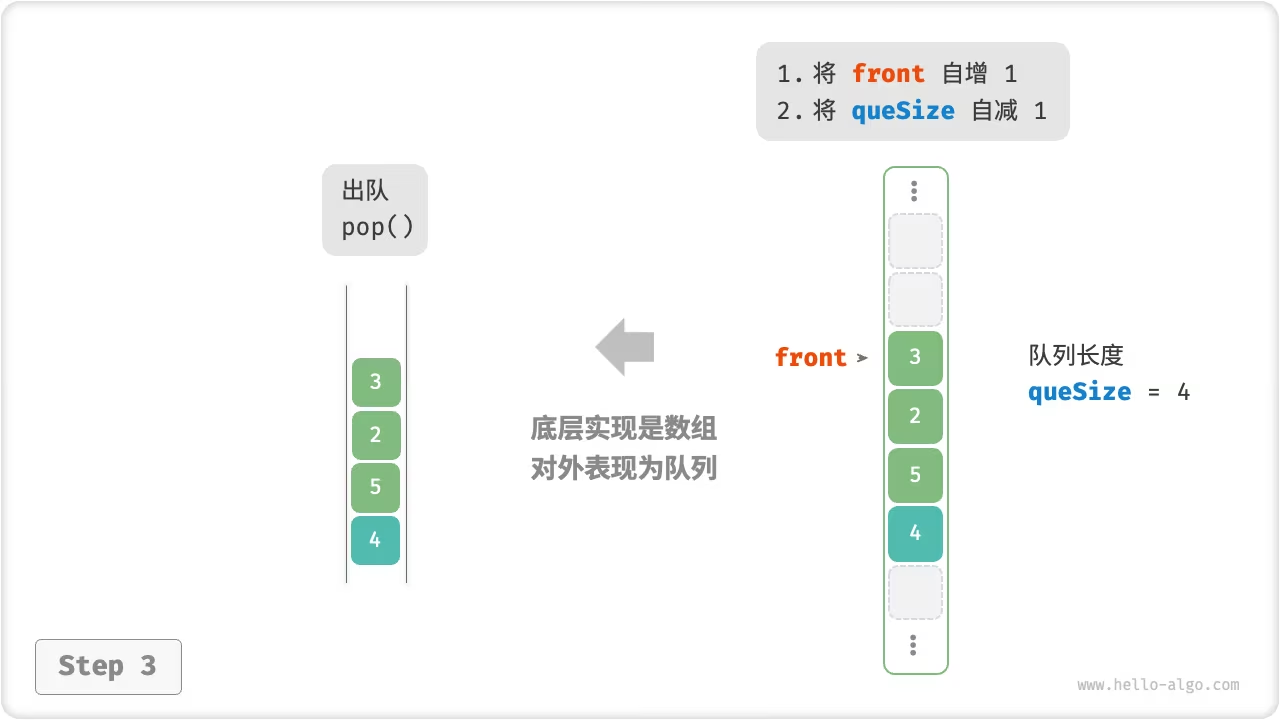
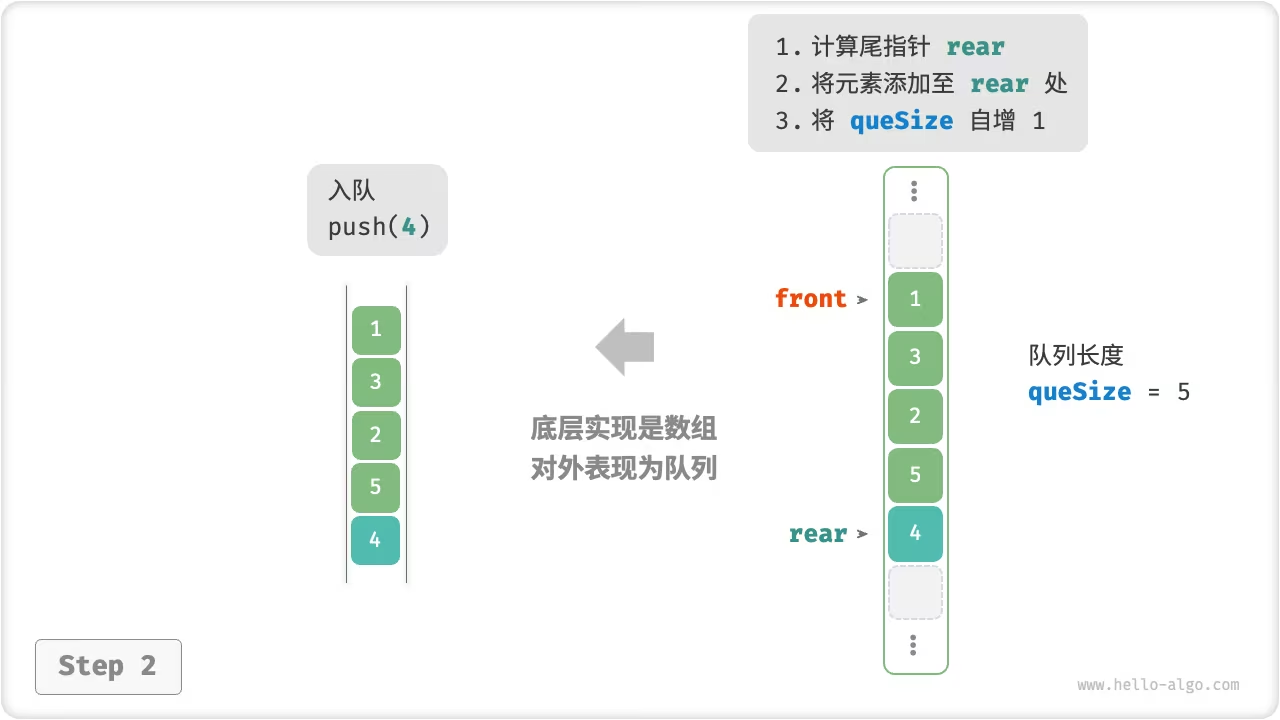
但也有问题,在不断进行入队和出队的过程中,front 和 rear 都在向右移动,当它们到达数组尾部时就无法继续移动了。为解决此问题,我们可以将数组视为首尾相接的“环形数组”。
对于环形数组,我们需要让 front 或 rear 在越过数组尾部时,直接回到数组头部继续遍历。这种周期性规律可以通过“取余操作”来实现,代码如下所示。
/* 基于环形数组实现的队列 */class ArrayQueue { private: int *nums; // 用于存储队列元素的数组 int front; // 队首指针,指向队首元素 int queSize; // 队列长度 int queCapacity; // 队列容量 public: ArrayQueue(int capacity) { // 初始化数组 nums = new int[capacity]; queCapacity = capacity; front = queSize = 0; } ~ArrayQueue() { delete[] nums; } /* 获取队列的容量 */ int capacity() { return queCapacity; } /* 获取队列的长度 */ int size() { return queSize; } /* 判断队列是否为空 */ bool isEmpty() { return size() == 0; } /* 入队 */ void push(int num) { if (queSize == queCapacity) { cout << "队列已满" << endl; return; } // 计算队尾指针,指向队尾索引 + 1 // 通过取余操作,实现 rear 越过数组尾部后回到头部 int rear = (front + queSize) % queCapacity; // 将 num 添加至队尾 nums[rear] = num; queSize++; } /* 出队 */ void pop() { int num = peek(); // 队首指针向后移动一位,若越过尾部则返回到数组头部 front = (front + 1) % queCapacity; queSize--; } /* 访问队首元素 */ int peek() { if (isEmpty()) throw out_of_range("队列为空"); return nums[front]; } /* 将数组转化为 Vector 并返回 */ vector<int> toVector() { // 仅转换有效长度范围内的列表元素 vector<int> arr(queSize); for (int i = 0, j = front; i < queSize; i++, j++) { arr[i] = nums[j % queCapacity]; } return arr; }};以上方法也有局限性,即长度不可变,当然了,换成动态数据就可以扩容了,但记得要改取余等的值
两种实现的对比:和上面栈的结论一样
**淘宝订单:**系统会依照顺序依次处理加入队列中的订单
各类待办事项:就是任何需要实现 “先来后到” 的场景,如排队挂号呀、打印顺序呀等等
就是头部和尾部都可以入队和出队的操作

| 方法名 | 描述 | 时间复杂度 |
|---|---|---|
| push_front() | 将元素添加至队首 | |
| push_back() | 将元素添加至队尾 | |
| pop_front() | 删除队首元素 | |
| pop_back() | 删除队尾元素 | |
| front() | 访问队首元素 | |
| back() | 访问队尾元素 |
/* 初始化双向队列 */deque<int> deque; /* 元素入队 */deque.push_back(2); // 添加至队尾deque.push_back(5);deque.push_back(4);deque.push_front(3); // 添加至队首deque.push_front(1); /* 访问元素 */int front = deque.front(); // 队首元素int back = deque.back(); // 队尾元素 /* 元素出队 */deque.pop_front(); // 队首元素出队deque.pop_back(); // 队尾元素出队 /* 获取双向队列的长度 */int size = deque.size(); /* 判断双向队列是否为空 */bool empty = deque.empty(); 同上,与实现队列类似,自己去 hello-algo 去看就行了
这就更简单了,只需增加队首入队和队尾出队的方法就行了
双向队列兼具栈和队列的逻辑,因此它可以实现这两者所有的应用场景,同时提高更高的自由度
我们知道,软件的“撤销”功能通常使用栈来实现:系统将每次更改操作 push 到栈中,然后通过 pop 实现撤销。然而,考虑到系统资源的限制,软件通常会限制撤销的步数(例如仅允许保存 50 步)。当栈的长度超过 50 时,软件需要在栈底(即队首)执行删除操作。但栈无法实现该功能,此时就需要使用双向队列来替代栈。请注意,“撤销”的核心逻辑仍然遵循栈的先入后出原则,只是双向队列能够更加灵活地实现一些额外逻辑。
「哈希表 hash table」,又称「散列表」通过建立键 key 与值 value 之间的映射,实现高效的元素查询
具体来说,我们向哈希表输入一个键 key ,则可以在 的时间内获取对应的值 value
如下图通过学号查询学生就可以用哈希表来实现

将哈希表与数组还有链表相比,可以得到下表
**添加元素:**只需将元素添加到数组(链表)尾部即可,使用 时间
**查询元素:**因为它两是乱序的,因此需要遍历其中所有的元素,使用 时间
**删除元素:**同理,要先查询,在删除,使用 时间
| 数组 | 链表 | 哈希表 | |
|---|---|---|---|
| 查找元素 | |||
| 添加元素 | |||
| 删除元素 |
哈希表通过大量空间,降低空间效率来提高时间效率
/* 初始化哈希表 */unordered_map<int, string> map; /* 添加操作 */// 在哈希表中添加键值对 (key, value)map[12836] = "小哈";map[15937] = "小啰";map[16750] = "小算";map[13276] = "小法";map[10583] = "小鸭"; /* 查询操作 */// 向哈希表输入键 key ,得到值 valuestring name = map[15937]; /* 删除操作 */// 在哈希表中删除键值对 (key, value)map.erase(10583);遍历键值对
/* 遍历哈希表 */// 遍历键值对 key->valuefor(auto kv: map){ cout<<kv.first<<"->"<<kv.second<<endl;}// 使用迭代器(指针)遍历 key->valuefor(auto iter = map.begin(); iter != map.end(); iter++){ cout<<iter->first<<"->"<<iter->second<<endl;}遍历键或值(和上面差不多同理)
C++的话是同时遍历的,只是看要获取什么
Python 是可以使用 “引用” 迭代器来遍历 键值对 或单独遍历
/* 遍历哈希表 */// 遍历键值对 key->valuefor (auto kv: map){ cout << kv.first << " -> " << kv.second << endl;}// 使用迭代器遍历 key->valuefor (auto iter = map.begin(); iter != map.end(); iter++){ cout << iter->first << "->" << iter->second << endl;}比如如下,只用一个数组(结构体)实现了哈希表(最简单的情况,不考虑多对值),其中数组中的每个空位称为「桶 bucket」,每个桶中可存储一个键值对,因此查询操作就是找到 key 对应的桶,然后在桶中获取 value
叫“桶”是因为在不简单的哈希表之中,一个桶中可以装很多个小球“元素”
哈希表通过「哈希函数 hash function」将一个较大的输入空间映射到一个较小的空间,然后再对桶的数量(数组长度)取模,从而得到该数组的索引,我们可以通过哈希函数得到该 key 对应的键值对在数组中的存储位置。
比如一个 string:string,第一个 key 通过 ascii 表等通过哈希函数转换成数字(这只是最简单的一种算法,其实哈希算法是很复杂的),然后通过取模(多为大的质数),获取数组的索引,最后通过索引获取值
输入一个
key,哈希函数的计算过程分为以下两步。
- 通过某种哈希算法
hash()计算得到哈希值。- 将哈希值对桶数量(数组长度)
capacity取模,从而获取该key对应的数组索引index。C++index = hash(key) % capacity随后,我们就可以利用
index在哈希表中访问对应的桶,从而获取value。设数组长度
capacity = 100、哈希算法hash(key) = key,易得哈希函数为key % 100。图 6-2 以key学号和value姓名为例,展示了哈希函数的工作原理。

以下代码实现了一个简单哈希表。其中,我们将 key 和 value 封装成一个类 Pair ,以表示键值对。
/* 键值对 */struct Pair { public: int key; string val; Pair(int key, string val) { this->key = key; this->val = val; }}; /* 基于数组简易实现的哈希表 */class ArrayHashMap { private: vector<Pair *> buckets; public: ArrayHashMap() { // 初始化数组,包含 100 个桶 buckets = vector<Pair *>(100); } ~ArrayHashMap() { // 释放内存 for (const auto &bucket : buckets) { delete bucket; } buckets.clear(); } /* 哈希函数 */ int hashFunc(int key) { int index = key % 100; return index; } /* 查询操作 */ string get(int key) { int index = hashFunc(key); Pair *pair = buckets[index]; if (pair == nullptr) return ""; return pair->val; } /* 添加操作 */ void put(int key, string val) { Pair *pair = new Pair(key, val); int index = hashFunc(key); buckets[index] = pair; } /* 删除操作 */ void remove(int key) { int index = hashFunc(key); // 释放内存并置为 nullptr delete buckets[index]; buckets[index] = nullptr; } /* 获取所有键值对 */ vector<Pair *> pairSet() { vector<Pair *> pairSet; for (Pair *pair : buckets) { if (pair != nullptr) { pairSet.push_back(pair); } } return pairSet; } /* 获取所有键 */ vector<int> keySet() { vector<int> keySet; for (Pair *pair : buckets) { if (pair != nullptr) { keySet.push_back(pair->key); } } return keySet; } /* 获取所有值 */ vector<string> valueSet() { vector<string> valueSet; for (Pair *pair : buckets) { if (pair != nullptr) { valueSet.push_back(pair->val); } } return valueSet; } /* 打印哈希表 */ void print() { for (Pair *kv : pairSet()) { cout << kv->key << " -> " << kv->val << endl; } }};因为通过取余可能出现余数相同的情况,然后会导致映射相同的情况,
因此理论上一定会存在 “多个输入对应相同输出” 的情况,即「哈希冲突 hash collision」

因此,可以通过扩容哈希表(增大取余的数)来减少哈希冲突

当然,因为扩容会导致原有的哈希表迁移到新的哈希表,本来就非常耗时,再加上哈希表鹅容量 capacity 的改变,会导致所有的储存位置都要重新计算,因此编程语言通常会预留足够大的哈希表容量(足够大的质数),防止频繁扩容
其中一个重要概念是「负载因子 load factor」,其定义为 ,用于衡量哈希冲突的严重程度,因此也常被作为哈希表扩容的触发条件
Java 中当超过 时,会扩容到原来的 倍
因为**通常情况下哈希函数的输入空间远大于输出空间,**因此理论上哈希冲突是不可避免的
因此我们需要改良哈希表,不能一遇到哈希冲突就扩容
改良哈希表的数据结构,使得哈希表可以在存在哈希冲突时正常工作
并且仅在有必要时,即哈希冲突很严重时,才执行扩容操作
因为之前每个桶只能存储一个键值对,但「链式地址 separate chaining」通过将单个元素(每个索引)转换成一个链表,将键值对转换成链表节点,取余相同的数都存储在同一链表中

因此,通过以上的改变后,一些操作方法也发生了变化:
**查询元素:**先指向桶的索引,然后遍历桶中的链表去查找
**添加元素:**同上
**删除元素:**同上
但使用链表也有以下局限性:
**占用空间大,**因为包含指针
**查询效率低,**从原始数据查询到桶时效率高,线性遍历链表时效率低
若使用动态数组(列表)来实现链式地址的哈希表,可以简化代码
以下方式若负载因子超过 时,我们将哈希表扩容到 倍
/* 链式地址哈希表 */class HashMapChaining { private: int size; // 键值对数量 int capacity; // 哈希表容量 double loadThres; // 触发扩容的负载因子阈值 int extendRatio; // 扩容倍数 vector<vector<Pair *>> buckets; // 桶数组 public: /* 构造方法 */ HashMapChaining() : size(0), capacity(4), loadThres(2.0 / 3.0), extendRatio(2) { buckets.resize(capacity); } /* 析构方法 */ ~HashMapChaining() { for (auto &bucket : buckets) { for (Pair *pair : bucket) { // 释放内存 delete pair; } } } /* 哈希函数 */ int hashFunc(int key) { return key % capacity; } /* 负载因子 */ double loadFactor() { return (double)size / (double)capacity; } /* 查询操作 */ string get(int key) { int index = hashFunc(key); // 遍历桶,若找到 key 则返回对应 val for (Pair *pair : buckets[index]) { if (pair->key == key) { return pair->val; } } // 若未找到 key 则返回空字符串 return ""; } /* 添加操作 */ void put(int key, string val) { // 当负载因子超过阈值时,执行扩容 if (loadFactor() > loadThres) { extend(); } int index = hashFunc(key); // 遍历桶,若遇到指定 key ,则更新对应 val 并返回 for (Pair *pair : buckets[index]) { if (pair->key == key) { pair->val = val; return; } } // 若无该 key ,则将键值对添加至尾部 buckets[index].push_back(new Pair(key, val)); size++; } /* 删除操作 */ void remove(int key) { int index = hashFunc(key); auto &bucket = buckets[index]; // 遍历桶,从中删除键值对 for (int i = 0; i < bucket.size(); i++) { if (bucket[i]->key == key) { Pair *tmp = bucket[i]; bucket.erase(bucket.begin() + i); // 从中删除键值对 delete tmp; // 释放内存 size--; return; } } } /* 扩容哈希表 */ void extend() { // 暂存原哈希表 vector<vector<Pair *>> bucketsTmp = buckets; // 初始化扩容后的新哈希表 capacity *= extendRatio; buckets.clear(); buckets.resize(capacity); size = 0; // 将键值对从原哈希表搬运至新哈希表 for (auto &bucket : bucketsTmp) { for (Pair *pair : bucket) { put(pair->key, pair->val); // 释放内存 delete pair; } } } /* 打印哈希表 */ void print() { for (auto &bucket : buckets) { cout << "["; for (Pair *pair : bucket) { cout << pair->key << " -> " << pair->val << ", "; } cout << "]\n"; } }}; 因为当链表很长时,查询效率很差 ,因此我们可以将链表转换为 “AVL 树” 或 “红黑树” ,从而将时间复杂度优化到
「开放寻址 open addressing」是一种解决哈希冲突的方法,它与哈希表中的链地址法相对应。在开放寻址中,当发生哈希冲突时,算法会尝试寻找另一个空槽来存储冲突的元素,而不是通过链表等数据结构来存储冲突的元素。
这样做的好处是可以减少额外的内存分配,因为所有的元素都存储在哈希表中,没有额外的指针或链表节点。缺点也有,比如容易产生聚集(clustering)现象,即连续的哈希冲突会导致性能下降。
开放寻址不引入额外的数据结构,而是通过 “多次探测” 的方法来处理哈希冲突,其包括线性探测,平方探测(二次探测),多次哈希(双重散列)等。
下面以线性探测为主要例子:
通过采用固定步长的线性搜索来进行探测
**插入元素:**计算出索引后,则从冲突位置向后线性遍历(步长通常为 ),直到找到空桶,将元素插入其中
**查找元素:**通过上述方法来遍历去查找元素,如果遇到空桶也没查到,就说明目标元素不在哈希表中,返回空值

当然,这种方法也有弊端,如:
**线性探测容易产生 “聚焦现象”。**当数组中数据越多,越容易出现哈希冲突(原位置被占了,要一直向后移动),导致恶性循环,效率越来越低
**也不能在开放寻址哈希表中直接删除元素,**因为删除元素就会产生空桶,让在查找元素时默认不查找(查不到)空桶以后的,导致误判元素不存在
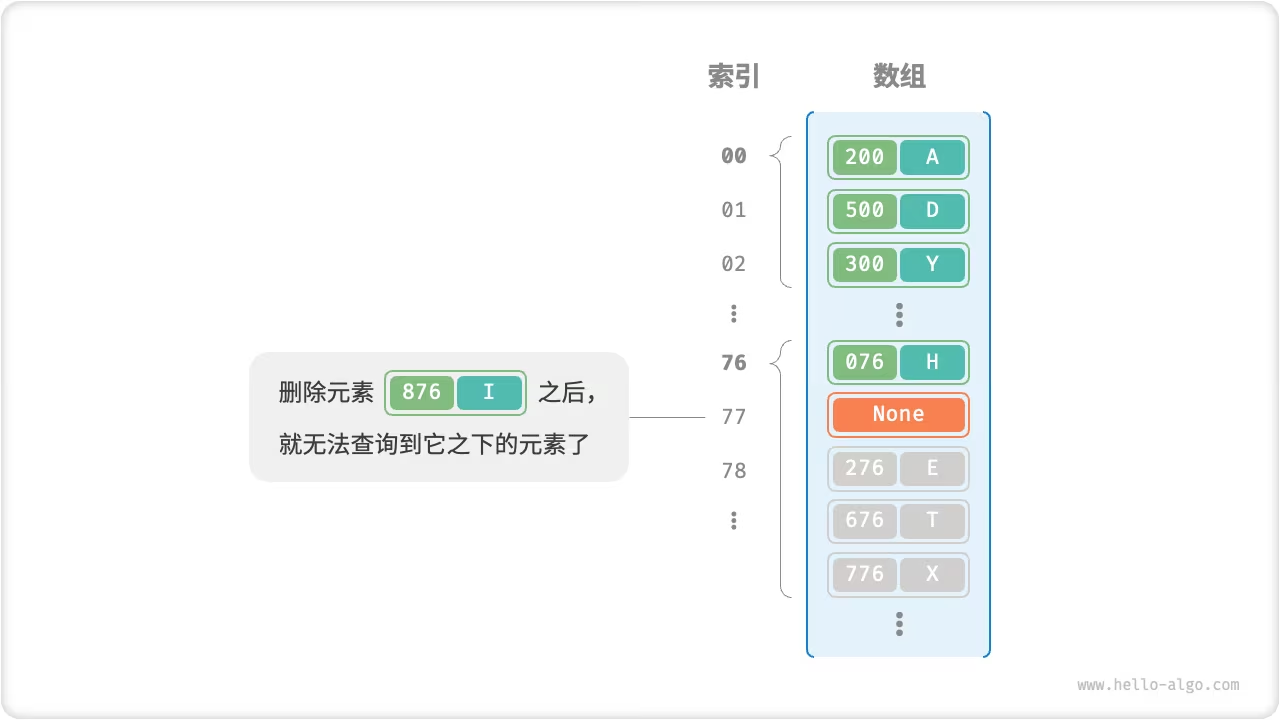
因此,为了解决不能删除元素的问题,常使用「**懒删除 lazy deletion」机制:就是用一个常量TOMBDTONE来标记这个桶,**同理,在“空”或这个常量下都可以放置键值对;遍历时检测到它时也会继续遍历。但其缺点就是可能会加速哈希表的性能退化,
可以通过以下方法来解决:在线性探测中记录遇到的首个 TOMBSTONE 的索引,并将搜索到的目标元素与该 TOMBSTONE 交换位置。这样做的好处是当每次查询或添加元素时,元素会被移动至距离理想位置(探测起始点)更近的桶,从而优化查询效率。
以下代码实现了一个包含懒删除的开放寻址(线性探测)的哈希表,当然了,使用”环形数组“来节省空间
/* 开放寻址哈希表 */class HashMapOpenAddressing { private: int size; // 键值对数量 int capacity = 4; // 哈希表容量 const double loadThres = 2.0 / 3.0; // 触发扩容的负载因子阈值 const int extendRatio = 2; // 扩容倍数 vector<Pair *> buckets; // 桶数组 Pair *TOMBSTONE = new Pair(-1, "-1"); // 删除标记 public: /* 构造方法 */ HashMapOpenAddressing() : size(0), buckets(capacity, nullptr) { } /* 析构方法 */ ~HashMapOpenAddressing() { for (Pair *pair : buckets) { if (pair != nullptr && pair != TOMBSTONE) { delete pair; } } delete TOMBSTONE; } /* 哈希函数 */ int hashFunc(int key) { return key % capacity; } /* 负载因子 */ double loadFactor() { return (double)size / capacity; } /* 搜索 key 对应的桶索引 */ int findBucket(int key) { int index = hashFunc(key); int firstTombstone = -1; // 线性探测,当遇到空桶时跳出 while (buckets[index] != nullptr) { // 若遇到 key ,返回对应桶索引 if (buckets[index]->key == key) { // 若之前遇到了删除标记,则将键值对移动至该索引 if (firstTombstone != -1) { buckets[firstTombstone] = buckets[index]; buckets[index] = TOMBSTONE; return firstTombstone; // 返回移动后的桶索引 } return index; // 返回桶索引 } // 记录遇到的首个删除标记 if (firstTombstone == -1 && buckets[index] == TOMBSTONE) { firstTombstone = index; } // 计算桶索引,越过尾部返回头部 index = (index + 1) % capacity; } // 若 key 不存在,则返回添加点的索引 return firstTombstone == -1 ? index : firstTombstone; } /* 查询操作 */ string get(int key) { // 搜索 key 对应的桶索引 int index = findBucket(key); // 若找到键值对,则返回对应 val if (buckets[index] != nullptr && buckets[index] != TOMBSTONE) { return buckets[index]->val; } // 若键值对不存在,则返回空字符串 return ""; } /* 添加操作 */ void put(int key, string val) { // 当负载因子超过阈值时,执行扩容 if (loadFactor() > loadThres) { extend(); } // 搜索 key 对应的桶索引 int index = findBucket(key); // 若找到键值对,则覆盖 val 并返回 if (buckets[index] != nullptr && buckets[index] != TOMBSTONE) { buckets[index]->val = val; return; } // 若键值对不存在,则添加该键值对 buckets[index] = new Pair(key, val); size++; } /* 删除操作 */ void remove(int key) { // 搜索 key 对应的桶索引 int index = findBucket(key); // 若找到键值对,则用删除标记覆盖它 if (buckets[index] != nullptr && buckets[index] != TOMBSTONE) { delete buckets[index]; buckets[index] = TOMBSTONE; size--; } } /* 扩容哈希表 */ void extend() { // 暂存原哈希表 vector<Pair *> bucketsTmp = buckets; // 初始化扩容后的新哈希表 capacity *= extendRatio; buckets = vector<Pair *>(capacity, nullptr); size = 0; // 将键值对从原哈希表搬运至新哈希表 for (Pair *pair : bucketsTmp) { if (pair != nullptr && pair != TOMBSTONE) { put(pair->key, pair->val); delete pair; } } } /* 打印哈希表 */ void print() { for (Pair *pair : buckets) { if (pair == nullptr) { cout << "nullptr" << endl; } else if (pair == TOMBSTONE) { cout << "TOMBSTONE" << endl; } else { cout << pair->key << " -> " << pair->val << endl; } } }};不是简单的跳过一个固定的不是,而是跳过 ”探测次数的平方“ 的步数,即 步
优点:
可以缓解聚集效应
会使数据分布的更加均匀
缺点:
还是会阴聚集现象
并且因为平方的增长,在平方探测中不会探测整个哈希表,因此即使有空桶,也可能不会访问到它们
使用多个哈希函数 来进行探测
插入元素:若第一个哈希函数出现冲突,则尝试第二个,以此类推,直到遇到空桶后插入元素(若到最后一个哈希函数都没有空桶,一般说明冲突比较严重了,比较简单的解法是:扩容哈希表,大力出奇迹。)
查找元素:与上面相同的方法,直到找到目标,或遇到空桶
各个编程语言采取了不同的哈希表实现策略,以下举几个例子。
Java 采用链式地址。自 JDK 1.8 以来,当 HashMap 内数组长度达到 64 且链表长度达到 8 时,链表会被转换为红黑树以提升查找性能。
Python 采用开放寻址。字典 dict 使用伪随机数进行探测。
Golang 采用链式地址。Go 规定每个桶最多存储 8 个键值对,超出容量则连接一个溢出桶。当溢出桶过多时,会执行一次特殊的等量扩容操作,以确保性能。
C++ 采用开放寻址法中的线性探测来处理冲突,不使用开放探测中其他的方法,过多时会扩容哈希表
开放寻址和链地址法只能保证哈希表可以在发生冲突时正常工作,但无法减少哈希冲突的发生
如下为哈希冲突最佳与最差的情况

因为键值对的分布是由哈希函数决定的,所有在容量capacity固定时,哈希算法hash()决定了其输出值,进而决定了分布情况,因此为了减少哈希冲突的发生概念,应该设计优秀的哈希算法hash()
index = hash(key) % capacity既快又稳,
因此要包含以下特点:
**确定性:**在相同的哈希算法下,对于相同的输入,始终产生相同的输出
**效率高:**计算哈希值的时空复杂度要优
**均匀分布:**让键值对可以平均分布在哈希表中最好
哈希算法除了用在哈希表,还用在其他领域:
**密码储存:**系统只存储密码的哈希值,以防止密码直接被黑客盗取出明文(比如可以用原文去撞其他库的账号)因为哈希值有单向性,当用户输入密码时,只用比对哈希值是否相等就可以了,因为它有抗碰撞性
**数据完整性检查:**同上,比如 MD5 哈希算法,通过检查哈希值是否相同来匹配数据是否完整,因为哈希值有雪碧效应
哈希值在密码学或者说在安全性上的特点:
**单向性:**无法通过哈希值反推出原始数据的任何信息
抗碰撞性:很难找到两个不同的输入,使得它们的哈希值相同; 注:“均匀分布” 与 “抗碰撞性” 是两个独立的概念
**雪崩效应:**即蝴蝶效应,输入微小变化会导致输出发生不可预测的变化
在一些要求不高的场景,也可以使用或排列组合以下简单的哈希算法
**加法哈希:**对每个输入的字符的 ASCII 码进行相加,将得到的总和作为哈希值
**乘法哈希:**通过利用乘法的不确定性,将它们的 ASCII 码相乘
**异或哈希:**同上,只是运算法则变成了异或(相反为真,相同为假)
**旋转哈希:**没加一个 ASCII 码,就将哈希值翻转一下
/* 加法哈希 */int addHash(string key) { long long hash = 0; const int MODULUS = 1000000007; for (unsigned char c : key) { hash = (hash + (int)c) % MODULUS; } return (int)hash;} /* 乘法哈希 */int mulHash(string key) { long long hash = 0; const int MODULUS = 1000000007; for (unsigned char c : key) { hash = (31 * hash + (int)c) % MODULUS; } return (int)hash;} /* 异或哈希 */int xorHash(string key) { int hash = 0; const int MODULUS = 1000000007; for (unsigned char c : key) { hash ^= (int)c; } return hash & MODULUS;} /* 旋转哈希 */int rotHash(string key) { long long hash = 0; const int MODULUS = 1000000007; for (unsigned char c : key) { hash = ((hash << 4) ^ (hash >> 28) ^ (int)c) % MODULUS; } return (int)hash;}为什么要对大质数取模呢?
因为当使用大质数作为模数时,可以最大化的保证哈希值的均匀分布,因为质数与其他数字没有公约数,因此会减少哈希的周期,从而避免哈希冲突
如下:
但如果你可以保证 key 是均匀分布的,选择质数或合数都可以的,但如果分布存在某种周期性是,就不行,对合数取模更容易出现聚集现象
有 MD5、SHA-1、SHA-2、SHA3 等
| MD5 | SHA-1 | SHA-2 | SHA-3 | |
|---|---|---|---|---|
| 推出时间 | 1992 | 1995 | 2002 | 2008 |
| 输出长度 | 128 bits | 160 bits | 256 / 512 bits | 224/256/384/512 bits |
| 哈希冲突 | 较多 | 较多 | 很少 | 很少 |
| 安全等级 | 低,已被成功攻击 | 低,已被成功攻击 | 高 | 高 |
| 应用 | 已被弃用,仍用于数据完整性检查 | 已被弃用 | 加密货币交易验证、数字签名等 | 可用于替代 SHA-2 |
整数和布尔量的哈希值就是其本身。
浮点数和字符串的哈希值计算较为复杂,
元组的哈希值是对其中每一个元素进行哈希,然后将这些哈希值组合起来,得到单一的哈希值。
对象的哈希值基于其内存地址生成。通过重写对象的哈希方法,可实现基于内容生成哈希值。
Python 自带 hash() 函数用于计算各种数据类型的哈希值
C++ 自带的只能计算基本数据类型的
int num = 3;size_t hashNum = hash<int>()(num);// 整数 3 的哈希值为 3 bool bol = true;size_t hashBol = hash<bool>()(bol);// 布尔量 1 的哈希值为 1 double dec = 3.14159;size_t hashDec = hash<double>()(dec);// 小数 3.14159 的哈希值为 4614256650576692846 string str = "Hello 算法";size_t hashStr = hash<string>()(str);// 字符串 Hello 算法 的哈希值为 15466937326284535026 // 在 C++ 中,内置 std:hash() 仅提供基本数据类型的哈希值计算// 数组、对象的哈希值计算需要自行实现 在其他的大多编程语言中,只有不可变对象才可以作为哈希表的key,但链表或一些自定义对象的是可变的却还是可哈希的,是因为那些对象的基于内存地址生成的,所以内存地址不变,哈希值也不变
有些编程软件的解释器会在每次启动时,为字符串哈希函数加入一个随机的盐值(Salt)来让输出的哈希值在不同算法下不同,以防止攻击
即根深叶茂,分枝扶疏
「二叉树 binary tree」是一种非线性数据结构,其有着祖先与后代之间的派生关系,体现着 “一分为二” 的分治逻辑,与链表类似,二叉树的基本单元也是节点。每个节点包含着:值、左节点指针、右节点指针
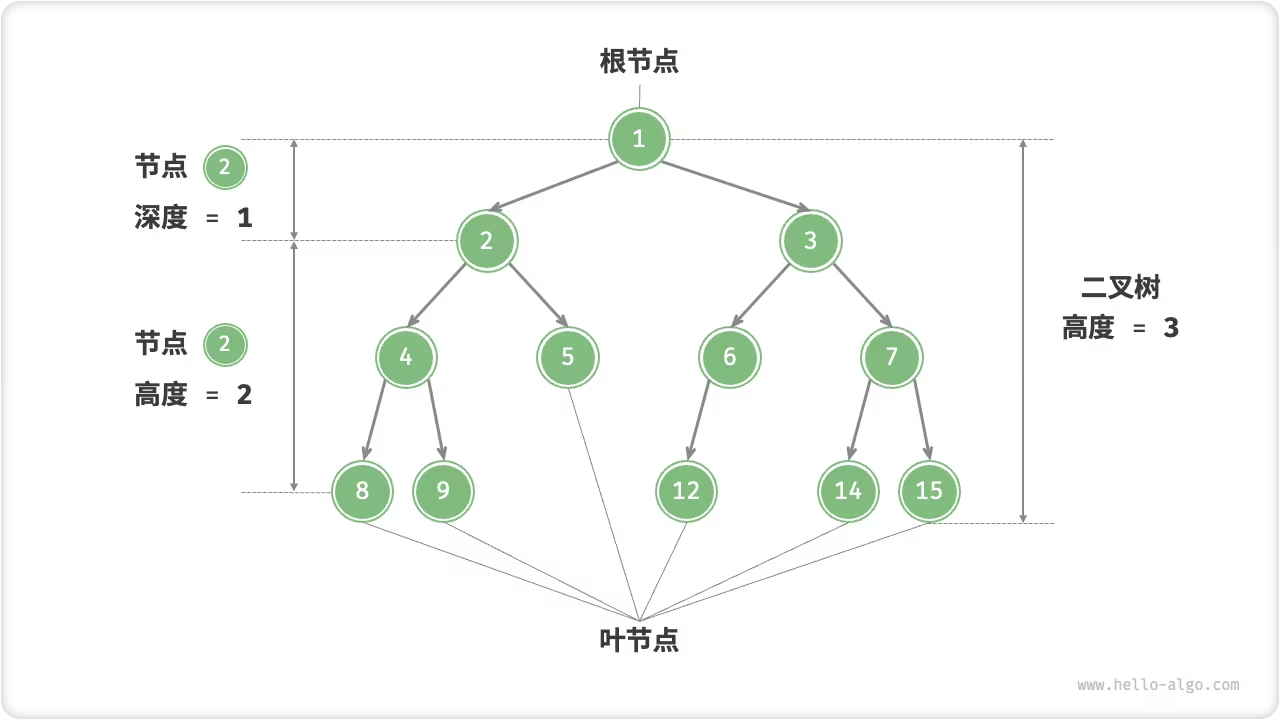
/* 二叉树节点结构体 */struct TreeNode { int val; // 节点值 TreeNode *left; // 左子节点指针 TreeNode *right; // 右子节点指针 TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}};其中,如果一个节点包含两个指向「左子节点 left-child node」和「右子节点 right-child node」的指针,则它叫这两个子节点的「父节点 parent node」,
还有,在一个节点以下,左边的左子节点及以下部分形成的树叫做该节点的「左子树 left subtree」,同理可得「右子树 right subtree」
如下图,在二叉树中,除了叶节点以外,其他的所有节点都包含子节点和非空子树

「根节点 root node」:位于二叉树顶层的节点,没有父节点。
「叶节点 leaf node」:没有子节点的节点,其两个指针均指向 。
「边 edge」:连接两个节点的线段,即节点引用(指针)。
节点所在的「层 level」:从顶至底递增,根节点所在层为 1 。
节点的「度 degree」:节点的子节点的数量。在二叉树中,度的取值范围是 0、1、2 。
二叉树的「高度 height」:从根节点到最远叶节点所经过的边的数量。
节点的「深度 depth」:从根节点到该节点所经过的边的数量。
节点的「高度 height」:从距离该节点最远的叶节点到该节点所经过的边的数量。

注:
这里的 “高度” 和 “深度” 指 “走过的边的数量” ,但在有些题目或教材中指 “走过的节点的数量(包括其本身)”,因此在这种情况下,高度与深度要加 1,
因此,在只有一个节点的二叉树中,树的高度和根节点的深度都是
都与链表的做法类似
/* 初始化二叉树 */// 初始化节点TreeNode* n1 = new TreeNode(1);TreeNode* n2 = new TreeNode(2);TreeNode* n3 = new TreeNode(3);TreeNode* n4 = new TreeNode(4);TreeNode* n5 = new TreeNode(5);// 构建指针指向(即指针)n1->left = n2;n1->right = n3;n2->left = n4;n2->right = n5;如下图,在插入或删除二叉树的节点是,会导致二叉树原有的逻辑结构改变,(删除单个节点会导致该节点及其以下所有子树都被删除,所以插入或删除常常是同时发生的)

/* 插入与删除节点 */TreeNode* P = new TreeNode(0);// 在 n1 -> n2 中间插入节点 Pn1->left = P;P->left = n2;// 删除节点 Pn1->left = n2;「完美二叉树 perfect binary tree」是所有层的阶段都被填满的二叉树
在完美二叉树中,叶节点的度为 ,其余所有节点的度都为 ;若树高度为 ,则节点总数为 ,呈现标准的指数级关系,反映了自然界中常见的细胞分裂现象。

「完全二叉树 complete binary tree」就是只有底层节点未被填满,且最底层节点尽量靠左填充

「完满二叉树 full binary tree」就是除了叶节点以外,其余的所有节点都有两个子节点

「平衡二叉树 balanced binary tree」就是它的其中任意节点的左子树与右子树的高度之差的绝对值不超过 1

左边是理想结构(最佳结构),二叉树的每层节点都被填满了
右边是退化结构(最差结构),所有节点都偏向一侧,退化成了链表
| 完美二叉树 | 链表 | |
|---|---|---|
| 第 层的节点数量 | ||
| 高度 树的叶节点数量 | $1 | |
| 高度 树的节点总数 | ||
| 节点总数 树的高度 |
树是一种基于链表的数据结构,也是一种非线性的数据结构,这使得遍历树比遍历链表更加复杂,因此需要借助搜索算法来实现遍历并使用优秀的搜索算法节约时间
二叉树常见的遍历方式包括层序遍历、前序遍历、中序遍历和后序遍历等
「层序遍历 level-order traversal」就是从顶部到底部逐层遍历二叉树。并在每一层按照从左到右的顺序访问节点
其本质上是「广度优先遍历 breadth-first traversal,它体现了一种“一圈一圈向外扩展”的逐层遍历方式。

广度优先遍历通常使用 “队列” 来作为中间值排序,从而获取新排序方式的序列,以便后续遍历。
因为队列遵循 “先进先出” 从规则,它和广度优先遍历 “逐层推进” 的规则背后的思想是差不多的
/* 层序遍历 */// 这只是以层序遍历的方式去排序1,2,3,4...这没包括遍历元素部分vector<int> levelOrder(TreeNode *root) { // 初始化队列,并加入根节点 queue<TreeNode *> queue; queue.push(root); // 初始化一个列表,用于保存以层序遍历的顺序排列的序列 vector<int> vec; // 下面是通过队列这个中间值,来保存层序遍历的孙秀 while (!queue.empty()) { TreeNode *node = queue.front(); queue.pop(); // 队列出队 vec.push_back(node->val); // 保存节点值 if (node->left != nullptr) queue.push(node->left); // 左子节点入队 if (node->right != nullptr) queue.push(node->right); // 右子节点入队 } return vec; // 返回这个顺序,用于去遍历}时间复杂度 :所有节点被访问一次,使用 时间,其中 为节点数量。(排序一次+遍历一次 共 ,约分为 )
空间复杂度 :在最差情况下,即满二叉树时,遍历到最底层之前,队列中最多同时存在 个节点,占用 空间。
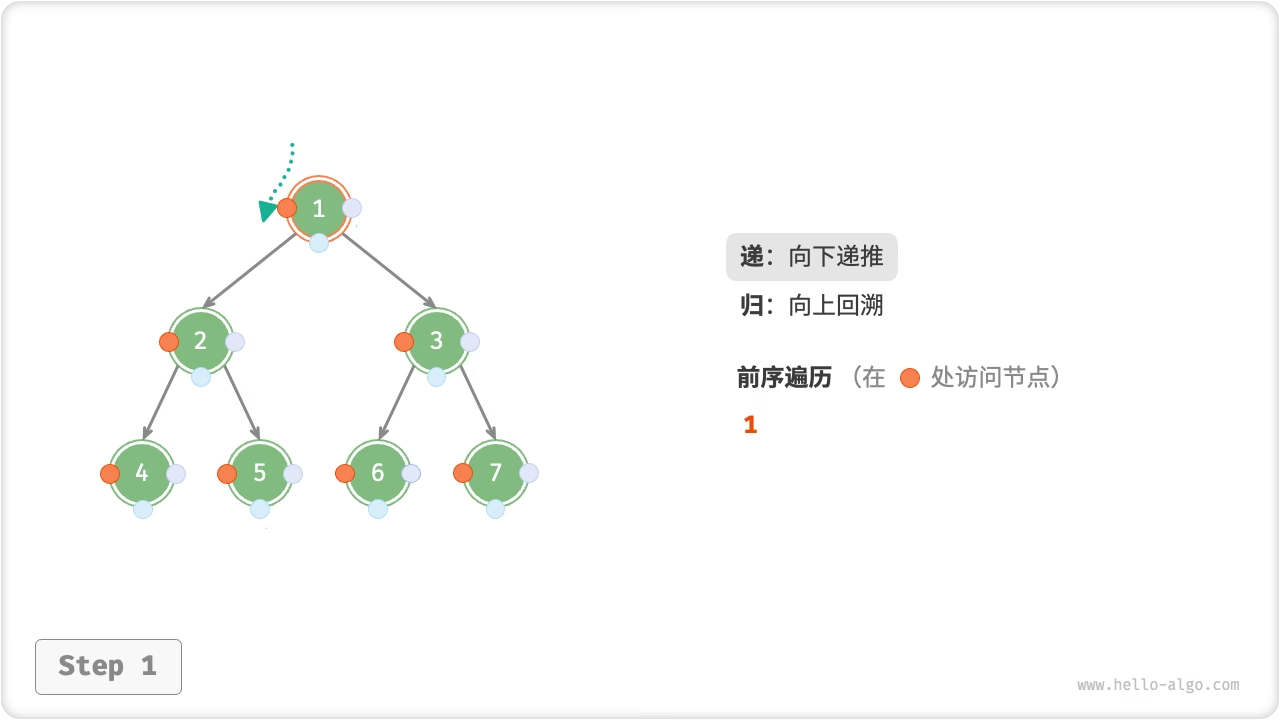
同理,这三个遍历都属于「深度优先遍历 depth-first traversal」,它体现了一种“先走到尽头,再回溯继续”的遍历方式。
其中分为三种方式:
① 前序遍历:根节点 -> 左子树 -> 右子树。“1245367”
② 中序遍历:左子树 -> 根节点 -> 右子树。“4251367”
③ 后序遍历:左子树 -> 右子树 -> 根节点。“4526731”
以下是对二叉树进行深度优先遍历的工作原理。深度优先遍历就像是绕着整个二叉树的外围“走”一圈,在每个节点都会遇到三个方向,分别对应前序遍历、中序遍历和后序遍历。(就是看是要先访问那个节点,橙色就是先访问左边(左子树/即前序遍历))

深度优先搜索通常基于递归实现:
这是直接遍历,不像上面一样要先排序在循环
/* 前序遍历 */void preOrder(TreeNode *root) { if (root == nullptr) return; // 访问优先级:根节点 -> 左子树 -> 右子树 // 如下图的步骤 vec.push_back(root->val); preOrder(root->left); preOrder(root->right);} /* 中序遍历 */void inOrder(TreeNode *root) { if (root == nullptr) return; // 访问优先级:左子树 -> 根节点 -> 右子树 inOrder(root->left); vec.push_back(root->val); inOrder(root->right);} /* 后序遍历 */void postOrder(TreeNode *root) { if (root == nullptr) return; // 访问优先级:左子树 -> 右子树 -> 根节点 postOrder(root->left); postOrder(root->right); vec.push_back(root->val);}当然也可以基于迭代(for 循环)实现,只是很麻烦
时间复杂度 :所有节点被访问一次,使用 时间。
空间复杂度 :在最差情况下,即树退化为链表时,递归深度达到 ,系统占用 栈帧空间。
二叉树也可以用数组表示,如下:
优点:
因为数组存储在连续内存空间中,因此访问右遍历速度比较快(广度优先与深度优先都快)
不需要指针,比较省空间(但空节点较多时不一定)
可以随机访问节点(这也是数组的优点)
局限性:
需要连续的空间,因此不适合存储数据量过大的树
增加与删除节点效率较低(需要大量的移动元素),(虽然查找效率较高),这也是数组与链表的优缺点
当二叉树中存在大量的空节点时,空间利用率较低
我们通过层序遍历的顺序来将一个二叉树储存到一个数组中,因此可以根据层序遍历的特性,推导出父与子节点索引之间的 “映射公式”(关系):
若节点的索引为 ,则该节点的左子节点索引为 ,右子节点索引为
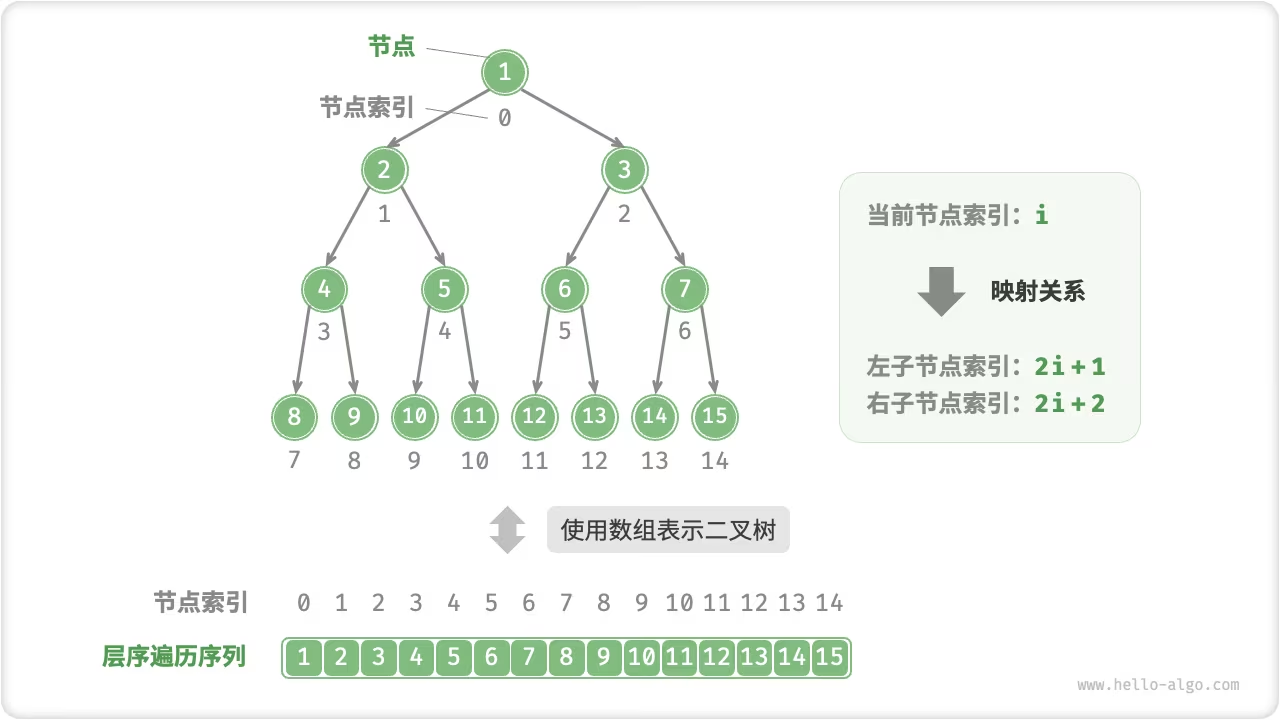
映射公式的角色相当于链表中的指针。给定数组中的任意一个节点,我们都可以通过映射公式来访问它的左(右)子节点。
除了完美二叉树(满二叉树)这一个特例,其他的二叉树的分叉都不是满的。因此通过层序遍历来将二叉树储存在数组是,空的分叉用空值来代替,以保证上面所说的 “映射关系” 成立
/* 二叉树的数组表示 */// 使用 int 最大值 INT_MAX 标记空位vector<int> tree = {1, 2, 3, 4, INT_MAX, 6, 7, 8, 9, INT_MAX, INT_MAX, 12, INT_MAX, INT_MAX, 15};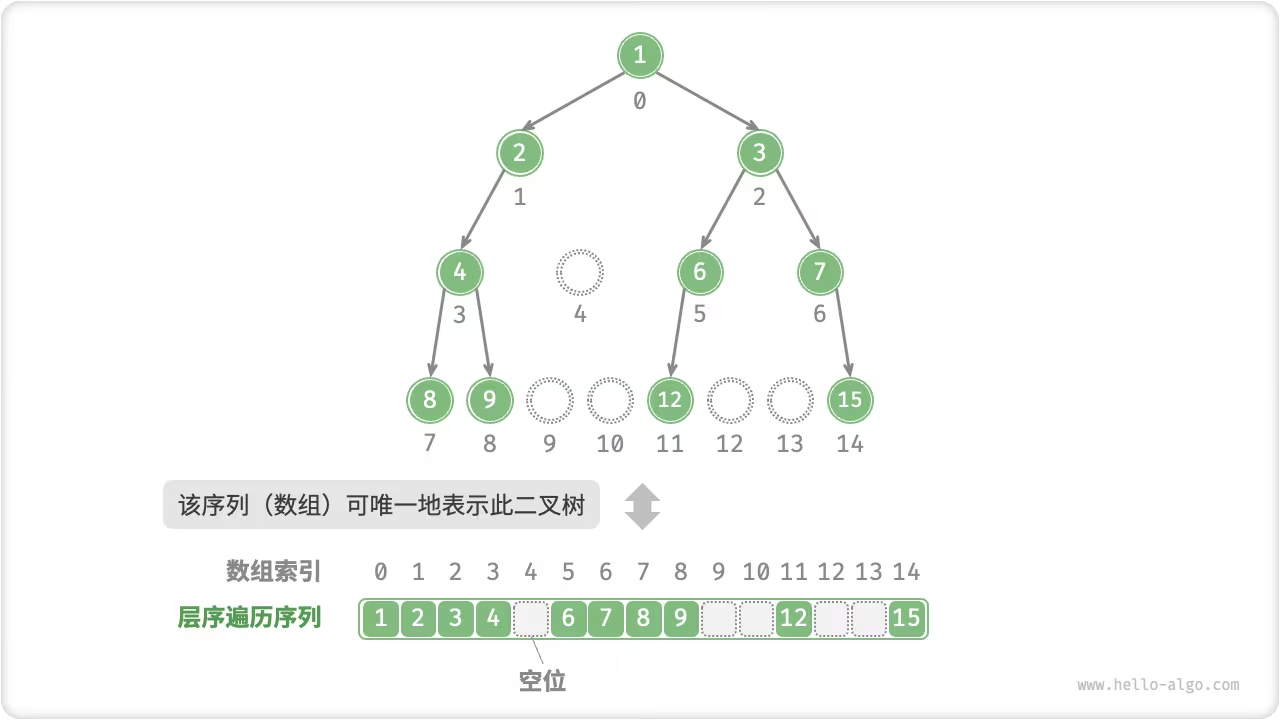
不然出现如下图的后果是,不满足映射关系,无法唯一的表示该二叉树(无法使用同一个方法表示二叉树,会很麻烦,这会导致每一层更改都要改变一次算法)
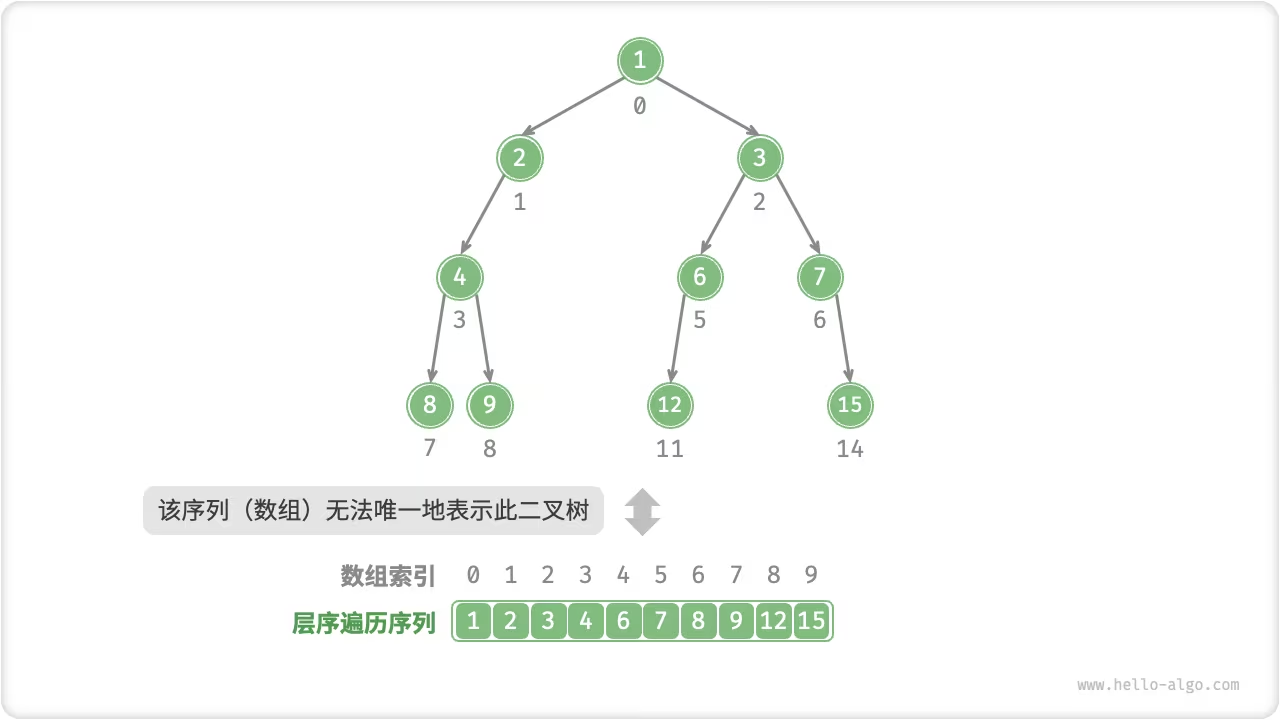
由此可知,**相比之下完全二叉树,以及它的特殊形式完美二叉树就非常适合用数组表示。**因为根据完全二叉树的定义,(空值)只出现在最底层且靠右的位置,因此所有 一定出现在层序遍历序列的末尾。
以下基于数组实现二叉树的代码,并包括以下操作:
给定某节点,获取它的值、左(右)子节点、父节点。
获取前序遍历、中序遍历、后序遍历、层序遍历序列。
/* 数组表示下的二叉树类 */class ArrayBinaryTree { public: /* 构造方法 */ ArrayBinaryTree(vector<int> arr) { tree = arr; } /* 节点数量 */ int size() { return tree.size(); } /* 获取索引为 i 节点的值 */ int val(int i) { // 若索引越界,则返回 INT_MAX ,代表空位 if (i < 0 || i >= size()) return INT_MAX; return tree[i]; } /* 获取索引为 i 节点的左子节点的索引 */ int left(int i) { return 2 * i + 1; } /* 获取索引为 i 节点的右子节点的索引 */ int right(int i) { return 2 * i + 2; } /* 获取索引为 i 节点的父节点的索引 */ int parent(int i) { return (i - 1) / 2; } /* 层序遍历 */ vector<int> levelOrder() { vector<int> res; // 直接遍历数组 for (int i = 0; i < size(); i++) { if (val(i) != INT_MAX) res.push_back(val(i)); } return res; } /* 前序遍历 */ vector<int> preOrder() { vector<int> res; dfs(0, "pre", res); return res; } /* 中序遍历 */ vector<int> inOrder() { vector<int> res; dfs(0, "in", res); return res; } /* 后序遍历 */ vector<int> postOrder() { vector<int> res; dfs(0, "post", res); return res; } private: vector<int> tree; /* 深度优先遍历 */ void dfs(int i, string order, vector<int> &res) { // 若为空位,则返回 if (val(i) == INT_MAX) return; // 下面是通过判断来选择那种方式 // 前序遍历 if (order == "pre") res.push_back(val(i)); dfs(left(i), order, res); // 中序遍历 if (order == "in") res.push_back(val(i)); dfs(right(i), order, res); // 后序遍历 if (order == "post") res.push_back(val(i)); }};「二叉搜索树 binary search tree」要满足以下条件:
1. 。以下的图的都是“值”,而非序号

我们通过将二叉搜索树封装为一个类 BinarySearchTree ,并声明一个成员变量 root ,指向树的根节点,来简化操作
/* 查找节点 */TreeNode *search(int num) { TreeNode *cur = root; // 循环查找,越过叶节点后跳出 while (cur != nullptr) { // 目标节点在 cur 的右子树中 if (cur->val < num) cur = cur->right; // 目标节点在 cur 的左子树中 else if (cur->val > num) cur = cur->left; // 找到目标节点,跳出循环(指针=值) else break; } // 返回目标节点 return cur;}【GIF】
二叉搜索树的查找操作与二分查找算法的原理一致,都是每轮排除一半的情况。循环次数最多为二叉树的高度,当二叉树平衡时,使用 时间。
因为为了保证二叉搜索树“左子树 < 根节点 < 右子树”的性质,因此流程如下:
先查找插入位置
再在该位置的左或右子树中插入节点
/* 插入节点 */void insert(int num) { // 若树为空,则初始化根节点 if (root == nullptr) { root = new TreeNode(num); return; } TreeNode *cur = root, *pre = nullptr; // 循环查找,越过叶节点后跳出 while (cur != nullptr) { // 找到重复节点,直接返回 if (cur->val == num) return; /* 在比较值的大小前赋值是: 为了用pre保存父节点, 防止pre赋值成了cur最后指向的空值, 如下图 */ pre = cur; // 插入位置在 cur 的右子树中 if (cur->val < num) cur = cur->right; // 插入位置在 cur 的左子树中 else cur = cur->left; } // 插入节点 TreeNode *node = new TreeNode(num); if (pre->val < num) pre->right = node; else pre->left = node;}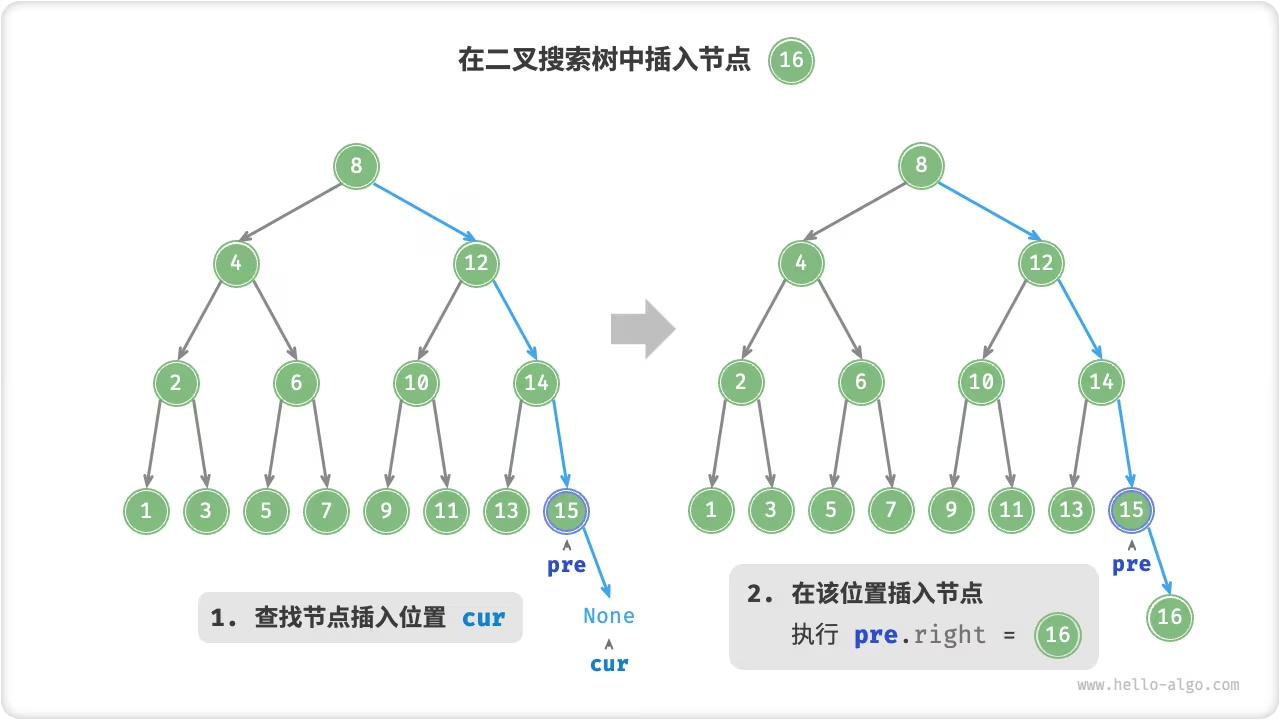
注:
二叉搜索树不允许存在重复节点,否则将违反其定义。因此,若待插入节点在树中已存在,则不执行插入,直接返回。
与查找节点相同,插入节点使用 时间。
也是先查找后删除,
但为了保证删除后,二叉搜索树的“左子树 < 根节点 < 右子树”的性质仍然满足。
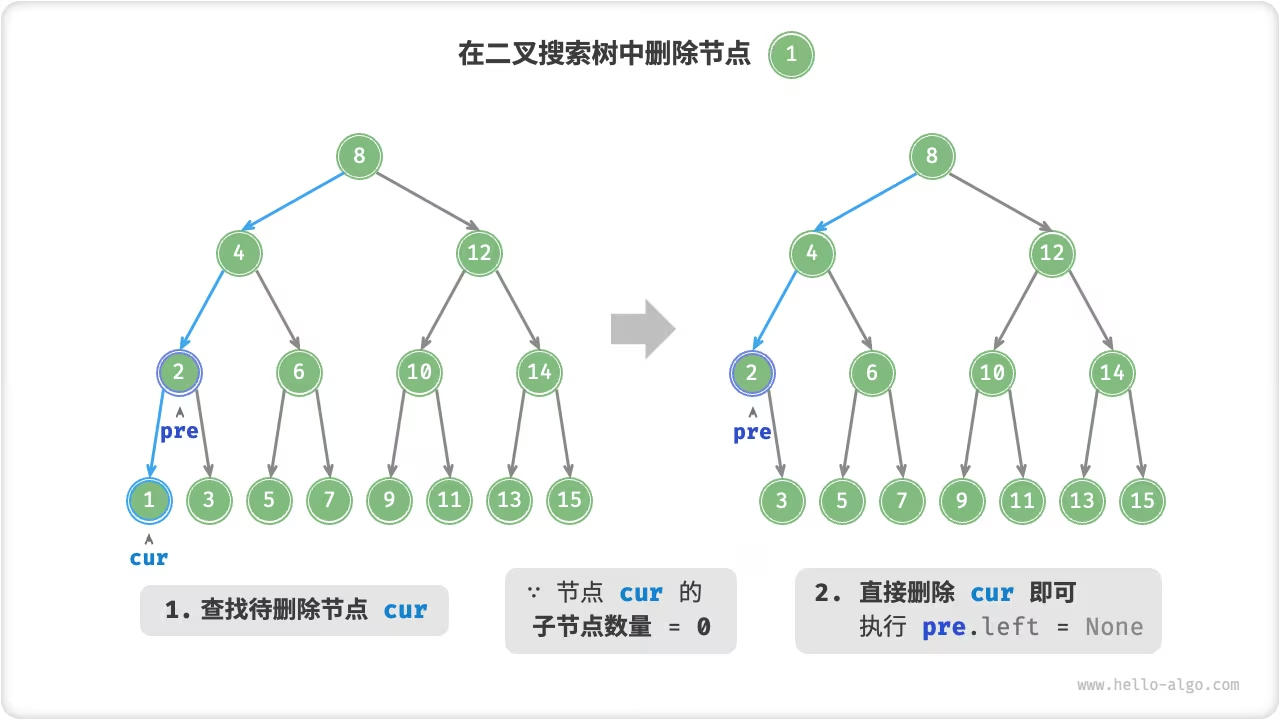
因此,我们需要根据节点数量(度),分为 这三种情况
这说明该节点是叶节点,可以直接删除
直接将要删除的节点的子节点替换掉它即可
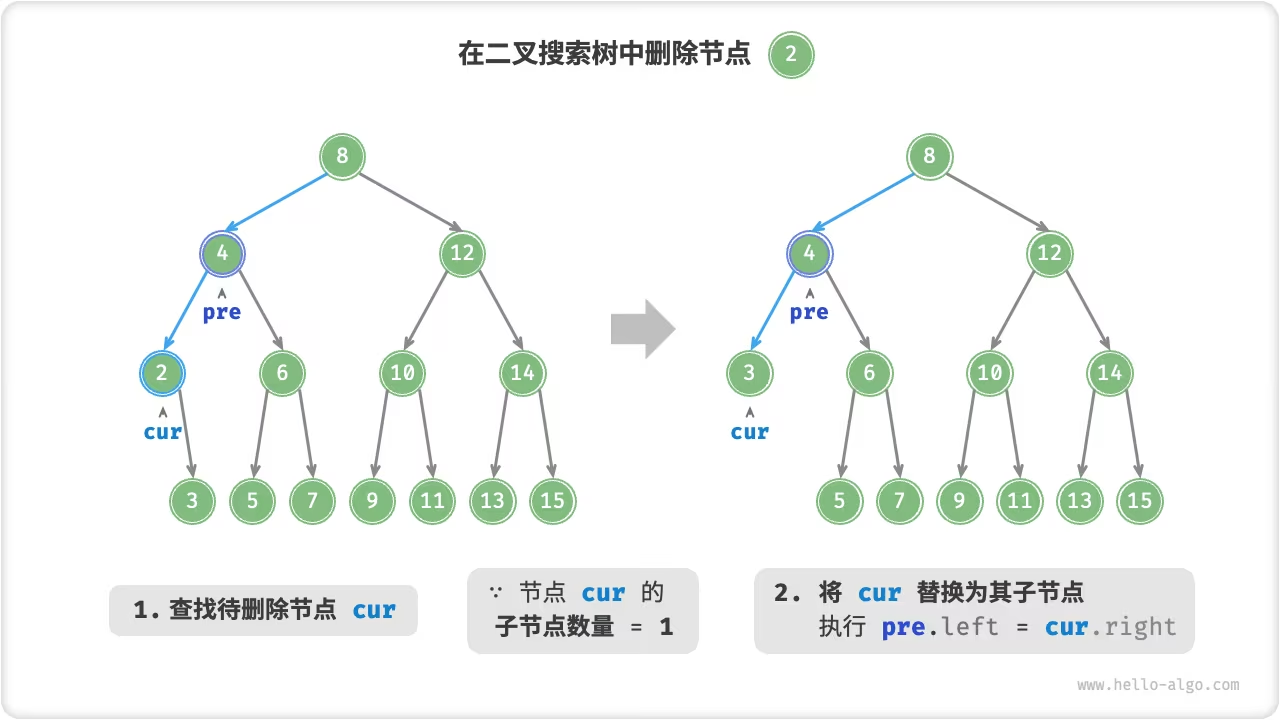
因为要保证“左 < 根 < 右”
因此需要在它的子树中找到一个节点来替换它,并根据性质可以发现,这个节点是右子树的最小节点或左子树的最大节点
【GIF】
删除节点操作同样使用 时间,
其中查找待删除节点需要 时间,(查找)
获取中序遍历后继节点需要 时间。(更改(这主要是节点为 个的情况))
/* 删除节点 */void remove(int num) { // 若树为空,直接提前返回 if (root == nullptr) return; TreeNode *cur = root, *pre = nullptr; // 循环查找,越过叶节点后跳出 while (cur != nullptr) { // 找到待删除节点,跳出循环 if (cur->val == num) break; pre = cur; // 待删除节点在 cur 的右子树中 if (cur->val < num) cur = cur->right; // 待删除节点在 cur 的左子树中 else cur = cur->left; } // 若无待删除节点,则直接返回 if (cur == nullptr) return; // 子节点数量 = 0 or 1 if (cur->left == nullptr || cur->right == nullptr) { // 当子节点数量 = 0 / 1 时, child = nullptr / 该子节点 TreeNode *child = cur->left != nullptr ? cur->left : cur->right; // 删除节点 cur if (cur != root) { if (pre->left == cur) pre->left = child; else pre->right = child; } else { // 若删除节点为根节点,则重新指定根节点 root = child; } // 释放内存 delete cur; } // 子节点数量 = 2 else { // 获取中序遍历中 cur 的下一个节点 TreeNode *tmp = cur->right; while (tmp->left != nullptr) { tmp = tmp->left; } int tmpVal = tmp->val; // 递归删除节点 tmp remove(tmp->val); // 用 tmp 覆盖 cur cur->val = tmpVal; }}因为二叉搜索树满足“左子节点 < 根节点 < 右子节点”的大小关系。
并且二叉树的中序遍历满足“左 → 根 → 右”的遍历顺序,且时间为
因此二叉搜索树的中序遍历序列是升序的,并且时间是 ,十分高效

| 无序数组 | 二叉搜索树 | |
|---|---|---|
| 查找元素 | ||
| 插入元素 | ||
| 删除元素 |
在理想情况下,二叉搜索树是 “平衡” 的,所以可以在 轮循环下查找任意节点。
但如果在二叉搜索树中不断地插入和删除节点,会导致二叉树退化,可能退化成链表,导致时间复杂度变为
还有,二分 二叉搜索树,因为二叉搜索树可能会经过不断的插入与删除退化(是最终结果,不是初始状态)

主要是在需要快速查找、插入、删除操作的场景下
作为系统中的多级索引,实现高效的查找、插入、删除操作
作为某些搜索算法的底层数据结构
用于存储数据流,以保持其有序的状态
因为二叉搜索树在多次插入与删除后,可能退化为链表,将时间复杂度恶化
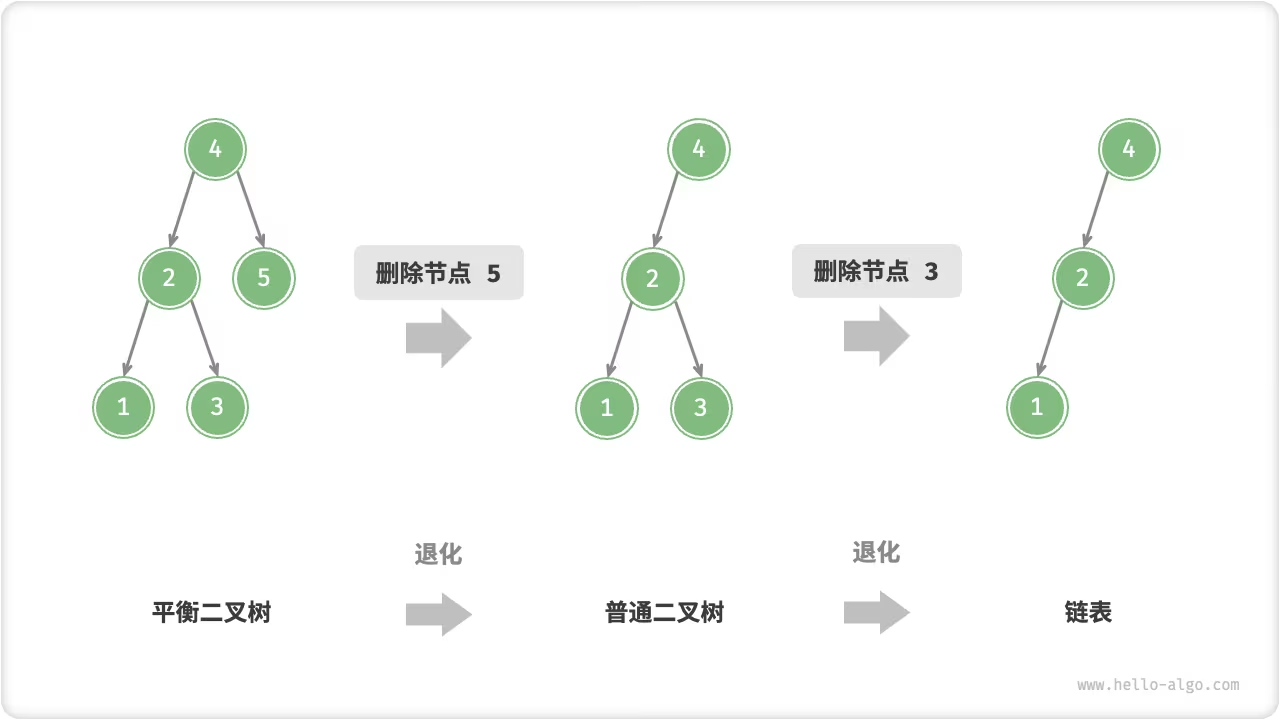
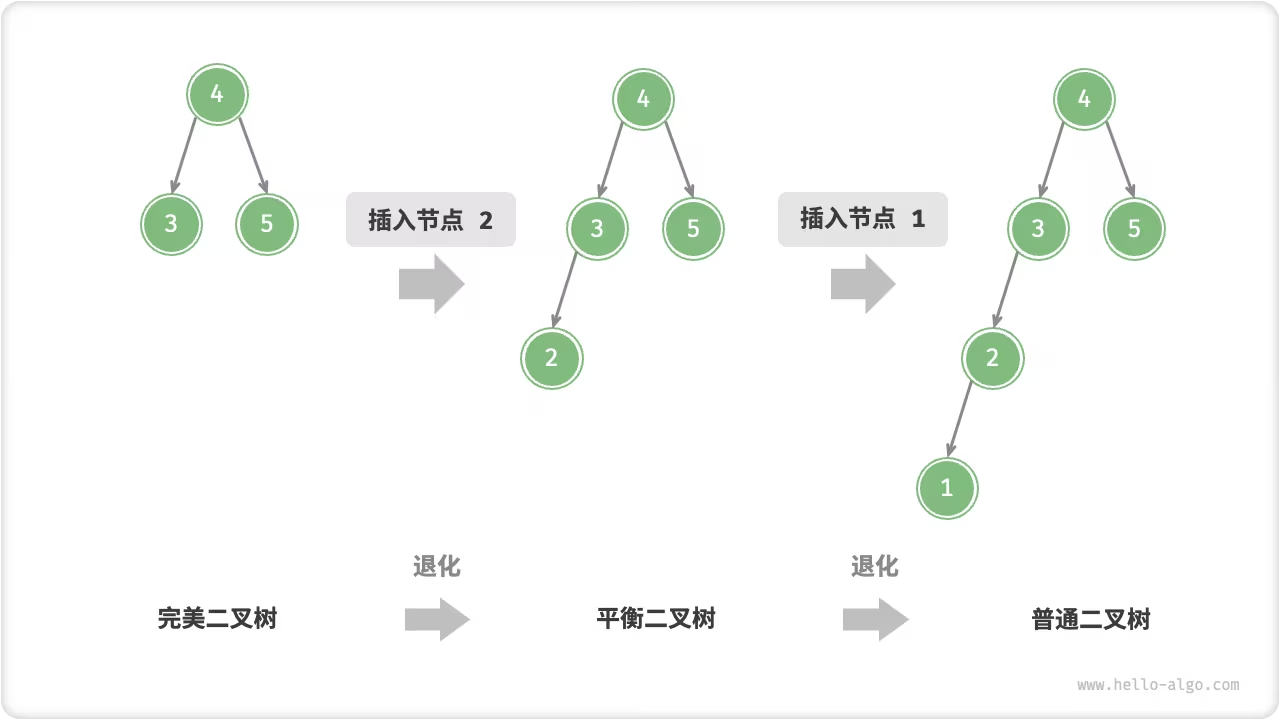
因此,G. M. Adelson-Velsky 和 E. M. Landis 在其 1962 年发表的论文 "An algorithm for the organization of information" 中提出了「AVL 树」,AVL 取的就是它们名字的首字母
说白了,AVL 树就是可以自动平衡的二叉搜索树
AVL 树既是二叉搜索树也是平衡二叉树,即满足它们的所有性质,因此又叫「平衡二叉搜索树 balanced binary search tree」。
因为要让树平衡(左右节点高度不超过 1),因此我们需要获取节点高度
因此 1 节点类要多增加一个节点高度 height 变量
/* AVL 树节点类 */struct TreeNode { int val{}; // 节点值 int height = 0; // 节点高度 TreeNode *left{}; // 左子节点 TreeNode *right{}; // 右子节点 TreeNode() = default; explicit TreeNode(int x) : val(x){}};这里的 “节点高度” 是指从该节点到其最远的叶节点的距离,即所经过的 “边” 的数量,
以下是两个工具函数
/* 获取节点高度 */int height(TreeNode *node) { // 空节点高度为 -1 ,叶节点高度为 0 return node == nullptr ? -1 : node->height;} /* 更新节点高度 */void updateHeight(TreeNode *node) { // 节点高度等于最高子树高度 + 1 node->height = max(height(node->left), height(node->right)) + 1;}节点的「平衡因子 balance factor」=节点左子树的高度-节点右子树的高度并规定空节点的平衡因子=0
以下是将获取节点平衡因子的功能封装成函数,方便后续使用
/* 获取平衡因子 */int balanceFactor(TreeNode *node) { // 空节点平衡因子为 0 if (node == nullptr) return 0; // 节点平衡因子 = 左子树高度 - 右子树高度 return height(node->left) - height(node->right);}则
AVL 树的特点就是其"旋转"操作,它能够在不影响二叉树的中序遍历序列的前提下,使失衡节点重新恢复平衡。即旋转操作既能保持“二叉搜索树”的性质,也能使树重新变为“平衡二叉树”。
根据平衡二叉树的性质,我们将 的节点称为 “失衡节点”,因此我们需要通过:右旋、左旋、先右旋后左旋、先左旋后右旋这四种方法来让其平衡
如下图,从底至顶看,二叉树中首个失衡节点是“节点 3”。我们关注该失衡节点(3),以及以该失衡节点(3)为根节点(3)的子树(1),将该节点(3)记为 node ,其左子节点(1)记为 child ,执行“右旋”操作。完成右旋后,子树已经恢复平衡,并且仍然保持二叉搜索树的特性。
【GIF】
如下图,当节点 child 有右子节点(记为 grandChild )时,需要在右旋中添加一步:将 grandChild 作为 node 的左子节点。(因为根据二叉搜索树的性质(4)的位置一定小于(5)的位置的)
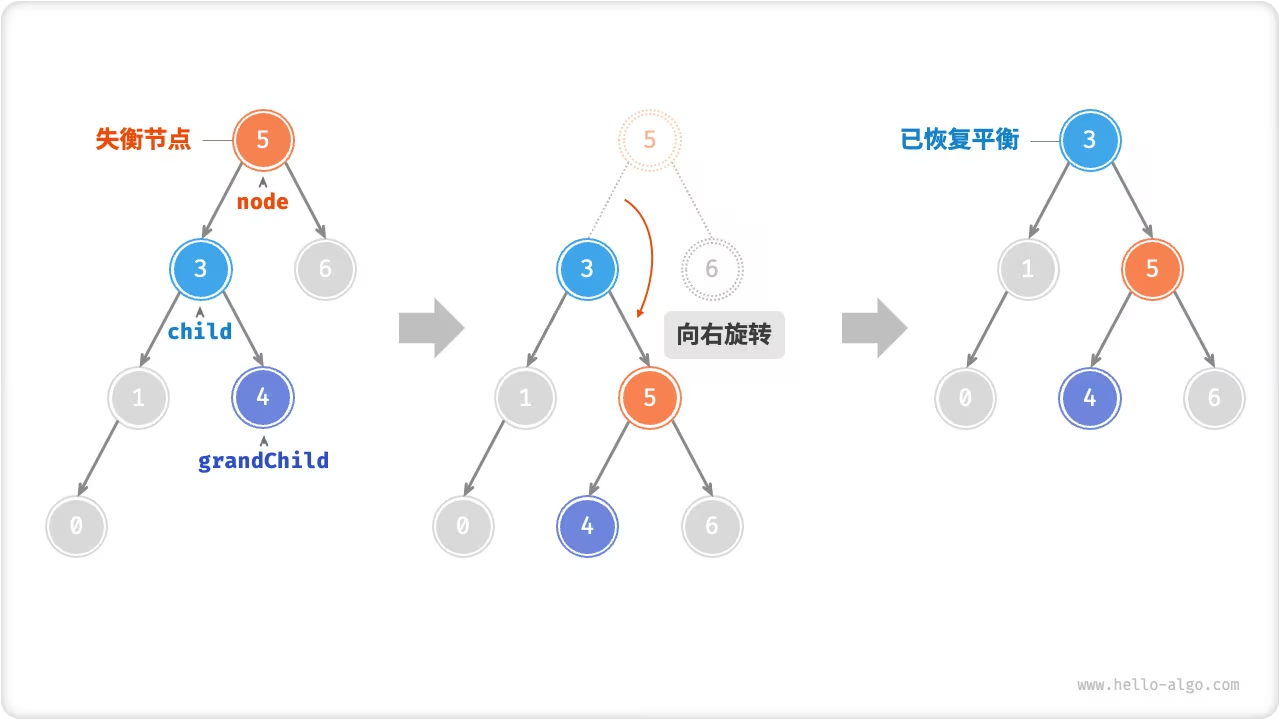
将形象的 “向右旋转” 改为修改节点指针的代码如下:
/* 右旋操作 */TreeNode *rightRotate(TreeNode *node) { TreeNode *child = node->left; TreeNode *grandChild = child->right; // 以 child 为原点,将 node 向右旋转 child->right = node; node->left = grandChild; // 更新节点高度 updateHeight(node); updateHeight(child); // 返回旋转后子树的根节点 return child;}与右旋的操作类似,只是镜像了一下
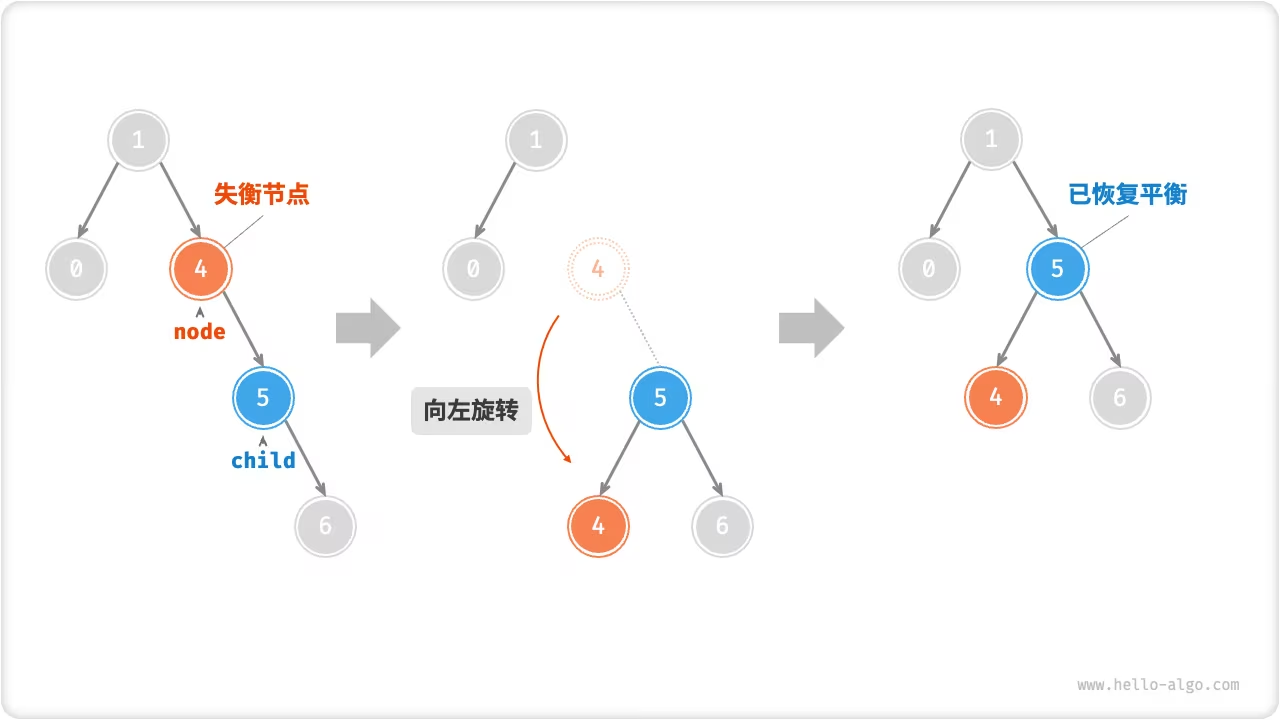
包括有两个子节点时也同理

因为操作逻辑上,右旋与左旋是镜像对称的,因此操作上也同理,如下
/* 左旋操作 */TreeNode *leftRotate(TreeNode *node) { TreeNode *child = node->right; TreeNode *grandChild = child->left; // 以 child 为原点,将 node 向左旋转 child->left = node; node->right = grandChild; // 更新节点高度 updateHeight(node); updateHeight(child); // 返回旋转后子树的根节点 return child;}因为有时候一步无法让他恢复平衡,就让他进行连续进行两步,又因为这两步步骤不同(相反),所以名称也不同

同上,也是镜像
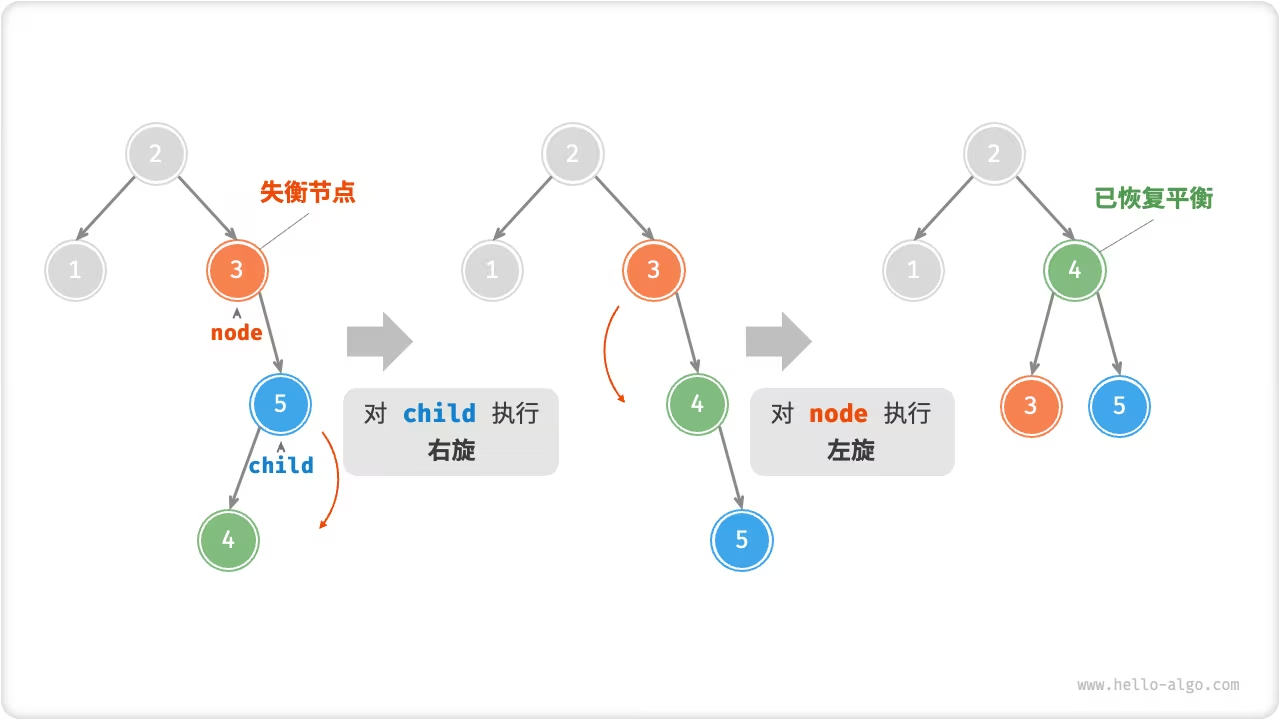
当然就是以上的四种情况了
只是用下表的变量与数学表达式来判断,以便规范与让计算机使用
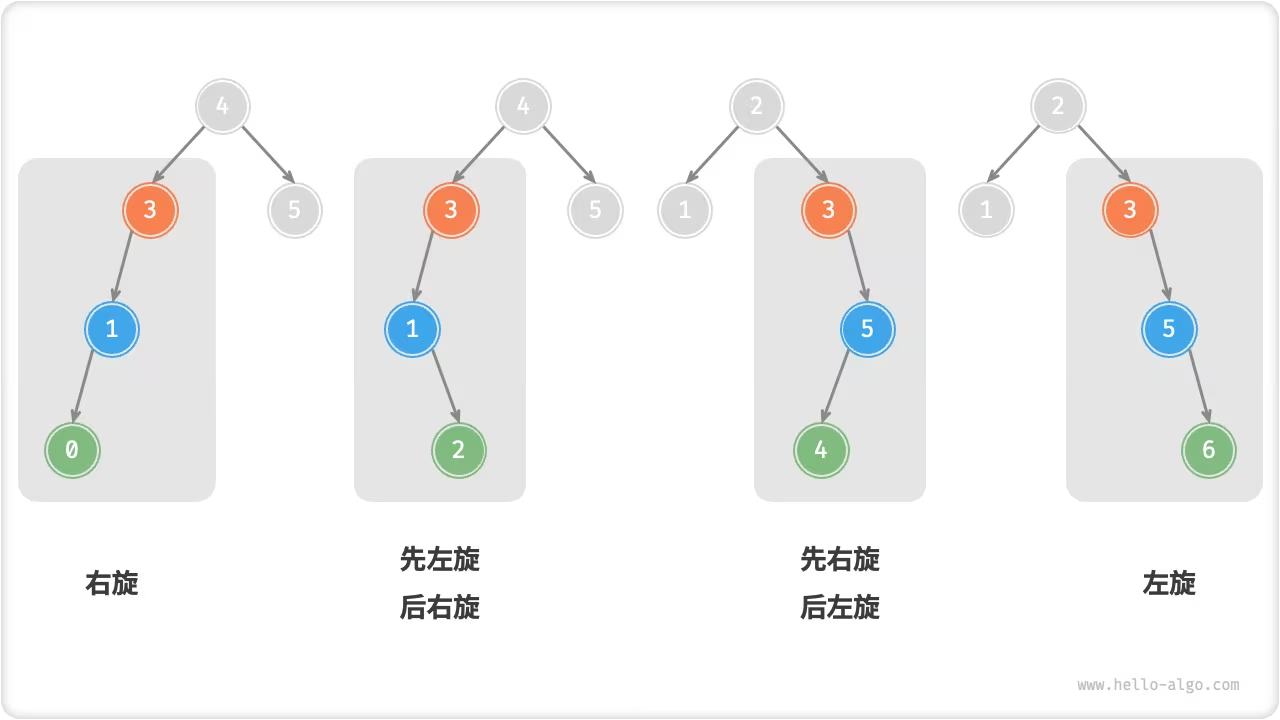
| 失衡节点的平衡因子 | 子节点的平衡因子 | 应采用的旋转方法 |
|---|---|---|
| (即左偏树) | 右旋 | |
| (即左偏树) | 先左旋后右旋 | |
| (即右偏树) | 左旋 | |
| (即右偏树) | 先右旋后左旋 |
然后将上表封装成函数如下:
/* 执行旋转操作,使该子树重新恢复平衡 */TreeNode *rotate(TreeNode *node) { // 获取节点 node 的平衡因子 int _balanceFactor = balanceFactor(node); // 左偏树 if (_balanceFactor > 1) { if (balanceFactor(node->left) >= 0) { // 右旋 return rightRotate(node); } else { // 先左旋后右旋 node->left = leftRotate(node->left); return rightRotate(node); } } // 右偏树 if (_balanceFactor < -1) { if (balanceFactor(node->right) <= 0) { // 左旋 return leftRotate(node); } else { // 先右旋后左旋 node->right = rightRotate(node->right); return leftRotate(node); } } // 平衡树,无须旋转,直接返回 return node;}就是插入后再判断一下是否失衡,然后再旋转以恢复平衡,通过从这个节点开始,自底向上执行旋转操作,使所有失衡节点恢复平衡。
/* 插入节点 */void insert(int val) { root = insertHelper(root, val);} /* 递归插入节点(辅助方法) */TreeNode *insertHelper(TreeNode *node, int val) { if (node == nullptr) return new TreeNode(val); /* 1. 查找插入位置,并插入节点 */ if (val < node->val) node->left = insertHelper(node->left, val); else if (val > node->val) node->right = insertHelper(node->right, val); else return node; // 重复节点不插入,直接返回 updateHeight(node); // 更新节点高度 /* 2. 执行旋转操作,使该子树重新恢复平衡 */ node = rotate(node); // 返回子树的根节点 return node;}同理,在删除操作上,在删除后也是需要从底至顶地执行旋转操作,使所有失衡节点恢复平衡。
/* 删除节点 */void remove(int val) { root = removeHelper(root, val);} /* 递归删除节点(辅助方法) */TreeNode *removeHelper(TreeNode *node, int val) { if (node == nullptr) return nullptr; /* 1. 查找节点,并删除之 */ if (val < node->val) node->left = removeHelper(node->left, val); else if (val > node->val) node->right = removeHelper(node->right, val); else { if (node->left == nullptr || node->right == nullptr) { TreeNode *child = node->left != nullptr ? node->left : node->right; // 子节点数量 = 0 ,直接删除 node 并返回 if (child == nullptr) { delete node; return nullptr; } // 子节点数量 = 1 ,直接删除 node else { delete node; node = child; } } else { // 子节点数量 = 2 ,则将中序遍历的下个节点删除,并用该节点替换当前节点 TreeNode *temp = node->right; while (temp->left != nullptr) { temp = temp->left; } int tempVal = temp->val; node->right = removeHelper(node->right, temp->val); node->val = tempVal; } } updateHeight(node); // 更新节点高度 /* 2. 执行旋转操作,使该子树重新恢复平衡 */ node = rotate(node); // 返回子树的根节点 return node;}同二叉搜索树
组织和存储大型数据,适用于高频查找、低频增删的场景。
用于构建数据库中的索引系统。
红黑树在许多应用中比 AVL 树更受欢迎。这是因为红黑树的平衡条件相对宽松,在红黑树中插入与删除节点所需的旋转操作相对较少,其节点增删操作的平均效率更高。
堆就像山川的峰峦,它们层叠起伏、形态各异
每一座山峰都有其高低之分,但最先映入眼帘总是最高峰
「堆 heap」是一种满足特定条件的特殊的完全二叉树,主要有以下两种类型:
「大顶堆 max heap」:任意节点的值 其子节点的值 (父子)
「小顶堆 min heap」:任意节点的值 其子节点的值 (父子)

并且我们将二叉树的根节点称为 “堆顶” ,将底层最靠右的节点称为 “堆底”
堆作为完全二叉树的一个特性,具有以下特点:
完全二叉树的最底层节点靠左填充,其他层节点都被填满的特点
对于大顶堆,堆顶元素(根节点)的值是最大的,小顶堆的就是最小的当然要注意:堆底的值不一定是最值
注:这是数据结构的 “堆”,它与内存管理的 “堆”不是同一个概念
内存管理的 “堆”内存是人工/程序控制的,而 “栈”内存是系统控制的
首先要明确一个概念:「优先队列 priority queue」这是一种抽象的数据结构,就是按照优先级来从一个队列中取出元素,而非通过先入先出的方式
常见实现优先队列的方式有:
堆(高效)
有序数组(每次取出时遍历一遍)
链表(按照优先级的顺序来存储,但缺点时插入操作比较慢
二叉搜索树(自带顺序(左<根<右,但有不平衡的缺点,AVL 树也没堆高效,因为旋转操作要大量时间)
所以人们常用堆来实现优先队列,大顶堆相当于将元素按从大到小的顺序出队的优先队列,因此 “堆” 和 “优先队列” 在使用时可以看作等价的,以下不做特别说明,“”
| 方法名 | 描述 | 时间复杂度 |
|---|---|---|
push() |
元素入堆 | |
pop() |
堆顶元素出堆 | |
top() |
访问堆顶元素(大 / 小顶堆分别为最大 / 小值) | |
size() |
获取堆的元素数量 | |
empty() |
判断堆是否为空 |
/* 初始化堆 */// 初始化小顶堆priority_queue<int, vector<int>, greater<int>> minHeap;// 初始化大顶堆priority_queue<int, vector<int>, less<int>> maxHeap; /* 元素入堆 */maxHeap.push(1);maxHeap.push(3);maxHeap.push(2);maxHeap.push(5);maxHeap.push(4); /* 获取堆顶元素 */int peek = maxHeap.top(); // 5 /* 堆顶元素出堆 */// 出堆元素会形成一个从大到小的序列maxHeap.pop(); // 5maxHeap.pop(); // 4maxHeap.pop(); // 3maxHeap.pop(); // 2maxHeap.pop(); // 1 /* 获取堆大小 */int size = maxHeap.size(); /* 判断堆是否为空 */bool isEmpty = maxHeap.empty(); /* 输入列表并建堆 */vector<int> input{1, 3, 2, 5, 4};priority_queue<int, vector<int>, greater<int>> minHeap(input.begin(), input.end());注:
greater<int> 和 less<int> 也可以用在 sort() 中,
less<int> 是让 sort() 按照默认顺序排序(从小到大)
greater<int>是让 sort() 按照从大到小的顺序来排序
int nums[] = {3, 1, 4, 1, 5, 9};sort(nums,nums+6, greater<int>());for(auto i:nums){cout<<i<<' ';} //输出:9 5 4 3 1 1还有:这两只是比较器,因此用在可变数组呀等等都是可以的
下面都是大顶堆的内容,若要改成小顶堆,只要将逻辑判断取反即可(如:将 替换为 )
因为完全二叉树非常适合使用数组来表示,并且堆是一种特殊的完全二叉树,因此我们常用数组来存储堆,并且可以使用索引映射公式来表示节点指针
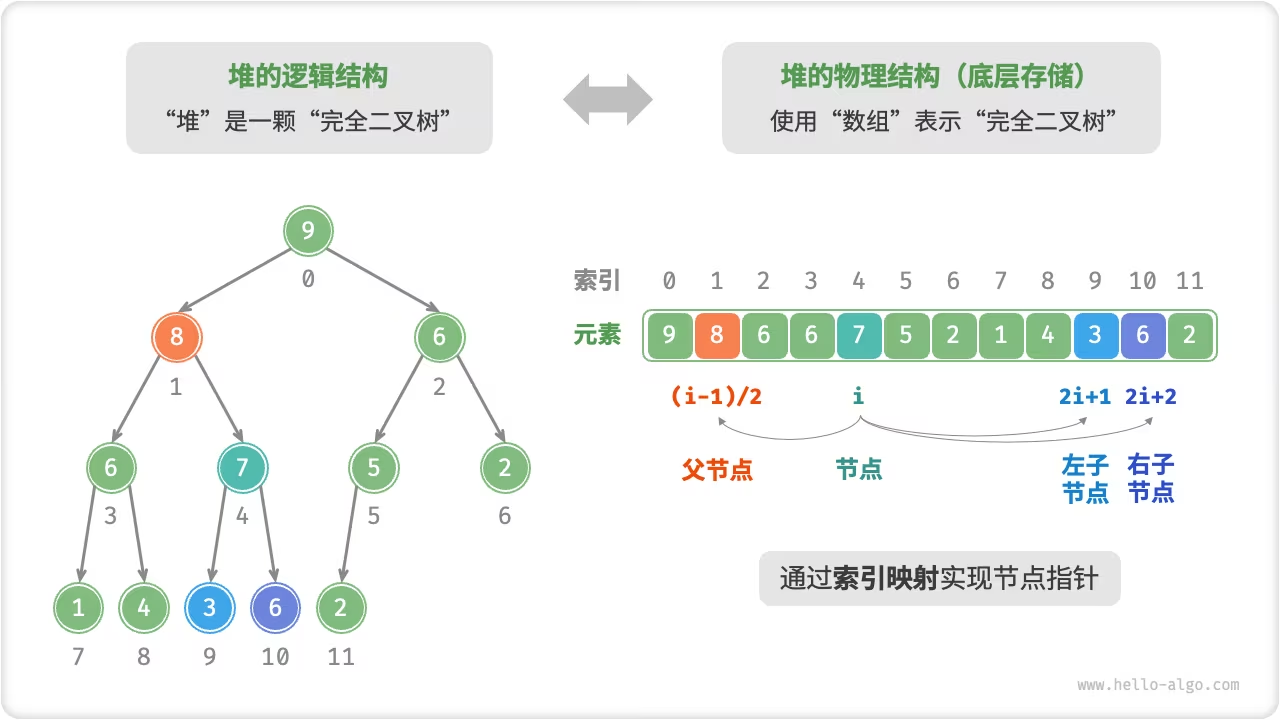
封装成函数如下:
/* 获取左子节点索引 */int left(int i) { return 2 * i + 1;} /* 获取右子节点索引 */int right(int i) { return 2 * i + 2;} /* 获取父节点索引 */int parent(int i) { return (i - 1) / 2; // 向下取整}堆顶元素即为二叉树的根节点,也是列表的首个元素
/* 访问堆顶元素 */int peek() { return maxHeap[0];}如下图所示,先放入数组末尾(堆底),然后再依次比较它的父节点,从底到顶进行「堆化 heapify」来修复从插入节点到根节点的路径上的各个节点,以保证堆的成立条件
【GIF】
当节点数为 时,树的高度为 ,则堆化操作的循环轮数最多为 ,即元素入堆操作的时间复杂度为
/* 元素入堆 */void push(int val) { // 添加节点 maxHeap.push_back(val); // 从底至顶堆化 siftUp(size() - 1);} /* 从节点 i 开始,从底至顶堆化 */void siftUp(int i) { while (true) { // 获取节点 i 的父节点 int p = parent(i); // 当“越过根节点”或“节点无须修复”时,结束堆化 if (p < 0 || maxHeap[i] <= maxHeap[p]) break; // 交换两节点 swap(maxHeap[i], maxHeap[p]); // 循环向上堆化 i = p; }}当删除了列表的首元素,所有的节点的因素都会发生变化,使得后面修复堆化会比较困难,因此我们需要减少元素索引的改动,因此我们用以下方法:
交换堆顶元素与堆底元素( a[0] 和 a[n-1] 根节点和最右子节点)
交换完成后,将堆底(即原来的堆顶)删除
然后从根节点开始,从顶到底执行堆化
通过这种方法,可以让时间复杂度与元素入堆操作相似,为
/* 元素出堆 */void pop() { // 判空处理 if (isEmpty()) { throw out_of_range("堆为空"); } // 交换根节点与最右叶节点(即交换首元素与尾元素) swap(maxHeap[0], maxHeap[size() - 1]); // 删除节点 maxHeap.pop_back(); // 从顶至底堆化 siftDown(0);} /* 从节点 i 开始,从顶至底堆化 */void siftDown(int i) { while (true) { // 因为要比较的更多了,所以比上面入堆操作的内容更多 // 判断节点 i, l, r 中值最大的节点,记为 ma int l = left(i), r = right(i), ma = i; if (l < size() && maxHeap[l] > maxHeap[ma]) ma = l; if (r < size() && maxHeap[r] > maxHeap[ma]) ma = r; // 若节点 i 最大或索引 l, r 越界,则无须继续堆化,跳出 if (ma == i) break; swap(maxHeap[i], maxHeap[ma]); // 循环向下堆化 i = ma; }}**优先队列:**堆通常作为实现优先队列的首选数据结构,其入队和出队操作的时间复杂度均为,而建队操作为,这些操作都非常高效
**堆排序:**给定一组数据,我们可以用它们建立一个堆,然后不断地执行元素出堆操作,从而得到有序数据。但我们常用更优雅的方式来进行堆排序
**获取最大(小)的 个元素:**如选择热度前 10 的新闻作为热搜等等
**查找中位数:**用于在一个动态序列中快速查找到中位数
**贪心算法优化:**在某些贪心算法中,堆可以快速找到当前的最优解
当我们想通过使用一个列表的所有元素来构建一个堆的操作叫 “建堆操作”
就是一个一个的将列表中的数据导入到堆中,然后每次导入都进行一遍 “入堆操作” 。
因为节点是从顶到底依次被添加进入二叉树中的,因此堆是 “自上而下” 的
所以在元素数量为 时,每个元素入堆时间为 ,因此建堆时间为
这种方法更高效,共分为两步:
将列表的元素添加到堆中
倒序遍历堆(即层序遍历(广度优先遍历)的倒序),然后依次对每个非叶节点进行 “从顶到底的堆化”
通过这种方法,**每当堆化一个节点时,以该节点为根节点的子树就形成了一个合法的子堆,**并且因为是倒序遍历,因此堆是 “自下而上” 的被构建的,这样就可以保证每个节点之下的子树都是合法的子堆,所以才高效。
因为叶节点没有子节点,天然就是合法的子堆,因此无需堆化,所以只需要从它的父节点开始倒序遍历即可
/* 构造方法,根据输入列表建堆 */MaxHeap(vector<int> nums) { // 将列表元素原封不动添加进堆 maxHeap = nums; // 堆化除叶节点以外的其他所有节点 for (int i = parent(size() - 1); i >= 0; i--) { siftDown(i); }}它的时间复杂度
假设完全二叉树的节点数量为 ,则叶节点数量为 ,其中 为向下整除(int 类型的除法)。因此需要堆化的节点数量为
在从顶至底堆化的过程中,每个节点最多堆化到叶节点,因此最大迭代次数为二叉树高度 。
因此时间复杂度简单计算为它们俩相乘: 但这个估算并不准确,因为二叉树底层的节点远远多于顶层节点的性质,没错,上面的计算可以作废了
以下是更准确的计算:
以完美二叉树为例,以减少计算量
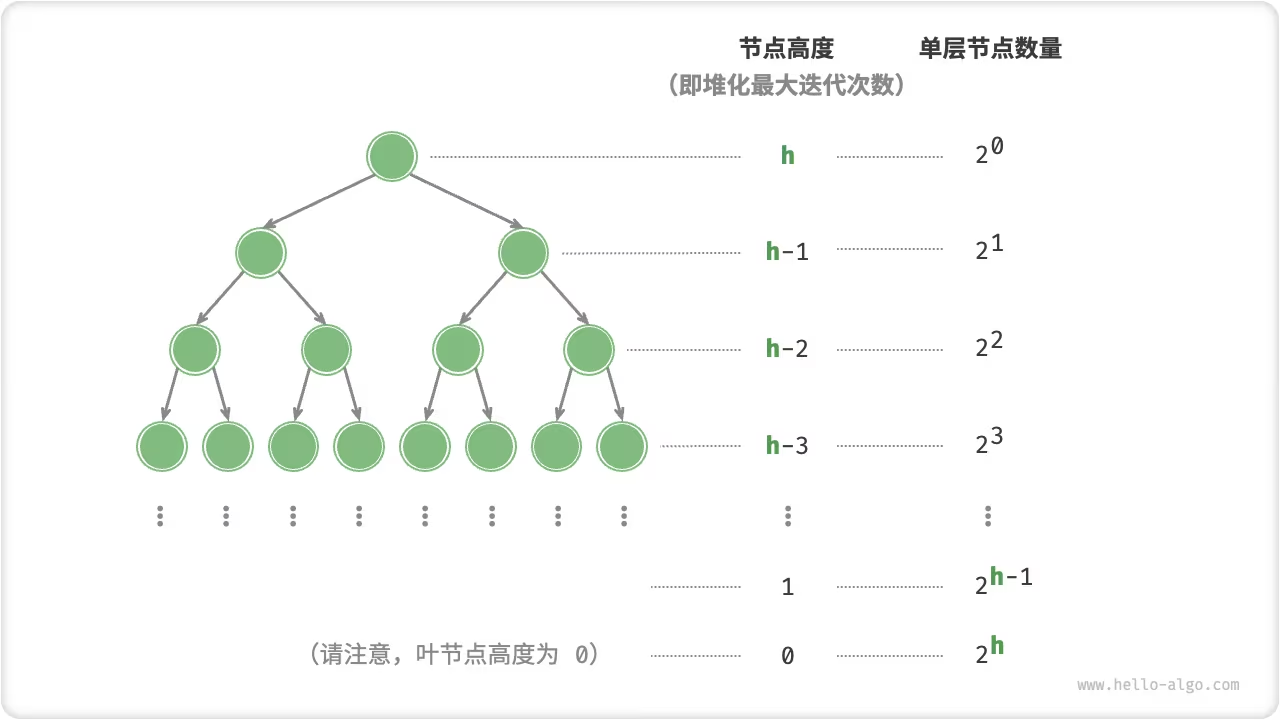
由上可知,
然后借助乘公比错位相减法,与等比数列的求和公式来化简:
又因为高度为 的完美二叉树节点数量为 ,然后两边同取 并且约分可得时间复杂度为 ,所以输入列表并建堆的时间复杂度为 ,非常高效
即上面所说的:“给定一个长度为 无序数组
nums,请返回数组中前 大的元素” 的问题
前两种方法比较直接,最后的方法效率更高
通过 轮遍历,在每轮中提取出第 大的元素,时间复杂度为
当然这只适用于 的情况,当 与 比较相近时,时间复杂度趋向于 ,和屎一样慢
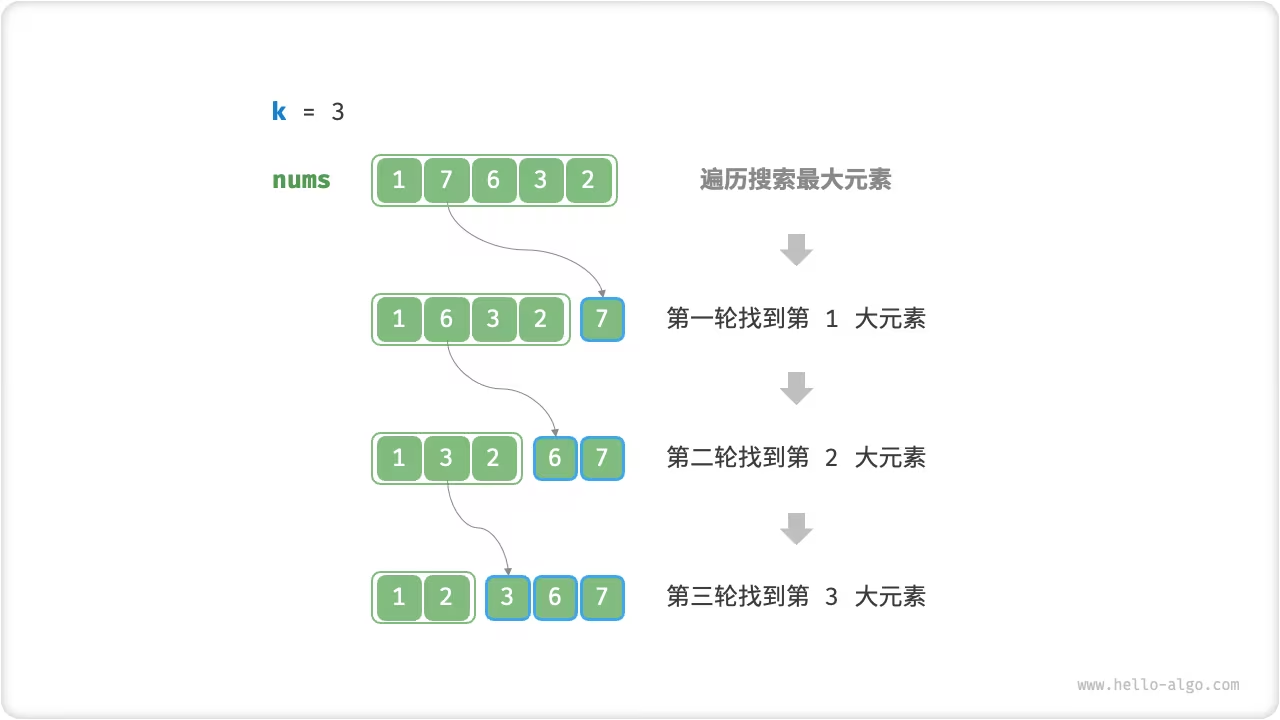
当 时,等价于 “选择排序” 算法
通过先用高效的排序方法对数组 nums 进行排序,再返回最右边的 个元素,时间复杂度为 ,优点超额完成任务了,但不太影响

又称堆选择法/堆排序法
流程如下:
【GIF】
因为执行了 轮的入堆和出堆,堆的最大长度为 ,因此时间复杂度为 ,非常高效。当 较大时,时间复杂度也不会超过 (即排序法的时间复杂度),而且相比于排序法,不额外占用空间,空间复杂度也低
并且这种方法是动态更新的,因此可以在使用动态数据流的场景
/* 基于堆查找数组中最大的 k 个元素 */priority_queue<int, vector<int>, greater<int>> topKHeap(vector<int> &nums, int k) { // 初始化小顶堆 priority_queue<int, vector<int>, greater<int>> heap; // 将数组的前 k 个元素入堆 for (int i = 0; i < k; i++) { heap.push(nums[i]); } // 从第 k+1 个元素开始,保持堆的长度为 k for (int i = k; i < nums.size(); i++) { // 若当前元素大于堆顶元素,则将堆顶元素出堆、当前元素入堆 if (nums[i] > heap.top()) { heap.pop(); heap.push(nums[i]); } } return heap;}“图”的特点是有“顶点”与“边”,与“网”有点区别,“网”是“带有权重的有向图”
「图 graph」是一种非线性数据结构,由「顶点 vertex」和「边 edge」组成
我们可以将图 抽象的表示为一组顶点 和一组边 的集合。
如果将顶点看作节点,将边看作连接各个节点的指针,我们就可以将图看作是一种从链表扩展而来的数据结构。相比于线性关系(链表)和分治关系(树),网络关系(图)的自由度更高,因此也更复杂

根据边使用有方向,可以将图分为「无向图 undirected graph」和「有向图 directed graph」
在无向图中,边表示两顶点之间的 “双向” 连接的关系,用无箭头的线来连接,如 QQ 的好友关系
在有向图中,边具有方向性,即 两个方向的边是相互独立的,当然也可以同时存在,常用带箭头的线来表示,如论坛社区中的 “关注” 与 “被关注” 关系

根据所有顶点是否连通,可分为「连通图 connected graph」和「非连通图 disconnected graph」
对于连通图,从某一个顶点出发,可以到达其余任意顶点
对于非连通图,从某个顶点出发,至少有一个顶点无法到达

通过边是否添加了 “权重” 变量,来将图分为「无权图 Unweighted Graph」「有权图 weighted graph」,比如某些手游中,系统会根据共同游戏时间来计算玩家之间的 “亲密度”,这种亲密的网络就可以用有权图来表示
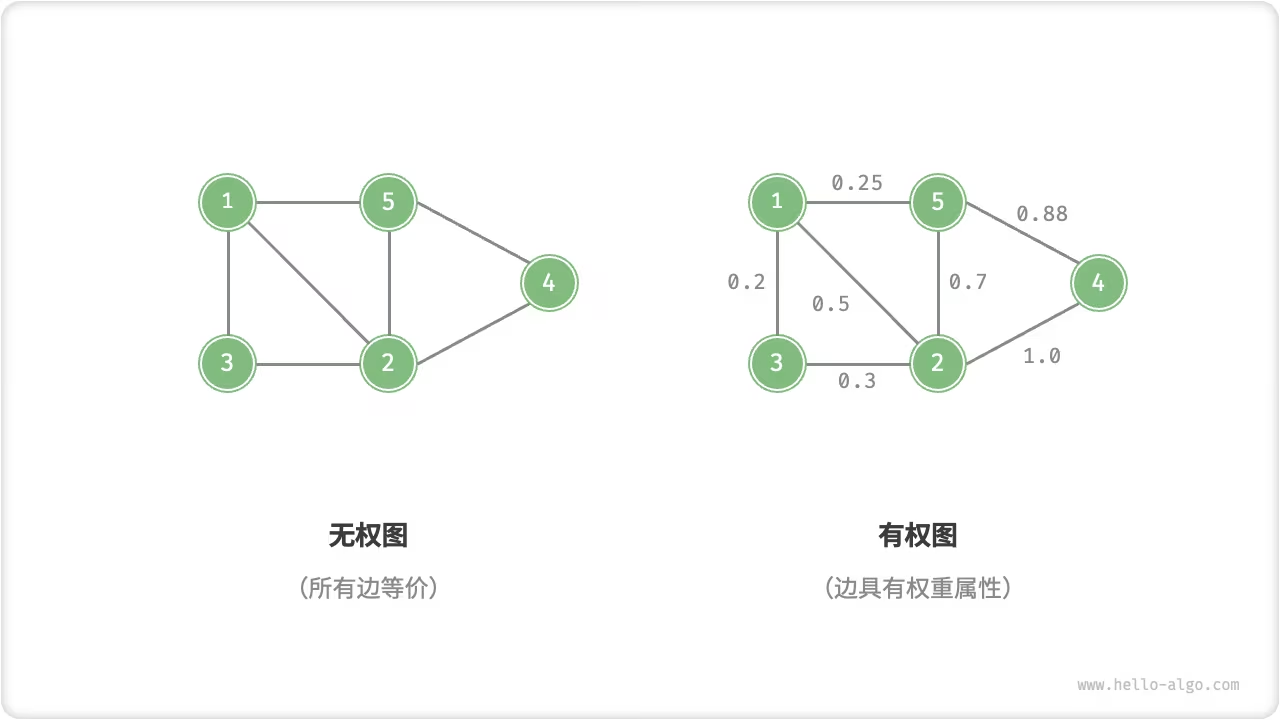
图数据结构包含以下常用的术语:
「邻接 adjacency」:当两顶点之间有边与之相连时,就叫这两顶点为 “邻接(点)”。如上图,顶点 1 的邻接顶点为顶点 2、3、5
「路径 path」:从顶点 A 到顶点 B 经过的边构成的序列被称为从 A 到 B 的 “路径” 。如上图,边序列 1-5-2-4 是顶点 1 到顶点 4 的一条路径
「度 degree」:就是一个顶点拥有的边数。对于有向图「入度 in-degree」表示有多少条边指向该顶点,「出度 out-degree」表示有多少天表从该节点出发(指出)
主要有 “邻接矩阵” 和 “邻接表” 这两种,以下对这两种都使无向图来举例
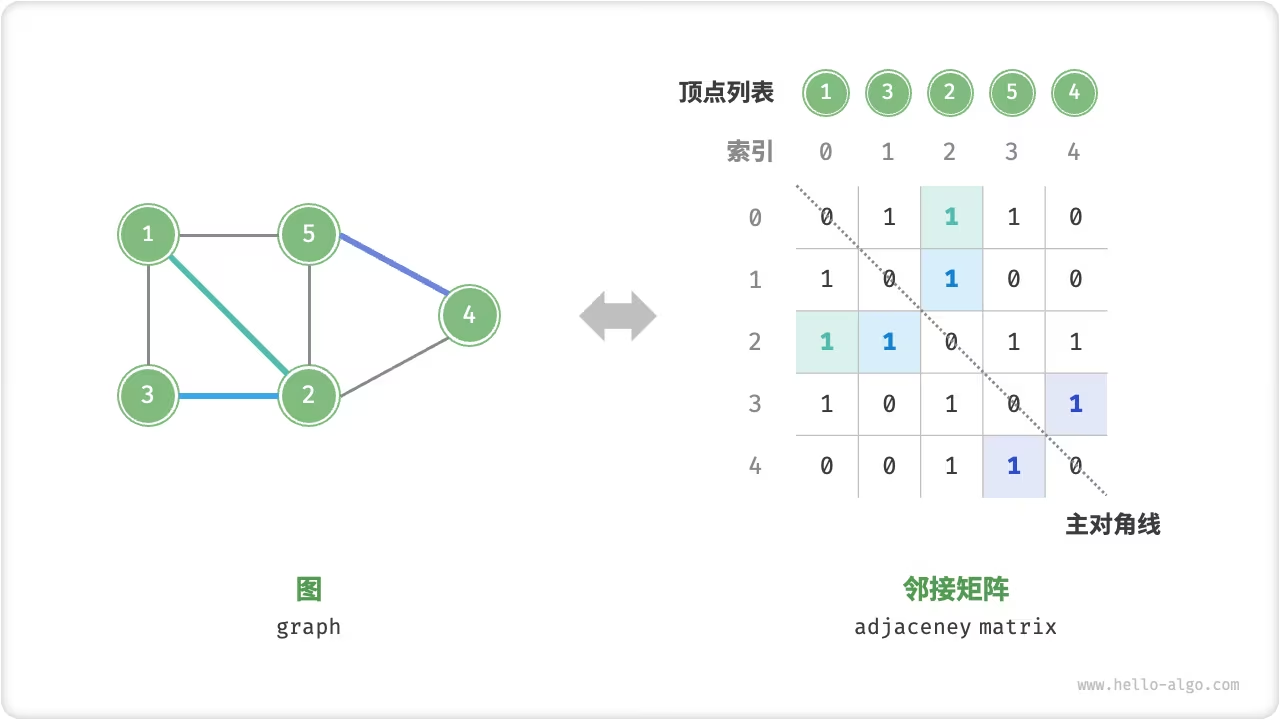
如上图,图的顶点数量为 ,「邻接矩阵 adjacency matrix」使用一个 大小的矩阵(二维数组)来表示图,每一行/列都表示一个顶点,矩阵中的元素表示边,并用 或 来表示两个顶点之间是否存在边。
有向图的话,边(元素)就不是按对角线对称的了
设邻接矩阵为 、顶点列表为 ,则矩阵元素 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 2: M\̲[̲i, j] = 1 表示顶点 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 2: V\̲[̲i] 到顶点 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 2: V\̲[̲j] 之间存在边,反之 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 2: M\̲[̲i, j] = 0 表示两顶点之间无边
邻接矩阵有以下特性:
因为顶点不能与自身相连,因此邻接矩阵主对角线没有意义
对于无向图,两个方向的边等价,此时邻接矩阵关于主对角线对称。
将邻接矩阵的元素从 和 替换为权重,则可表示有权图。
它的优点是可以通过直接访问矩阵元素以获取边,因此增删查操作的效率很高,时间复杂度为 ,但缺点是空间复杂度较高,为
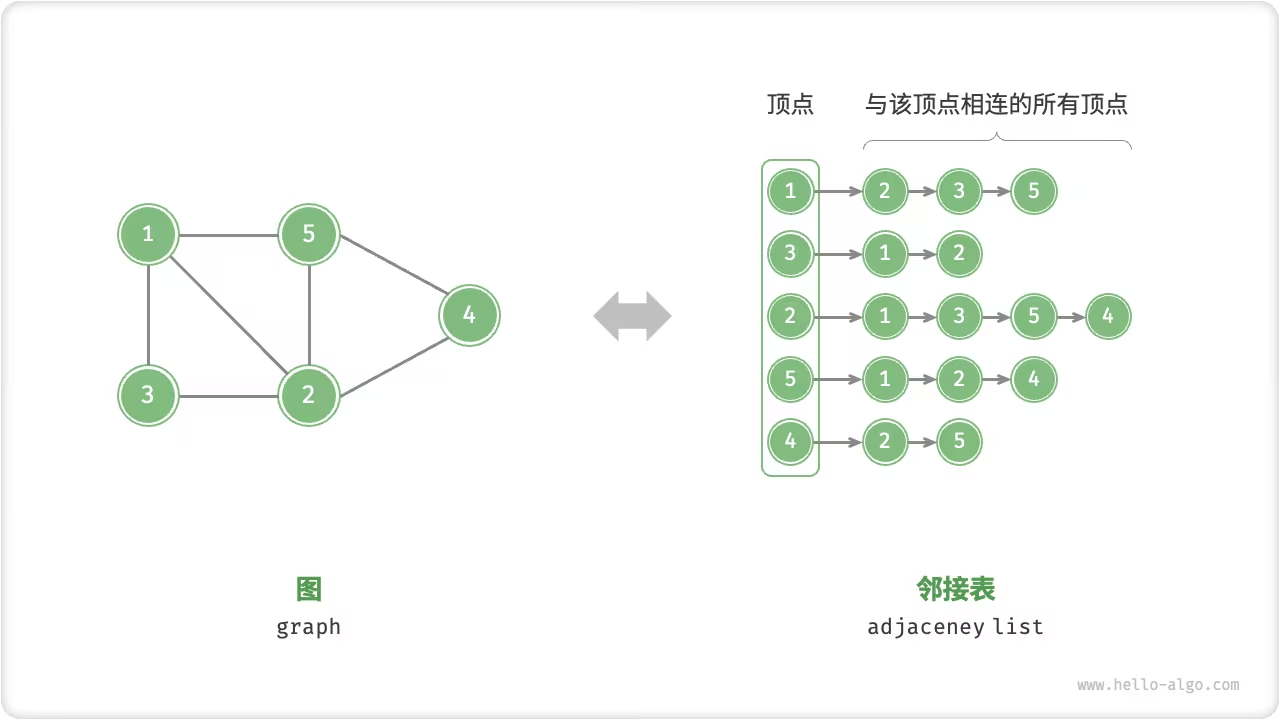
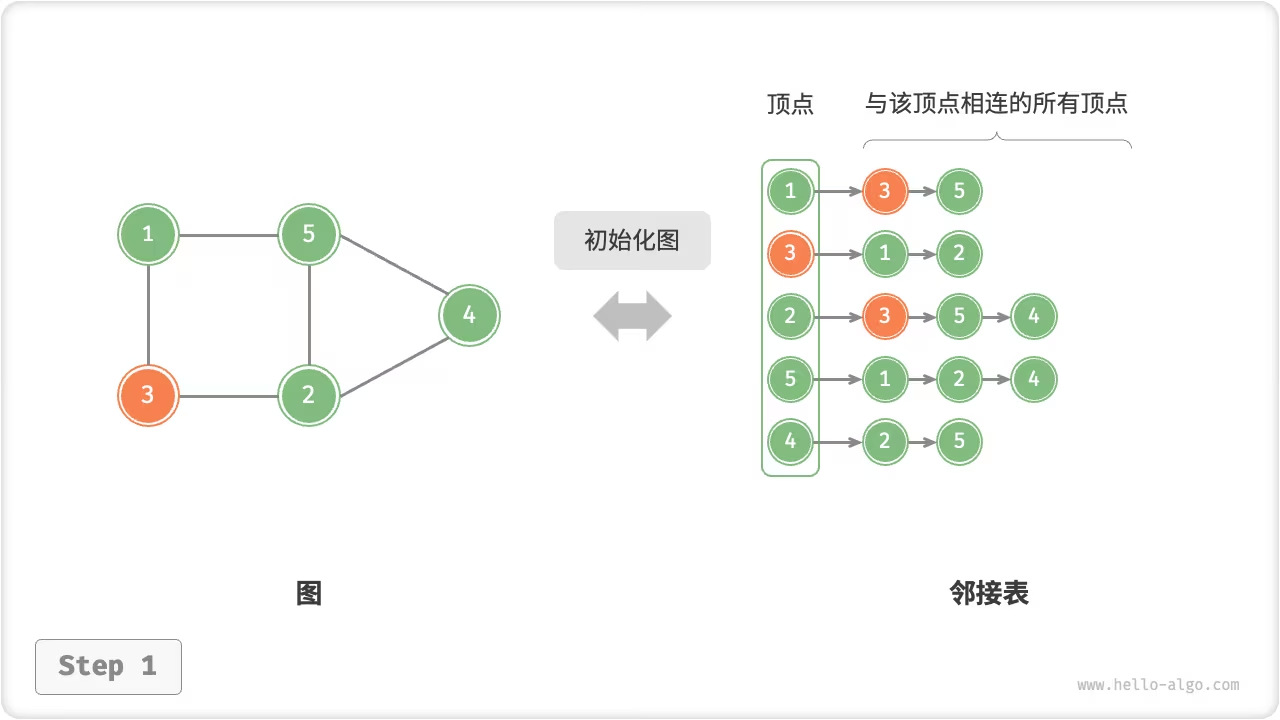
「邻接表 adjacency list」通过使用 个链表来表示图,链表节点为图的顶点,第 条链表对应顶点 ,其中存储了该顶点的所有邻接顶点(即与该顶点相连的顶点
因为邻接表仅存储实际存在的边,而一般情况下, 的,因此它更加节省空间,但他需要通过遍历链表来查找边,因此其时间效率不如邻接矩阵
但是,仔细看上图,可以发现,邻接表的结构有点像哈希表中的“链式地址”,因此我们可以通过类似的方法来优化效率,比如当链表(这里指上图的横着的一排(一个链表))较长时,可以将它转化为 AVL 树或红黑树,从而将时间效率从 优化到 ,还可以将链表再次转化成哈希表,从而将时间复杂度降低到
许多现实系统都可以用图来建模,相应的问题也可以转化为图的计算问题
现实生活中:
| 顶点 | 边 | 图计算问题 | |
|---|---|---|---|
| 社交网络 | 用户 | 好友关系 | 潜在好友推荐 |
| 地铁线路 | 站点 | 站点间的连通性 | 最短路线推荐 |
| 太阳系 | 星体 | 星体间的万有引力作用 | 行星轨道计算 |
计算机中:
| 顶点 | 边 | 图计算问题 | |
|---|---|---|---|
| 搜索引擎 | 网页 | 网页链接关系 | 页面排名、相关性分析 |
| 人工智能和机器学习 | 关键点 | 关键点之间的联系 | 神经网络 |
| 电路设计和芯片布局 | 电子元件 | 连接线路 | 电路优化、芯片布局规划 |
| 图像处理和计算机视觉 | 像素 | 图像的像素关系 | 图像分割、目标识别 |
| 编译器和解释器 | 各个语句和表达式等 | 它们之间的关系 | 优化代码并编译等 |
就是对图的两部分 “边” 和 “顶点” 的操作,在 “邻接矩阵” 和 “邻接表” 中的实现方法不同
对于一个定点数量为 的无向图:
初始化:
传入 的顶点,初始化一个顶点列表 vectices 需要 的时间(只初始化点,不初始化边的情况)
然后再初始化 3 大小的邻接矩阵 adjMat 使用 的时间
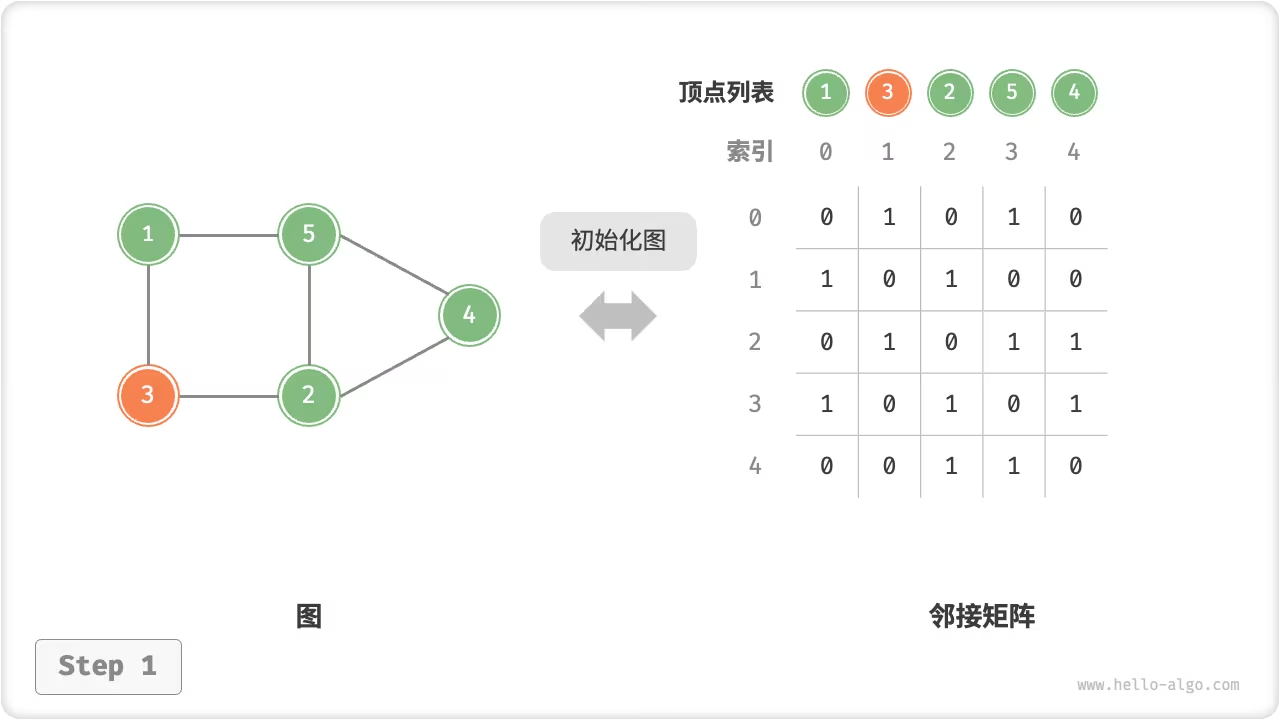
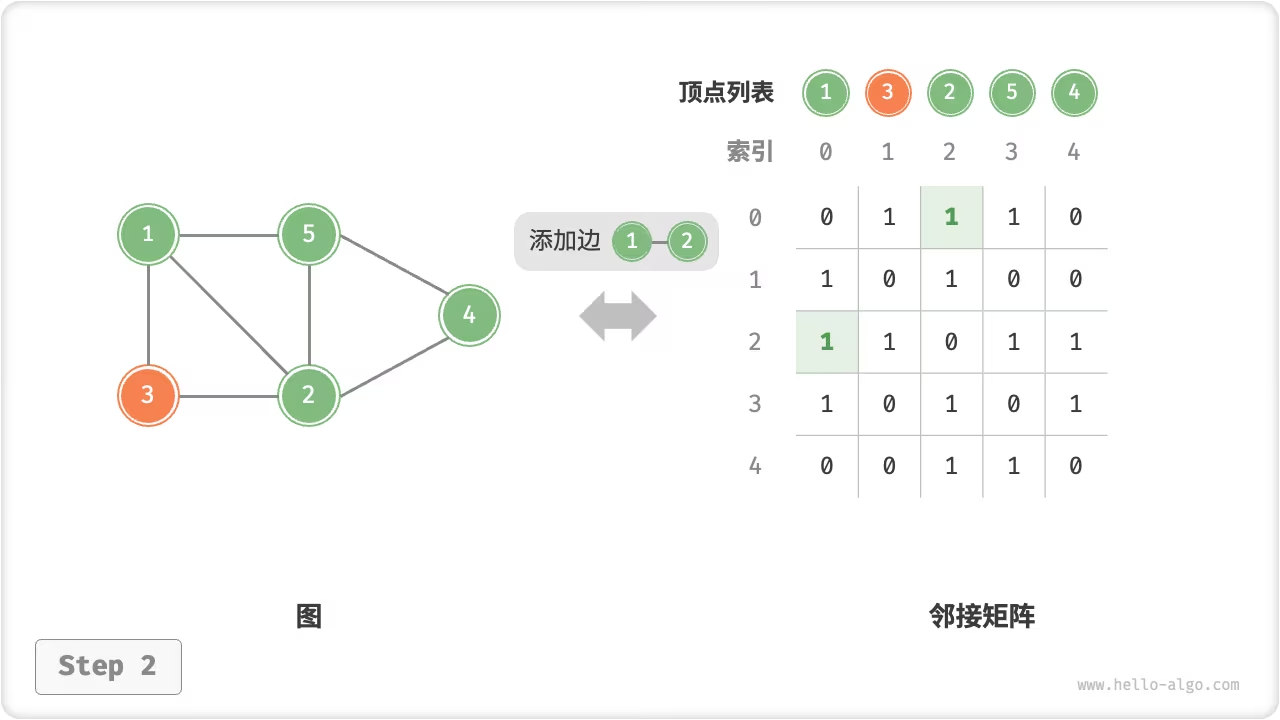
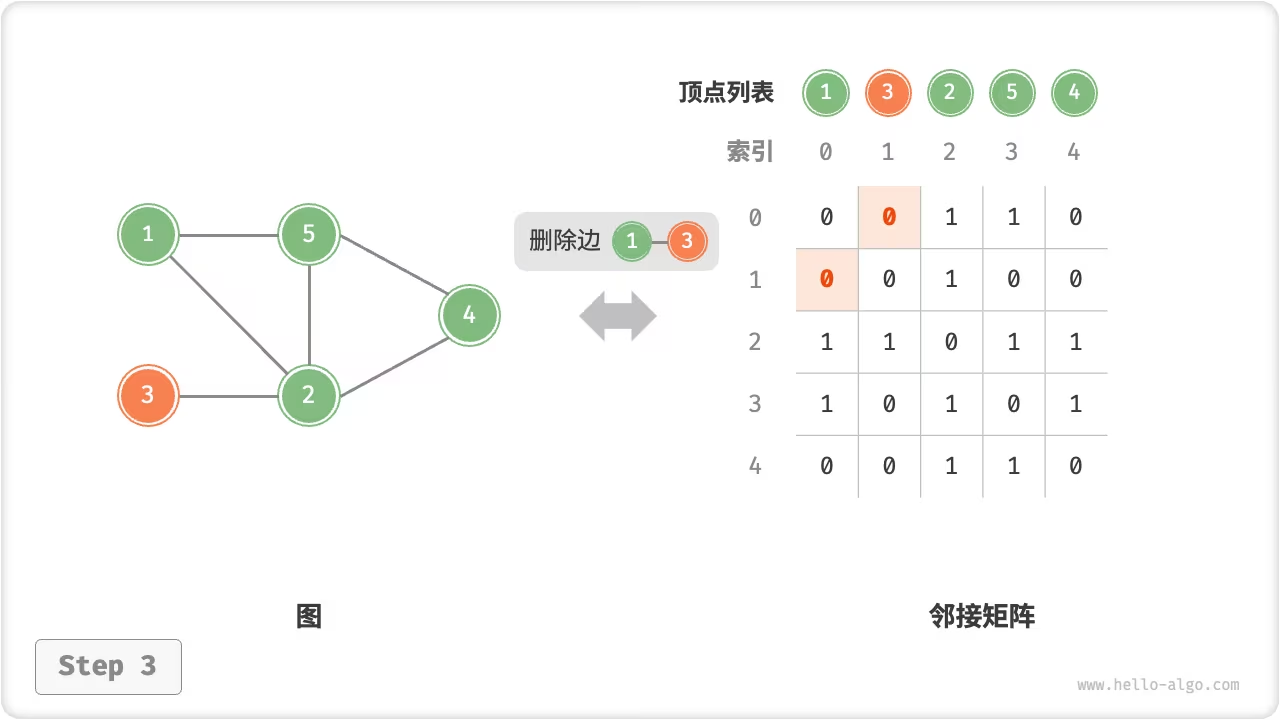
**添加或删除边:**直接在邻接矩阵中修改指定的边即可,使用 的时间,若是无向图,则需要同时更新两个方向的边
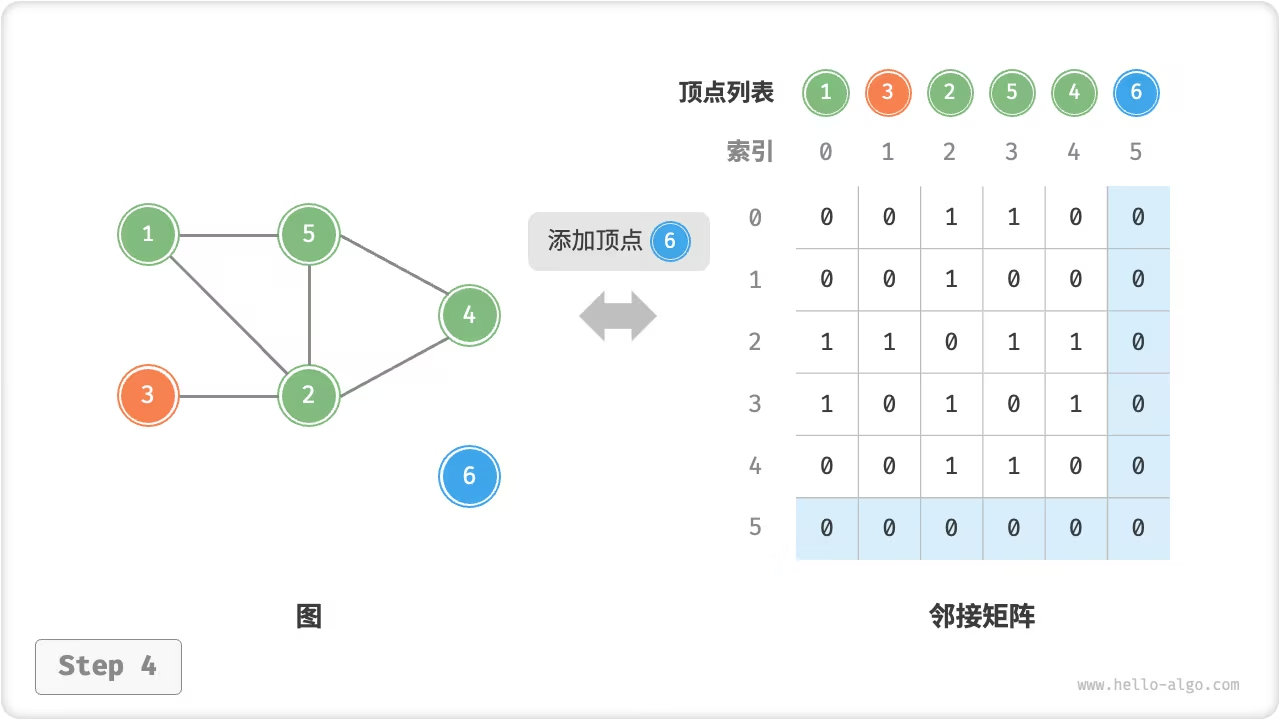
**添加顶点:**在邻接矩阵的尾部添加一行一列,并全部填 即可,使用 的时间
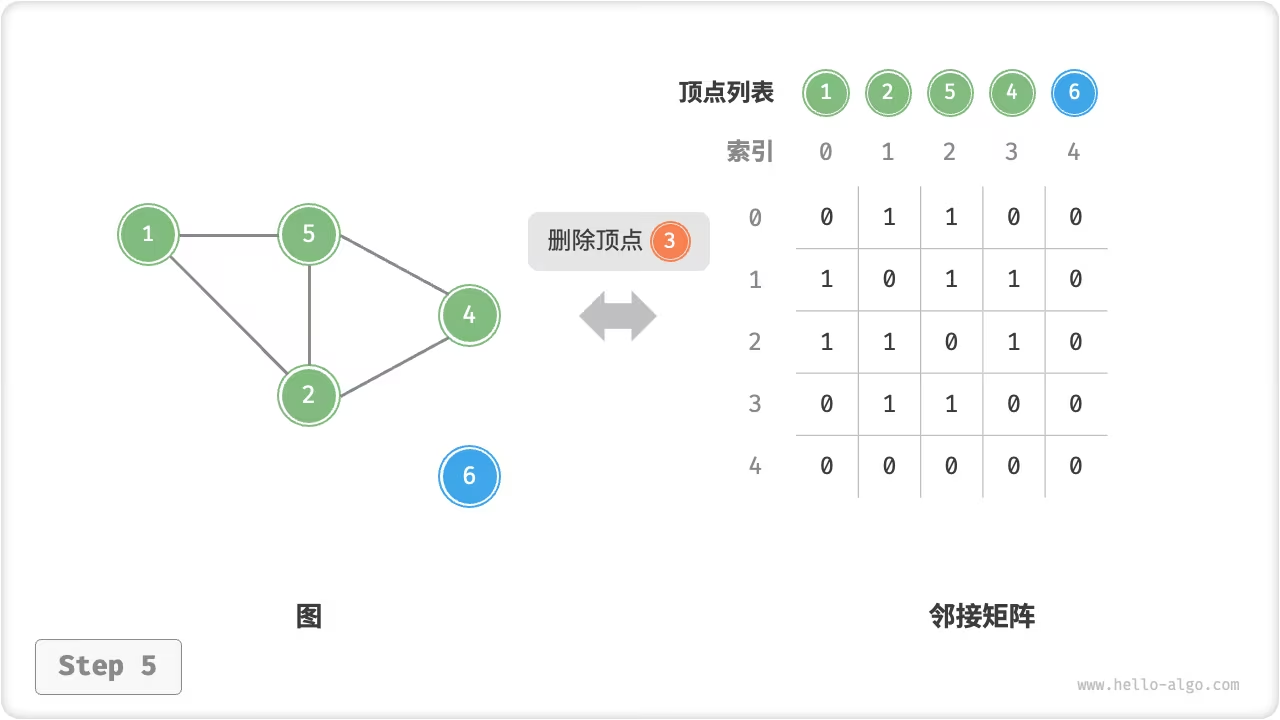
**删除顶点:**在邻接矩阵中删除一行一列,因为删除后还要将它后面的左上移动,若是出现了删除首行首列这样的最差的情况,需要将 个元素移动,使用 的时间
/* 基于邻接矩阵实现的无向图类 */class GraphAdjMat { vector<int> vertices; // 顶点列表,元素代表“顶点值”,索引代表“顶点索引” vector<vector<int>> adjMat; // 邻接矩阵,行列索引对应“顶点索引” public: /* 构造方法 */ GraphAdjMat(const vector<int> &vertices, const vector<vector<int>> &edges) { // 添加顶点 for (int val : vertices) { addVertex(val); } // 添加边 // 请注意,edges 元素代表顶点索引,即对应 vertices 元素索引 for (const vector<int> &edge : edges) { addEdge(edge[0], edge[1]); } } /* 获取顶点数量 */ int size() const { return vertices.size(); } /* 添加顶点 */ void addVertex(int val) { int n = size(); // 向顶点列表中添加新顶点的值 vertices.push_back(val); // 在邻接矩阵中添加一行 adjMat.emplace_back(vector<int>(n, 0)); // 在邻接矩阵中添加一列 for (vector<int> &row : adjMat) { row.push_back(0); } } /* 删除顶点 */ void removeVertex(int index) { if (index >= size()) { throw out_of_range("顶点不存在"); } // 在顶点列表中移除索引 index 的顶点 vertices.erase(vertices.begin() + index); // 在邻接矩阵中删除索引 index 的行 adjMat.erase(adjMat.begin() + index); // 在邻接矩阵中删除索引 index 的列 for (vector<int> &row : adjMat) { row.erase(row.begin() + index); } } /* 添加边 */ // 参数 i, j 对应 vertices 元素索引 void addEdge(int i, int j) { // 索引越界与相等处理 if (i < 0 || j < 0 || i >= size() || j >= size() || i == j) { throw out_of_range("顶点不存在"); } // 在无向图中,邻接矩阵沿主对角线对称,即满足 (i, j) == (j, i) adjMat[i][j] = 1; adjMat[j][i] = 1; } /* 删除边 */ // 参数 i, j 对应 vertices 元素索引 void removeEdge(int i, int j) { // 索引越界与相等处理 if (i < 0 || j < 0 || i >= size() || j >= size() || i == j) { throw out_of_range("顶点不存在"); } adjMat[i][j] = 0; adjMat[j][i] = 0; } /* 打印邻接矩阵 */ void print() { cout << "顶点列表 = "; printVector(vertices); cout << "邻接矩阵 =" << endl; printVectorMatrix(adjMat); }};假设无向图的顶点总数为 ,边总数为 ,则:
**初始化:**在邻接表常见 个顶点和 条边(),使用 的时间
**添加边:**在顶点对应链表的末尾添加边即可,使用 的时间。在无向图,需要同时添加两个方向的边
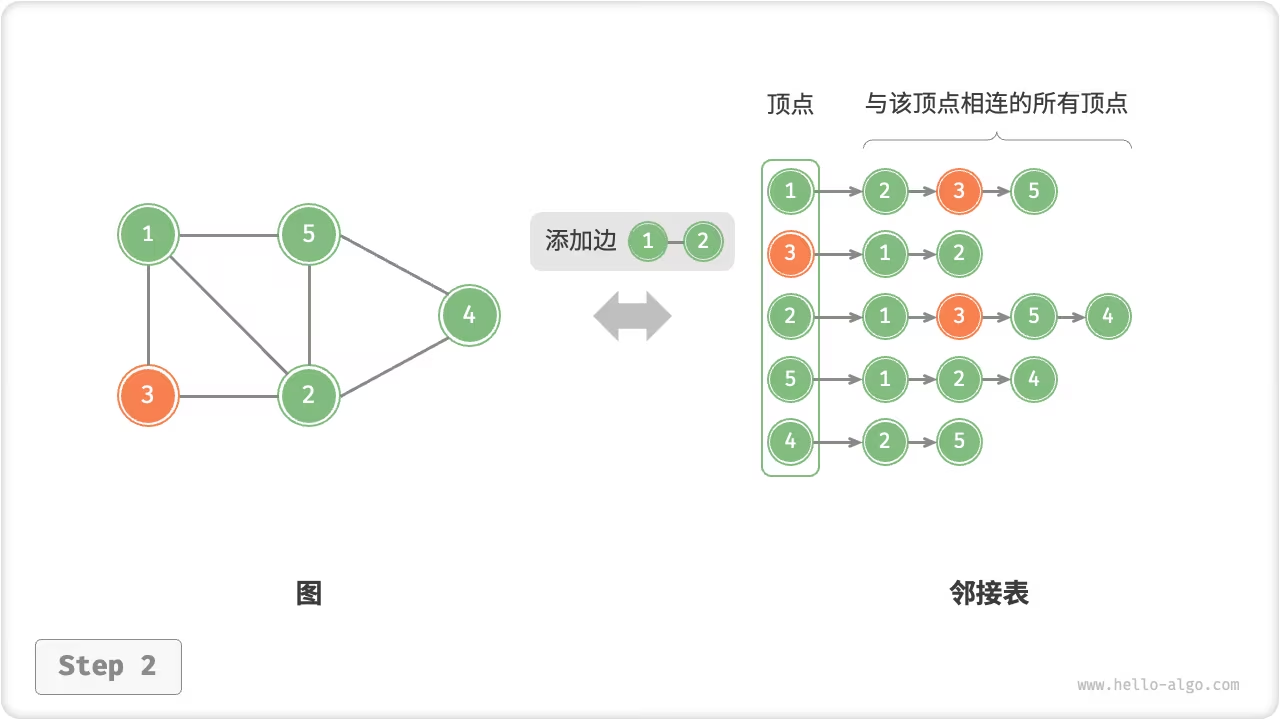
**删除边:**查找顶点对应的链表(就是遍历所有边,共 个)并删除指定边,使用 的时间。在无向图,需要同时添加两个方向的边
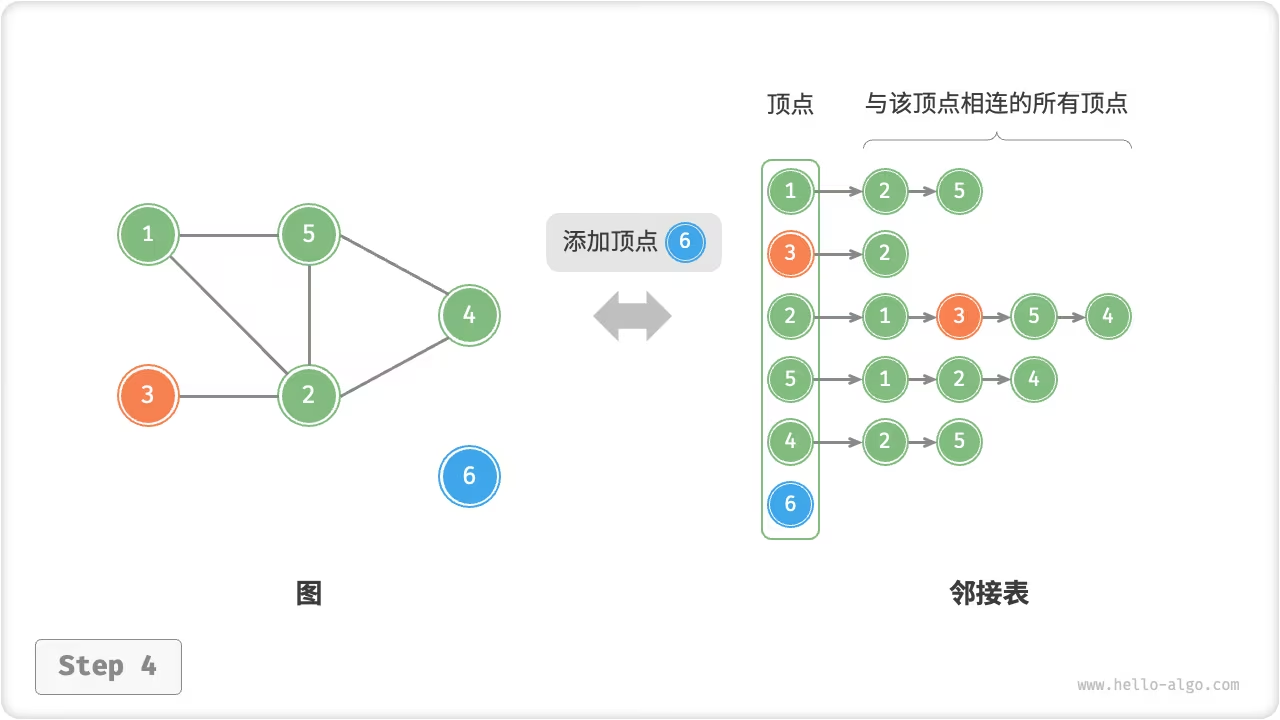
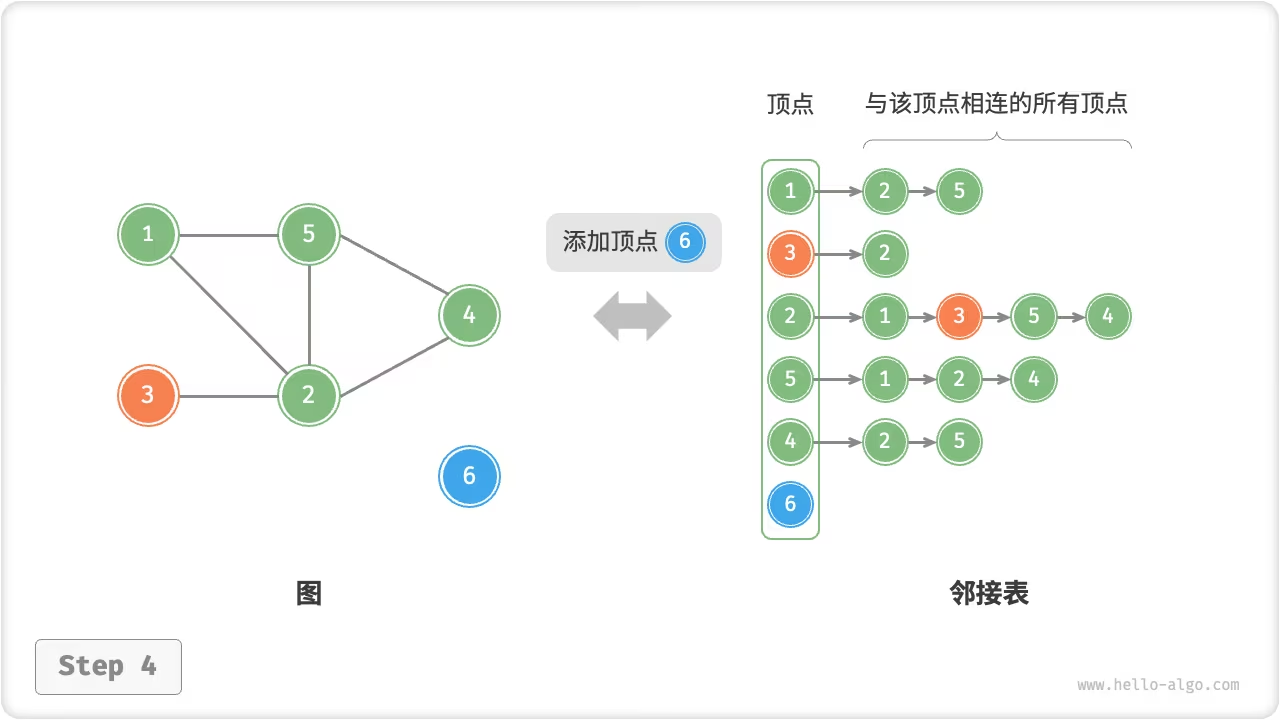
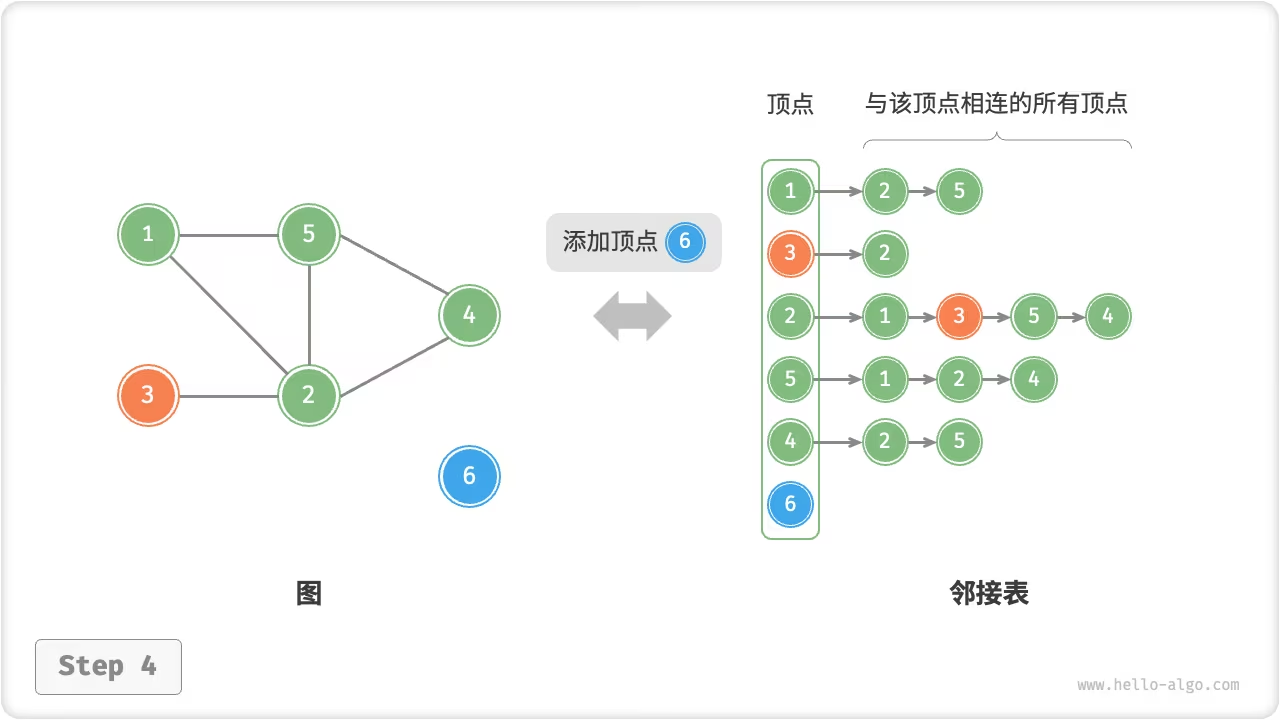
**添加顶点:**再添加一个以该顶点为头节点的链表即可,使用 时间
**删除顶点:**要删除顶点本身和它所连接的所有的边,使用 的时间, 为整个邻接表的节点的数量
以下为代码:
其中为了方便的删除添加顶点,并简化以下代码,我们使用动态数组来替代链表
并使用哈希表来存储邻接表,以key 为顶点实例,value 为该顶点的邻接顶点列表(链表)
另外,我们在邻接表中使用 Vertex 类来表示顶点,这样做的原因是:如果与邻接矩阵一样,用列表索引来区分不同顶点,那么假设要删除索引为 的顶点,则需遍历整个邻接表,将所有大于 的索引全部减 ,效率很低。而如果每个顶点都是唯一的 Vertex 实例,删除某一顶点之后就无须改动其他顶点了。
/* 基于邻接表实现的无向图类 */class GraphAdjList { public: // 邻接表,key: 顶点,value:该顶点的所有邻接顶点 unordered_map<Vertex *, vector<Vertex *>> adjList; /* 在 vector 中删除指定节点 */ void remove(vector<Vertex *> &vec, Vertex *vet) { for (int i = 0; i < vec.size(); i++) { if (vec[i] == vet) { vec.erase(vec.begin() + i); break; } } } /* 构造方法 */ GraphAdjList(const vector<vector<Vertex *>> &edges) { // 添加所有顶点和边 for (const vector<Vertex *> &edge : edges) { addVertex(edge[0]); addVertex(edge[1]); addEdge(edge[0], edge[1]); } } /* 获取顶点数量 */ int size() { return adjList.size(); } /* 添加边 */ void addEdge(Vertex *vet1, Vertex *vet2) { if (!adjList.count(vet1) || !adjList.count(vet2) || vet1 == vet2) throw invalid_argument("不存在顶点"); // 添加边 vet1 - vet2 adjList[vet1].push_back(vet2); adjList[vet2].push_back(vet1); } /* 删除边 */ void removeEdge(Vertex *vet1, Vertex *vet2) { if (!adjList.count(vet1) || !adjList.count(vet2) || vet1 == vet2) throw invalid_argument("不存在顶点"); // 删除边 vet1 - vet2 remove(adjList[vet1], vet2); remove(adjList[vet2], vet1); } /* 添加顶点 */ void addVertex(Vertex *vet) { if (adjList.count(vet)) return; // 在邻接表中添加一个新链表 adjList[vet] = vector<Vertex *>(); } /* 删除顶点 */ void removeVertex(Vertex *vet) { if (!adjList.count(vet)) throw invalid_argument("不存在顶点"); // 在邻接表中删除顶点 vet 对应的链表 adjList.erase(vet); // 遍历其他顶点的链表,删除所有包含 vet 的边 for (auto &adj : adjList) { remove(adj.second, vet); } } /* 打印邻接表 */ void print() { cout << "邻接表 =" << endl; for (auto &adj : adjList) { const auto &key = adj.first; const auto &vec = adj.second; cout << key->val << ": "; printVector(vetsToVals(vec)); } }};图中共有 个顶点和 条边,如下:
| 邻接矩阵 | 邻接表(链表) | 邻接表(哈希表) | |
|---|---|---|---|
| 判断是否邻接 | |||
| 添加边 | |||
| 删除边 | |||
| 添加顶点 | |||
| 删除顶点 | |||
| 内存空间占用 |
时间空间复杂度如上,看上去第三种的时间与空间效率最优,但实际上效率复杂度,因此邻接矩阵的效率最高,只用访问一次数组并赋值就可了。
总的来说,邻接矩阵体现了“以空间换时间”的原则,而邻接表体现了“以时间换空间”的原则。
树是 “一对多”,而图是 “多对多”,因此我们可以把树看作是图的一种特例,树的遍历操作也是图的一种特例
图的遍历也和树一样分为两种:「广度优先遍历 breadth-first traversal」和「深度优先遍历 depth-first traversal」。它们也被称为:「广度优先搜索 breadth-first search」和「深度优先搜索 depth-first search」,简称 BFS 和 DFS 。
广度优先遍历是一种由近到远的遍历方式,从某个节点出发,始终优先访问距离最近的顶点,并一层层的向外扩张。
以如下图的遍历方法

/* 广度优先遍历 BFS */// 使用邻接表来表示图,以便获取指定顶点的所有邻接顶点vector<Vertex *> graphBFS(GraphAdjList &graph, Vertex *startVet) { // 顶点遍历序列 vector<Vertex *> res; // 哈希表,用于记录已被访问过的顶点 unordered_set<Vertex *> visited = {startVet}; // 队列用于实现 BFS queue<Vertex *> que; que.push(startVet); // 以顶点 vet 为起点,循环直至访问完所有顶点 while (!que.empty()) { Vertex *vet = que.front(); que.pop(); // 队首顶点出队 res.push_back(vet); // 记录访问顶点 // 遍历该顶点的所有邻接顶点 for (auto adjVet : graph.adjList[vet]) { if (visited.count(adjVet)) continue; // 跳过已被访问过的顶点 que.push(adjVet); // 只入队未访问的顶点 visited.emplace(adjVet); // 标记该顶点已被访问 } } // 返回顶点遍历序列 return res;} /* Driver Code */int main() { /* 初始化无向图 */ vector<Vertex *> v = valsToVets({0, 1, 2, 3, 4, 5, 6, 7, 8, 9}); vector<vector<Vertex *>> edges = {{v[0], v[1]}, {v[0], v[3]}, {v[1], v[2]}, {v[1], v[4]}, {v[2], v[5]}, {v[3], v[4]}, {v[3], v[6]}, {v[4], v[5]}, {v[4], v[7]}, {v[5], v[8]}, {v[6], v[7]}, {v[7], v[8]}}; GraphAdjList graph(edges); cout << "\n初始化后,图为\\n"; graph.print(); /* 广度优先遍历 BFS */ vector<Vertex *> res = graphBFS(graph, v[0]); cout << "\n广度优先遍历(BFS)顶点序列为" << endl; printVector(vetsToVals(res)); // 释放内存 for (Vertex *vet : v) { delete vet; } return 0;}如下图:
【GIF】
广度优先遍历只要求按“由近及远”的顺序遍历,而多个相同距离的顶点的遍历顺序是允许被任意打乱的。如上图,顶点 1、3 的访问顺序可以交换、顶点 2、4、6 的访问顺序也可以任意交换。
**时间复杂度:**有顶点都会入队并出队一次,使用 时间;在遍历邻接顶点的过程中,由于是无向图,因此所有边都会被访问 次,使用 时间;总体使用 时间。
空间复杂度: 列表 res ,哈希表 visited ,队列 que 中的顶点数量最多为 ,使用 空间。
深度优先遍历是一种优先走到底、无路可走再回头的遍历方式。
如下图,从左上角顶点出发,访问当前顶点的某个邻接顶点,直到走到尽头时返回,再继续走到尽头并返回,以此类推,直至所有顶点遍历完成。

这种“走到尽头再返回”的算法范式和递归的思维相似,所有通常使用递归来实现,与广度优先遍历类似,在深度优先遍历中我们也需要借助一个哈希表 visited 来记录已被访问的顶点,以避免重复访问顶点。
/* 深度优先遍历 DFS 辅助函数 */void dfs(GraphAdjList &graph, unordered_set<Vertex *> &visited, vector<Vertex *> &res, Vertex *vet) { res.push_back(vet); // 记录访问顶点 visited.emplace(vet); // 标记该顶点已被访问 // 遍历该顶点的所有邻接顶点 for (Vertex *adjVet : graph.adjList[vet]) { if (visited.count(adjVet)) continue; // 跳过已被访问过的顶点 // 递归访问邻接顶点 dfs(graph, visited, res, adjVet); }} /* 深度优先遍历 DFS */// 使用邻接表来表示图,以便获取指定顶点的所有邻接顶点vector<Vertex *> graphDFS(GraphAdjList &graph, Vertex *startVet) { // 顶点遍历序列 vector<Vertex *> res; // 哈希表,用于记录已被访问过的顶点 unordered_set<Vertex *> visited; dfs(graph, visited, res, startVet); return res;} /* Driver Code */int main() { /* 初始化无向图 */ vector<Vertex *> v = valsToVets(vector<int>{0, 1, 2, 3, 4, 5, 6}); vector<vector<Vertex *>> edges = {{v[0], v[1]}, {v[0], v[3]}, {v[1], v[2]}, {v[2], v[5]}, {v[4], v[5]}, {v[5], v[6]}}; GraphAdjList graph(edges); cout << "\n初始化后,图为" << endl; graph.print(); /* 深度优先遍历 DFS */ vector<Vertex *> res = graphDFS(graph, v[0]); cout << "\n深度优先遍历(DFS)顶点序列为" << endl; printVector(vetsToVals(res)); // 释放内存 for (Vertex *vet : v) { delete vet; } return 0;}流程如下所示:
直虚线代表向下递推,表示开启了一个新的递归方法来访问新顶点。
曲虚线代表向上回溯,表示此递归方法已经返回,回溯到了开启此递归方法的位置。
【GIF】
与广度优先遍历类似,深度优先遍历序列的顺序也不是唯一的。给定某顶点,先往哪个方向探索都可以,即邻接顶点的顺序可以任意打乱,都是深度优先遍历。
以树的遍历为例,“根 → 左 → 右”、“左 → 根 → 右”、“左 → 右 → 根”分别对应前序、中序、后序遍历,它们展示了三种不同的遍历优先级,然而这三者都属于深度优先遍历。
时间复杂度: 所有顶点都会被访问 次,使用 时间;所有边都会被访问 次,使用 时间;总体使用 时间。
空间复杂度: 列表 res ,哈希表 visited 顶点数量最多为 ,递归深度最大为 ,因此使用 空间。
没错,和广度优先遍历的是一样的
就是要快速找到目标
「二分查找 binary search」是一种基于分治策略的高效搜索算法,它利用数据的有序性,每轮减少一半的搜索范围,直到找到目标元素或搜索区间为空为止
Q:给定一个长度为 的数组
nums,元素按从小到大的顺序排列,数组不包含重复元素。请查找并返回元素target在该数组中的索引。若数组不包含该元素,则返回 。

如下图所示,我们先初始化指针 和 ,分别指向数组的首元素和尾元素,代表搜索区间 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲0,n-1] (注意这是闭区间)
然后开始循环。
计算中点索引 ,其中 表示 floor() 向下取整,当然,int 类型本身就是向下取整的
然后判断数组 nums[m] 和目标元素 target 的大小关系,分为三种情况
a. 当 nums[m] < target 时,说明 target 在区间 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲m+1,j] 中,因此执行
b. 当 nums[m] > target 时,说明 target 在区间 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i,m-1] 中,因此执行
c.当 nums[m] = target 时,说明找到了 target ,因此返回索引
若数组中不包含目标元素,搜索区间最终会缩小为空,此时返回
【GIF】
因为 和 都是 int 类型,**因此 可能会超过 int 类型的取值范围。 为了避免大数越界,我们常用公式 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: m=\̲[̲i+(j-i)/2] 来计算中点,**而非使用 来计算中点
/* 二分查找(双闭区间) */int binarySearch(vector<int> &nums, int target) { // 初始化双闭区间 [0, n-1] ,即 i, j 分别指向数组首元素、尾元素 int i = 0, j = nums.size() - 1; // 循环,当搜索区间为空时跳出(当 i > j 时为空) while (i <= j) { int m = i + (j - i) / 2; // 计算中点索引 m if (nums[m] < target) // 此情况说明 target 在区间 [m+1, j] 中 i = m + 1; else if (nums[m] > target) // 此情况说明 target 在区间 [i, m-1] 中 j = m - 1; else // 找到目标元素,返回其索引 return m; } // 未找到目标元素,返回 -1 return -1;}**时间复杂度 :**在二分循环中,区间每轮缩小一半,循环次数为
**空间复杂度 :**指针 和 使用常数大小的空间
除了上面所说的上闭区间,常见的区间还有 “左闭右开” 区间,定义为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲0,n) ,在该表示下,区间 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i,j] 在 时为空
/* 二分查找(左闭右开) */int binarySearchLCRO(vector<int> &nums, int target) { // 初始化左闭右开 [0, n) ,即 i, j 分别指向数组首元素、尾元素+1 int i = 0, j = nums.size(); // 循环,当搜索区间为空时跳出(当 i = j 时为空) while (i < j) { int m = i + (j - i) / 2; // 计算中点索引 m if (nums[m] < target) // 此情况说明 target 在区间 [m+1, j) 中 i = m + 1; else if (nums[m] > target) // 此情况说明 target 在区间 [i, m) 中 j = m; else // 找到目标元素,返回其索引 return m; } // 未找到目标元素,返回 -1 return -1;}如下图所示,因为这两种区间不同,因此在算法中,它们的初始化、循环条件和缩小区间的操作都有所不同
因为 “双闭区间” 表示中左右区间都是闭区间,因此指针 和 缩小区间操作也是对称的,这样就不容易出错,因此一半建议采用 “双闭区间” 的写法

优点:
时间效率高,数据越大越高,这也是 的特点
空间效率也高,不占用额外的空间
缺点:
只适用于数组,因为要跳跃式(非连续地)访问元素
只适用于有序的数据,否则要先排序,先排完再线性或二分查找的时间复杂度都高于之间线性查找的
小数据量时,还不如线性查找
二分查找不仅可以用于查找目标元素,还可以用于其他问题,比如查找目标元素的插入位置/要插入的位置
给定一个长度为 的有序数组
nums和一个元素target,数组不存在重复元素。现将target插入到数组nums中,并保持其有序性。若数组中已存在元素target,则插入到其左方。请返回插入后target在数组中的索引。

当数组包含 target 时,插入点的索引就是该 target 的索引。
当数组中不存在
target时,插入点是哪个元素的索引?
进一步思考二分查找过程:当 nums[m] < target 时 移动,这意味着指针 在向大于等于 target 的元素靠近。同理,指针 始终在向小于等于 target 的元素靠近。
因此二分结束时一定有: 指向首个大于 target 的元素, 指向首个小于 target 的元素。
易得当数组不包含 target 时,插入索引为 。
/* 二分查找插入点(无重复元素) */int binarySearchInsertionSimple(vector<int> &nums, int target) { int i = 0, j = nums.size() - 1; // 初始化双闭区间 [0, n-1] while (i <= j) { int m = i + (j - i) / 2; // 计算中点索引 m if (nums[m] < target) { i = m + 1; // target 在区间 [m+1, j] 中 } else if (nums[m] > target) { j = m - 1; // target 在区间 [i, m-1] 中 } else { return m; // 找到 target ,返回插入点 m } } // 未找到 target ,返回插入点 i return i;}在上一题的基础上,规定数组可能包含重复元素,其余不变。
假设数组中存在多个 target ,则普通二分查找只能返回其中一个 target 的索引,而无法确定该元素的左边和右边还有多少 target。
题目要求将目标元素插入到最左边,所以我们需要查找数组中最左一个 target 的索引。初步考虑通过图 10-5 所示的步骤实现。
target 的索引,记为 。target 时返回。
这方法简单易懂,但包含线性查找,因此时间复杂度为 。当数组中存在很多重复的 target 时,该方法效率很低。
现考虑拓展二分查找代码。如图 10-6 所示,整体流程保持不变,每轮先计算中点索引 ,再判断 target 和 nums[m] 大小关系,分为以下几种情况。
当 nums[m] < target 或 nums[m] > target 时,说明还没有找到 target ,因此采用普通二分查找的缩小区间操作,从而使指针 和 向 target 靠近。
当 nums[m] == target 时,说明小于 target 的元素在区间 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i,j−1] 中,因此采用 来缩小区间,从而使指针 向小于 target 的元素靠近。
【GIF】
/* 二分查找插入点(存在重复元素) */int binarySearchInsertion(vector<int> &nums, int target) { int i = 0, j = nums.size() - 1; // 初始化双闭区间 [0, n-1] while (i <= j) { int m = i + (j - i) / 2; // 计算中点索引 m if (nums[m] < target) { i = m + 1; // target 在区间 [m+1, j] 中 } else if (nums[m] > target) { j = m - 1; // target 在区间 [i, m-1] 中 } else { j = m - 1; // 首个小于 target 的元素在区间 [i, m-1] 中 } } // 返回插入点 i return i;}// 以上的 “判断分支 nums[m] > target 和 nums[m] == target”的操作相同,因此两者可以合并总之,最后的结构就是成功找到答案,或者是越过边界后停止
给定一个长度为 的有序数组
nums,数组可能包含重复元素。请返回数组中最左一个元素target的索引。若数组中不包含该元素,则返回
回忆二分查找插入点的方法,搜索完成后, 指向最左一个 target ,因此查找插入点本质上是在查找最左一个 target 的索引。
所以可以用查找插入点的函数实现查找左边界。因为数组中可能不包含target,因此可能会有以下两种结果:
插入点的索引 越界
元素 nums[i] 与 target 不相等。
因此出现这两种情况,直接返回 即可
/* 二分查找最左一个 target */int binarySearchLeftEdge(vector<int> &nums, int target) { // 等价于查找 target 的插入点 int i = binarySearchInsertion(nums, target); // 未找到 target ,返回 -1 if (i == nums.size() || nums[i] != target) { return -1; } // 找到 target ,返回索引 i return i;}最简单的方法就在直接修改代码,替换在 nums[m] == target 情况下的指针收缩操作
下面是更取巧的方法:
实际上,我们可以利用查找最左元素的函数来查找最右元素,具体方法为:将查找最右一个 target 转化为查找最左一个 target + 1。
如下要查找 6 的右边界,就相当于要查找 7 的左边界,若没有 7 返回的也是 6 的右边界的位置( 会指向首个小于7 的元素)。当查找完成后,指针 指向最左一个 target + 1(如果存在),而 指向最右一个 target ,因此返回 即可。但因为返回的插入点是 ,因此需要将其减 ,从而获得 。
/* 二分查找最右一个 target */int binarySearchRightEdge(vector<int> &nums, int target) { // 转化为查找最左一个 target + 1 int i = binarySearchInsertion(nums, target + 1); // j 指向最右一个 target ,i 指向首个大于 target 的元素 int j = i - 1; // 未找到 target ,返回 -1 if (j == -1 || nums[j] != target) { return -1; } // 找到 target ,返回索引 j return j;}因为当数组不包含 target 时,最终 和 会分别指向首个大于、小于 target 的元素。因此,如下图,我们可以构造一个数组中不存在的元素,用于查找左右边界
查找最左一个 target :可以转化为查找 target - 0.5 ,并返回指针
查找最右一个 target :可以转化为查找 target + 0.5 ,并返回指针

代码省略,以下是要注意的两点 注意要改成浮点类型 还有因为原数组不包含小数,因此无需考虑相等的情况在算法题中,我们常通过将线性查找替换为哈希查找来降低算法的时间复杂度。
给定一个整数数组
nums和一个目标元素target,请在数组中搜索“和”为target的两个元素,并返回它们的数组索引。返回任意一个解即可。
通过考虑直接遍历所有可能的组合。如下图,我们使用两层循环,在每轮判断中判断两个整数的和是否为 target ,若是则返回它们的索引

/* 方法一:暴力枚举 */vector<int> twoSumBruteForce(vector<int> &nums, int target) { int size = nums.size(); // 两层循环,时间复杂度 O(n^2) for (int i = 0; i < size - 1; i++) { for (int j = i + 1; j < size; j++) { if (nums[i] + nums[j] == target) return {i, j}; } } return {};}这种方法简单易懂,但看到两层循环就知道它的时间复杂度为 ,空间复杂度为 ,在大数据量下非常耗时
先添加一个哈希表,将数组元素与数组索引(下标)作为它的键值对。然后在按如下步骤循环遍历数组来添加:
target - nums[i] 是否在哈希表中,若是则直接返回这两个元素的索引nums[i] 和索引 i 添加到哈希表中【GIF】
添加完要 的时间复杂度,查询要 的时间复杂度
/* 方法二:辅助哈希表 */vector<int> twoSumHashTable(vector<int> &nums, int target) { int size = nums.size(); // 辅助哈希表,空间复杂度 O(n) unordered_map<int, int> dic; // 单层循环,时间复杂度 O(n) for (int i = 0; i < size; i++) { if (dic.find(target - nums[i]) != dic.end()) { return {dic[target - nums[i]], i}; } dic.emplace(nums[i], i); } return {};}通过以上方法只要单层循环即可,所以时间复杂度从 降低到 , 大幅提升了运行效率
因为要添加一个额外的哈希表,因此空间复杂度为 。因为整体的时空复杂度较为均衡,因此它是本题的最优解法(其实是时间复杂度小才是重点的说)
「搜索算法 searching algorithm」用于在数据结构(如数组、链表、树和图)中搜索一个或一组满足特定条件的元素
搜索算法更加实现思路可以分为以下两类:
**通过遍历数据结构来定位目标元素,**例如数组、链表、树、图的遍历等
**通过利用数据组织结构或数据中包含的先验信息,实现高效元素查找,**例如二分查找、哈希查找和二叉搜索树查找等
以下将从更系统的视角来切入,重新审视搜索算法。
暴力搜索就是通过遍历搜索结果的每一个元素来定位目标元素
“线性搜索”: 适用于数组和链表等线性数据结构,它从数据结构的一端开始,逐个访问元素,直到找到目标元素或达到另一端或任然没有找到目标元素为止。
**“广度优先搜索”和“深度优先搜索”:**是对图和树的两种遍历策略。
广度优先搜索从初始节点开始逐层搜索,由近及远地访问各个节点
深度优先搜索是从初始节点开始,沿着一条路径走到头为止,再回溯并尝试其他路径,直到遍历完整个数据结构
暴力搜索的优点是简单且通用性好,无需对数据做预处理和借助额外的数据结构。
然而,这类算法的时间复杂度为 ,其中 为元素数量,因此再数据量较大时的性能较差
自适应搜索利用数据的特有属性(例如有序性)来优化搜索过程,从而更高效的定位目标元素。
**“二分查找”:**利用数据的有序性来实现高效查找,仅适用于数组
**“哈希查找”:**利用哈希表将搜索数据结构和目标数据建立为键值对映射,从而实现查询操作
**“树查找”:**在特定的树结构(例如二叉搜索树)中,基于比较节点值来快速排除节点,从而定位目标元素。
此类算法的优点是效率高,时间复杂度可达到 甚至
但是,**使用这些算法往往需要对数据进行预处理。**例如二分查找需要预先对数组进行排序,哈希查找和树查找都需要借助二外的数据结构,维护这些数据结构(进行预处理的过程)也需要额外的时间和空间开支。
自适应搜索算法又称查找算法,主要用于在特定数据结构中快速检索目标元素
给定大小为 的一组数据,我们可以使用线性搜索、二分查找、树查找、哈希查找等多种方法在该数据中搜索目标元素。各个方法的工作原理如下图所示

| 线性搜索 | 二分查找 | 树查找 | 哈希查找 | |
|---|---|---|---|---|
| 查找元素 | ||||
| 插入元素 | ||||
| 删除元素 | ||||
| 额外空间 | ||||
| 数据预处理 | 排序 | 建树 | 建哈希表 | |
| 数据是否有序 | 无序 | 有序 | 有序 | 无序 |
搜索算法的选择还取决于数据体量、搜索性能要求、数据查询、更新频率等
线性搜索
**通用性较好,无须任何数据处理操作。**如果我们只需要查询一次数据,那么其他三种方法的数据预处理的时间比线性搜索的时间还要更长
适用于体量较小的数据,此情况下时间复杂度对效率影响较小。
适用于数据更新频率较高的场景,因为该方法不需要对数据进行任何额外维护。
二分查找
**适用于大数据量的情况,**效率表现稳定,最差时间复杂度为
**数据量不能过大,**因为存储数组需要连续的内存空间。
不适用于高频增删数据的场景,因为维护有序数组的开销较大。
哈希查找
适合对查询性能要求很高的场景,平均时间复杂度为 。
不适合需要有序数据或范围查找的场景,因为哈希表无法维护数据的有序性。
对哈希函数和哈希冲突处理策略的依赖性较高,具有较大的性能劣化风险。
不适合数据量过大的情况,因为哈希表需要额外空间来最大程度地减少冲突,从而提供良好的查询性能。
树查找
**适用于海量数据,**因为树节点在内存中是分散存储的。
适合需要维护有序数据或范围查找的场景。
在持续增删节点的过程中,二叉搜索树可能产生倾斜,时间复杂度劣化至 。
若使用 AVL 树或红黑树,则各项操作可在 效率下稳定运行,但维护树平衡的操作会增加额外开销。
二分查找依赖于数据的有序性,通过循环逐步缩减一半搜索区间来实现查找。它要求输入数据有序,且仅适用于数组或基于数组实现的数据结构。
暴力搜索通过遍历数据结构来定位数据。线性搜索适用于数组和链表,广度优先搜索和深度优先搜索适用于图和树。此类算法通用性好,无须对数据预处理,但时间复杂度 较高。
哈希查找、树查找和二分查找属于高效搜索方法,可在特定数据结构中快速定位目标元素。此类算法效率高,时间复杂度可达 甚至 ,但通常需要借助额外数据结构。
实际中,我们需要对数据体量、搜索性能要求、数据查询和更新频率等因素进行具体分析,从而选择合适的搜索方法。
线性搜索适用于小型或频繁更新的数据;二分查找适用于大型、排序的数据;哈希查找适合对查询效率要求较高且无须范围查询的数据;树查找适用于需要维护顺序和支持范围查询的大型动态数据。
用哈希查找替换线性查找是一种常用的优化运行时间的策略,可将时间复杂度从 降低至 。
排序犹如一把将混乱变为秩序的魔法钥匙,使我们能更高效的方法理解与处理数据。无论是简单的升序,还是夫扎尔达分类排列,排序都向我们展示了数据的和谐与美感
还有多进程排序、shell(希尔)排序等等没说
多进程、希尔排序是什么
「排序算法 sorting algorithm」用于对一组数据按照特定的顺序进行排列。排序算法有着广泛的应用,因为有序的数据通常能够更高效的查找、分析、处理。
如下图,排序算法中的数据类型可以是整数、浮点数、字符、字符串等,排序的判断规则可自行决定,可以是字符大小、字符 ASCII 码顺序或自定义规则等。

分为以下 5 点:
**运行效率:**要求排序算法的时间复杂度要低,总体总体操作数量要较小(即是时间复杂度中的常数项要小)。因为大数据量下,要让排序的时间越小越好
**就地性:**就是要越节省内存越好,因为这样,或者说原地排序的数据搬运操作较少,运行速度也快
**稳定性:**就是在排序后,相等的元素在数组中的相对顺序不发生改变,类比之前的 double 类型的单位的顺序不改变,或者如下
稳定排序是多级排序场景的必要条件。假设我们有一个存储学生信息的表格,第 1 列和第 2 列分别是姓名和年龄。在这种情况下,「非稳定排序」可能导致输入数据的有序性丧失:
# 输入数据是按照姓名排序好的# (name, age) ('A', 19) ('B', 18) ('C', 21) ('D', 19) ('E', 23) # 假设使用非稳定排序算法按年龄排序列表,# 结果中 ('D', 19) 和 ('A', 19) 的相对位置改变,# 输入数据按姓名排序的性质丢失 ('B', 18) ('D', 19) ('A', 19) ('C', 21) ('E', 23)**自适应性:**就是所时间复杂度中有变量。最佳、最差、平均时间复杂度都并不相等
自适应性需要根据具体情况来评估。如果最差时间复杂度差于平均时间复杂度,说明排序算法在某些数据下性能可能劣化,因此被视为负面属性;而如果最佳时间复杂度优于平均时间复杂度,则被视为正面属性。
是否基于比较:
「基于比较的排序」依赖比较运算符()来判断元素的相对顺序,从而排序整个数组,理论最优时间复杂度为 。
而「非比较排序」不使用比较运算符,时间复杂度可达 ,但其通用性相对较差。
运行快、原地、稳定、正向自适应、通用性好。因为现在没有兼容以上所有特性的完美算法,因此,需要根据具体问题具体分析来选择适合的排序算法
「选择排序 selection sort」的原理就是:
开启一轮循环,再在每轮循环中再开一个循环来寻找其中最小的元素,然后把它放到新开的一个序列末尾,之后将其变为 空值、-1、INT_MAX等
或用双指针(两轮循环),按下图来遍历,把最小元素放到该数组已排序的部分的末尾
【GIF】
/* 选择排序 */void selectionSort(vector<int> &nums) { int n = nums.size(); // 外循环:未排序区间为 [i, n-1] for (int i = 0; i < n - 1; i++) { // 内循环:找到未排序区间内的最小元素 int k = i; for (int j = i + 1; j < n; j++) { if (nums[j] < nums[k]) k = j; // 记录最小元素的索引 } // 将该最小元素与未排序区间的首个元素交换 swap(nums[i], nums[k]); }}注:上面的第一种方法的空间复杂度为 ,第二种为
**时间复杂度为 、为非自适应排序:**外循环共 轮,第一轮的未排序区间长度为 ,最后一轮的未排序区间长度为 ,即各轮外循环分别包含 轮内循环,求和为 。
空间复杂度 、为原地排序: 指针 和 使用常数大小的额外空间。
**非稳定排序:**如下图,元素 nums[i] 有可能被交换至与其相等的元素的右边,导致两者的相对顺序发生改变。
注:原地排序指未借助额外数组

「冒泡排序 bubble sort」:通过连续的比较与交换相邻元素来实现排序。这个过程就像气泡从底部升到顶部一样,因此得名冒泡排序
如下图,冒泡过程可以利用两元素的交换操作来模拟:从数组最左端开始向右遍历(第一重遍历),然后再依次比较相邻元素的大小(第二重),如果 “左元素 > 右元素” 就将两者交换。每当一轮遍历完后,最大的元素就会被移动到数组的最右端
【GIF】
如下图:

/* 冒泡排序 */void bubbleSort(vector<int> &nums) { // 外循环:未排序区间为 [0, i] for (int i = nums.size() - 1; i > 0; i--) { // 内循环:将未排序区间 [0, i] 中的最大元素交换至该区间的最右端 for (int j = 0; j < i; j++) { if (nums[j] > nums[j + 1]) { // 交换 nums[j] 与 nums[j + 1] // 这里使用了 std::swap() 函数 swap(nums[j], nums[j + 1]); } } }}当某轮 “冒泡” 中没有指向任何交换操作,说明数组已完成排序了,可以直接返回结果。因此我们可以加一个标志位 flag 来监视这种情况,一旦出现就立即返回
通过这种优化,它的时间复杂度还是 ,但长数组的有序程度越高时,它的速度越快,当输入时的数组完全有序时,可达到最佳时间复杂度
/* 冒泡排序(标志优化)*/void bubbleSortWithFlag(vector<int> &nums) { // 外循环:未排序区间为 [0, i] for (int i = nums.size() - 1; i > 0; i--) { bool flag = false; // 初始化标志位 // 内循环:将未排序区间 [0, i] 中的最大元素交换至该区间的最右端 for (int j = 0; j < i; j++) { if (nums[j] > nums[j + 1]) { // 交换 nums[j] 与 nums[j + 1] // 这里使用了 std::swap() 函数 swap(nums[j], nums[j + 1]); flag = true; // 记录交换元素 } } if (!flag) break; // 此轮冒泡未交换任何元素,直接跳出 }}**时间复杂度为 、为自适应排序:**各轮“冒泡”遍历的数组长度依次为 ,总和为 。在引入 flag 优化后,最佳时间复杂度可达到 。
**空间复杂度为 、为原地排序:**指针 和 使用尝试大小的额外空间
**稳定排序:**由于在“冒泡”中遇到相等元素不交换。
「插入排序 insertion sort」是一种简单的算法,它的工作原理与手动整理一副扑克牌的过程非常的相似
就是再未排序的区间选择一个基准元素,将该元素与其左侧已排序的区间的元素逐一比较大小,并将该元素插入到正确的位置。
如下图,设基准元素为 base ,我们需要将从目标索引到 base 之间的所有元素向右移动一位,然后将 base 赋值给目标索引。
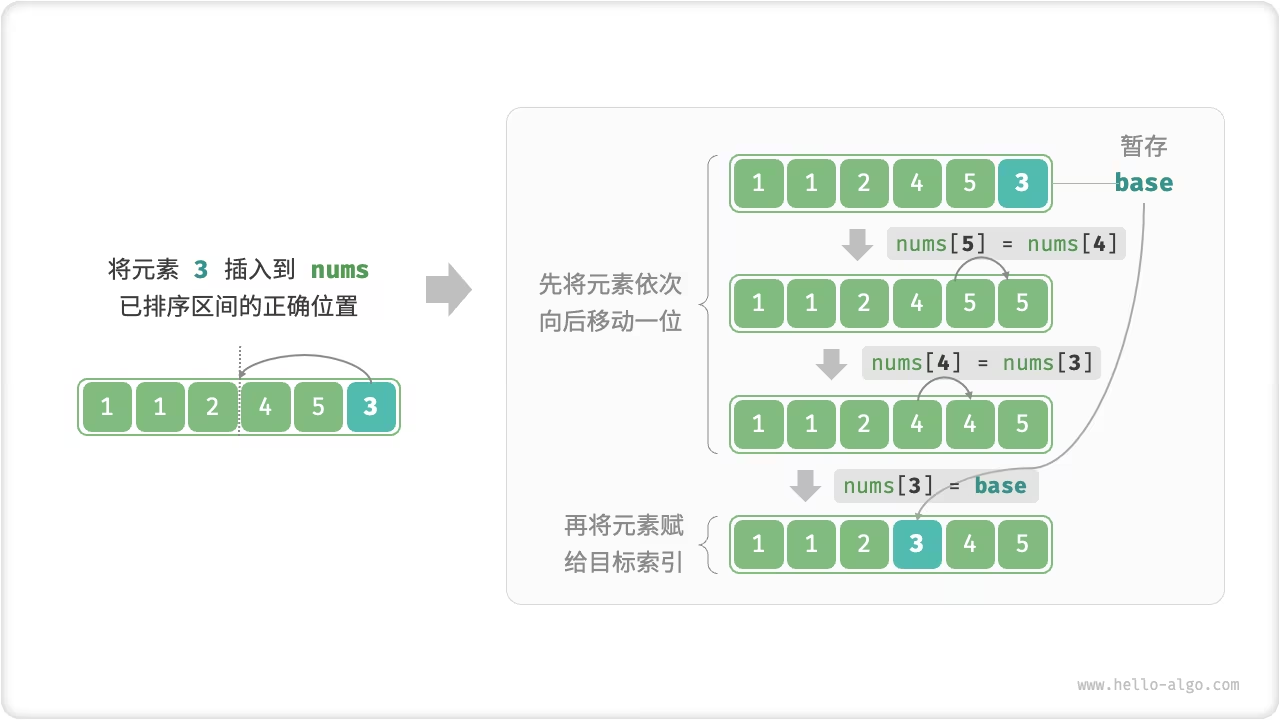
base ,将其插入到正确位置后,数组的前 2 个元素已排序。base ,将其插入到正确位置后,数组的前 3 个元素已排序。base ,将其插入到正确位置后,所有元素均已排序。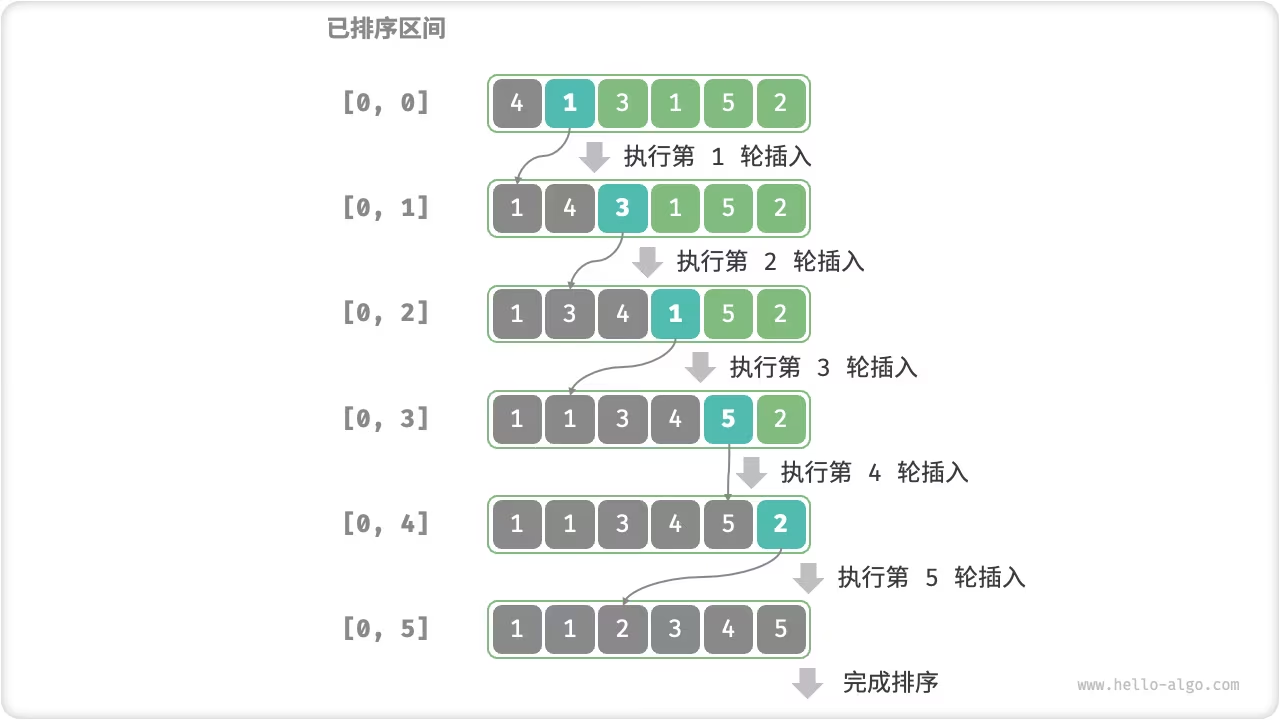
/* 插入排序 */void insertionSort(vector<int> &nums) { // 外循环:已排序元素数量为 1, 2, ..., n for (int i = 1; i < nums.size(); i++) { int base = nums[i], j = i - 1; // 内循环:将 base 插入到已排序部分的正确位置 while (j >= 0 && nums[j] > base) { nums[j + 1] = nums[j]; // 将 nums[j] 向右移动一位 j--; } nums[j + 1] = base; // 将 base 赋值到正确位置 }}时间复杂度 O(n^2)、为自适应排序:在最差情况下,每次插入操作分别需要循环 次,求和得到 ,因此时间复杂度为 。在遇到有序数据时,插入操作会提前终止。当输入数组完全有序时,插入排序达到最佳时间复杂度 。
空间复杂度 O(1)、为原地排序:指针 和 使用常数大小的额外空间。
稳定排序:在插入操作过程中,我们会将元素插入到相等元素的右侧,不会改变它们的顺序。
其的时间复杂度为 ,虽然之后的快速排序的时间复杂度为 ,虽然看起来插入排序的时间复杂度更高,但在数据量较小的情况下,插入排序通常会更快。
这个结论和 线性查找与二分查找的情况类似。快速排序这类 的算法属于基于分治策略的排序算法,往往包含更多单元计算操作。而在数据量较小时, 和 的数值比较接近,复杂度不占主导地位;每轮中的单元操作数量起到决定性作用。
实际上,许多编程语言(例如 Java)的内置排序函数采用了插入排序,大致思路为:对于长数组,采用基于分治策略的排序算法,例如快速排序;对于短数组,直接使用插入排序。
前三种排序(都是 )中,插入排序的优势:
冒泡排序基于元素交换实现,需要借助一个临时变量,共涉及 3 个单元操作;插入排序基于元素赋值实现,仅需 1 个单元操作。因此,冒泡排序的计算开销通常比插入排序更高。
选择排序在任何情况下的时间复杂度都为 。如果给定一组部分有序的数据,插入排序通常比选择排序效率更高。
选择排序不稳定,无法应用于多级排序。
这也是为什么插入排序的使用频率显著高于冒泡排序和选择排序
「快速排序 quick sort」是一种基于分治的排序算法,运行高效
它的核心操作是 “哨兵划分” (双指针):其目标是,选择数组中的某个元素作为 “基准数” ,将所有小于基准数的元素移到其左侧,而大于其基准数的元素移到其右侧,如下图:
i 和 j 分别指向数组的两端。i(j)分别寻找第一个比基准数大(小)的元素,然后交换这两个元素。2. ,直到 i 和 j 相遇时停止,最后将基准数交换至两个子数组的分界线。【GIF】
当哨兵划分完成之后,原数组被划分为三部分:左子数组、基准数、右子数组并且满足 “左子数组的任意元素 ≤ 基准数 ≤ 右子数组的任意元素”然后通过对这两个子数组通过递归的方法用同样的方法排序即可
/* 元素交换 */void swap(vector<int> &nums, int i, int j) { int tmp = nums[i]; nums[i] = nums[j]; nums[j] = tmp;} /* 哨兵划分 */int partition(vector<int> &nums, int left, int right) { // 以 nums[left] 为基准数 int i = left, j = right; while (i < j) { while (i < j && nums[j] >= nums[left]) j--; // 从右向左找首个小于基准数的元素 while (i < j && nums[i] <= nums[left]) i++; // 从左向右找首个大于基准数的元素 swap(nums, i, j); // 交换这两个元素 } swap(nums, i, left); // 将基准数交换至两子数组的分界线 return i; // 返回基准数的索引}如下图:

/* 快速排序 */void quickSort(vector<int> &nums, int left, int right) { // 子数组长度为 1 时终止递归 if (left >= right) return; // 哨兵划分 int pivot = partition(nums, left, right); // 递归左子数组、右子数组 quickSort(nums, left, pivot - 1); quickSort(nums, pivot + 1, right);}时间复杂度 、为自适应排序:在平均情况下,哨兵划分的递归层数为 ,每层中的总循环数为 ,总体使用 时间。在最差情况下,每轮哨兵划分操作都将长度为 的数组划分为长度为 和 的两个子数组,此时递归层数达到 ,每层中的循环数为 ,总体使用 时间。
空间复杂度 、为原地排序:在输入数组完全倒序的情况下,达到最差递归深度 ,使用 栈帧空间。排序操作是在原数组上进行的,未借助额外数组。但进行尾递归优化后,空间复杂度可优化为
非稳定排序:在哨兵划分的最后一步,基准数可能会被交换至相等元素的右侧。
虽然快速排序的平均时间复杂度与 “归并排序” 和 “堆排序” 相同,但快排的效率更高的原因如下:
出现最差情况的概率很低:虽然快速排序的最差时间复杂度为 ,没有归并排序稳定,但在绝大多数情况下,快速排序能在 的时间复杂度下运行。
缓存使用效率高:在执行哨兵划分操作时,系统可将整个子数组加载到缓存,因此访问元素的效率较高。而像“堆排序”这类算法需要跳跃式访问元素,从而缺乏这一特性。
复杂度的常数系数小:在上述三种算法中,快速排序的比较、赋值、交换等操作的总数量最少。这与“插入排序”比“冒泡排序”更快的原因类似。
因此他才叫快速排序
**在倒序输入呀等情况,快速排序的时间效率会很低。**比如倒序输入时,每次交换要完全交换一遍,并让哨兵一直靠近右边,从而让分治策略基本失效,使快排退化为 “冒泡排序”
因此我们可以改变哨兵划分与选取的策略来优化,如我们可以在数组中选取三个候选元素(通常为数组的首、尾、中点元素),并将这三个候选元素的中位数作为基准数。采用这种方法后,时间复杂度劣化至 的概率大大降低。
/* 选取三个元素的中位数 */int medianThree(vector<int> &nums, int left, int mid, int right) { // 此处使用异或运算来简化代码 // 异或规则为 0 ^ 0 = 1 ^ 1 = 0, 0 ^ 1 = 1 ^ 0 = 1 if ((nums[left] < nums[mid]) ^ (nums[left] < nums[right])) return left; else if ((nums[mid] < nums[left]) ^ (nums[mid] < nums[right])) return mid; else return right;} /* 哨兵划分(三数取中值) */int partition(vector<int> &nums, int left, int right) { // 选取三个候选元素的中位数 int med = medianThree(nums, left, (left + right) / 2, right); // 将中位数交换至数组最左端 swap(nums, left, med); // 以 nums[left] 为基准数 int i = left, j = right; while (i < j) { while (i < j && nums[j] >= nums[left]) j--; // 从右向左找首个小于基准数的元素 while (i < j && nums[i] <= nums[left]) i++; // 从左向右找首个大于基准数的元素 swap(nums, i, j); // 交换这两个元素 } swap(nums, i, left); // 将基准数交换至两子数组的分界线 return i; // 返回基准数的索引}在某些输入情况下,快速排序可能占用空间较多,因此可以通过每轮排序完后,只对较短的子数组进行递归来优化,可以将最差的空间复杂度优化为
/* 快速排序(尾递归优化) */void quickSort(vector<int> &nums, int left, int right) { // 子数组长度为 1 时终止 while (left < right) { // 哨兵划分操作 int pivot = partition(nums, left, right); // 对两个子数组中较短的那个执行快速排序 if (pivot - left < right - pivot) { quickSort(nums, left, pivot - 1); // 递归排序左子数组 left = pivot + 1; // 剩余未排序区间为 [pivot + 1, right] } else { quickSort(nums, pivot + 1, right); // 递归排序右子数组 right = pivot - 1; // 剩余未排序区间为 [left, pivot - 1] } }}「归并排序 merge sort」也是一种基于分治策略的排序算法,包含 “归类划分” 和 “合并” 两个阶段

如上图:
“划分阶段”从顶至底递归地将数组从中点切分为两个子数组。
mid ,递归划分左子数组(区间 [left, mid] )和右子数组(区间 [mid + 1, right] )。1. ,直至子数组区间长度为 1 时终止。“合并阶段”从底至顶地将左子数组和右子数组合并为一个有序数组。需要注意的是,从长度为 1 的子数组开始合并,合并阶段中的每个子数组都是有序的。
注:因为合并时每个小块都是有序的,所以只要将小块排序即可
【GIF】
由上图可知,归并排序与二叉树的后序遍历的递归顺序是一致的

后序遍历:先递归左子树,再递归右子树,最后处理根节点。
归并排序:先递归左子数组,再递归右子数组,最后处理合并。
归并排序的实现如下,其中
nums 的待合并区间为 [left, right] ,而 tmp 的对应区间为 [0, right - left] 。
/* 合并左子数组和右子数组 */void merge(vector<int> &nums, int left, int mid, int right) { // 左子数组区间 [left, mid], 右子数组区间 [mid+1, right] // 创建一个临时数组 tmp ,用于存放合并后的结果 vector<int> tmp(right - left + 1); // 初始化左子数组和右子数组的起始索引 int i = left, j = mid + 1, k = 0; // 当左右子数组都还有元素时,比较并将较小的元素复制到临时数组中 while (i <= mid && j <= right) { if (nums[i] <= nums[j]) tmp[k++] = nums[i++]; else tmp[k++] = nums[j++]; } // 将左子数组和右子数组的剩余元素复制到临时数组中 while (i <= mid) { tmp[k++] = nums[i++]; } while (j <= right) { tmp[k++] = nums[j++]; } // 将临时数组 tmp 中的元素复制回原数组 nums 的对应区间 for (k = 0; k < tmp.size(); k++) { nums[left + k] = tmp[k]; }} /* 归并排序 */void mergeSort(vector<int> &nums, int left, int right) { // 终止条件 if (left >= right) return; // 当子数组长度为 1 时终止递归 // 划分阶段 int mid = (left + right) / 2; // 计算中点 mergeSort(nums, left, mid); // 递归左子数组 mergeSort(nums, mid + 1, right); // 递归右子数组 // 合并阶段 merge(nums, left, mid, right);}时间复杂度 、非自适应排序:划分产生高度为 的递归树,每层合并的总操作数量为 ,因此总体时间复杂度为 。
空间复杂度 、非原地排序:递归深度为 ,使用 大小的栈帧空间。合并操作需要借助辅助数组实现,使用 大小的额外空间。
稳定排序:在合并过程中,相等元素的次序保持不变。
对于链表,归并排序相较于其他排序算法具有显著优势,可以将链表排序任务的空间复杂度优化至 。
划分阶段:可以使用“迭代”替代“递归”来实现链表划分工作,从而省去递归使用的栈帧空间。
合并阶段:在链表中,节点增删操作仅需改变引用(指针)即可实现,因此合并阶段(将两个短有序链表合并为一个长有序链表)无须创建额外链表。
具体实现细节比较复杂,因此没有代码
「堆排序 heap sort」是一种高效的排序算法,我们可以利用上面的 Top-K 问题的 “堆” 解决方案(“建堆操作”和“元素出堆操作”)来实现,如下
或者用更优雅的方式来实现,因为这种方法需要额外借助一个数组来保存弹出的元素,比较浪费空间
设数组的长度为 ,
2. 步和第 3. 步。循环 轮后,即可完成数组排序。2. 3. 4. 5. 6. 7. ……【GIF】
我们使用了与“堆”章节相同的从顶至底堆化 sift_down() 函数。但由于堆的长度会随着提取最大元素而减小,因此我们需要给 sift_down() 函数添加一个长度参数 ,用于指定堆的当前有效长度。代码如下所示:
/* 堆的长度为 n ,从节点 i 开始,从顶至底堆化 */void siftDown(vector<int> &nums, int n, int i) { while (true) { // 判断节点 i, l, r 中值最大的节点,记为 ma int l = 2 * i + 1; int r = 2 * i + 2; int ma = i; if (l < n && nums[l] > nums[ma]) ma = l; if (r < n && nums[r] > nums[ma]) ma = r; // 若节点 i 最大或索引 l, r 越界,则无须继续堆化,跳出 if (ma == i) { break; } // 交换两节点 swap(nums[i], nums[ma]); // 循环向下堆化 i = ma; }} /* 堆排序 */void heapSort(vector<int> &nums) { // 建堆操作:堆化除叶节点以外的其他所有节点 for (int i = nums.size() / 2 - 1; i >= 0; --i) { siftDown(nums, nums.size(), i); } // 从堆中提取最大元素,循环 n-1 轮 for (int i = nums.size() - 1; i > 0; --i) { // 交换根节点与最右叶节点(交换首元素与尾元素) swap(nums[0], nums[i]); // 以根节点为起点,从顶至底进行堆化 siftDown(nums, i, 0); }}时间复杂度 、非自适应排序:建堆操作使用 时间。从堆中提取最大元素的时间复杂度为 ,共循环 轮。
空间复杂度 、原地排序:几个指针变量使用 空间。元素交换和堆化操作都是在原数组上进行的。
非稳定排序:在交换堆顶元素和堆底元素时,相等元素的相对位置可能发生变化。
前几种排序算法都属于 “基于比较的排序算法” ,它们通过比较元素的大小来实现排序。其时间复杂度不是 就是 。下面所说的算法,其时间复杂度不定。有的可达到线性阶
「桶排序 bucket sort」是分治策略的一个典型应用。
它通过设置一些按照区间划分,并递增来排列的桶,将数据拼接分配到各个桶中;
然后,对每个桶内部分别执行排序;
最终按照桶的顺序将所有数据合并
注:它的思路有点像前面是因为都是分治思路嘛
对于一个长度是 的数组,其元素的范围是 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲0,1) 之间的浮点数,
先初始化 个桶,将 个元素分配到 个桶中
然后对每个桶执行排序
按照桶从小到大的顺序来合并结果

/* 桶排序 */void bucketSort(vector<float> &nums) { // 初始化 k = n/2 个桶,预期向每个桶分配 2 个元素 int k = nums.size() / 2; vector<vector<float>> buckets(k); // 1. 将数组元素分配到各个桶中 for (float num : nums) { // 输入数据范围为 [0, 1),使用 num * k 映射到索引范围 [0, k-1] int i = num * k; // 将 num 添加进桶 bucket_idx buckets[i].push_back(num); } // 2. 对各个桶执行排序 for (vector<float> &bucket : buckets) { // 使用内置排序函数,也可以替换成其他排序算法 sort(bucket.begin(), bucket.end()); } // 3. 遍历桶合并结果 int i = 0; for (vector<float> &bucket : buckets) { for (float num : bucket) { nums[i++] = num; // nums[]为原数组 } } 以下使用 C++ 中自带的排序函数来对每个桶内排序,其中:
sort() 是混合排序,会自动选择快速排序、归并排序、堆排序、插入排序等中的一种进行排序,以便获得更优的复杂度
时间复杂度为
默认升序排序
不稳定
常用于不要求稳定,要求快的排序
stable_sort() 是稳定排序,使用归并排序实现
时间复杂度为
稳定,元素的相对顺序不变
常用于对结构体进行排序或者需要按照先后顺序进行排列
partial_sort() 是一种局部排序的算法,使用堆排序实现,可以对数组/容器中的前 个元素进行排序,左开右闭区间[ , )
时间复杂度为
常用于取前 k 大或前 k 小元素的情况
partial_sort(a + 2, a + 6, a + n);// 将 a[2] 到 a[5] 区间内的前 4 个元素排序桶排序适用于处理体量很大的数据。例如,输入数据包含 100 万个元素,由于空间限制,系统无法一次性加载所有数据,因此可以分为 1000 个桶,然后对每个桶排序,然后合并结果
**时间复杂度 :**假设 个元素在 个桶内平均分布,那么每个桶内的元素的数量为 。因此,排单个桶需要 的时间。排所有的桶需要 的时间。**当桶的数量 比较大的时候, ,使得时间复杂度 ,**然后合并结果又需要遍历所有桶和元素,花费 的时间
**自适应排序:**在最差的情况下,所有数据被分配到一个桶中,因此排序该桶需要使用 的时间
空间复杂度 、非原地排序: 需要借助 个桶和总共 个元素的额外空间
注意,桶排序是否稳定取决于排序桶内元素的算法 sort() 是否稳定(如上使用 C++ 自带的归并排序 stable_sort() 的话就会更稳定)
桶排序的时间复杂度理论上可以达到 ,关键在于将元素均匀分配到各个桶中,因为实际数据往往不是均匀分布的。
就像正态分布, 的区间,来通过设定不同的区间,根据数据概率分布设置每个桶的价格分界线,来将每个桶的数据的数量变得近似相等,

当然,不用特定的设计区间,只要根据大概的数学模型近似来平均的分即可
然后,在第一次很晚后,还可以再次分治,如下图,

它有点像链式结构的哈希表,一个是按照取模,一个是按照区间来分
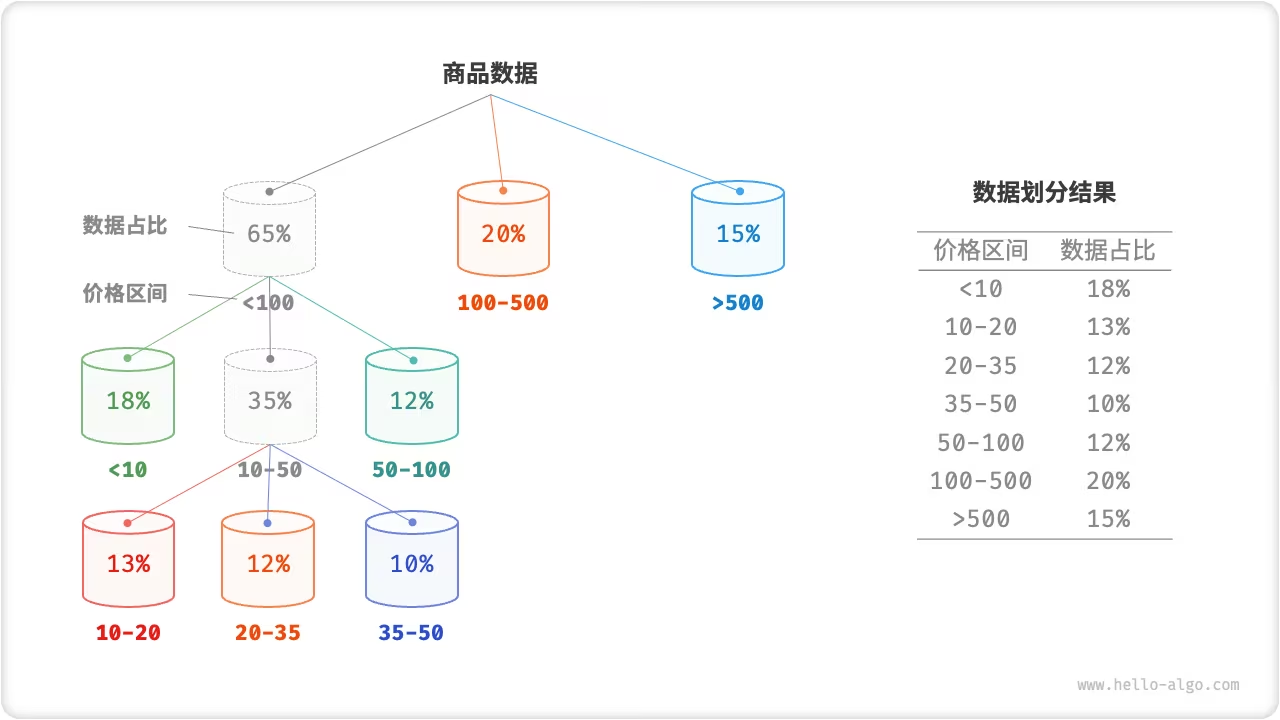
其方法的本质实际上是创建一棵递归树,目标是让叶节点的值尽可能平均。当然,不一定要每轮将数据划分为 3 个桶,具体划分方式可根据数据特点灵活选择。
「计数排序 counting sort」通过统计元素数量来实现排序,通常应用于整数数组、ASCII 表、字母……

如上图,给定一个长度为 的数组 nums ,其中的元素都是“非负整数”,计数排序的整体流程如下:
counter 。counter 统计 nums 中各数字的出现次数,其中 counter[num] 对应数字 num 的出现次数。统计方法很简单,只需遍历 nums(设当前数字为 num),每轮将 counter[num] 增加 即可。counter 的各个索引天然有序,因此相当于所有数字已经排序好了。接下来,我们遍历 counter ,根据各数字出现次数从小到大的顺序填入 nums 即可。/* 计数排序 */// 简单实现,无法用于排序对象void countingSortNaive(vector<int> &nums) { // 1. 统计数组最大元素 m int m = 0; for (int num : nums) { m = max(m, num); } // 2. 统计各数字的出现次数 // counter[num] 代表 num 的出现次数 vector<int> counter(m + 1, 0); for (int num : nums) { counter[num]++; } // 3. 遍历 counter ,将各元素填入原数组 nums int i = 0; for (int num = 0; num < m + 1; num++) { for (int j = 0; j < counter[num]; j++, i++) { nums[i] = num; } }}计数排序与桶排序的联系
从桶排序的角度看,我们可以将计数排序中的计数数组
counter的每个索引视为一个桶,将统计数量的过程看作将各个元素分配到对应的桶中。本质上,计数排序是桶排序在整型数据下的一个特例。
上面的方法看上去简单美好,但实用条件较小,如果输入数据是对象,上述步骤 3. 就失效了。
假设输入数据是商品对象,我们想按照商品价格(类的成员变量)对商品进行排序,而上述算法只能给出价格的排序结果。
注:这里指的是这种计数排序的方法,而不是指如何对结构体排序
想要用计数排序来对结构体/对象排序,那么需要在如上步骤后还要,计算前缀和(在计数完后对 counter 数组进行变形,变形为前缀和 prefix)
对于 counter 的“前缀和”,顾名思义,顾名思义,索引 i 处的前缀和 prefix[i] 等于数组前 i 个元素之和:
ParseError: KaTeX parse error: Undefined control sequence: \[ at position 14: \text{prefix}\̲[̲i] = \sum\_{j=0…
前缀和具有明确的意义,prefix[num]-1 表示元素 num 在结果数组 res 中最后一次出现的索引。这个信息非常关键,因为它告诉我们各个元素应该出现在结果数组的哪个位置。还有一点是使用前缀和这个特性,可以实现稳定排序。
先统计元素个数,然后记录高 counter 数组
计算前缀和
从 counter 数组的第二个元素开始,将当前元素与前一个元素累加,更新 counter[i] 的值为 counter[i] + counter[i-1]。
这样,counter[i]的值就表示小于等于元素 i 的个数。
然后创建一个与待排序数组大小相同的结果数组 result(res)。
从后向前倒序遍历原数组 nums,并排序
将 num (nums[i])填入数组 res[ prefix[num] - 1 ] 处。填入 prefix[num] - 1处是因为,数组是从 开始计算的
令前缀和 prefix[num] 减小 1 ,从而得到下次放置 num 的索引
上面两步其实可以写成
res[ --prefix[nums[i]] ]这一句话
最终,结果数组 result 中的元素就是有序的排列。
【GIF】
/* 计数排序 */// 完整实现,可排序对象,并且是稳定排序void countingSort(vector<int> &nums) { // 1. 统计数组最大元素 m int m = 0; for (int num : nums) { m = max(m, num); } // 2. 统计各数字的出现次数 // counter[num] 代表 num 的出现次数 vector<int> counter(m + 1, 0); for (int num : nums) { counter[num]++; } // 3. 求 counter 的前缀和,将“出现次数”转换为“尾索引” // 即 counter[num]-1 是 num 在 res 中最后一次出现的索引 for (int i = 0; i < m; i++) { counter[i + 1] += counter[i]; } // 4. 倒序遍历 nums ,将各元素填入结果数组 res // 初始化数组 res 用于记录结果 int n = nums.size(); vector<int> res(n); for (int i = n - 1; i >= 0; i--) { int num = nums[i]; res[counter[num] - 1] = num; // 将 num 放置到对应索引处 counter[num]--; // 令前缀和自减 1 ,得到下次放置 num 的索引 } // 使用结果数组 res 覆盖原数组 nums nums = res;}**时间复杂度 O(n+m):**涉及遍历 nums 和遍历 counter ,都使用线性时间。一般情况下 n≫m ,时间复杂度趋于 O(n) 。
**空间复杂度 、为非原地排序:**借助了长度分别为 和 的数组 res 和 counter 。
**稳定排序:**因为由于向 res 中填充元素的顺序是“从右向左”的,因此倒序遍历 nums 可以避免改变相等元素之间的相对位置,从而实现稳定排序。
实际上,正序遍历
nums也可以得到正确的排序结果,但结果是非稳定的。如果我们能将前缀和的初始状态指向“第一个索引”,而非原来记录的“最后一个的索引”,那么就应该正序遍历
nums。如下:Pythondef counting_sort(nums: list[int]): """计数排序""" # 完整实现,可排序对象,并且是稳定排序 # 1. 统计数组最大元素 m m = max(nums) # 2. 统计各数字的出现次数 # counter[num] 代表 num 的出现次数 counter = [0] * (m + 1) for num in nums: counter[num] += 1 # 3. 求 counter 的前缀和,将“出现次数”转换为“尾索引” # 即 counter[num]-1 是 num 在 res 中最后一次出现的索引 for i in range(m): counter[i + 1] += counter[i] # ! 在 counter 首部添加 0 ,此时 counter[num] 的含义变为: num 在 res 中第一次出现的索引 counter.insert(0, 0) # 4. 正序遍历 nums ,将各元素填入结果数组 res # 初始化数组 res 用于记录结果 n = len(nums) res = [0] * n # ! 请注意,这时我们就可以在正序遍历下保持稳定性 for i in range(n): num = nums[i] res[counter[num]] = num # 将 num 放置到对应索引处 counter[num] += 1 # 令前缀和自增 1 ,得到下次放置 num 的索引 # 使用结果数组 res 覆盖原数组 nums for i in range(n): nums[i] = res[i]
看上去它的方法很巧妙,但是使用条件相对比较严格
之前的计数排序,它适用于数据量 较大但数据范围 较小的情况。假设我们需要对 个学号进行排序,而学号是一个 位数字(如下图),这意味着数据范围 非常大,使用计数排序需要分配大量内存空间,而基数排序可以避免这种情况。
「基数排序 radix sort」的核心思想与计数排序一致,也通过统计个数来实现排序。只不过将个数转化为了索引(每一位),就是在此基础上,基数排序利用数字各位之间的递进关系,依次对每一位进行排序,从而得到最终的排序结果。
因此嘛,不仅数字,还有字母等也可以用其来排序
在一些特殊情况,基数排序会退化成计数排序
以上面说的学号数据为例,假设数字的最低位是第 位,最高位是第 位,基数排序的流程如下所示:
2. 继续迭代,直到所有位都排序完成后结束。
以下为代码及代码解释:
对于一个 进制的数字 ,要获得其第 位 ,可以循环遍历,或使用以下公式一步到位,
其中 表示对浮点数 向下取整,而 表示对 取余。对于学号数据, 且 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 7: k \in \̲[̲1,8]
因此我们只要小幅改动计数排序的代码,就可以使之更加数字的第 位进行排序:
/* 获取元素 num 的第 k 位,其中 exp = 10^(k-1) */int digit(int num, int exp) { // 传入 exp 而非 k 可以避免在此重复执行昂贵的次方计算 return (num / exp) % 10;} /* 计数排序(根据 nums 第 k 位排序) */void countingSortDigit(vector<int> &nums, int exp) { // 十进制的位范围为 0~9 ,因此需要长度为 10 的桶数组 vector<int> counter(10, 0); int n = nums.size(); // 统计 0~9 各数字的出现次数 for (int i = 0; i < n; i++) { int d = digit(nums[i], exp); // 获取 nums[i] 第 k 位,记为 d counter[d]++; // 统计数字 d 的出现次数 } // 求前缀和,将“出现个数”转换为“数组索引” for (int i = 1; i < 10; i++) { counter[i] += counter[i - 1]; } // 倒序遍历,根据桶内统计结果,将各元素填入 res vector<int> res(n, 0); for (int i = n - 1; i >= 0; i--) { int d = digit(nums[i], exp); int j = counter[d] - 1; // 获取 d 在数组中的索引 j res[j] = nums[i]; // 将当前元素填入索引 j counter[d]--; // 将 d 的数量减 1 } // 使用结果覆盖原数组 nums for (int i = 0; i < n; i++) nums[i] = res[i];} /* 基数排序 */void radixSort(vector<int> &nums) { // 获取数组的最大元素,用于判断最大位数 int m = *max_element(nums.begin(), nums.end()); // 按照从低位到高位的顺序遍历 for (int exp = 1; exp <= m; exp *= 10) // 对数组元素的第 k 位执行计数排序 // k = 1 -> exp = 1 // k = 2 -> exp = 10 // 即 exp = 10^(k-1) countingSortDigit(nums, exp);}为什么从最低位开始排序?
在连续的排序轮次中,后一轮排序会覆盖前一轮排序的结果。举例来说,如果第一轮排序结果 ParseError: KaTeX parse error: Undefined control sequence: \< at position 2: a\̲<̲b ,而第二轮排序结果 ,那么第二轮的结果将取代第一轮的结果。由于数字的高位优先级高于低位,因此应该先排序低位再排序高位。
相比于计数排序,计数排序适用于数据范围较大的情况,**但前提是数据必须可以表示位固定位数的格式,且位数不能过大。**例如,浮点数不适合使用基数排序,因为其位数 过大,可能导致时间复杂度 (还不如使用其他排序方法呢)
**时间复杂度 :**假设数据量为 、数据为 进制、最大位数为 ,则对某一位执行计数排序使用 时间,排序所有 位使用 时间。通常情况下, 和 都相对较小,时间复杂度 。
**空间复杂度 、为原地排序:**与计数排序相同,基数排序需要借助长度为 和 的数组 res 和 counter 。
稳定排序:当计数排序稳定时,基数排序也稳定;当计数排序不稳定时,基数排序无法保证得到正确的排序结果。
冒泡排序通过交换相邻元素来实现排序。通过添加一个标志位来实现提前返回,我们可以将冒泡排序的最佳时间复杂度优化到 。
插入排序每轮将未排序区间内的元素插入到已排序区间的正确位置,从而完成排序。虽然插入排序的时间复杂度为 ,但由于单元操作相对较少,因此在小数据量的排序任务中非常受欢迎。
快速排序基于哨兵划分操作实现排序。在哨兵划分中,有可能每次都选取到最差的基准数,导致时间复杂度劣化至 。引入中位数基准数或随机基准数可以降低这种劣化的概率。尾递归方法可以有效地减少递归深度,将空间复杂度优化到 。
归并排序包括划分和合并两个阶段,典型地体现了分治策略。在归并排序中,排序数组需要创建辅助数组,空间复杂度为 ;然而排序链表的空间复杂度可以优化至 。
桶排序包含三个步骤:数据分桶、桶内排序和合并结果。它同样体现了分治策略,适用于数据体量很大的情况。桶排序的关键在于对数据进行平均分配。
计数排序是桶排序的一个特例,它通过统计数据出现的次数来实现排序。计数排序适用于数据量大但数据范围有限的情况,并且要求数据能够转换为正整数。
基数排序通过逐位排序来实现数据排序,要求数据能够表示为固定位数的数字。
总的来说,我们希望找到一种排序算法,具有高效率、稳定、原地以及正向自适应性等优点。然而,正如其他数据结构和算法一样,没有一种排序算法能够同时满足所有这些条件。在实际应用中,我们需要根据数据的特性来选择合适的排序算法。
下图对比了主流排序算法的效率、稳定性、就地性和自适应性等。

排序算法稳定性在什么情况下是必需的?
在现实中,我们有可能是基于对象的某个属性进行排序。例如,学生有姓名和身高两个属性,我们希望实现一个多级排序:
先按照姓名进行排序,得到 (A, 180) (B, 185) (C, 170) (D, 170) ;再对身高进行排序。由于排序算法不稳定,因此可能得到 (D, 170) (C, 170) (A, 180) (B, 185) 。
可以发现,学生 D 和 C 的位置发生了交换,姓名的有序性被破坏了,而这是我们不希望看到的。
哨兵划分中“从右往左查找”与“从左往右查找”的顺序可以交换吗?
不行,当我们以最左端元素为基准数时,必须先“从右往左查找”再“从左往右查找”。这个结论有些反直觉,我们来剖析一下原因。
哨兵划分 partition() 的最后一步是交换 nums[left] 和 nums[i] 。完成交换后,基准数左边的元素都 <= 基准数,这就要求最后一步交换前 nums[left] >= nums[i] 必须成立。假设我们先“从左往右查找”,那么如果找不到比基准数更大的元素,则会在 i == j 时跳出循环,此时可能 nums[j] == nums[i] > nums[left]。也就是说,此时最后一步交换操作会把一个比基准数更大的元素交换至数组最左端,导致哨兵划分失败。
举个例子,给定数组 [0, 0, 0, 0, 1] ,如果先“从左向右查找”,哨兵划分后数组为 [1, 0, 0, 0, 0] ,这个结果是不正确的。
再深入思考一下,如果我们选择 nums[right] 为基准数,那么正好反过来,必须先“从左往右查找”。
关于尾递归优化,为什么选短的数组能保证递归深度不超过 ?
递归深度就是当前未返回的递归方法的数量。每轮哨兵划分我们将原数组划分为两个子数组。在尾递归优化后,向下递归的子数组长度最大为原数组长度的一半。假设在最差的情况,一直为一半长度,那么最终的递归深度就是 。
回顾原始的快速排序,我们有可能会连续地递归长度较大的数组,最差情况下为 ,递归深度为 。尾递归优化可以避免这种情况出现。
当数组中所有元素都相等时,快速排序的时间复杂度是 吗?该如何处理这种退化情况?
是的。对于这种情况,可以考虑通过哨兵划分将数组划分为三个部分:小于、等于、大于基准数。仅向下递归小于和大于的两部分。在该方法下,输入元素全部相等的数组,仅一轮哨兵划分即可完成排序。
桶排序的最差时间复杂度为什么是 ?
最差情况下,所有元素被分至同一个桶中。如果我们采用一个 算法来排序这些元素,则时间复杂度为 。
如字面意思,分开治理,分而治之:
将难题逐层拆解,每一次拆解都是它变得更为简单
分而治之揭示了一个重要的事实:从简单做起,一切都不复杂
「分治 divide and conquer」,全称分而治之,是一种非常重要的算法策略,其通常基于递归实现,包括“分”和“治”两个步骤
如下,“归并排序”是分治思想的典型应用之一

要看是否满足以下条件:
显然递归排序可以满足以上三个条件
分治不仅可以有效地解决算法问题,往往还可以提升算法效率。在排序算法中,快速排序、归并排序、堆排序相较于选择、冒泡、插入排序更快,就是因为它们应用了分治策略。
其原因如下:
以“冒泡排序”为例,其处理一个长度为 的数组需要 时间。假设我们按照下图所示的方式,将数组从中点分为两个子数组,则划分需要 时间,排序每个子数组需要 时间,合并两个子数组需要 时间,总体时间复杂度为:

接下来,我们计算以下不等式,其左边和右边分别为划分前和划分后的操作总数:
这意味着当 时,划分后的操作数量更少,排序效率应该更高。请注意,划分后的时间复杂度仍然是平方阶 ,只是复杂度中的常数项变小了。
进一步想,如果我们把子数组不断地再从中点划分为两个子数组,直至子数组只剩一个元素时停止划分呢?这种思路实际上就是“归并排序”,时间复杂度为 。
再思考,如果我们多设置几个划分点,将原数组平均划分为 个子数组呢?这种情况与“桶排序”非常类似,它非常适合排序海量数据,理论上时间复杂度可以达到 。
我们知道,分治生成的子问题是相互独立的,因此通常可以并行解决。也就是说,分治不仅可以降低算法的时间复杂度,还有利于操作系统的并行优化。
并行优化在多核或多处理器的环境中尤其有效,因为系统可以同时处理多个子问题,更加充分地利用计算资源,从而显著减少总体的运行时间。
比如在下图所示的“桶排序”中,我们将海量的数据平均分配到各个桶中,则可所有桶的排序任务分散到各个计算单元,完成后再进行结果合并。

一方面,分治可以用来解决许多经典算法问题。
寻找最近点对:该算法首先将点集分成两部分,然后分别找出两部分中的最近点对,最后再找出跨越两部分的最近点对。
大整数乘法:例如 Karatsuba 算法,它是将大整数乘法分解为几个较小的整数的乘法和加法。
矩阵乘法:例如 Strassen 算法,它是将大矩阵乘法分解为多个小矩阵的乘法和加法。
汉诺塔问题:汉诺塔问题可以视为典型的分治策略,通过递归解决。
求解逆序对:在一个序列中,如果前面的数字大于后面的数字,那么这两个数字构成一个逆序对。求解逆序对问题可以通过分治的思想,借助归并排序进行求解。
另一方面,分治在算法和数据结构的设计中应用非常广泛。
二分查找:二分查找是将有序数组从中点索引分为两部分,然后根据目标值与中间元素值比较结果,决定排除哪一半区间,然后在剩余区间执行相同的二分操作。
归并排序:文章开头已介绍,不再赘述。
快速排序:快速排序是选取一个基准值,然后把数组分为两个子数组,一个子数组的元素比基准值小,另一子数组的元素比基准值大,然后再对这两部分进行相同的划分操作,直至子数组只剩下一个元素。
桶排序:桶排序的基本思想是将数据分散到多个桶,然后对每个桶内的元素进行排序,最后将各个桶的元素依次取出,从而得到一个有序数组。
树:例如二叉搜索树、AVL 树、红黑树、B 树、B+ 树等,它们的查找、插入和删除等操作都可以视为分治的应用。
堆:堆是一种特殊的完全二叉树,其各种操作,如插入、删除和堆化,实际上都隐含了分治的思想。
哈希表:虽然哈希表来并不直接应用分治,但某些哈希冲突解决策略间接应用了分治策略,例如,链式地址中的长链表会被转化为红黑树,以提升查询效率。
可以看出,分治是一种“润物细无声”的算法思想,隐含在各种算法与数据结构之中。
搜索算法分为两大类:
暴力搜索:它通过遍历数据结构实现,时间复杂度为 。
自适应搜索:它利用特有的数据组织形式或先验信息,可达到 甚至 的时间复杂度。
实际上,时间复杂度为 的搜索算法通常都是基于分治策略实现的,例如二分查找和树。
二分查找的每一步都将问题(在数组中搜索目标元素)分解为一个小问题(在数组的一半中搜索目标元素),这个过程一直持续到数组为空或找到目标元素为止。
树是分治关系的代表,在二叉搜索树、AVL 树、堆等数据结构中,各种操作的时间复杂度皆为 。
二分查找的分治策略如下所示。
问题可以被分解:二分查找递归地将原问题(在数组中进行查找)分解为子问题(在数组的一半中进行查找),这是通过比较中间元素和目标元素来实现的。
子问题是独立的:在二分查找中,每轮只处理一个子问题,它不受另外子问题的影响。
子问题的解无须合并:二分查找旨在查找一个特定元素,因此不需要将子问题的解进行合并。当子问题得到解决时,原问题也会同时得到解决。
分治能够提升搜索效率,本质上是因为暴力搜索每轮只能排除一个选项,而分治搜索每轮可以排除一半选项。
之前 “十、搜索” 中的二分查找是基于递推(迭代/循环语句)实现的。以下是基于分治(递归)实现的
给定一个长度为 的有序数组
nums,数组中所有元素都是唯一的,请查找元素target。
从分治角度,我们将搜索区间 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j] 对应的子问题记为 。
从原问题 为起始点,通过以下步骤进行二分查找。
1. 和 2. 步,直至找到 target 或区间为空时返回。下图展示了在数组中二分查找元素 的分治过程。

使用一个递归函数 dfs() 来求解问题 ,即找到区间 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j]
/* 二分查找:问题 f(i, j) */int dfs(vector<int> &nums, int target, int i, int j) { // 若区间为空,代表无目标元素,则返回 -1 if (i > j) { return -1; } // 计算中点索引 m int m = (i + j) / 2; if (nums[m] < target) { // 递归子问题 f(m+1, j) return dfs(nums, target, m + 1, j); } else if (nums[m] > target) { // 递归子问题 f(i, m-1) return dfs(nums, target, i, m - 1); } else { // 找到目标元素,返回其索引 return m; }} /* 二分查找 */int binarySearch(vector<int> &nums, int target) { int n = nums.size(); // 求解问题 f(0, n-1) return dfs(nums, target, 0, n - 1);}给定一个二叉树的前序遍历
preorder和中序遍历inorder,请从中构建二叉树,返回二叉树的根节点。假设二叉树中没有值重复的节点。

原问题定义为从 preorder 和 inorder 构建二叉树,其是一个典型的分治问题。
问题可以被分解:从分治的角度切入,我们可以将原问题划分为两个子问题:构建左子树、构建右子树,加上一步操作:初始化根节点。而对于每个子树(子问题),我们仍然可以复用以上划分方法,将其划分为更小的子树(子问题),直至达到最小子问题(空子树)时终止。
子问题是独立的:左子树和右子树是相互独立的,它们之间没有交集。在构建左子树时,我们只需要关注中序遍历和前序遍历中与左子树对应的部分。右子树同理。
子问题的解可以合并:一旦得到了左子树和右子树(子问题的解),我们就可以将它们链接到根节点上,得到原问题的解。
根据以上分析,这道题是可以使用分治来求解的,但如何通过前序遍历 preorder 和中序遍历 inorder 来划分左子树和右子树呢?
根据定义,preorder 和 inorder 都可以被划分为三个部分。
前序遍历:[ 根节点 | 左子树 | 右子树 ] ,例如上图的树对应 [ 3 | 9 | 2 1 7 ] 。
中序遍历:[ 左子树 | 根节点 | 右子树 ] ,例如上图的树对应 [ 9 | 3 | 1 2 7 ] 。
以上图数据为例,我们可以通过下图所示的步骤得到划分结果。
inorder 中的索引,利用该索引可将 inorder 划分为 [ 9 | 3 | 1 2 7 ] 。inorder 划分结果,易得左子树和右子树的节点数量分别为 1 和 3 ,从而可将 preorder 划分为 [ 3 | 9 | 2 1 7 ] 。
根据以上划分方法,我们已经得到根节点、左子树、右子树在 preorder 和 inorder 中的索引区间。而为了描述这些索引区间,我们需要借助几个指针变量。
将当前树的根节点在 preorder 中的索引记为 。
将当前树的根节点在 inorder 中的索引记为 。
将当前树在 inorder 中的索引区间记为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲l, r] 。
如下表所示,通过以上变量即可表示根节点在 preorder 中的索引,以及子树在 inorder 中的索引区间。
表
根节点在 preorder 中的索引 |
子树在 inorder 中的索引区间 |
|
|---|---|---|
| 当前树 | ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲l, r] | |
| 左子树 | ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲l, m-1] | |
| 右子树 | ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲m+1, r] |
请注意,右子树根节点索引中的 的含义是“左子树的节点数量”,建议配合下图理解。

为了提升查询 的效率,我们借助一个哈希表 hmap 来存储数组 inorder 中元素到索引的映射。
/* 构建二叉树:分治 */TreeNode *dfs(vector<int> &preorder, unordered_map<int, int> &inorderMap, int i, int l, int r) { // 子树区间为空时终止 if (r - l < 0) return NULL; // 初始化根节点 TreeNode *root = new TreeNode(preorder[i]); // 查询 m ,从而划分左右子树 int m = inorderMap[preorder[i]]; // 子问题:构建左子树 root->left = dfs(preorder, inorderMap, i + 1, l, m - 1); // 子问题:构建右子树 root->right = dfs(preorder, inorderMap, i + 1 + m - l, m + 1, r); // 返回根节点 return root;} /* 构建二叉树 */TreeNode *buildTree(vector<int> &preorder, vector<int> &inorder) { // 初始化哈希表,存储 inorder 元素到索引的映射 unordered_map<int, int> inorderMap; for (int i = 0; i < inorder.size(); i++) { inorderMap[inorder[i]] = i; } TreeNode *root = dfs(preorder, inorderMap, 0, 0, inorder.size() - 1); return root;}下图展示了构建二叉树的递归过程,各个节点是在向下“递”的过程中建立的,而各条边(即引用)是在向上“归”的过程中建立的。
【GIF】
每个递归函数内的前序遍历 preorder 和中序遍历 inorder 的划分结果如下图所示。

设树的节点数量为 ,初始化每一个节点(执行一个递归函数 dfs() )使用 时间。因此总体时间复杂度为 。
哈希表存储 inorder 元素到索引的映射,空间复杂度为 。最差情况下,即二叉树退化为链表时,递归深度达到 ,使用 的栈帧空间。因此总体空间复杂度为 。
在之前的归并排序和构建二叉树中,我们都是将原问题一分为二来解决的,然而对于汉诺塔问题,我们要采用不同的分解策略
给定三根柱子,记为
A、B和C。起始状态下,柱子A上套着 个圆盘,它们从上到下按照从小到大的顺序排列。我们的任务是要把这 个圆盘移到柱子C上,并保持它们的原有顺序不变。在移动圆盘的过程中,需要遵守以下规则。
- 圆盘只能从一个柱子顶部拿出,从另一个柱子顶部放入。
- 每次只能移动一个圆盘。
- 小圆盘必须时刻位于大圆盘之上。

我们将规模为 的汉诺塔问题记做 。例如 代表将 个圆盘从 A 移动至 C 的汉诺塔问题。
如下图所示,对于问题 ,即当只有一个圆盘时,我们将它直接从 A 移动至 C 即可。
【GIF】
如下图所示,对于问题 ,即当有两个圆盘时,由于要时刻满足小圆盘在大圆盘之上,因此需要借助 B 来完成移动。
A 移至 B 。A 移至 C 。B 移至 C 。【GIF】
解决问题 的过程可总结为:将两个圆盘借助 B 从 A 移至 C 。其中,C 称为目标柱、B 称为缓冲柱。
对于问题 ,即当有三个圆盘时,情况变得稍微复杂了一些。
因为已知 和 的解,所以我们可从分治角度思考,将 A 顶部的两个圆盘看做一个整体,执行下图所示的步骤。这样三个圆盘就被顺利地从 A 移动至 C 了。
B 为目标柱、C 为缓冲柱,将两个圆盘从 A 移动至 B 。A 中剩余的一个圆盘从 A 直接移动至 C 。C 为目标柱、A 为缓冲柱,将两个圆盘从 B 移动至 C 。【GIF】
本质上看,我们将问题 划分为两个子问题 和子问题 。按顺序解决这三个子问题之后,原问题随之得到解决。这说明子问题是独立的,而且解是可以合并的。
至此,我们可总结出下图所示的汉诺塔问题的分治策略:将原问题 划分为两个子问题 和一个子问题 ,并按照以下顺序解决这三个子问题。
C 从 A 移至 B 。A 直接移至 C 。A 从 B 移至 C 。对于这两个子问题 ,可以通过相同的方式进行递归划分,直至达到最小子问题 。而 的解是已知的,只需一次移动操作即可。

/* 移动一个圆盘 */void move(vector<int> &src, vector<int> &tar) { // 从 src 顶部拿出一个圆盘 int pan = src.back(); src.pop_back(); // 将圆盘放入 tar 顶部 tar.push_back(pan);} /* 求解汉诺塔问题 f(i) */void dfs(int i, vector<int> &src, vector<int> &buf, vector<int> &tar) { // 若 src 只剩下一个圆盘,则直接将其移到 tar if (i == 1) { move(src, tar); return; } // 子问题 f(i-1) :将 src 顶部 i-1 个圆盘借助 tar 移到 buf dfs(i - 1, src, tar, buf); // 子问题 f(1) :将 src 剩余一个圆盘移到 tar move(src, tar); // 子问题 f(i-1) :将 buf 顶部 i-1 个圆盘借助 src 移到 tar dfs(i - 1, buf, src, tar);} /* 求解汉诺塔问题 */void solveHanota(vector<int> &A, vector<int> &B, vector<int> &C) { int n = A.size(); // 将 A 顶部 n 个圆盘借助 B 移到 C dfs(n, A, B, C);}如下图所示,汉诺塔问题形成一个高度为 的递归树,每个节点代表一个子问题、对应一个开启的 dfs() 函数,因此时间复杂度为 ,空间复杂度为 。

汉诺塔问题源自一种古老的传说故事。在古印度的一个寺庙里,僧侣们有三根高大的钻石柱子,以及 个大小不一的金圆盘。僧侣们不断地移动原盘,他们相信在最后一个圆盘被正确放置的那一刻,这个世界就会结束。
然而,即使僧侣们每秒钟移动一次,总共需要大约 秒,合约 亿年,远远超过了现在对宇宙年龄的估计。所以,倘若这个传说是真的,我们应该不需要担心世界末日的到来。
分治算法是一种常见的算法设计策略,包括分(划分)和治(合并)两个阶段,通常基于递归实现。
判断是否是分治算法问题的依据包括:问题能否被分解、子问题是否独立、子问题是否可以被合并。
归并排序是分治策略的典型应用,其递归地将数组划分为等长的两个子数组,直到只剩一个元素时开始逐层合并,从而完成排序。
引入分治策略往往可以带来算法效率的提升。一方面,分治策略减少了操作数量;另一方面,分治后有利于系统的并行优化。
分治既可以解决许多算法问题,也广泛应用于数据结构与算法设计中,处处可见其身影。
相较于暴力搜索,自适应搜索效率更高。时间复杂度为 的搜索算法通常都是基于分治策略实现的。
二分查找是分治策略的另一个典型应用,它不包含将子问题的解进行合并的步骤。我们可以通过递归分治实现二分查找。
在构建二叉树问题中,构建树(原问题)可以被划分为构建左子树和右子树(子问题),其可以通过划分前序遍历和中序遍历的索引区间来实现。
在汉诺塔问题中,一个规模为 的问题可以被划分为两个规模为 的子问题和一个规模为 的子问题。按顺序解决这三个子问题后,原问题随之得到解决。
遇到死路就回溯回去重新开始,不断尝试,直到找到出口
「回溯算法 backtracking algorithm」是一种通过穷举来解决问题的方法,它的核心思想是从一个初始状态出发,暴力搜索所有可能的解方案,当遇到正解则将其记录,直到找到阶或遍历完所有可能都无法找到解为止
其通常采用 “深度优先搜索” 来遍历,在二叉树中,前中后序遍历都属于深度优先搜索。
给定一个二叉树,搜索并记录所有值为 的节点,请返回节点列表。(利用前序遍历构造一个回溯问题)
对于这题,只要前序遍历这棵树,并判断当前节点的值是否为 ,若是则将该节点的值加入到结果列表 res 之中
/* 前序遍历:例题一 */void preOrder(TreeNode *root) { if (root == nullptr) { return; } if (root->val == 7) { // 记录解 res.push_back(root); } preOrder(root->left); preOrder(root->right);}
之所以称之为回溯算法,是因为该算法在搜索解空间时会采用“尝试”与“回退”的策略。当算法在搜索过程中遇到某个状态无法继续前进或无法得到满足条件的解时,它会撤销上一步的选择,退回到之前的状态,并尝试其他可能的选择。
如上题,访问每个节点都代表一次“尝试”,而越过叶节点或返回父节点的 return 则表示“回退”。(这和深度优先搜索很相似)
但是,**回退并不仅仅包括函数在栈空间的返回,而是一种方法的操作名称,**包括函数返回、状态恢复、选择点跳转、回溯标记等等。这些操作都是为了探索解空间并找到问题的最优解而设计的。
在二叉树中搜索所有值为 的节点,请返回根节点到这些节点的路径。
对此,我们只要在上一题的基础上,借助一个列表 path 记录访问过的节点路径。当访问到值为 的节点时,则复制列表 path 并添加进结果列表 res 。遍历完成后,res 中保存的就是所有的解。
/* 前序遍历:例题二 */void preOrder(TreeNode *root) { if (root == nullptr) { return; } // 尝试 path.push_back(root); if (root->val == 7) { // 记录解 res.push_back(path); } preOrder(root->left); preOrder(root->right); // 回退 path.pop_back();}在每次“尝试”中,我们通过将当前节点添加进 path 来记录路径;而在“回退”前,我们需要将该节点从 path 中弹出,以恢复本次尝试之前的状态。
【GIF】
以上都是解释回退是一个包括多种操作的名称
复杂的回溯问题通常包含一个或多个约束条件,解决约束条件的方法通常使用“剪枝”
在二叉树中搜索所有值为 的节点,请返回根节点到这些节点的路径,并要求路径中不包含值为 的节点。
对于这道题,我们需要在原先的基础上添加剪枝操作:
即在搜索过程中,若遇到值为 的节点,则提前返回,停止继续搜索。
/* 前序遍历:例题三 */void preOrder(TreeNode *root) { // 剪枝 if (root == nullptr || root->val == 3) { return; } // 尝试 path.push_back(root); if (root->val == 7) { // 记录解 res.push_back(path); } preOrder(root->left); preOrder(root->right); // 回退 path.pop_back();}“剪枝” 顾名思义,在搜索过程中,我们“剪掉”了不满足约束条件的搜索分支,避免许多无意义的尝试,从而提高了搜索效率。

将以上操作的主体框架提炼出来如下:
其中state 表示问题的当前状态,choices 表示当前状态下可以做出的选择
/* 回溯算法框架 */void backtrack(State *state, vector<Choice *> &choices, vector<State *> &res) { // 判断是否为解 if (isSolution(state)) { // 记录解 recordSolution(state, res); // 不再继续搜索的话要加它 return; } // 遍历所有选择 for (Choice choice : choices) { // 剪枝:判断选择是否合法 if (isValid(state, choice)) { // 尝试:做出选择,更新状态 makeChoice(state, choice); /* 要做的步骤 */ // 递归 backtrack(state, choices, res); // 回退:撤销选择,恢复到之前的状态 undoChoice(state, choice); } }}上题的完整代码如下:
/* 判断当前状态是否为解 */bool isSolution(vector<TreeNode *> &state) { return !state.empty() && state.back()->val == 7;} /* 记录解 */void recordSolution(vector<TreeNode *> &state, vector<vector<TreeNode *>> &res) { res.push_back(state);} /* 判断在当前状态下,该选择是否合法 */bool isValid(vector<TreeNode *> &state, TreeNode *choice) { return choice != nullptr && choice->val != 3;} /* 更新状态 */void makeChoice(vector<TreeNode *> &state, TreeNode *choice) { state.push_back(choice);} /* 恢复状态 */void undoChoice(vector<TreeNode *> &state, TreeNode *choice) { state.pop_back();} /* 回溯算法:例题三 */void backtrack(vector<TreeNode *> &state, vector<TreeNode *> &choices, vector<vector<TreeNode *>> &res) { // 检查是否为解 if (isSolution(state)) { // 记录解 recordSolution(state, res); } // 遍历所有选择 for (TreeNode *choice : choices) { // 剪枝:检查选择是否合法 if (isValid(state, choice)) { // 尝试:做出选择,更新状态 makeChoice(state, choice); // 进行下一轮选择 vector<TreeNode *> nextChoices{choice->left, choice->right}; backtrack(state, nextChoices, res); // 回退:撤销选择,恢复到之前的状态 undoChoice(state, choice); } }}注:因为根据题意,我们在找到值为 7 的节点后应该继续搜索,因此需要将记录解之后的 return 语句删除
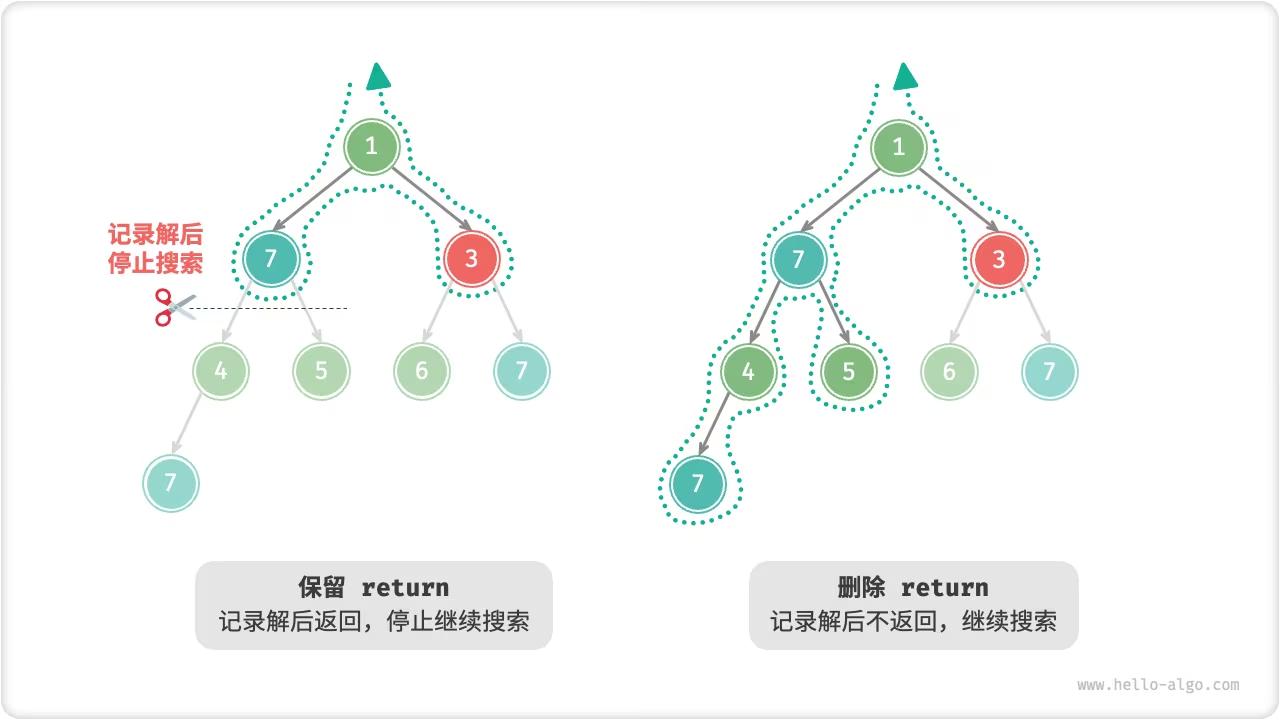
相比于直接基于前序遍历的代码实现,使用回溯算法模板虽然更繁琐,但通用性更好,实际上,许多回溯问题可以在该框架下解决,执行根据具体问题具体分析,改变 state 和 choices ,并实现框架中的各个方法即可
回溯算法中的常用术语
| 名词 | 定义 | 例题三 |
|---|---|---|
| 解 Solution | 解是满足问题特定条件的答案,可能有一个或多个 | 根节点到节点 的满足约束条件的所有路径 |
| 约束条件 Constraint | 约束条件是问题中限制解的可行性的条件,通常用于剪枝 | 路径中不包含节点 |
| 状态 State | 状态表示问题在某一时刻的情况,包括已经做出的选择 | 当前已访问的节点路径,即 path 节点列表 |
| 尝试 Attempt | 尝试是根据可用选择来探索解空间的过程,包括做出选择,更新状态,检查是否为解 | 递归访问左(右)子节点,将节点添加进 path ,判断节点的值是否为 |
| 回退 Backtracking | 回退指遇到不满足约束条件的状态时,撤销前面做出的选择,回到上一个状态 | 当越过叶节点、结束节点访问、遇到值为 的节点时终止搜索,函数返回 |
| 剪枝 Pruning | 剪枝是根据问题特性和约束条件避免无意义的搜索路径的方法,可提高搜索效率 | 当遇到值为 的节点时,则终止继续搜索 |
问题、解、状态等概念是通用的,在分治、回溯、动态规划、贪心等算法中都有涉及。
回溯算法本质上术语一种深度优先算法,它尝试所有可能的解决方案直到找到满足条件的解。这种方法的优点在于能够找到所有可能的解决方案,而且在合理的剪枝操作下,具有很高的效率。
然而,在处理大规模或者复杂问题时,回溯算法的运行效率可能难以接受。
时间:回溯算法通常需要遍历状态空间的所有可能,时间复杂度可以达到指数阶或阶乘阶。
空间:在递归调用中需要保存当前的状态(例如路径、用于剪枝的辅助变量等),当深度很大时,空间需求可能会变得很大。
即便如此,回溯算法仍然是某些搜索问题和约束满足问题的最佳解决方案。对于这些问题,由于无法预测哪些选择可生成有效的解,因此我们必须对所有可能的选择进行遍历。在这种情况下,关键是如何优化效率,常见的效率优化方法有两种。
剪枝:避免搜索那些肯定不会产生解的路径,从而节省时间和空间。
启发式搜索:在搜索过程中引入一些策略或者估计值(权重),从而优先搜索最有可能产生有效解的路径。
回溯算法可用于解决许多搜索问题、约束满足问题和组合优化问题。
搜索问题:这类问题的目标是找到满足特定条件的解决方案。
全排列问题:给定一个集合,求出其所有可能的排列组合。
子集和问题:给定一个集合和一个目标和,找到集合中所有和为目标和的子集。
汉诺塔问题:给定三个柱子和一系列大小不同的圆盘,要求将所有圆盘从一个柱子移动到另一个柱子,每次只能移动一个圆盘,且不能将大圆盘放在小圆盘上。
约束满足问题:这类问题的目标是找到满足所有约束条件的解。
皇后:在 的棋盘上放置 个皇后,使得它们互不攻击。
数独:在 的网格中填入数字 ~ ,使得每行、每列和每个 子网格中的数字不重复。
图着色问题:给定一个无向图,用最少的颜色给图的每个顶点着色,使得相邻顶点颜色不同。
组合优化问题:这类问题的目标是在一个组合空间中找到满足某些条件的最优解。
0-1 背包问题:给定一组物品和一个背包,每个物品有一定的价值和重量,要求在背包容量限制内,选择物品使得总价值最大。
旅行商问题:在一个图中,从一个点出发,访问所有其他点恰好一次后返回起点,求最短路径。
最大团问题:给定一个无向图,找到最大的完全子图,即子图中的任意两个顶点之间都有边相连。
注:对于以上组合优化问题,回溯都不是最优解决方案。
0-1 背包问题通常使用动态规划解决,以达到更高的时间效率。
旅行商是一个著名的 NP-Hard 问题,常用解法有遗传算法和蚁群算法等。
最大团问题是图论中的一个经典问题,可用贪心等启发式算法来解决。
全排列问题是回溯算法的一个典型应用。它的定义是:在给定的一个集合(如一个数组或字符串)的情况下,找出其中元素的索引可能的排列。
如下例子:
| 输入数组 | 所有排列 |
|---|---|
| ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲1] | ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲1] |
| ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲1, 2] | ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲1, 2], \[2, 1] |
| ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲1, 2, 3] | ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲1, 2, 3], \[1, … |
输入一个整数数组,其中不包含重复元素,返回所有可能的排列。
从回溯算法的角度来看,**我们可以把生成排列的过程想象成一系列选择的结果。**假设输入数组为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲1,2,3],如果我们先选择 ,再选择 ,最后选择 ,则获得排列 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲1,3,2]。回退表示撤回一个选择,之后继续尝试其他选择
从回溯代码的角度来看,候选集合 choices 是输入数组中的所有元素,状态 state 是直至目前已被选择的元素。请注意,每个元素只允许被选择一次,因此 state 中的所有元素都应该是唯一的。
如下图所示,我们可以将搜索过程展开成一个递归树,树中的每个节点代表当前状态 state 。从根节点开始,经过三轮选择后到达叶节点,每个叶节点都对应一个排列。
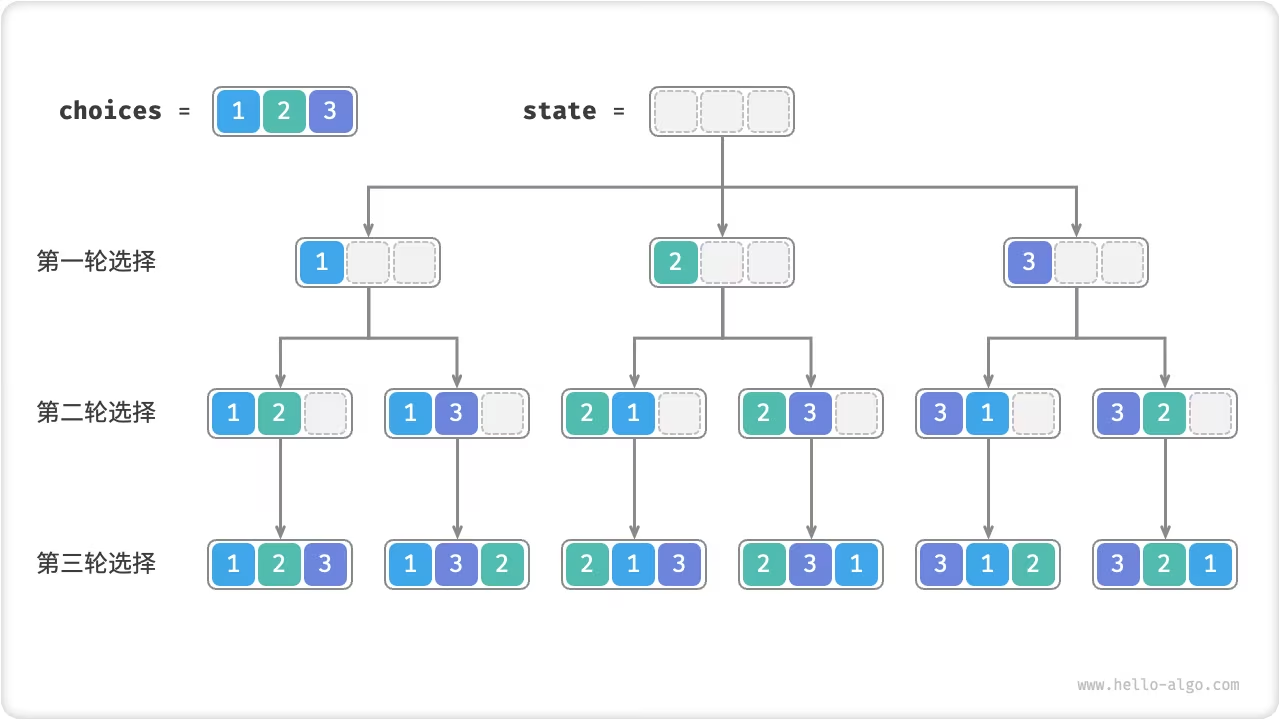
为了实现每个元素只被选择一次,我们考虑引入一个布尔型数组 selected ,其中 selected[i] 表示 choices[i] 是否已被选择,并基于它实现以下剪枝操作。
在做出选择 choice[i] 后,我们就将 selected[i] 赋值为 ,代表它已被选择。
遍历选择列表 choices 时,跳过所有已被选择过的节点,即剪枝。
如下图所示,假设我们第一轮选择 1 ,第二轮选择 3 ,第三轮选择 2 ,则需要在第二轮剪掉元素 1 的分支,在第三轮剪掉元素 1 和元素 3 的分支。
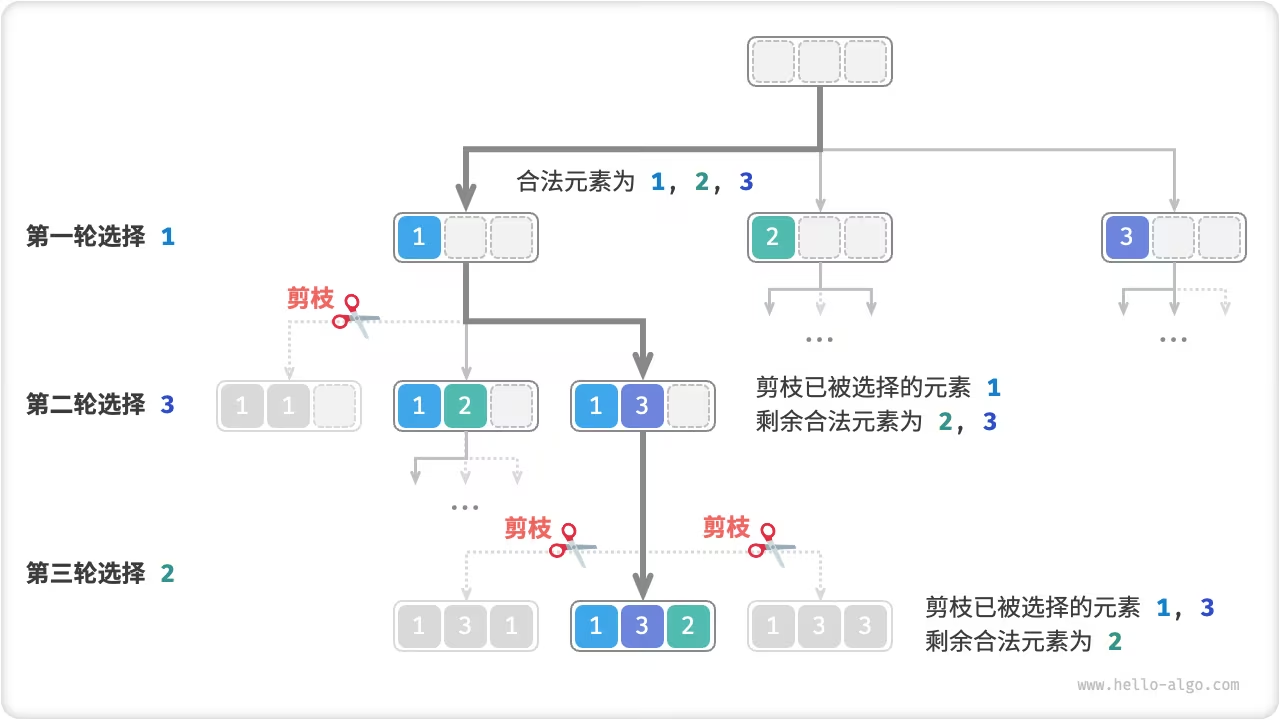
由上图可知,该剪枝操作将搜索空间大小从 降低至 。
/* 回溯算法:全排列 I */void backtrack(vector<int> &state, const vector<int> &choices, vector<bool> &selected, vector<vector<int>> &res) { // 当状态长度等于元素数量时,记录解 if (state.size() == choices.size()) { res.push_back(state); return; } // 遍历所有选择 for (int i = 0; i < choices.size(); i++) { int choice = choices[i]; // 剪枝:不允许重复选择元素 if (!selected[i]) { // 尝试:做出选择,更新状态 selected[i] = true; state.push_back(choice); // 进行下一轮选择 backtrack(state, choices, selected, res); // 回退:撤销选择,恢复到之前的状态 selected[i] = false; state.pop_back(); } }} /* 全排列 I */vector<vector<int>> permutationsI(vector<int> nums) { vector<int> state; vector<bool> selected(nums.size(), false); vector<vector<int>> res; backtrack(state, nums, selected, res); //上面的函数 return res;}输入一个整数数组,数组中可能包含重复元素,返回所有不重复的排列。
假设输入数组为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲1, 1, 2] 。为了方便区分两个重复元素 ,我们将第二个 记为 。
如下图所示,上述方法生成的排列有一半都是重复的。
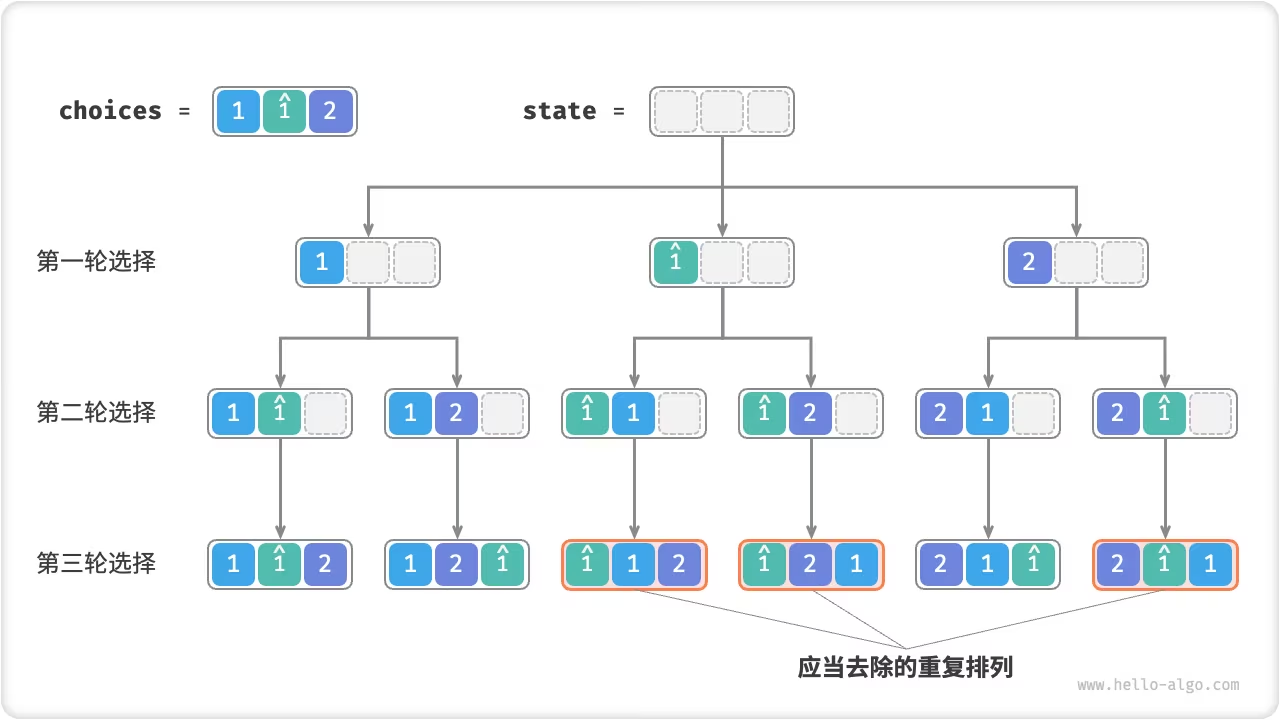
为了去重,第一种方法,也就是最简单的方法就是借助一个哈希表,直接对排列结果进行去重。但其效率低,又因为生成重复排列的搜索分支没有必要,应当提前识别并剪枝,这样可以进一步提升算法效率。
观察下图,在第一轮中,选择 或选择 是等价的,在这两个选择之下生成的所有排列都是重复的。因此应该把 剪枝掉。
同理,在第一轮选择 之后,第二轮选择中的 和 也会产生重复分支,因此也应将第二轮的 剪枝。
本质上看,我们的目标是在某一轮选择中,保证多个相等的元素仅被选择一次。
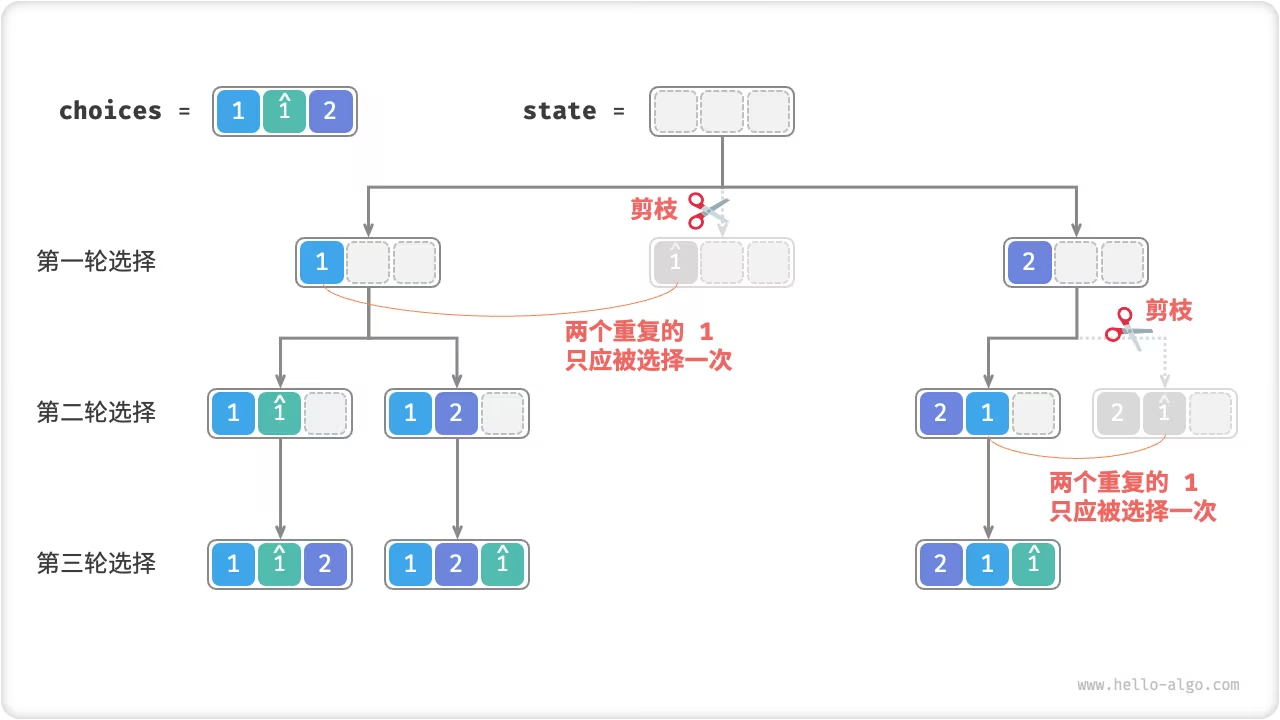
只要在上一题代码的基础上,在每轮选择时开启一个哈希表 duplicated ,用于记录该轮中已经尝试过的元素,并将重复元素剪枝即可
/* 回溯算法:全排列 II */void backtrack(vector<int> &state, const vector<int> &choices, vector<bool> &selected, vector<vector<int>> &res) { // 当状态长度等于元素数量时,记录解 if (state.size() == choices.size()) { res.push_back(state); return; } // 遍历所有选择 unordered_set<int> duplicated; for (int i = 0; i < choices.size(); i++) { int choice = choices[i]; // duplicated的部分是多出来的 // 剪枝:不允许重复选择元素 且 不允许重复选择相等元素 if (!selected[i] && duplicated.find(choice) == duplicated.end()) { // 尝试:做出选择,更新状态 duplicated.emplace(choice); // 记录选择过的元素值 selected[i] = true; state.push_back(choice); // 进行下一轮选择 backtrack(state, choices, selected, res); // 回退:撤销选择,恢复到之前的状态 selected[i] = false; state.pop_back(); } }} /* 全排列 II */vector<vector<int>> permutationsII(vector<int> nums) { vector<int> state; vector<bool> selected(nums.size(), false); vector<vector<int>> res; backtrack(state, nums, selected, res); return res;}假设元素两两之间互不相同,则 个元素共有 种排列(阶乘);在记录结果时,需要复制长度为 的列表,使用 时间。因此时间复杂度为 。
最大递归深度为 ,使用 栈帧空间。selected 使用 空间。同一时刻最多共有 个 duplicated ,使用 空间。因此空间复杂度为 。
虽然 selected 和 duplicated 都用作剪枝,但两者的目标是不同的。
重复选择剪枝:整个搜索过程中只有一个 selected 。它记录的是当前状态中包含哪些元素,作用是防止 choices 中的任一元素在 state 中重复出现。
相等元素剪枝:每轮选择(即每个调用的 backtrack 函数)都包含一个 duplicated 。它记录的是在本轮遍历(即 for 循环)中哪些元素已被选择过,作用是保证相等的元素只被选择一次。
下图展示了两个剪枝条件的生效范围。注意,树中的每个节点代表一个选择,从根节点到叶节点的路径上的各个节点构成一个排列

给定一个正整数数组
nums和一个目标正整数target,请找出所有可能的组合,使得组合中的元素和等于target。给定数组无重复元素,每个元素可以被选取多次。请以列表形式返回这些组合,列表中不应包含重复组合。
例如,输入集合 和目标整数 ,解为 。需要注意以下两点。
输入集合中的元素可以被无限次重复选取。
子集是不区分元素顺序的,比如 和 是同一个子集。
只是在选择过程中实时更新 “元素和” 当元素和等于目标元素 target 时,就将子集记录至结果列表。
而与全排列问题不同的是,本题集合中的元素可以被无限次选取,因此无须借助 selected 布尔列表来记录元素是否已被选择。我们可以对全排列代码进行小幅修改,初步得到解题代码。
/* 回溯算法:子集和 I */void backtrack(vector<int> &state, int target, int total, vector<int> &choices, vector<vector<int>> &res) { // 子集和等于 target 时,记录解 if (total == target) { res.push_back(state); return; } // 遍历所有选择 for (size_t i = 0; i < choices.size(); i++) { // 剪枝:若子集和超过 target ,则跳过该选择 if (total + choices[i] > target) { continue; } // 尝试:做出选择,更新元素和 total state.push_back(choices[i]); // 进行下一轮选择 backtrack(state, target, total + choices[i], choices, res); // 回退:撤销选择,恢复到之前的状态 state.pop_back(); }} /* 求解子集和 I(包含重复子集) */vector<vector<int>> subsetSumINaive(vector<int> &nums, int target) { vector<int> state; // 状态(子集) int total = 0; // 子集和 vector<vector<int>> res; // 结果列表(子集列表) backtrack(state, target, total, nums, res); return res;}向以上代码输入数组 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲3, 4, 5] 和目标元素 ,输出结果为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲3, 3, 3], \[4, … 。虽然成功找出了所有和为 的子集,但其中存在重复的子集 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲4, 5] 和 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲5, 4] 。
这是因为搜索过程是区分选择顺序的,然而子集不区分选择顺序。如下图所示,先选 后选 与先选 后选 是两个不同的分支,但两者对应同一个子集。
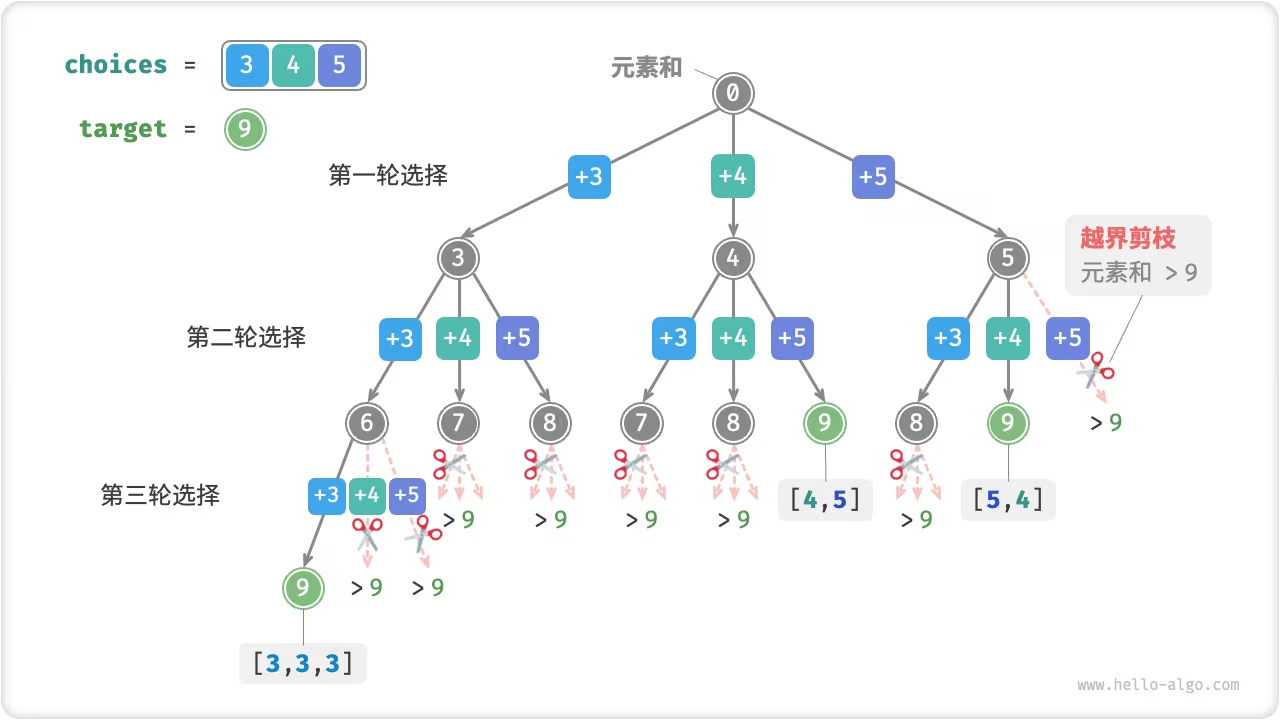
为了去除重复子集,一种直接的思路是对结果列表进行去重。但这个方法效率很低,有两方面原因。
当数组元素较多,尤其是当 target 较大时,搜索过程会产生大量的重复子集。
比较子集(数组)的异同非常耗时,需要先排序数组,再比较数组中每个元素的异同。
我们考虑在搜索过程中通过剪枝进行去重。观察下图,重复子集是在以不同顺序选择数组元素时产生的,例如以下情况。
1. 中生成的子集完全重复。在搜索中,每一层的选择都是从左到右被逐个尝试的,因此越靠右的分支被剪掉的越多。
1. 和 2. 步中描述的子集完全重复。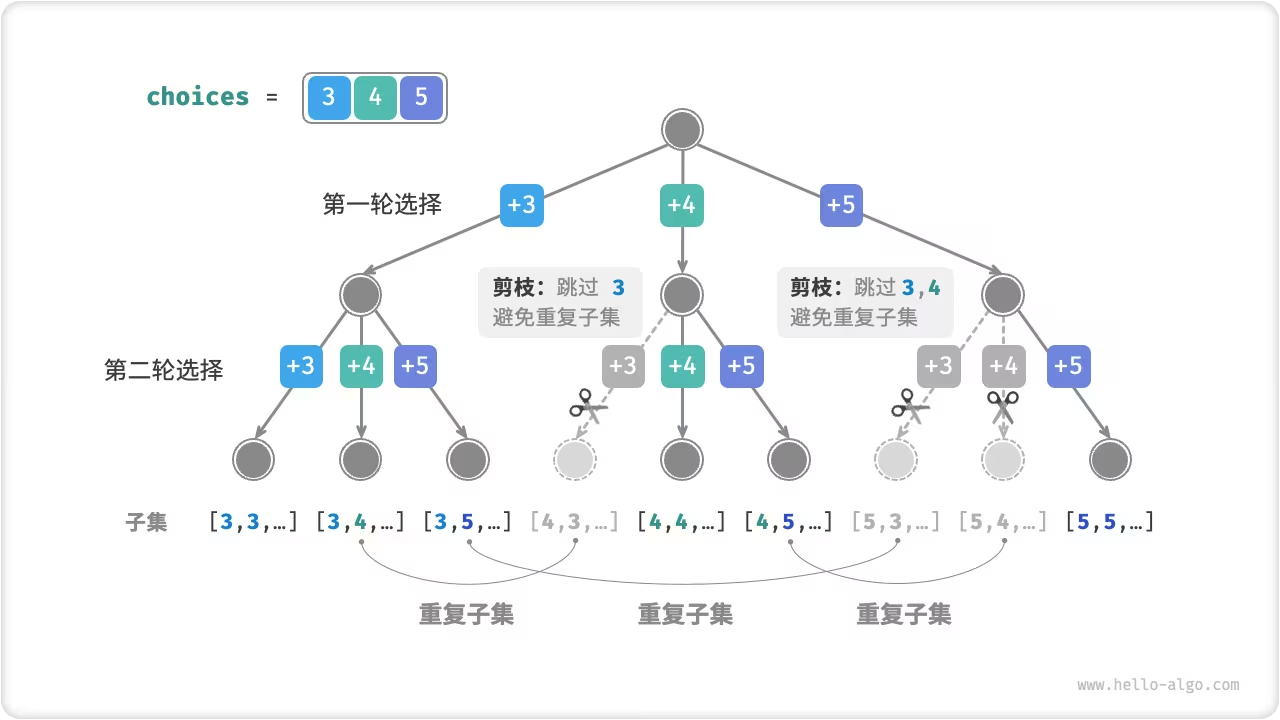
总结来看,给定输入数组 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲x\_1, x\_2, \do… ,设搜索过程中的选择序列为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲x\_{i\_1}, x\_{… ,则该选择序列需要满足 ,不满足该条件的选择序列都会造成重复,应当剪枝。
为实现该剪枝,我们初始化变量 start ,用于指示遍历起点。当做出选择 后,设定下一轮从索引 开始遍历。这样做就可以让选择序列满足 ,从而保证子集唯一。
除此之外,我们还对代码进行了以下两项优化。
在开启搜索前,先将数组 nums 排序。在遍历所有选择时,当子集和超过 target 时直接结束循环,因为后边的元素更大,其子集和都一定会超过 target 。
省去元素和变量 total ,通过在 target 上执行减法来统计元素和,当 target 等于 时记录解。
/* 回溯算法:子集和 I */void backtrack(vector<int> &state, int target, vector<int> &choices, int start, vector<vector<int>> &res) { // 子集和等于 target 时,记录解 if (target == 0) { res.push_back(state); return; } // 遍历所有选择 // 剪枝二:从 start 开始遍历,避免生成重复子集 for (int i = start; i < choices.size(); i++) { // 剪枝一:若子集和超过 target ,则直接结束循环 // 这是因为数组已排序,后边元素更大,子集和一定超过 target if (target - choices[i] < 0) { break; } // 尝试:做出选择,更新 target, start state.push_back(choices[i]); // 进行下一轮选择 backtrack(state, target - choices[i], choices, i, res); // 回退:撤销选择,恢复到之前的状态 state.pop_back(); }} /* 求解子集和 I */vector<vector<int>> subsetSumI(vector<int> &nums, int target) { vector<int> state; // 状态(子集) sort(nums.begin(), nums.end()); // 对 nums 进行排序 int start = 0; // 遍历起始点 vector<vector<int>> res; // 结果列表(子集列表) backtrack(state, target, nums, start, res); return res;}如下图所示,为将数组 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲3, 4, 5] 和目标元素 输入到以上代码后的整体回溯过程。
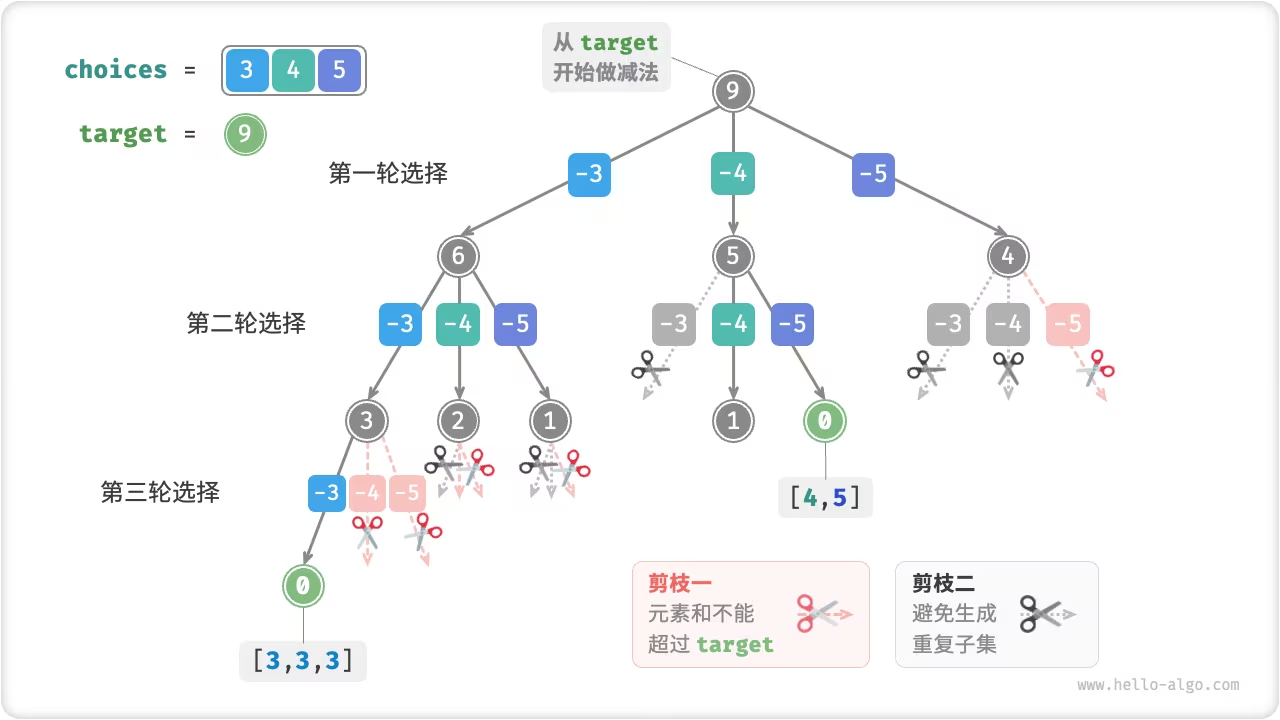
给定一个正整数数组
nums和一个目标正整数target,请找出所有可能的组合,使得组合中的元素和等于target。给定数组可能包含重复元素,每个元素只可被选择一次。请以列表形式返回这些组合,列表中不应包含重复组合。
相比于上题,本题的输入数组可能包含重复元素,这引入了新的问题。例如,给定数组 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲4, \hat{4}, 5] 和目标元素 ,则现有代码的输出结果为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲4, 5], \[\hat{4… ,出现了重复子集。
造成这种重复的原因是相等元素在某轮中被多次选择。在下图中,第一轮共有三个选择,其中两个都为 ,会产生两个重复的搜索分支,从而输出重复子集;同理,第二轮的两个 也会产生重复子集。

为解决此问题,我们需要限制相等元素在每一轮中只被选择一次。实现方式比较巧妙:由于数组是已排序的,因此相等元素都是相邻的。这意味着在某轮选择中,若当前元素与其左边元素相等,则说明它已经被选择过,因此直接跳过当前元素。
与此同时,本题规定数组中的每个元素只能被选择一次。幸运的是,我们也可以利用变量 start 来满足该约束:当做出选择 后,设定下一轮从索引 开始向后遍历。这样即能去除重复子集,也能避免重复选择元素。
/* 回溯算法:子集和 II */void backtrack(vector<int> &state, int target, vector<int> &choices, int start, vector<vector<int>> &res) { // 子集和等于 target 时,记录解 if (target == 0) { res.push_back(state); return; } // 遍历所有选择 // 剪枝二:从 start 开始遍历,避免生成重复子集 // 剪枝三:从 start 开始遍历,避免重复选择同一元素 for (int i = start; i < choices.size(); i++) { // 剪枝一:若子集和超过 target ,则直接结束循环 // 这是因为数组已排序,后边元素更大,子集和一定超过 target if (target - choices[i] < 0) { break; } // 剪枝四:如果该元素与左边元素相等,说明该搜索分支重复,直接跳过 if (i > start && choices[i] == choices[i - 1]) { continue; } // 尝试:做出选择,更新 target, start state.push_back(choices[i]); // 进行下一轮选择 backtrack(state, target - choices[i], choices, i + 1, res); // 回退:撤销选择,恢复到之前的状态 state.pop_back(); }} /* 求解子集和 II */vector<vector<int>> subsetSumII(vector<int> &nums, int target) { vector<int> state; // 状态(子集) sort(nums.begin(), nums.end()); // 对 nums 进行排序 int start = 0; // 遍历起始点 vector<vector<int>> res; // 结果列表(子集列表) backtrack(state, target, nums, start, res); return res;}下图展示了数组 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲4, 4, 5] 和目标元素 的回溯过程,共包含四种剪枝操作。请你将图示与代码注释相结合,理解整个搜索过程,以及每种剪枝操作是如何工作的。
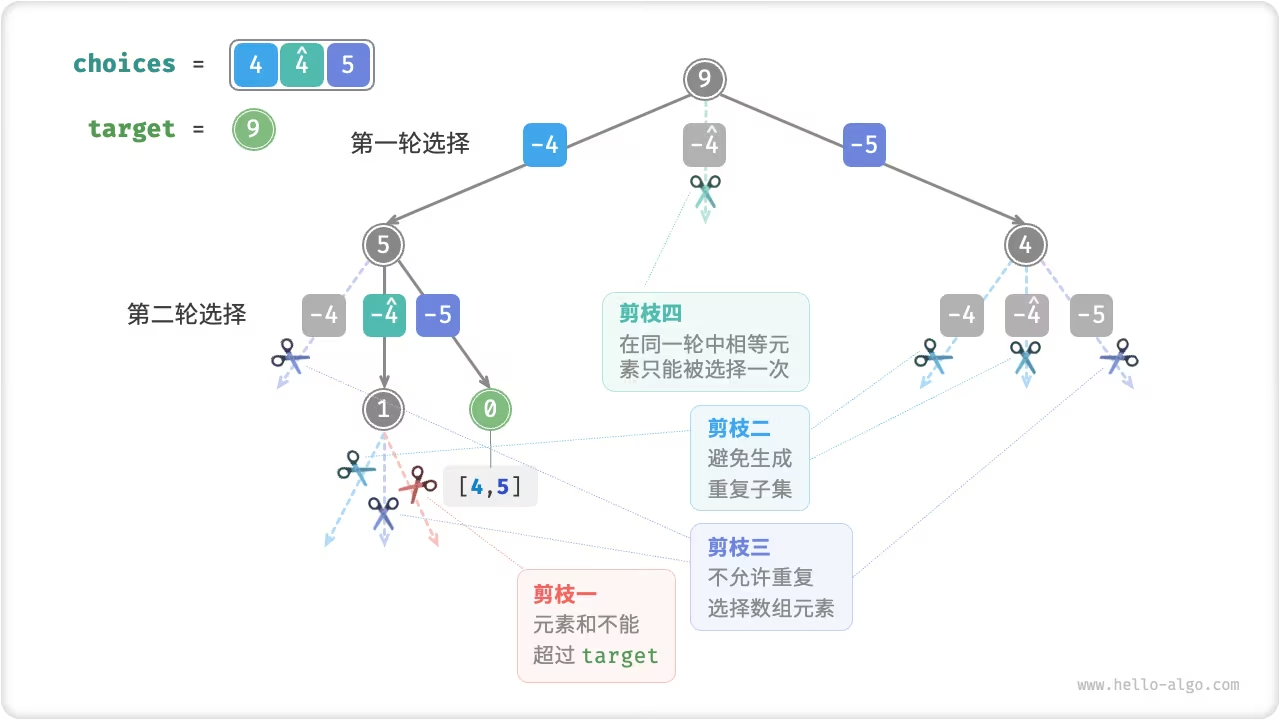
根据国际象棋的规则,皇后可以攻击与之处在同一行或同一列或同一斜线上的棋子。给定 个皇后和一个 大小的棋盘,寻找使得所有皇后之间无法相互攻击的摆放方案。
如下图所示,当 时,共可以找到两个解。从回溯算法的角度看, 大小的棋盘共有 个格子,给出了所有的选择 choices 。在逐个放置皇后的过程中,棋盘状态在不断地变化,每个时刻的棋盘就是状态 state 。
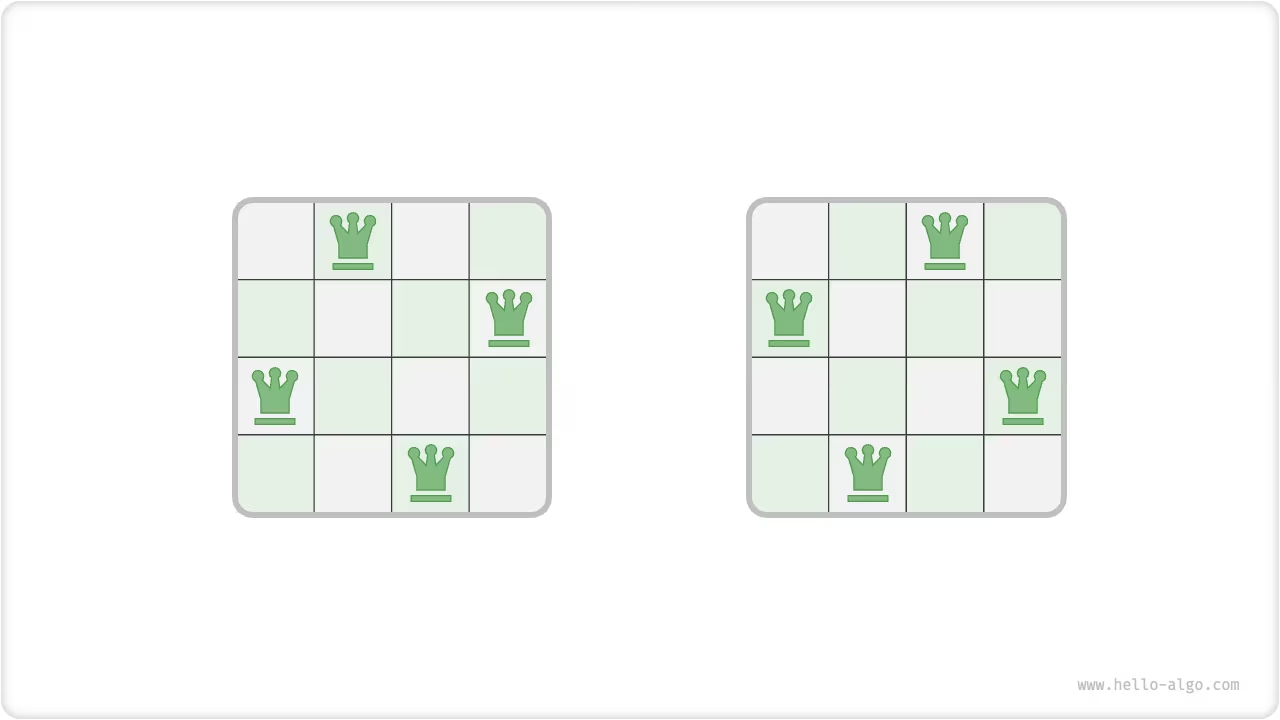
下图展示了本题的三个约束条件:多个皇后不能在同一行、同一列、同一对角线。值得注意的是,对角线分为主对角线 \ 和次对角线 / 两种。
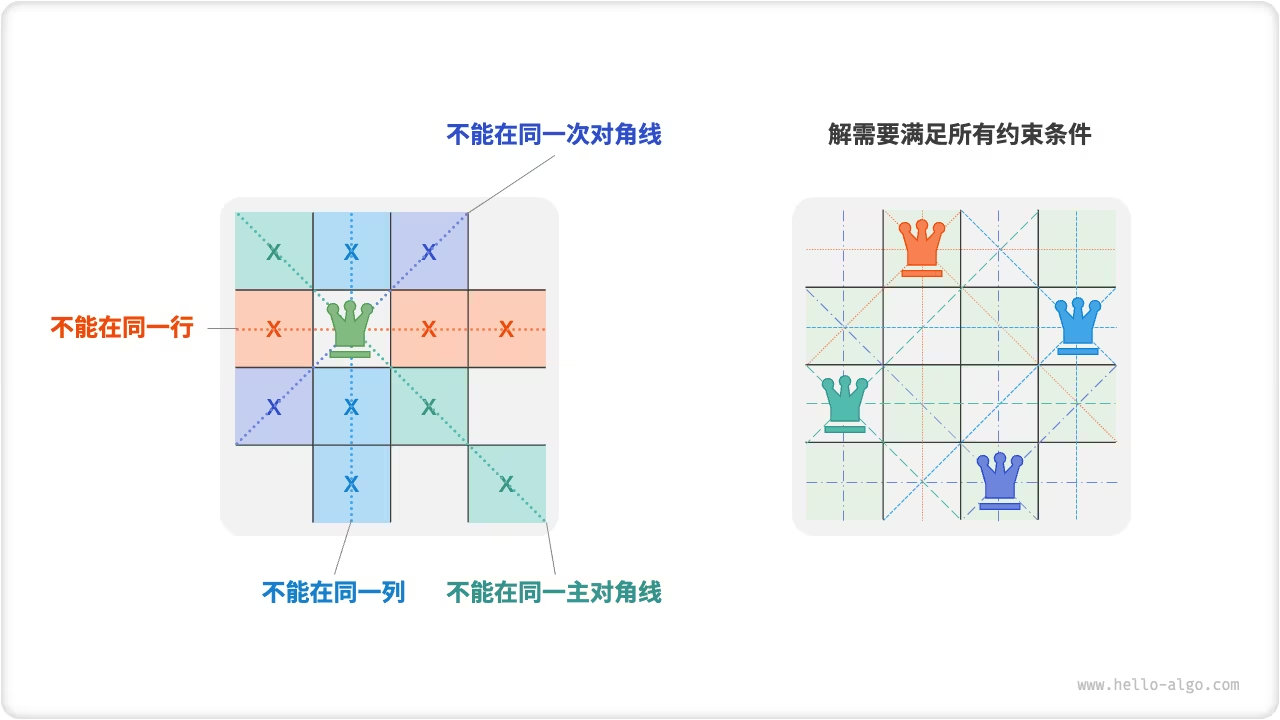
皇后的数量和棋盘的行数都为 ,因此我们容易得到一个推论:棋盘每行都允许且只允许放置一个皇后。
也就是说,我们可以采取逐行放置策略:从第一行开始,在每行放置一个皇后,直至最后一行结束。
如下图所示,为 皇后问题的逐行放置过程。受画幅限制,下图仅展开了第一行的其中一个搜索分支,并且将不满足列约束和对角线约束的方案都进行了剪枝。
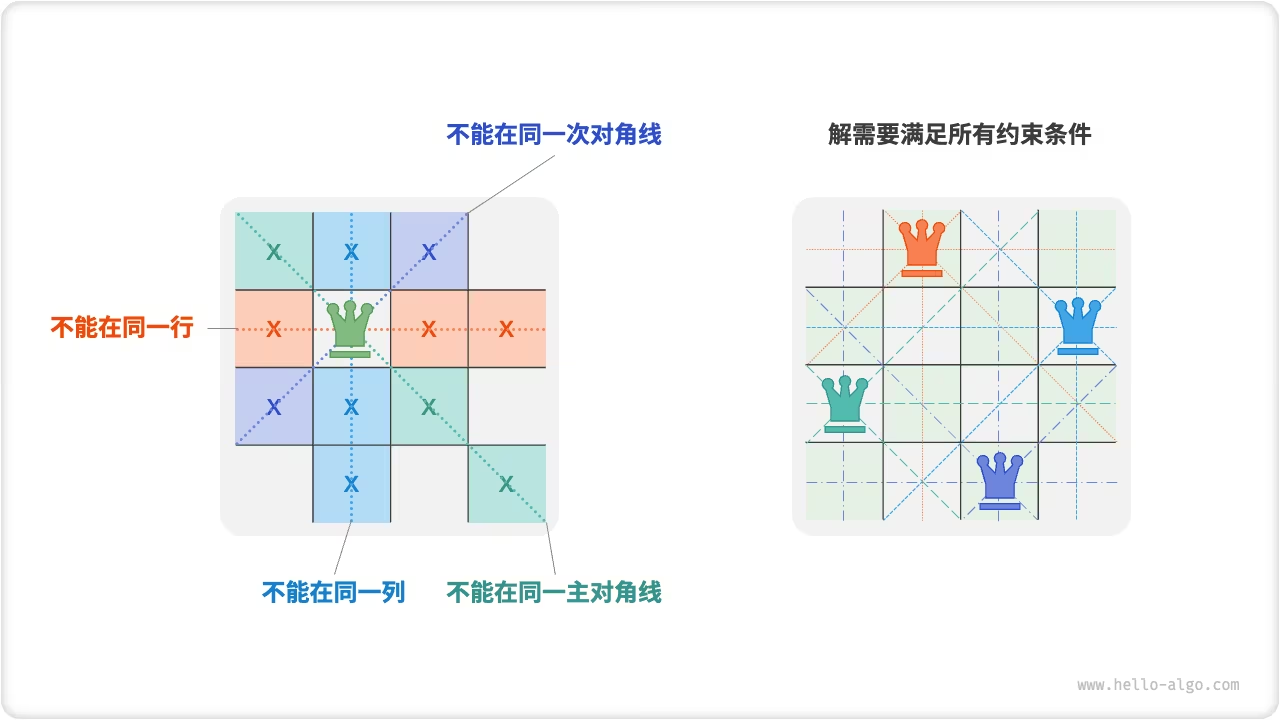
本质上看,逐行放置策略起到了剪枝的作用,它避免了同一行出现多个皇后的所有搜索分支。
为了满足列约束,我们可以利用一个长度为 的布尔型数组 cols 记录每一列是否有皇后。在每次决定放置前,我们通过 cols 将已有皇后的列进行剪枝,并在回溯中动态更新 cols 的状态。
那么,如何处理对角线约束呢?设棋盘中某个格子的行列索引为 ,选定矩阵中的某条主对角线,我们发现该对角线上所有格子的行索引减列索引都相等,即对角线上所有格子的 为恒定值。
也就是说,如果两个格子满足 ,则它们一定处在同一条主对角线上。利用该规律,我们可以借助下图所示的数组 diag1 ,记录每条主对角线上是否有皇后。
同理,次对角线上的所有格子的 是恒定值。我们同样也可以借助数组 diag2 来处理次对角线约束。
请注意, 维方阵中 的范围是 , 的范围是 ,所以主对角线和次对角线的数量都为 ,即数组 diag1 和 diag2 的长度都为 。
/* 回溯算法:N 皇后 */void backtrack(int row, int n, vector<vector<string>> &state, vector<vector<vector<string>>> &res, vector<bool> &cols, vector<bool> &diags1, vector<bool> &diags2) { // 当放置完所有行时,记录解 if (row == n) { res.push_back(state); return; } // 遍历所有列 for (int col = 0; col < n; col++) { // 计算该格子对应的主对角线和副对角线 int diag1 = row - col + n - 1; int diag2 = row + col; // 剪枝:不允许该格子所在列、主对角线、副对角线上存在皇后 if (!cols[col] && !diags1[diag1] && !diags2[diag2]) { // 尝试:将皇后放置在该格子 state[row][col] = "Q"; cols[col] = diags1[diag1] = diags2[diag2] = true; // 放置下一行 backtrack(row + 1, n, state, res, cols, diags1, diags2); // 回退:将该格子恢复为空位 state[row][col] = "#"; cols[col] = diags1[diag1] = diags2[diag2] = false; } }} /* 求解 N 皇后 */vector<vector<vector<string>>> nQueens(int n) { // 初始化 n*n 大小的棋盘,其中 'Q' 代表皇后,'#' 代表空位 vector<vector<string>> state(n, vector<string>(n, "#")); vector<bool> cols(n, false); // 记录列是否有皇后 vector<bool> diags1(2 * n - 1, false); // 记录主对角线上是否有皇后 vector<bool> diags2(2 * n - 1, false); // 记录副对角线上是否有皇后 vector<vector<vector<string>>> res; backtrack(0, n, state, res, cols, diags1, diags2); return res;}逐行放置 次,考虑列约束,则从第一行到最后一行分别有 、、、、 个选择,因此时间复杂度为 。实际上,根据对角线约束的剪枝也能够大幅地缩小搜索空间,因而搜索效率往往优于以上时间复杂度。
数组 state 使用 空间,数组 cols、diags1 和 diags2 皆使用 空间。最大递归深度为 ,使用 栈帧空间。因此,空间复杂度为 。
怎么理解回溯和递归的关系?
总的来看,回溯是一种“算法策略”,而递归更像是一个“工具”。
回溯算法通常基于递归实现。然而,回溯是递归的应用场景之一,是递归在搜索问题中的应用。
递归的结构体现了“子问题分解”的解题范式,常用于解决分治、回溯、动态规划(记忆化递归)等问题。
回溯算法本质是穷举法,通过对解空间进行深度优先遍历来寻找符合条件的解。在搜索过程中,遇到满足条件的解则记录,直至找到所有解或遍历完成后结束。
回溯算法的搜索过程包括尝试与回退两个部分。它通过深度优先搜索来尝试各种选择,当遇到不满足约束条件的情况时,则撤销上一步的选择,退回到之前的状态,并继续尝试其他选择。尝试与回退是两个方向相反的操作。
回溯问题通常包含多个约束条件,它们可用于实现剪枝操作。剪枝可以提前结束不必要的搜索分支,大幅提升搜索效率。
回溯算法主要可用于解决搜索问题和约束满足问题。组合优化问题虽然可以用回溯算法解决,但往往存在效率更高或效果更好的解法。
小溪汇入河流,江河汇入大海。
动态规划就是将小问题的解汇集成大问题的答案,一步步引领我们走向解决问题的彼岸
「动态规划 dynamic programming」是一个很重要的算法方法,它将一个问题分解为更小的子问题,但相比与之前的分解方法,他还会通过存储子问题的解来避免重复计算,从而大幅提升时间效率。
给定一个共有 阶的楼梯,你每步可以上 阶或者 阶,请问有多少种方案可以爬到楼顶。
如下图所示,对于一个 阶楼梯,共有 种方案可以爬到楼顶。

本题的目标是求解方案数量,我们可以考虑通过回溯来穷举所有可能性。具体来说,将爬楼梯想象为一个多轮选择的过程:从地面出发,每轮选择上 1 阶或 2 阶,每当到达楼梯顶部时就将方案数量加 1 ,当越过楼梯顶部时就将其剪枝。代码如下所示:
/* 回溯 */void backtrack(vector<int> &choices, int state, int n, vector<int> &res) { // 当爬到第 n 阶时,方案数量加 1 if (state == n) res[0]++; // 遍历所有选择 for (auto &choice : choices) { // 剪枝:不允许越过第 n 阶 if (state + choice > n) continue; // 尝试:做出选择,更新状态 backtrack(choices, state + choice, n, res); // 回退 }} /* 爬楼梯:回溯 */int climbingStairsBacktrack(int n) { vector<int> choices = {1, 2}; // 可选择向上爬 1 阶或 2 阶 int state = 0; // 从第 0 阶开始爬 vector<int> res = {0}; // 使用 res[0] 记录方案数量 backtrack(choices, state, n, res); return res[0];}回溯算法通常并不显式地对问题进行拆解,而是将问题看作一系列决策步骤,通过试探和剪枝,搜索所有可能的解。
我们可以尝试从问题分解的角度分析这道题。设爬到第 阶共有 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i] 种方案,那么 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i] 就是原问题,其子问题包括:
ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i-1], dp\[i-2],…
由于每轮只能上 阶或 阶,因此当我们站在第 阶楼梯上时,上一轮只可能站在第 阶或第 阶上。换句话说,我们只能从第 阶或第 阶前往第 阶。
由此便可得出一个重要推论:爬到第 阶的方案数加上爬到第 阶的方案数就等于爬到第 阶的方案数。公式如下:
ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i] = dp\[i-1] +…
这意味着在爬楼梯问题中,各个子问题之间存在递推关系,原问题的解可以由子问题的解构建得来。下图展示了该递推关系。

我们可以根据递推公式得到暴力搜索解法。以 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲n] 为起始点,递归地将一个较大问题拆解为两个较小问题的和,直至到达最小子问题 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲1] 和 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲2] 时返回。其中,最小子问题的解是已知的,即 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲1] = 1、ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲2] = 2 ,表示爬到第 、 阶分别有 、 种方案。
观察以下代码,它和标准回溯代码都属于深度优先搜索,但更加简洁。
/* 搜索 */int dfs(int i) { // 已知 dp[1] 和 dp[2] ,返回之 if (i == 1 || i == 2) return i; // dp[i] = dp[i-1] + dp[i-2] int count = dfs(i - 1) + dfs(i - 2); return count;} /* 爬楼梯:搜索 */int climbingStairsDFS(int n) { return dfs(n);}下图展示了暴力搜索形成的递归树。对于问题 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲n] ,其递归树的深度为 ,时间复杂度为 。指数阶属于爆炸式增长,如果我们输入一个比较大的 ,则会陷入漫长的等待之中。

观察上图,指数阶的时间复杂度是由于“重叠子问题”导致的。例如 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲9] 被分解为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲8] 和 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲7] ,ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲8] 被分解为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲7] 和 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲6] ,两者都包含子问题 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲7] 。
以此类推,子问题中包含更小的重叠子问题,子子孙孙无穷尽也。绝大部分计算资源都浪费在这些重叠的问题上。
为了提升算法效率,我们希望所有的重叠子问题都只被计算一次。为此,我们声明一个数组 mem 来记录每个子问题的解,并在搜索过程中将重叠子问题剪枝。
mem[i] ,以便之后使用。mem[i] 中获取结果,从而避免重复计算该子问题。/* 记忆化搜索 */int dfs(int i, vector<int> &mem) { // 已知 dp[1] 和 dp[2] ,返回之 if (i == 1 || i == 2) return i; // 若存在记录 dp[i] ,则直接返回之 if (mem[i] != -1) return mem[i]; // dp[i] = dp[i-1] + dp[i-2] int count = dfs(i - 1, mem) + dfs(i - 2, mem); // 记录 dp[i] mem[i] = count; return count;} /* 爬楼梯:记忆化搜索 */int climbingStairsDFSMem(int n) { // mem[i] 记录爬到第 i 阶的方案总数,-1 代表无记录 vector<int> mem(n + 1, -1); return dfs(n, mem);}观察下图,经过记忆化处理后,所有重叠子问题都只需被计算一次,时间复杂度被优化至 ,这是一个巨大的飞跃。

记忆化搜索是一种“从顶至底”的方法:我们从原问题(根节点)开始,递归地将较大子问题分解为较小子问题,直至解已知的最小子问题(叶节点)。之后,通过回溯将子问题的解逐层收集,构建出原问题的解。
与之相反,动态规划是一种“从底至顶”的方法:从最小子问题的解开始,迭代地构建更大子问题的解,直至得到原问题的解。
由于动态规划不包含回溯过程,因此只需使用循环迭代实现,无须使用递归。在以下代码中,我们初始化一个数组 dp 来存储子问题的解,它起到了记忆化搜索中数组 mem 相同的记录作用。
/* 爬楼梯:动态规划 */int climbingStairsDP(int n) { if (n == 1 || n == 2) return n; // 初始化 dp 表,用于存储子问题的解 vector<int> dp(n + 1); // 初始状态:预设最小子问题的解 dp[1] = 1; dp[2] = 2; // 状态转移:从较小子问题逐步求解较大子问题 for (int i = 3; i <= n; i++) { dp[i] = dp[i - 1] + dp[i - 2]; } return dp[n];}下图模拟了以上代码的执行过程。

与回溯算法一样,动态规划也使用“状态”概念来表示问题求解的某个特定阶段,每个状态都对应一个子问题以及相应的局部最优解。例如,爬楼梯问题的状态定义为当前所在楼梯阶数 。
根据以上内容,我们可以总结出动态规划的常用术语。
将数组 dp 称为「 表」,ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i] 表示状态 对应子问题的解。
将最小子问题对应的状态(即第 和 阶楼梯)称为「初始状态」。
将递推公式 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i] = dp\[i-1] +… 称为「状态转移方程」。
由于 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i] 只与 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i-1] 和 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i-2] 有关,因此我们无须使用一个数组 dp 来存储所有子问题的解,而只需两个变量滚动前进即可。
/* 爬楼梯:空间优化后的动态规划 */int climbingStairsDPComp(int n) { if (n == 1 || n == 2) return n; int a = 1, b = 2; for (int i = 3; i <= n; i++) { int tmp = b; b = a + b; a = tmp; } return b;}观察以上代码,由于省去了数组 dp 占用的空间,因此空间复杂度从 降低至 。
在动态规划问题中,当前状态往往仅与前面有限个状态有关,这时我们可以只保留必要的状态,通过“降维”来节省内存空间。这种空间优化技巧被称为“滚动变量”或“滚动数组”。
想上述所说的通过子问题分解来求解原问题的方法是一种通用的方法。实际上,子问题分解是一种通用的算法思路,在分治、动态规划、回溯中的侧重点不同。
分治算法递归地将原问题划分为多个相互独立的子问题,直至最小子问题,并在回溯中合并子问题的解,最终得到原问题的解。
动态规划也对问题进行递归分解,但与分治算法的主要区别是,动态规划中的子问题是相互依赖的,在分解过程中会出现许多重叠子问题。
回溯算法在尝试和回退中穷举所有可能的解,并通过剪枝避免不必要的搜索分支。原问题的解由一系列决策步骤构成,我们可以将每个决策步骤之前的子序列看作为一个子问题。
实际上,动态规划常用来求解最优化问题,它们不仅包含重叠子问题,还具有另外两大特性:最优子结构、无后效性。
我们对爬楼梯问题稍作改动,使之更加适合展示最优子结构概念
爬楼梯最小代价
给定一个楼梯,你每步可以上 阶或者 阶,每一阶楼梯上都贴有一个非负整数,表示你在该台阶所需要付出的代价。给定一个非负整数数组 ,其中 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 5: cost\̲[̲i] 表示在第 个台阶需要付出的代价,ParseError: KaTeX parse error: Undefined control sequence: \[ at position 5: cost\̲[̲0] 为地面起始点。请计算最少需要付出多少代价才能到达顶部?
如下图所示,若第 、、 阶的代价分别为 、、 ,则从地面爬到第 阶的最小代价为 。

设 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i] 为爬到第 阶累计付出的代价,由于第 阶只可能从 阶或 阶走来,因此 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i] 只可能等于 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i - 1] + cost\[… 或 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i - 2] + cost\[… 。为了尽可能减少代价,我们应该选择两者中较小的那一个:
ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i] = \min(dp\[i…
这便可以引出最优子结构的含义:原问题的最优解是从子问题的最优解构建得来的。
本题显然具有最优子结构:我们从两个子问题最优解 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i-1] 和 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i-2] 中挑选出较优的那一个,并用它构建出原问题 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i] 的最优解。
那么,上节的爬楼梯题目有没有最优子结构呢?它的目标是求解方案数量,看似是一个计数问题,但如果换一种问法:“求解最大方案数量”。我们意外地发现,虽然题目修改前后是等价的,但最优子结构浮现出来了:第 阶最大方案数量等于第 阶和第 阶最大方案数量之和。所以说,最优子结构的解释方式比较灵活,在不同问题中会有不同的含义。
/* 爬楼梯最小代价:动态规划 */int minCostClimbingStairsDP(vector<int> &cost) { int n = cost.size() - 1; if (n == 1 || n == 2) return cost[n]; // 初始化 dp 表,用于存储子问题的解 vector<int> dp(n + 1); // 初始状态:预设最小子问题的解 dp[1] = cost[1]; dp[2] = cost[2]; // 状态转移:从较小子问题逐步求解较大子问题 for (int i = 3; i <= n; i++) { dp[i] = min(dp[i - 1], dp[i - 2]) + cost[i]; } return dp[n];}下图展示了以上代码的动态规划过程,倒过来看容易看懂一些

本题也可以进行空间优化,将一维压缩至零维,使得空间复杂度从 降低至 。
/* 爬楼梯最小代价:空间优化后的动态规划 */int minCostClimbingStairsDPComp(vector<int> &cost) { int n = cost.size() - 1; if (n == 1 || n == 2) return cost[n]; int a = cost[1], b = cost[2]; for (int i = 3; i <= n; i++) { int tmp = b; b = min(a, tmp) + cost[i]; a = tmp; } return b;}无后效性是动态规划能够有效解决问题的重要特性之一,定义为:给定一个确定的状态,它的未来发展只与当前状态有关,而与当前状态过去所经历过的所有状态无关。
以爬楼梯问题为例,给定状态 ,它会发展出状态 和状态 ,分别对应跳 步和跳 步。在做出这两种选择时,我们无须考虑状态 之前的状态,它们对状态 的未来没有影响。
然而,如果我们向爬楼梯问题添加一个约束,情况就不一样了。
带约束爬楼梯
给定一个共有 阶的楼梯,你每步可以上 阶或者 阶,但不能连续两轮跳 阶,请问有多少种方案可以爬到楼顶。
例如下图,爬上第 阶仅剩 种可行方案,其中连续三次跳 阶的方案不满足约束条件,因此被舍弃。
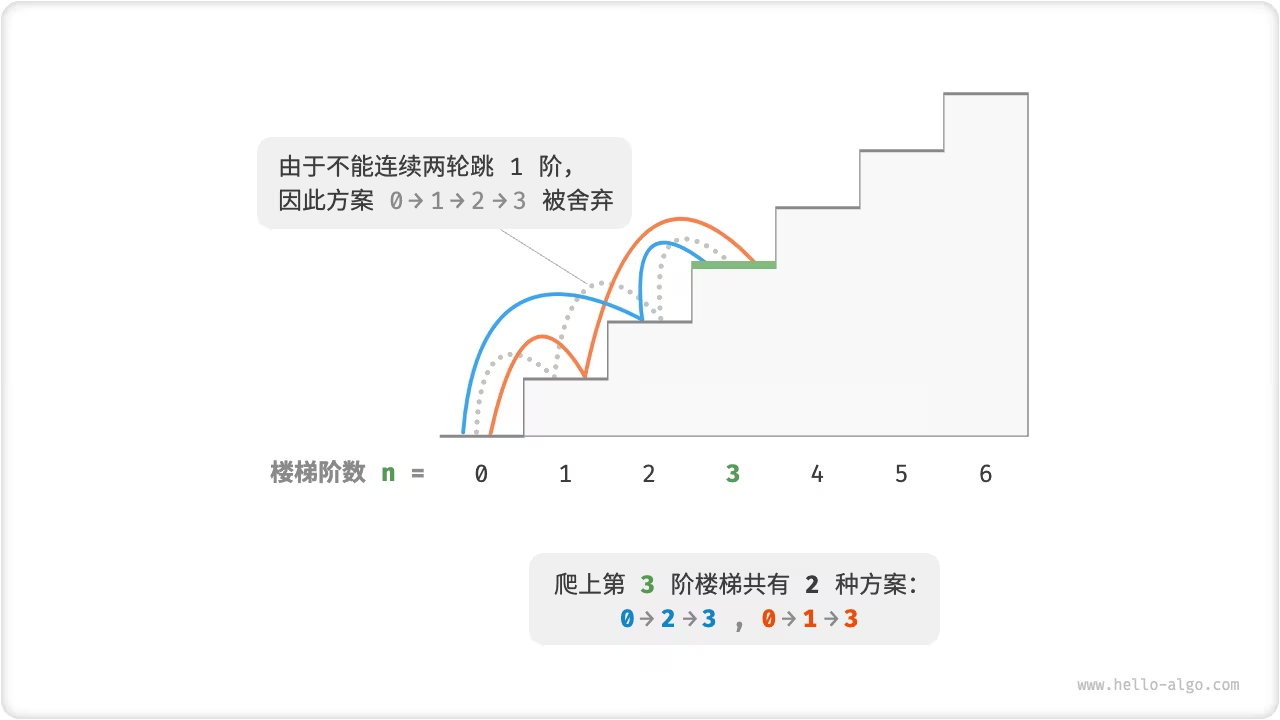
在该问题中,如果上一轮是跳 阶上来的,那么下一轮就必须跳 阶。这意味着,下一步选择不能由当前状态(当前楼梯阶数)独立决定,还和前一个状态(上轮楼梯阶数)有关。
不难发现,此问题已不满足无后效性,状态转移方程 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i] = dp\[i-1] +… 也失效了,因为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i-1] 代表本轮跳 阶,但其中包含了许多“上一轮跳 阶上来的”方案,而为了满足约束,我们就不能将 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i-1] 直接计入 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i] 中。
为此,我们需要扩展状态定义:状态 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j] 表示处在第 阶、并且上一轮跳了 阶,其中 。此状态定义有效地区分了上一轮跳了 阶还是 阶,我们可以据此来判断当前状态是从何而来的。
当上一轮跳了 阶时,上上一轮只能选择跳 阶,即 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, 1] 只能从 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i-1, 2] 转移过来。
当上一轮跳了 阶时,上上一轮可选择跳 阶或跳 阶,即 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, 2] 可以从 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i-2, 1] 或 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i-2, 2] 转移过来。
如下图所示,在该定义下,ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, j] 表示状态 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j] 对应的方案数。此时状态转移方程为:
ParseError: KaTeX parse error: Undefined control sequence: \[ at position 17: …begin{cases} dp\̲[̲i, 1] = dp\[i-1…

最终,返回 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲n, 1] + dp\[n, … 即可,两者之和代表爬到第 阶的方案总数。
为什么返回 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲n, 1] + dp\[n, … 是正确答案。
当爬到第 阶楼梯时,最后一步只能是跳了 阶或者跳了 阶。所以,总的方案数就等于 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲n, 1] + dp\[n, …。
/* 带约束爬楼梯:动态规划 */int climbingStairsConstraintDP(int n) { if (n == 1 || n == 2) { return 1; } // 初始化 dp 表,用于存储子问题的解 vector<vector<int>> dp(n + 1, vector<int>(3, 0)); // 初始状态:预设最小子问题的解 dp[1][1] = 1; dp[1][2] = 0; dp[2][1] = 0; dp[2][2] = 1; // 状态转移:从较小子问题逐步求解较大子问题 for (int i = 3; i <= n; i++) { dp[i][1] = dp[i - 1][2]; dp[i][2] = dp[i - 2][1] + dp[i - 2][2]; } return dp[n][1] + dp[n][2];}在上面的案例中,由于仅需多考虑前面一个状态,因此我们仍然可以通过扩展状态定义,使得问题重新满足无后效性。然而,某些问题具有非常严重的“有后效性”。
爬楼梯与障碍生成
定一个共有 阶的楼梯,你每步可以上 阶或者 阶。规定当爬到第 阶时,系统自动会给第 阶上放上障碍物,之后所有轮都不允许跳到第 阶上。例如,前两轮分别跳到了第 、 阶上,则之后就不能跳到第 、 阶上。请问有多少种方案可以爬到楼顶。
上面只是介绍了动态规划问题的主要特征,下面说的就是如何解动态规划的题
如果一个问题包含上述的重叠子问题、最优子结构、无后效性的话,那么它通常适合使用动态规划来求解。然而,我们很难直接从问题描述中直接提取出这些特性。因此我们通常会放宽条件,先去观察问题是否适合使用回溯(穷举)来解决。
适合用回溯解决的问题通常满足“决策树模型”,这种问题可以使用树形结构来描述,其中每一个节点代表一个决策,每一条路径代表一个决策序列。即,如果问题包含明确的决策概念,并且解是通过一系列决策产生的,那么它就满足决策树模型,通常可以使用回溯来解决。
在此基础上,动态规划问题还有一些判断的“加分项”。
问题包含最大(小)或最多(少)等最优化描述。
问题的状态能够使用一个列表、多维矩阵或树来表示,并且一个状态与其周围的状态存在递推关系。
相应地,也存在一些“减分项”。
问题的目标是找出所有可能的解决方案,而不是找出最优解。(最优解问题相比于找出所有可能的问题更适合使用动态规划)
问题描述中有明显的排列组合的特征,需要返回具体的多个方案。
如果一个问题满足决策树模型,并具有较为明显的“加分项“,我们就可以假设它是一个动态规划问题,并在求解过程中验证它。
虽然要因题制宜,但还是有通用步骤的,分为:描述决策,定义状态,建立 表,推导状态转移方程,确定边界条件等
通常使用一个经典问题“最小路径和”来举例
给定一个 的二维网格
grid,网格中的每个单元格包含一个非负整数,表示该单元格的代价。机器人以左上角单元格为起始点,每次只能向下或者向右移动一步,直至到达右下角单元格。请返回从左上角到右下角的最小路径和。
下图展示了一个例子,给定网格的最小路径和为 。
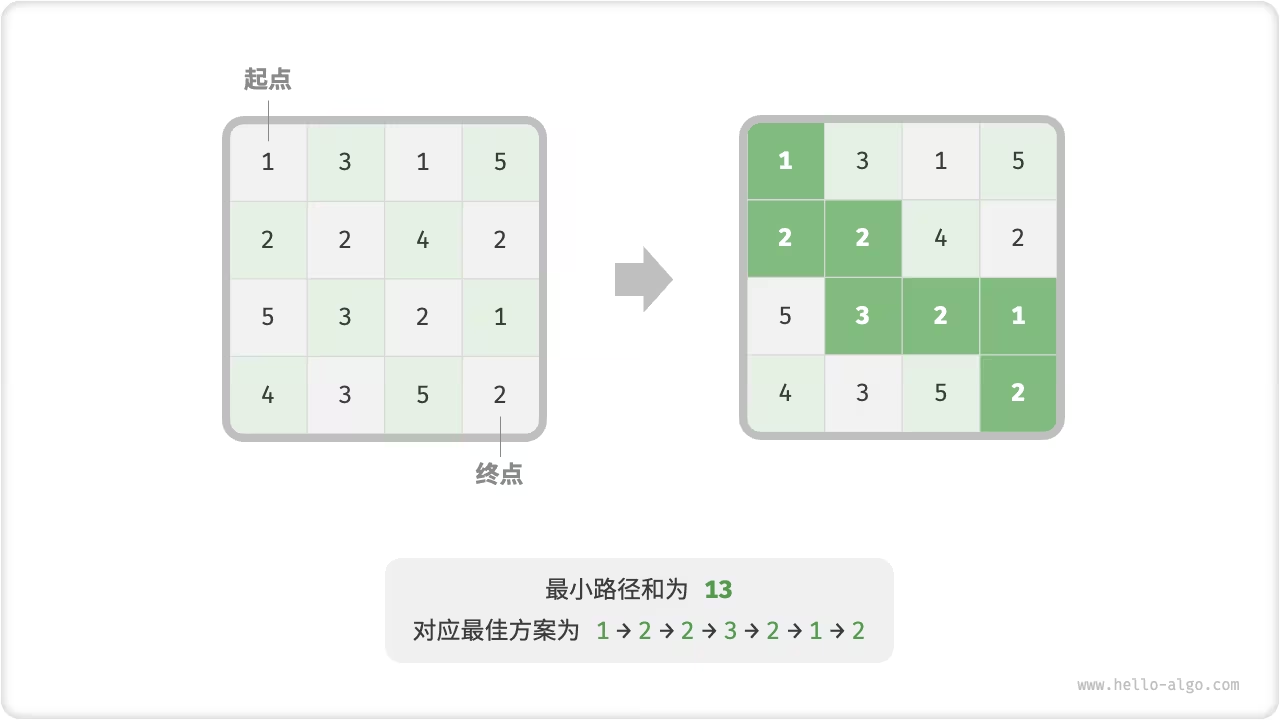
第一步:思考每轮的决策,定义状态,从而得到 表
本题的每一轮的决策就是从当前格子向下或向右一步。设当前格子的行列索引为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j] ,则向下或向右走一步后,索引变为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i+1, j] 或 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j+1] 。因此,状态应包含行索引和列索引两个变量,记为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j] 。
状态 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j] 对应的子问题为:从起始点 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲0, 0] 走到 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j] 的最小路径和,解记为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, j] 。
至此,我们就得到了下图所示的二维 矩阵,其尺寸与输入网格 相同。
动态规划和回溯过程可以被描述为一个决策序列,而状态由所有决策变量构成。它应当包含描述解题进度的所有变量,其包含了足够的信息,能够用来推导出下一个状态。
每个状态都对应一个子问题,我们会定义一个 表来存储所有子问题的解,状态的每个独立变量都是 表的一个维度。本质上看, 表是状态和子问题的解之间的映射。
第二步:找出最优子结构,进而推导出状态转移方程
对于状态 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j] ,它只能从上边格子 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i-1, j] 和左边格子 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j-1] 转移而来。因此最优子结构为:到达 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j] 的最小路径和由 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j-1] 的最小路径和与 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i-1, j] 的最小路径和,这两者较小的那一个决定。
根据以上分析,可推出下图所示的状态转移方程:
ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, j] = \min(dp…
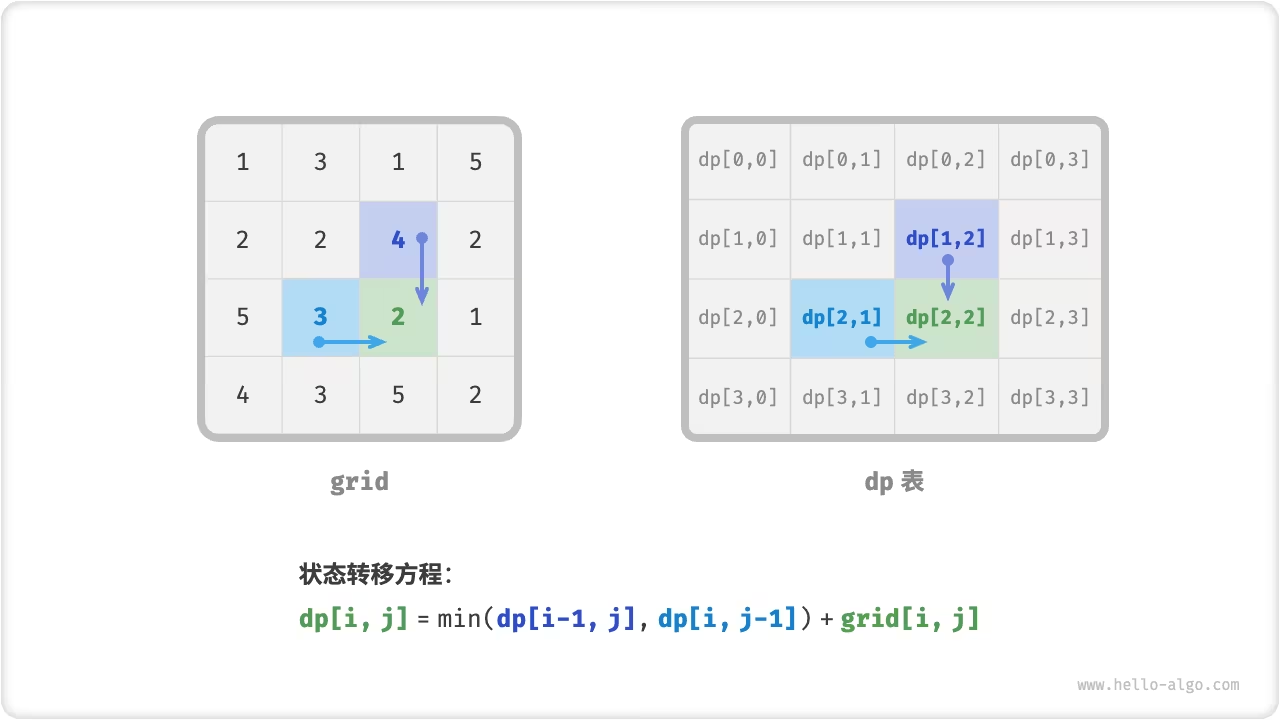
注:dp 为坐标,grid 为那一点的数值
根据定义好的 表,思考原问题和子问题的关系,找出通过子问题的最优解来构造原问题的最优解的方法,即最优子结构。
一旦我们找到了最优子结构,就可以使用它来构建出状态转移方程。
第三步:确定边界条件和状态转移顺序
在本题中,首行的状态只能从其左边的状态得来,首列的状态只能从其上边的状态得来,因此首行 和首列 是边界条件。
如下图所示,由于每个格子是由其左方格子和上方格子转移而来,因此我们使用采用循环来遍历矩阵,外循环遍历各行、内循环遍历各列。
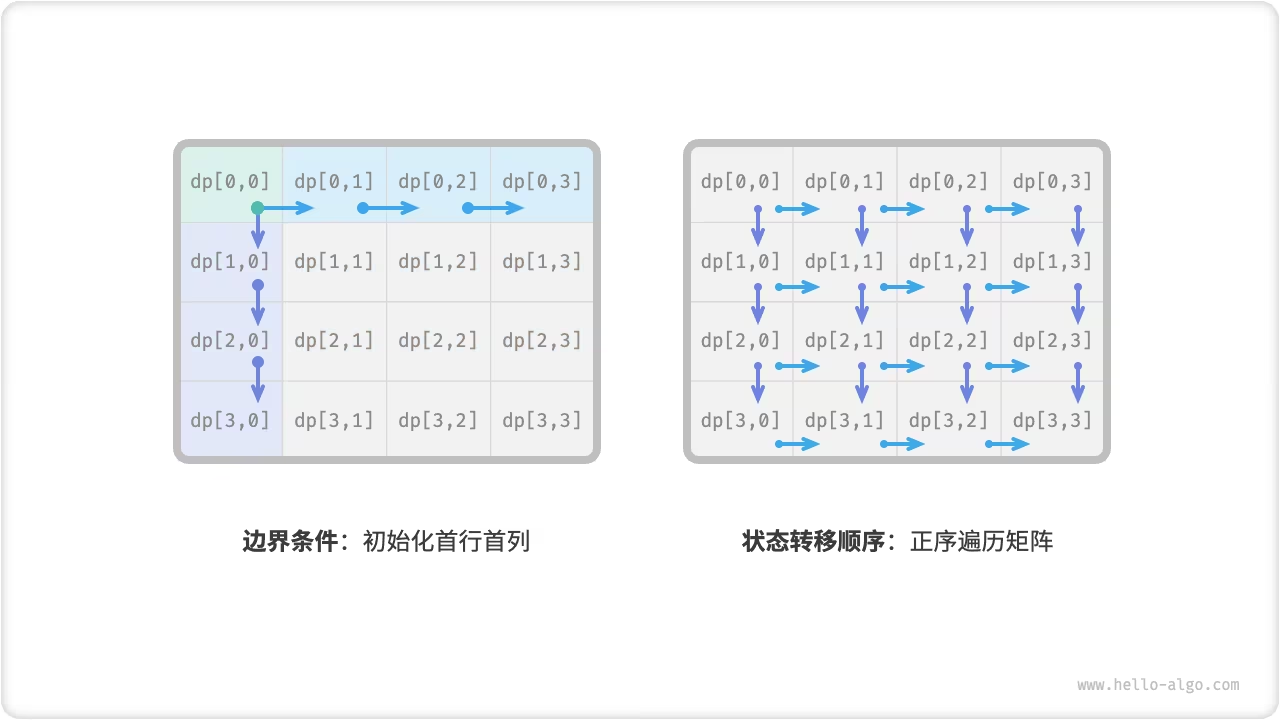
边界条件在动态规划中用于初始化 表,在搜索中用于剪枝。
状态转移顺序的核心是要保证在计算当前问题的解时,所有它依赖的更小子问题的解都已经被正确地计算出来。
根据以上分析,我们已经可以直接写出动态规划代码。然而子问题分解是一种从顶至底的思想,因此按照“暴力搜索 记忆化搜索 动态规划”的顺序实现更加符合思维习惯。(这只是对于新手而言,如果熟练的话,直接考虑 DP 递推的解法都是可以的哟)
从状态 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j] 开始搜索,不断分解为更小的状态 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i-1, j] 和 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j-1] ,递归函数包括以下要素。
递归参数:状态 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j] 。
返回值:从 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲0, 0] 到 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j] 的最小路径和 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, j] 。
终止条件:当 且 时,返回代价 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 5: grid\̲[̲0, 0] 。
剪枝:当 时或 时索引越界,此时返回代价 ,代表不可行。
/* 最小路径和:暴力搜索 */int minPathSumDFS(vector<vector<int>> &grid, int i, int j) { // 若为左上角单元格,则终止搜索 if (i == 0 && j == 0) { return grid[0][0]; } // 若行列索引越界,则返回 +∞ 代价 if (i < 0 || j < 0) { return INT_MAX; } // 计算从左上角到 (i-1, j) 和 (i, j-1) 的最小路径代价 int up = minPathSumDFS(grid, i - 1, j); int left = minPathSumDFS(grid, i, j - 1); // 返回从左上角到 (i, j) 的最小路径代价 return min(left, up) != INT_MAX ? min(left, up) + grid[i][j] : INT_MAX;}下图给出了以 为根节点的递归树,其中包含一些重叠子问题,其数量会随着网格 grid 的尺寸变大而急剧增多。
本质上看,造成重叠子问题的原因为:存在多条路径可以从左上角到达某一单元格。
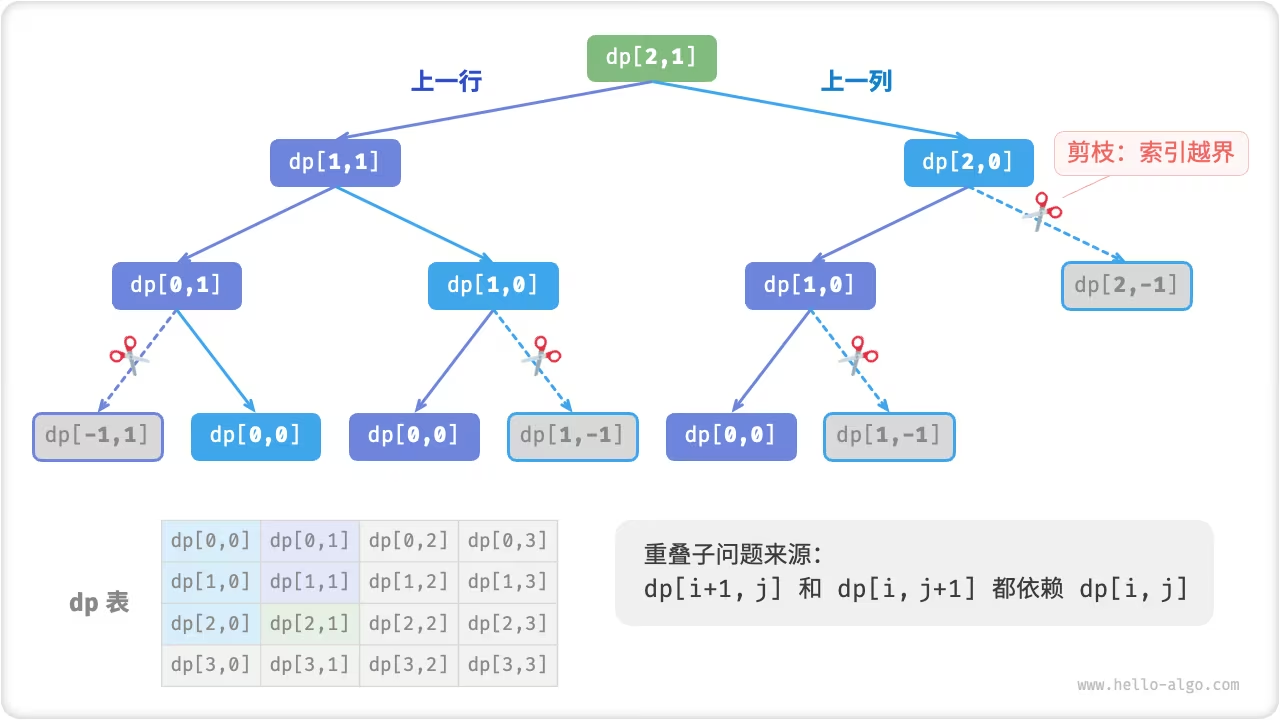
每个状态都有向下和向右两种选择,从左上角走到右下角总共需要 步,所以最差时间复杂度为 。请注意,这种计算方式未考虑临近网格边界的情况,当到达网络边界时只剩下一种选择。因此实际的路径数量会少一些。
我们引入一个和网格 grid 相同尺寸的记忆列表 mem ,用于记录各个子问题的解,并将重叠子问题进行剪枝。
/* 最小路径和:记忆化搜索 */int minPathSumDFSMem(vector<vector<int>> &grid, vector<vector<int>> &mem, int i, int j) { // 若为左上角单元格,则终止搜索 if (i == 0 && j == 0) { return grid[0][0]; } // 若行列索引越界,则返回 +∞ 代价 if (i < 0 || j < 0) { return INT_MAX; } // 这一条是剪枝部分 // 若已有记录,则直接返回 if (mem[i][j] != -1) { return mem[i][j]; } // 左边和上边单元格的最小路径代价 int up = minPathSumDFSMem(grid, mem, i - 1, j); int left = minPathSumDFSMem(grid, mem, i, j - 1); // 记录并返回左上角到 (i, j) 的最小路径代价 mem[i][j] = min(left, up) != INT_MAX ? min(left, up) + grid[i][j] : INT_MAX; return mem[i][j];}如下图所示,在引入记忆化后,所有子问题的解只需计算一次,因此时间复杂度取决于状态总数,即网格尺寸 。

基于迭代实现动态规划解法。
/* 最小路径和:动态规划 */int minPathSumDP(vector<vector<int>> &grid) { int n = grid.size(), m = grid[0].size(); // 初始化 dp 表 vector<vector<int>> dp(n, vector<int>(m)); dp[0][0] = grid[0][0]; // 状态转移:首行 for (int j = 1; j < m; j++) { dp[0][j] = dp[0][j - 1] + grid[0][j]; } // 状态转移:首列 for (int i = 1; i < n; i++) { dp[i][0] = dp[i - 1][0] + grid[i][0]; } // 状态转移:其余行和列 for (int i = 1; i < n; i++) { for (int j = 1; j < m; j++) { dp[i][j] = min(dp[i][j - 1], dp[i - 1][j]) + grid[i][j]; } } return dp[n - 1][m - 1];}下图展示了最小路径和的状态转移过程,其遍历了整个网格,因此时间复杂度为 。
数组 dp 大小为 ,因此空间复杂度为 。
【GIF】
由于每个格子只与其左边和上边的格子有关,因此我们可以只用一个单行数组来实现 表。
请注意,因为数组 dp 只能表示一行的状态,所以我们无法提前初始化首列状态,而是在遍历每行中更新它。
/* 最小路径和:空间优化后的动态规划 */int minPathSumDPComp(vector<vector<int>> &grid) { int n = grid.size(), m = grid[0].size(); // 初始化 dp 表 vector<int> dp(m); // 状态转移:首行 dp[0] = grid[0][0]; for (int j = 1; j < m; j++) { dp[j] = dp[j - 1] + grid[0][j]; } // 状态转移:其余行 for (int i = 1; i < n; i++) { // 状态转移:首列 dp[0] = dp[0] + grid[i][0]; // 状态转移:其余列 for (int j = 1; j < m; j++) { dp[j] = min(dp[j - 1], dp[j]) + grid[i][j]; } } return dp[m - 1];}背包问题是动态规划中最常见的问题形式,其中的 0-1 背包问题是最常见的一种,还有像是完全背包问题、多重背包问题等
给定 个物品,第 个物品的重量为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 4: wgt\̲[̲i-1]、价值为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 4: val\̲[̲i-1] ,和一个容量为 的背包。每个物品只能选择一次,问在不超过背包容量下能放入物品的最大价值。
观察下图,由于物品编号 从 开始计数,数组索引从 开始计数,因此物品 对应重量 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 4: wgt\̲[̲i-1] 和价值 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 4: val\̲[̲i-1] 。
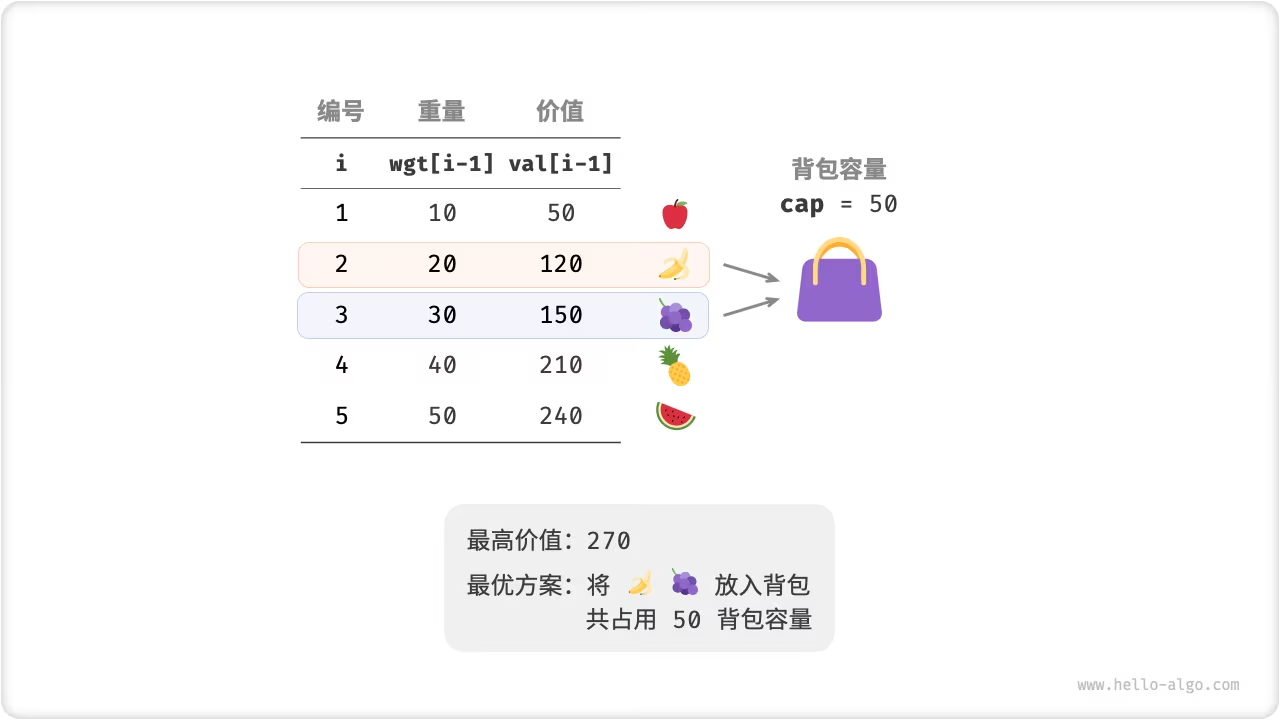
我们可以将 0-1 背包问题看作是一个由 轮决策组成的过程,每个物体都有不放入和放入两种决策,因此该问题是满足决策树模型的。
该问题的目标是求解“在限定背包容量下的最大价值”,因此较大概率是个动态规划问题。
第一步:思考每轮的决策,定义状态,从而得到 表
对于每个物品来说,不放入背包,背包容量不变;放入背包,背包容量减小。由此可得状态定义:当前物品编号 和剩余背包容量 ,记为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, c] 。
状态 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, c] 对应的子问题为:前 个物品在剩余容量为 的背包中的最大价值,记为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, c] 。
待求解的是 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲n, cap] ,因此需要一个尺寸为 的二维 表。
第二步:找出最优子结构,进而推导出状态转移方程
当我们做出物品 的决策后,剩余的是前 个物品的决策,可分为以下两种情况。
不放入物品 :背包容量不变,状态变化为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i-1, c] 。
放入物品 :背包容量减小 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 4: wgt\̲[̲i-1] ,价值增加 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 4: val\̲[̲i-1] ,状态变化为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i-1, c-wgt\[i-1… 。
上述分析向我们揭示了本题的最优子结构:最大价值 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, c] 等于不放入物品 和放入物品 两种方案中的价值更大的那一个。由此可推出状态转移方程:
ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, c] = \max(dp…
需要注意的是,若当前物品重量 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 4: wgt\̲[̲i - 1] 超出剩余背包容量 ,则只能选择不放入背包。
第三步:确定边界条件和状态转移顺序
当无物品或无剩余背包容量时最大价值为 ,即首列 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, 0] 和首行 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲0, c] 都等于 。
当前状态 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, c] 从上方的状态 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i-1, c] 和左上方的状态 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i-1, c-wgt\[i-1… 转移而来,因此通过两层循环正序遍历整个 表即可。
根据以上分析,我们接下来按顺序实现暴力搜索、记忆化搜索、动态规划解法。
搜索代码包含以下要素。
递归参数:状态 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, c] 。
返回值:子问题的解 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, c] 。
终止条件:当物品编号越界 或背包剩余容量为 时,终止递归并返回价值 。
剪枝:若当前物品重量超出背包剩余容量,则只能不放入背包。
/* 0-1 背包:暴力搜索 */int knapsackDFS(vector<int> &wgt, vector<int> &val, int i, int c) { // 若已选完所有物品或背包无剩余容量,则返回价值 0 if (i == 0 || c == 0) { return 0; } // 若超过背包容量,则只能选择不放入背包 if (wgt[i - 1] > c) { return knapsackDFS(wgt, val, i - 1, c); } // 计算不放入和放入物品 i 的最大价值 int no = knapsackDFS(wgt, val, i - 1, c); int yes = knapsackDFS(wgt, val, i - 1, c - wgt[i - 1]) + val[i - 1]; // 返回两种方案中价值更大的那一个 return max(no, yes);}如下图所示,由于每个物品都会产生不选和选两条搜索分支,因此时间复杂度为 。
观察递归树,容易发现其中存在重叠子问题,例如 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲1, 10] 等。而当物品较多、背包容量较大,尤其是相同重量的物品较多时,重叠子问题的数量将会大幅增多。(下图两个橙框部分)
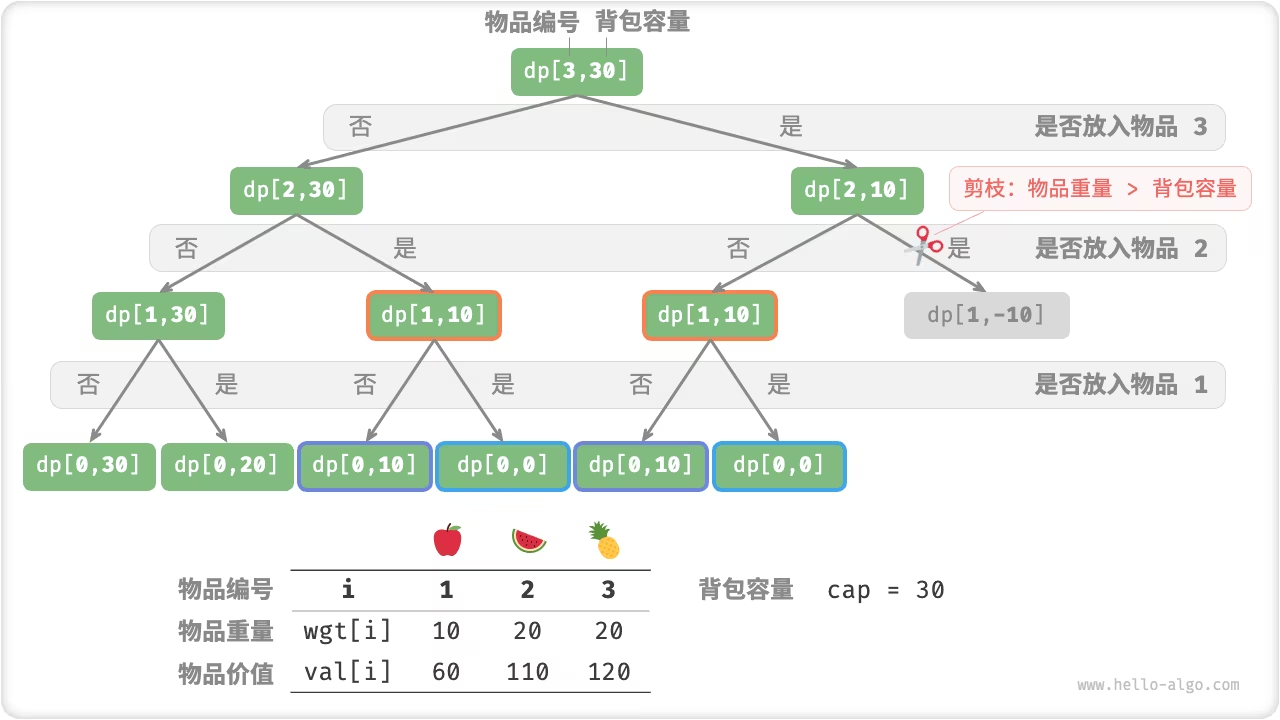
为了保证重叠子问题只被计算一次,我们借助记忆列表 mem 来记录子问题的解,其中 mem[i][c] 对应 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, c] 。
引入记忆化之后,时间复杂度取决于子问题数量,也就是
/* 0-1 背包:记忆化搜索 */int knapsackDFSMem(vector<int> &wgt, vector<int> &val, vector<vector<int>> &mem, int i, int c) { // 若已选完所有物品或背包无剩余容量,则返回价值 0 if (i == 0 || c == 0) { return 0; } // 若已有记录,则直接返回 if (mem[i][c] != -1) { return mem[i][c]; } // 若超过背包容量,则只能选择不放入背包 if (wgt[i - 1] > c) { return knapsackDFSMem(wgt, val, mem, i - 1, c); } // 计算不放入和放入物品 i 的最大价值 int no = knapsackDFSMem(wgt, val, mem, i - 1, c); int yes = knapsackDFSMem(wgt, val, mem, i - 1, c - wgt[i - 1]) + val[i - 1]; // 记录并返回两种方案中价值更大的那一个 mem[i][c] = max(no, yes); return mem[i][c];}下图展示了在记忆化递归中被剪掉的搜索分支。
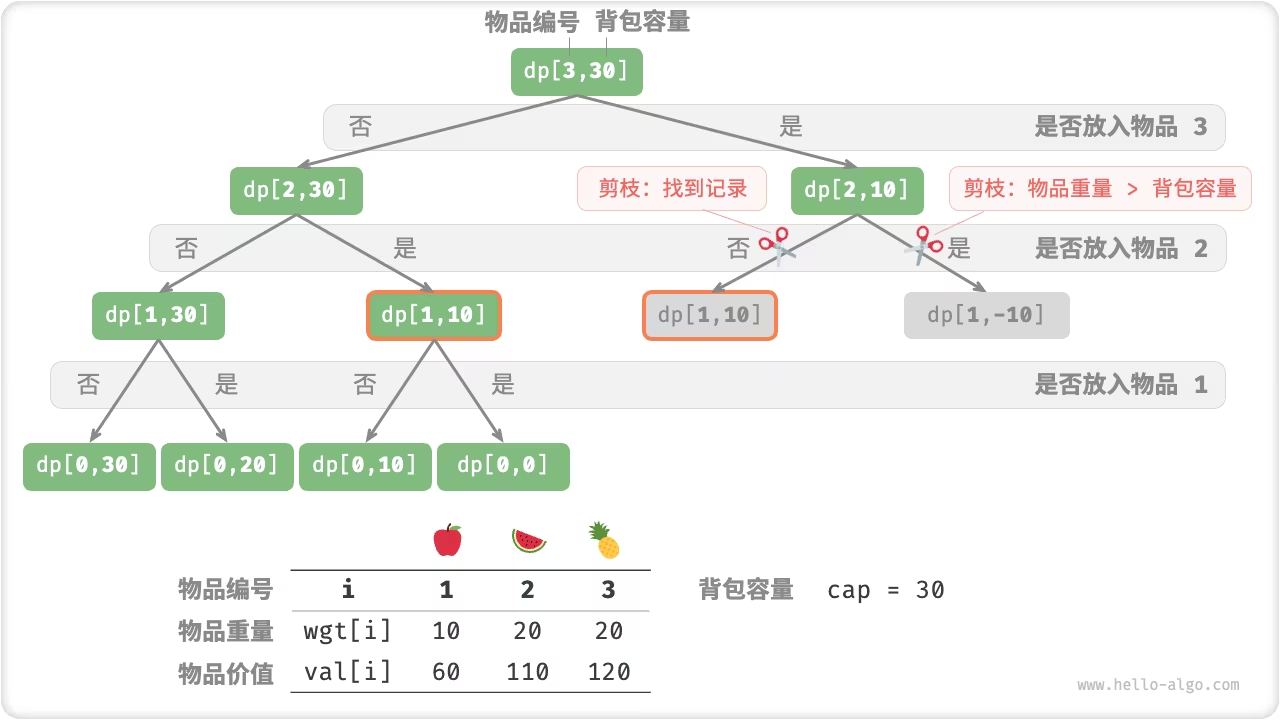
动态规划实质上就是在状态转移中填充 表的过程,代码如下所示。
/* 0-1 背包:动态规划 */int knapsackDP(vector<int> &wgt, vector<int> &val, int cap) { int n = wgt.size(); // 初始化 dp 表 vector<vector<int>> dp(n + 1, vector<int>(cap + 1, 0)); // 状态转移 for (int i = 1; i <= n; i++) { for (int c = 1; c <= cap; c++) { if (wgt[i - 1] > c) { // 若超过背包容量,则不选物品 i dp[i][c] = dp[i - 1][c]; } else { // 不选和选物品 i 这两种方案的较大值 dp[i][c] = max(dp[i - 1][c], dp[i - 1][c - wgt[i - 1]] + val[i - 1]); } } } return dp[n][cap];}如下图所示,时间复杂度和空间复杂度都由数组 dp 大小决定,即 。
【GIF】
由于每个状态都只与其上一行的状态有关,因此我们可以使用两个数组滚动前进,将空间复杂度从 将低至 。
进一步思考,我们是否可以仅用一个数组实现空间优化呢?观察可知,每个状态都是由正上方或左上方的格子转移过来的。假设只有一个数组,当开始遍历第 行时,该数组存储的仍然是第 行的状态。
如果采取正序遍历,那么遍历到 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, j] 时,左上方 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i-1, 1] ~ ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i-1, j-1] 值可能已经被覆盖,此时就无法得到正确的状态转移结果。
如果采取倒序遍历,则不会发生覆盖问题,状态转移可以正确进行。
下图展示了在单个数组下从第 行转换至第 行的过程。请思考正序遍历和倒序遍历的区别。
【GIF】
在代码实现中,我们仅需将数组 dp 的第一维 直接删除,并且把内循环更改为倒序遍历即可。
/* 0-1 背包:空间优化后的动态规划 */int knapsackDPComp(vector<int> &wgt, vector<int> &val, int cap) { int n = wgt.size(); // 初始化 dp 表 vector<int> dp(cap + 1, 0); // 状态转移 for (int i = 1; i <= n; i++) { // 倒序遍历 for (int c = cap; c >= 1; c--) { if (wgt[i - 1] <= c) { // 不选和选物品 i 这两种方案的较大值 dp[c] = max(dp[c], dp[c - wgt[i - 1]] + val[i - 1]); } } } return dp[cap];}完全背包也是一种常见的背包问题,其中的零钱兑换问题的它的特例之一
给定 个物品,第 个物品的重量为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 4: wgt\̲[̲i-1]、价值为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 4: val\̲[̲i-1] ,和一个容量为 的背包。每个物品可以重复选取,问在不超过背包容量下能放入物品的最大价值。

完全背包和 0-1 背包问题非常相似,区别仅在于不限制物品的选择次数。
在 0-1 背包中,每个物品只有一个,因此将物品 放入背包后,只能从前 个物品中选择。
在完全背包中,每个物品有无数个,因此将物品 放入背包后,仍可以从前 个物品中选择。
在完全背包的规定下,状态 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, c] 的变化分为两种情况。
不放入物品 :与 0-1 背包相同,转移至 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i-1, c] 。
放入物品 :与 0-1 背包不同,转移至 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, c-wgt\[i-1]] 。
从而状态转移方程变为:
ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, c] = \max(dp…
对比两道题目的代码,状态转移中有一处从 变为 ,其余完全一致。
/* 完全背包:动态规划 */int unboundedKnapsackDP(vector<int> &wgt, vector<int> &val, int cap) { int n = wgt.size(); // 初始化 dp 表 vector<vector<int>> dp(n + 1, vector<int>(cap + 1, 0)); // 状态转移 for (int i = 1; i <= n; i++) { for (int c = 1; c <= cap; c++) { if (wgt[i - 1] > c) { // 若超过背包容量,则不选物品 i dp[i][c] = dp[i - 1][c]; } else { // 不选和选物品 i 这两种方案的较大值 dp[i][c] = max(dp[i - 1][c], dp[i][c - wgt[i - 1]] + val[i - 1]); } } } return dp[n][cap];}由于当前状态是从左边和上边的状态转移而来,因此空间优化后应该对 表中的每一行采取正序遍历。
这个遍历顺序与 0-1 背包正好相反。
【GIF】
代码实现比较简单,仅需将数组 dp 的第一维删除。
/* 完全背包:空间优化后的动态规划 */int unboundedKnapsackDPComp(vector<int> &wgt, vector<int> &val, int cap) { int n = wgt.size(); // 初始化 dp 表 vector<int> dp(cap + 1, 0); // 状态转移 for (int i = 1; i <= n; i++) { for (int c = 1; c <= cap; c++) { if (wgt[i - 1] > c) { // 若超过背包容量,则不选物品 i dp[c] = dp[c]; } else { // 不选和选物品 i 这两种方案的较大值 dp[c] = max(dp[c], dp[c - wgt[i - 1]] + val[i - 1]); } } } return dp[cap];}给定 种硬币,第 种硬币的面值为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 6: coins\̲[̲i - 1] ,目标金额为 ,每种硬币可以重复选取,问能够凑出目标金额的最少硬币个数。如果无法凑出目标金额则返回 。

零钱兑换可以看作是完全背包的一种特殊情况,两者具有以下联系与不同点。
两道题可以相互转换,“物品”对应于“硬币”、“物品重量”对应于“硬币面值”、“背包容量”对应于“目标金额”。
优化目标相反,背包问题是要最大化物品价值,零钱兑换问题是要最小化硬币数量。
背包问题是求“不超过”背包容量下的解,零钱兑换是求“恰好”凑到目标金额的解。
第一步:思考每轮的决策,定义状态,从而得到 表
状态 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, a] 对应的子问题为:前 种硬币能够凑出金额 的最少硬币个数,记为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, a] 。
二维 表的尺寸为 。
第二步:找出最优子结构,进而推导出状态转移方程
本题与完全背包的状态转移方程存在以下两个差异。
本题要求最小值,因此需将运算符 更改为 。
优化主体是硬币数量而非商品价值,因此在选中硬币时执行 即可。
ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, a] = \min(dp…
第三步:确定边界条件和状态转移顺序
当目标金额为 时,凑出它的最少硬币个数为 ,即首列所有 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, 0] 都等于 。
当无硬币时,无法凑出任意 的目标金额,即是无效解。为使状态转移方程中的 函数能够识别并过滤无效解,我们考虑使用 来表示它们,即令首行所有 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲0, a] 都等于 。
大多数编程语言并未提供 变量,只能使用整型 int 的最大值来代替。而这又会导致大数越界:状态转移方程中的 操作可能发生溢出。
为此,我们采用数字 来表示无效解,因为凑出 的硬币个数最多为 个。
最后返回前,判断 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲n, amt] 是否等于 ,若是则返回 ,代表无法凑出目标金额。
/* 零钱兑换:动态规划 */int coinChangeDP(vector<int> &coins, int amt) { int n = coins.size(); int MAX = amt + 1; // 初始化 dp 表 vector<vector<int>> dp(n + 1, vector<int>(amt + 1, 0)); // 状态转移:首行首列 for (int a = 1; a <= amt; a++) { dp[0][a] = MAX; } // 状态转移:其余行和列 for (int i = 1; i <= n; i++) { for (int a = 1; a <= amt; a++) { if (coins[i - 1] > a) { // 若超过目标金额,则不选硬币 i dp[i][a] = dp[i - 1][a]; } else { // 不选和选硬币 i 这两种方案的较小值 dp[i][a] = min(dp[i - 1][a], dp[i][a - coins[i - 1]] + 1); } } } return dp[n][amt] != MAX ? dp[n][amt] : -1;}下图展示了零钱兑换的动态规划过程,和完全背包非常相似。下图只有 4 块钱的情况,不包括 11 块钱的情况
零钱兑换的空间优化的处理方式和完全背包一致。
/* 零钱兑换:空间优化后的动态规划 */int coinChangeDPComp(vector<int> &coins, int amt) { int n = coins.size(); int MAX = amt + 1; // 初始化 dp 表 vector<int> dp(amt + 1, MAX); dp[0] = 0; // 状态转移 for (int i = 1; i <= n; i++) { for (int a = 1; a <= amt; a++) { if (coins[i - 1] > a) { // 若超过目标金额,则不选硬币 i dp[a] = dp[a]; } else { // 不选和选硬币 i 这两种方案的较小值 dp[a] = min(dp[a], dp[a - coins[i - 1]] + 1); } } } return dp[amt] != MAX ? dp[amt] : -1;}给定 种硬币,第 种硬币的面值为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 6: coins\̲[̲i - 1] ,目标金额为 ,每种硬币可以重复选取,问在凑出目标金额的硬币组合数量。

相比于上一题,本题目标是组合数量,因此子问题变为:前 种硬币能够凑出金额 的组合数量。而 表仍然是尺寸为 的二维矩阵。
当前状态的组合数量等于不选当前硬币与选当前硬币这两种决策的组合数量之和。状态转移方程为:
ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, a] = dp\[i-1…
当目标金额为 时,无须选择任何硬币即可凑出目标金额,因此应将首列所有 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, 0] 都初始化为 。当无硬币时,无法凑出任何 的目标金额,因此首行所有 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲0, a] 都等于 。
/* 零钱兑换 II:动态规划 */int coinChangeIIDP(vector<int> &coins, int amt) { int n = coins.size(); // 初始化 dp 表 vector<vector<int>> dp(n + 1, vector<int>(amt + 1, 0)); // 初始化首列 for (int i = 0; i <= n; i++) { dp[i][0] = 1; } // 状态转移 for (int i = 1; i <= n; i++) { for (int a = 1; a <= amt; a++) { if (coins[i - 1] > a) { // 若超过目标金额,则不选硬币 i dp[i][a] = dp[i - 1][a]; } else { // 不选和选硬币 i 这两种方案之和 dp[i][a] = dp[i - 1][a] + dp[i][a - coins[i - 1]]; } } } return dp[n][amt];}空间优化处理方式相同,删除硬币维度即可。
/* 零钱兑换 II:空间优化后的动态规划 */int coinChangeIIDPComp(vector<int> &coins, int amt) { int n = coins.size(); // 初始化 dp 表 vector<int> dp(amt + 1, 0); dp[0] = 1; // 状态转移 for (int i = 1; i <= n; i++) { for (int a = 1; a <= amt; a++) { if (coins[i - 1] > a) { // 若超过目标金额,则不选硬币 i dp[a] = dp[a]; } else { // 不选和选硬币 i 这两种方案之和 dp[a] = dp[a] + dp[a - coins[i - 1]]; } } } return dp[amt];}其实,这个零钱兑换问题如果使用贪心算法的话,可能会很快的找到最优解,也可能会找到很差的解,如下“贪心”部分,因此,这个问题更适合使用动态规划来解决
编辑距离,也被称为 Levenshtein 距离,指两个字符串之间互相转换的最小修改次数,通常用于在信息检索和自然语言处理中度量两个序列的相似度。
输入两个字符串 和 ,返回将 转换为 所需的最少编辑步数。
你可以在一个字符串中进行三种编辑操作:插入一个字符、删除一个字符、替换字符为任意一个字符。
如下图所示,将 kitten 转换为 sitting 需要编辑 3 步,包括 2 次替换操作与 1 次添加操作;将 hello 转换为 algo 需要 3 步,包括 2 次替换操作和 1 次删除操作。
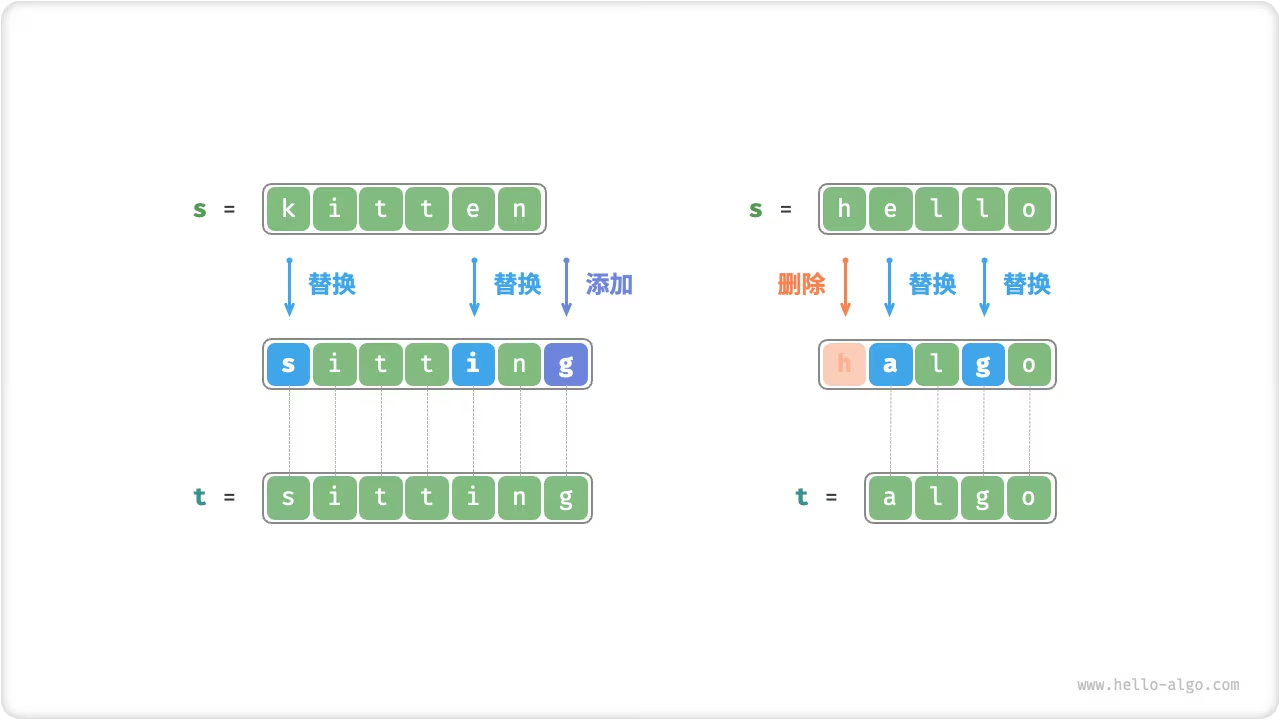
编辑距离问题可以很自然地用决策树模型来解释。字符串对应树节点,一轮决策(一次编辑操作)对应树的一条边。
如下图所示,在不限制操作的情况下,每个节点都可以派生出许多条边,每条边对应一种操作,这意味着从 hello 转换到 algo 有许多种可能的路径。
从决策树的角度看,本题的目标是求解节点 hello 和节点 algo 之间的最短路径。

第一步:思考每轮的决策,定义状态,从而得到 表
每一轮的决策是对字符串 进行一次编辑操作。
我们希望在编辑操作的过程中,问题的规模逐渐缩小,这样才能构建子问题。设字符串 和 的长度分别为 和 ,我们先考虑两字符串尾部的字符 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 2: s\̲[̲n-1] 和 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 2: t\̲[̲m-1] 。
若 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 2: s\̲[̲n-1] 和 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 2: t\̲[̲m-1] 相同,我们可以跳过它们,直接考虑 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 2: s\̲[̲n-2] 和 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 2: t\̲[̲m-2] 。
若 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 2: s\̲[̲n-1] 和 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 2: t\̲[̲m-1] 不同,我们需要对 进行一次编辑(插入、删除、替换),使得两字符串尾部的字符相同,从而可以跳过它们,考虑规模更小的问题。
也就是说,我们在字符串 中进行的每一轮决策(编辑操作),都会使得 和 中剩余的待匹配字符发生变化。因此,状态为当前在 和 中考虑的第 和 个字符,记为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j] 。
状态 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j] 对应的子问题:将 的前 个字符更改为 的前 个字符所需的最少编辑步数。
至此,得到一个尺寸为 的二维 表。
第二步:找出最优子结构,进而推导出状态转移方程
考虑子问题 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, j] ,其对应的两个字符串的尾部字符为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 2: s\̲[̲i-1] 和 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 2: t\̲[̲j-1] ,可根据不同编辑操作分为下图所示的三种情况。
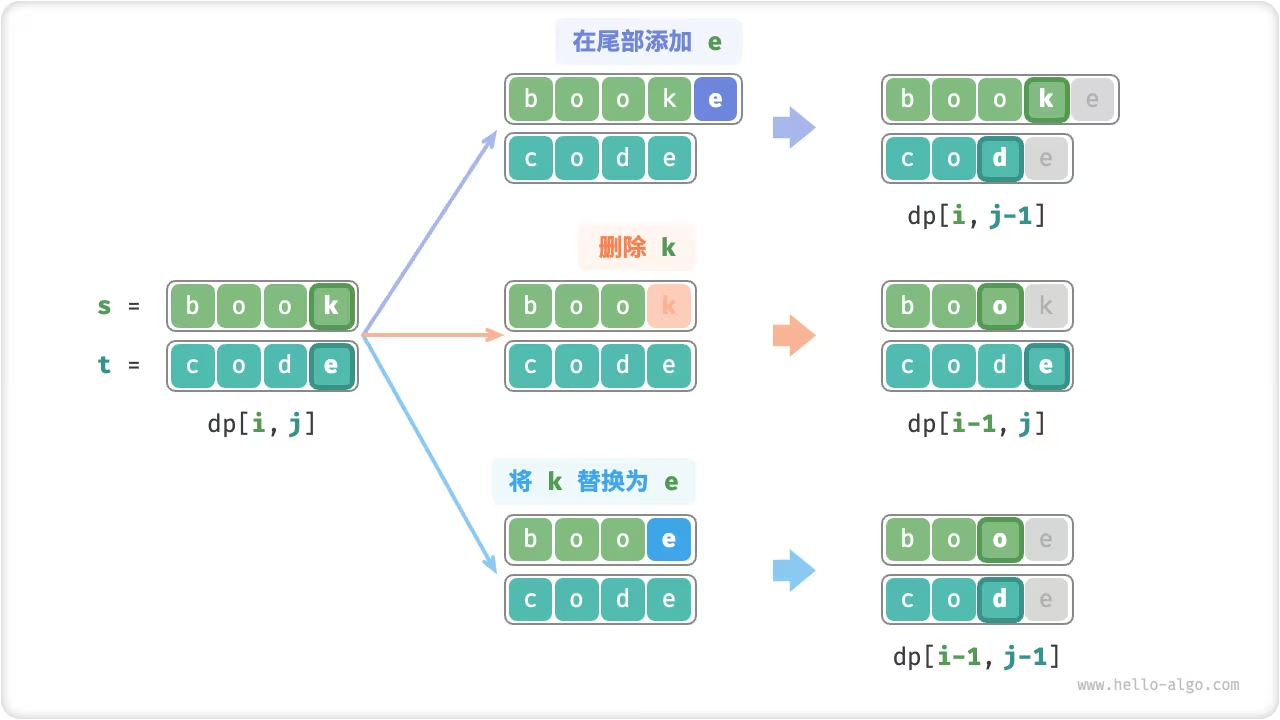
根据以上分析,可得最优子结构:ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, j] 的最少编辑步数等于 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, j-1]、ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i-1, j]、ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i-1, j-1] 三者中的最少编辑步数,再加上本次的编辑步数 。对应的状态转移方程为:
ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, j] = \min(dp…
请注意,当 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 2: s\̲[̲i-1] 和 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 2: t\̲[̲j-1] 相同时,无须编辑当前字符,这种情况下的状态转移方程为:
ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, j] = dp\[i-1…
第三步:确定边界条件和状态转移顺序
当两字符串都为空时,编辑步数为 ,即 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲0, 0] = 0 。当 为空但 不为空时,最少编辑步数等于 的长度,即首行 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲0, j] = j 。当 不为空但 为空时,等于 的长度,即首列 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, 0] = i 。
观察状态转移方程,解 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, j] 依赖左方、上方、左上方的解,因此通过两层循环正序遍历整个 表即可。
/* 编辑距离:动态规划 */int editDistanceDP(string s, string t) { int n = s.length(), m = t.length(); vector<vector<int>> dp(n + 1, vector<int>(m + 1, 0)); // 状态转移:首行首列 for (int i = 1; i <= n; i++) { dp[i][0] = i; } for (int j = 1; j <= m; j++) { dp[0][j] = j; } // 状态转移:其余行和列 for (int i = 1; i <= n; i++) { for (int j = 1; j <= m; j++) { if (s[i - 1] == t[j - 1]) { // 若两字符相等,则直接跳过此两字符 dp[i][j] = dp[i - 1][j - 1]; } else { // 最少编辑步数 = 插入、删除、替换这三种操作的最少编辑步数 + 1 dp[i][j] = min(min(dp[i][j - 1], dp[i - 1][j]), dp[i - 1][j - 1]) + 1; } } } return dp[n][m];}如下图所示,编辑距离问题的状态转移过程与背包问题非常类似,都可以看作是填写一个二维网格的过程。
【GIF】
由于 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i,j] 是由上方 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i-1, j]、左方 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, j-1]、左上方状态 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i-1, j-1] 转移而来,而正序遍历会丢失左上方 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i-1, j-1] ,倒序遍历无法提前构建 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i, j-1] ,因此两种遍历顺序都不可取。
为此,我们可以使用一个变量 leftup 来暂存左上方的解 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i-1, j-1] ,从而只需考虑左方和上方的解。此时的情况与完全背包问题相同,可使用正序遍历。
/* 编辑距离:空间优化后的动态规划 */int editDistanceDPComp(string s, string t) { int n = s.length(), m = t.length(); vector<int> dp(m + 1, 0); // 状态转移:首行 for (int j = 1; j <= m; j++) { dp[j] = j; } // 状态转移:其余行 for (int i = 1; i <= n; i++) { // 状态转移:首列 int leftup = dp[0]; // 暂存 dp[i-1, j-1] dp[0] = i; // 状态转移:其余列 for (int j = 1; j <= m; j++) { int temp = dp[j]; if (s[i - 1] == t[j - 1]) { // 若两字符相等,则直接跳过此两字符 dp[j] = leftup; } else { // 最少编辑步数 = 插入、删除、替换这三种操作的最少编辑步数 + 1 dp[j] = min(min(dp[j - 1], dp[j]), leftup) + 1; } leftup = temp; // 更新为下一轮的 dp[i-1, j-1] } } return dp[m];}动态规划对问题进行分解,并通过存储子问题的解来规避重复计算,实现高效的计算效率。
不考虑时间的前提下,所有动态规划问题都可以用回溯(暴力搜索)进行求解,但递归树中存在大量的重叠子问题,效率极低。通过引入记忆化列表,可以存储所有计算过的子问题的解,从而保证重叠子问题只被计算一次。
记忆化递归是一种从顶至底的递归式解法,而与之对应的动态规划是一种从底至顶的递推式解法,其如同“填写表格”一样。由于当前状态仅依赖于某些局部状态,因此我们可以消除 表的一个维度,从而降低空间复杂度。
子问题分解是一种通用的算法思路,在分治、动态规划、回溯中具有不同的性质。
动态规划问题的三大特性:重叠子问题、最优子结构、无后效性。
如果原问题的最优解可以从子问题的最优解构建得来,则它就具有最优子结构。
无后效性指对于一个状态,其未来发展只与该状态有关,与其所经历的过去的所有状态无关。许多组合优化问题都不具有无后效性,无法使用动态规划快速求解。
背包问题
背包问题是最典型的动态规划题目,具有 0-1 背包、完全背包、多重背包等变种问题。
0-1 背包的状态定义为前 个物品在剩余容量为 的背包中的最大价值。根据不放入背包和放入背包两种决策,可得到最优子结构,并构建出状态转移方程。在空间优化中,由于每个状态依赖正上方和左上方的状态,因此需要倒序遍历列表,避免左上方状态被覆盖。
完全背包的每种物品的选取数量无限制,因此选择放入物品的状态转移与 0-1 背包不同。由于状态依赖于正上方和正左方的状态,因此在空间优化中应当正序遍历。
零钱兑换问题是完全背包的一个变种。它从求“最大”价值变为求“最小”硬币数量,因此状态转移方程中的 应改为 。从求“不超过”背包容量到求“恰好”凑出目标金额,因此使用 来表示“无法凑出目标金额”的无效解。
零钱兑换 II 问题从求“最少硬币数量”改为求“硬币组合数量”,状态转移方程相应地从 改为求和运算符。
编辑距离问题
编辑距离(Levenshtein 距离)用于衡量两个字符串之间的相似度,其定义为从一个字符串到另一个字符串的最小编辑步数,编辑操作包括添加、删除、替换。
编辑距离问题的状态定义为将 的前 个字符更改为 的前 个字符所需的最少编辑步数。当 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 2: s\̲[̲i] \ne t\[j] 时,具有三种决策:添加、删除、替换,它们都有相应的剩余子问题。据此便可以找出最优子结构与构建状态转移方程。而当 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 2: s\̲[̲i] = t\[j] 时,无须编辑当前字符。
在编辑距离中,状态依赖于其正上方、正左方、左上方的状态,因此空间优化后正序或倒序遍历都无法正确地进行状态转移。为此,我们利用一个变量暂存左上方状态,从而转化到与完全背包等价的情况,可以在空间优化后进行正序遍历。
贪心策略在一轮轮的简单选择中,逐步导向最佳答案。
就像向日葵朝着太阳转动,时刻追求着自身成长的最大可能。
「贪心算法 greedy algorithm」是一种常见的解决优化问题的算法,其基本思想是在问题的每个决策阶段,都选择当前看起来最优的选择,即贪心地做出局部最优的决策,以获得全局最优解。因此贪心算法简洁且高效,在一些实际问题上有着广泛的应用
贪心算法和动态规划都常用于解决优化问题。它们之间存在一些相似之处,比如都依赖最优子结构性质,但工作原理是不同的。
动态规划会根据之前阶段的所有决策来考虑当前决策,并使用过去子问题的解来构建当前子问题的解。
贪心算法不会重新考虑过去的决策,而是一路向前地进行贪心选择,不断缩小问题范围,直至问题被解决。
给定 种硬币,第 种硬币的面值为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 6: coins\̲[̲i - 1] ,目标金额为 ,每种硬币可以重复选取,问能够凑出目标金额的最少硬币个数。如果无法凑出目标金额则返回 。
本题的贪心策略如下图所示。给定目标金额,我们贪心地选择不大于且最接近它的硬币,不断循环该步骤,直至凑出目标金额为止。

如下代码,贪心算法仅使用了不到 10 行就解决了零钱兑换问题
/* 零钱兑换:贪心 */int coinChangeGreedy(vector<int> &coins, int amt) { // 假设 coins 列表有序 int i = coins.size() - 1; int count = 0; // 循环进行贪心选择,直到无剩余金额 while (amt > 0) { // 找到小于且最接近剩余金额的硬币 while (i > 0 && coins[i] > amt) { i--; } // 选择 coins[i] amt -= coins[i]; count++; } // 若未找到可行方案,则返回 -1 return amt == 0 ? count : -1;}优点:
贪心算法不仅操作直接、实现简单,而且通常效率也很高。在以上代码中,记硬币最小面值为 ,则贪心选择最多循环 次,时间复杂度为 。这比动态规划解法的时间复杂度 提升了一个数量级。
局限性:
然而,对于某些硬币面值组合,贪心算法并不能找到最优解。下图给出了两个示例。
正例 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 9: coins = \̲[̲1, 5, 10, 20, 5…:在该硬币组合下,给定任意 ,贪心算法都可以找出最优解。
反例 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 9: coins = \̲[̲1, 20, 50]:假设 ,贪心算法只能找到 的兑换组合,共计 枚硬币,但动态规划可以找到最优解 ,仅需 枚硬币。
反例 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 9: coins = \̲[̲1, 49, 50]:假设 ,贪心算法只能找到 的兑换组合,共计 枚硬币,但动态规划可以找到最优解 ,仅需 枚硬币。

也就是说,对于零钱兑换问题,贪心算法无法保证找到全局最优解,并且有可能找到非常差的解。它更适合用动态规划解决。
因此,一般情况下,贪心算法适用于以下两类问题。
那么问题来了,什么样的问题适合用贪心算法求解呢?或者说,贪心算法在什么情况下可以保证找到最优解?
相较于动态规划,贪心算法的使用条件更加苛刻,其主要关注问题的两个性质。
贪心选择性质:只有当局部最优选择始终可以导致全局最优解时,贪心算法才能保证得到最优解。由特例到一般情况
最优子结构:原问题的最优解包含子问题的最优解。
最优子结构已经在动态规划章节中介绍过,
就是
dp=max(dp1,dp2)这一段(选择最优的子结构,最优子结构可能是dp1,也可能是dp2)。
值得注意的是,一些问题的最优子结构并不明显,但仍然可使用贪心算法解决。
我们主要探究贪心选择性质的判断方法。虽然它的描述看上去比较简单,但实际上对于许多问题,证明贪心选择性质不是一件易事。
例如零钱兑换问题,我们虽然能够容易地举出反例,对贪心选择性质进行证伪,但证实的难度较大。如果问:满足什么条件的硬币组合可以使用贪心算法求解?我们往往只能凭借直觉或举例子来证明使用贪心解决有缺陷,但难以直接给出严谨的数学证明。(其实是有方法可以使用贪心算法来判断一个硬币组合是否可以找出任意金额的最优解的,只不过需要 的时间复杂度,还不如动态规划呢)
当然就是把大象装进冰箱的三部啦~
其中的确定贪心策略是求解问题的核心步骤,但实施起来可能并不容易,主要包含以下原因。
不同问题的贪心策略的差异较大。对于许多问题来说,贪心策略都比较浅显,我们通过一些大概的思考与尝试就能得出。而对于一些复杂问题,贪心策略可能非常隐蔽,这种情况就非常考验个人的解题经验与算法能力了。
某些贪心策略具有较强的迷惑性。当我们满怀信心设计好贪心策略,写出解题代码并提交运行,很可能发现部分测试样例无法通过。这是因为设计的贪心策略只是“部分正确”的,上文介绍的零钱兑换就是个典型案例。
为了保证正确性,我们应该对贪心策略进行严谨的数学证明,通常需要用到反证法或数学归纳法。
然而,正确性证明也很可能不是一件易事。如若没有头绪,我们通常会选择面向测试用例进行代码调试 ,一步步修改与验证贪心策略。
贪心算法常常应用在满足贪心选择性质和最优子结构的优化问题中,以下列举了一些典型的贪心算法问题。
硬币找零问题:在某些硬币组合下,贪心算法总是可以得到最优解。
区间调度问题:假设你有一些任务,每个任务在一段时间内进行,你的目标是完成尽可能多的任务。如果每次都选择结束时间最早的任务,那么贪心算法就可以得到最优解。
分数背包问题:给定一组物品和一个载重量,你的目标是选择一组物品,使得总重量不超过载重量,且总价值最大。如果每次都选择性价比最高(价值 / 重量)的物品,那么贪心算法在一些情况下可以得到最优解。
股票买卖问题:给定一组股票的历史价格,你可以进行多次买卖,但如果你已经持有股票,那么在卖出之前不能再买,目标是获取最大利润。
霍夫曼编码:霍夫曼编码是一种用于无损数据压缩的贪心算法。通过构建霍夫曼树,每次选择出现频率最小的两个节点合并,最后得到的霍夫曼树的带权路径长度(即编码长度)最小。
Dijkstra 算法:它是一种解决给定源顶点到其余各顶点的最短路径问题的贪心算法。
给定 个物品,第 个物品的重量为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 4: wgt\̲[̲i-1]、价值为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 4: val\̲[̲i-1] ,和一个容量为 的背包。每个物品只能选择一次,但可以选择物品的一部分,价值根据选择的重量比例计算,问在不超过背包容量下背包中物品的最大价值。

分数背包和 0-1 背包整体上非常相似,状态包含当前物品 和容量 ,目标是求不超过背包容量下的最大价值。
不同点在于,本题允许只选择物品的一部分。如下图所示,我们可以对物品任意地进行切分,并按照重量比例来计算物品价值。

最大化背包内物品总价值,本质上是要最大化单位重量下的物品价值。由此便可推出下图所示的贪心策略。
将物品按照单位价值从高到低进行排序。
若剩余背包容量不足,则使用当前物品的一部分填满背包即可。

我们建立了一个物品类 Item ,以便将物品按照单位价值进行排序。循环进行贪心选择,当背包已满时跳出并返回解。
/* 物品 */class Item { public: int w; // 物品重量 int v; // 物品价值 Item(int w, int v) : w(w), v(v) { }}; /* 分数背包:贪心 */double fractionalKnapsack(vector<int> &wgt, vector<int> &val, int cap) { // 创建物品列表,包含两个属性:重量、价值 vector<Item> items; for (int i = 0; i < wgt.size(); i++) { items.push_back(Item(wgt[i], val[i])); } // 按照单位价值 item.v / item.w 从高到低进行排序 sort(items.begin(), items.end(), [](Item &a, Item &b) { return (double)a.v / a.w > (double)b.v / b.w; }); // 循环贪心选择 double res = 0; for (auto &item : items) { if (item.w <= cap) { // 若剩余容量充足,则将当前物品整个装进背包 res += item.v; cap -= item.w; } else { // 若剩余容量不足,则将当前物品的一部分装进背包 res += (double)item.v / item.w * cap; // 已无剩余容量,因此跳出循环 break; } } return res;}最差情况下,需要遍历整个物品列表,因此时间复杂度为 ,其中 为物品数量。
由于初始化了一个 Item 对象列表,因此空间复杂度为 。
采用反证法。设:"物品 为单位价值最高的物品";“使用某算法求得最大价值为 res ,但该解中不包含物品 ”。
现在我们从背包中拿出某物品替换为物品 (都切出相同的重量来交换)。由于物品 的单位价值最高,所以替换后的总价值一定大于 res (原来的最优解)。这与 res 是最优解矛盾,说明最优解中必须包含物品 。
并且对于该解中的其他物品,我们也可以构建出上述矛盾。总而言之,单位价值更大的物品总是更优选择,这说明对于分数背包问题,贪心策略是有效的。
如下图所示,如果将物品重量和物品单位价值分别看作一个 2D 图表的横轴和纵轴,则分数背包问题可被转化为“求在限定轴区间下的最大围成面积”。这个类比可以帮助我们从几何角度理解贪心策略的有效性。

输入一个数组 ,数组中的每个元素代表一个垂直隔板的高度。数组中的任意两个隔板,以及它们之间的空间可以组成一个容器。
容器的容量等于高度和宽度的乘积(即面积),其中高度由较短的隔板决定,宽度是两个隔板的数组索引之差。
请在数组中选择两个隔板,使得组成的容器的容量最大,返回最大容量。
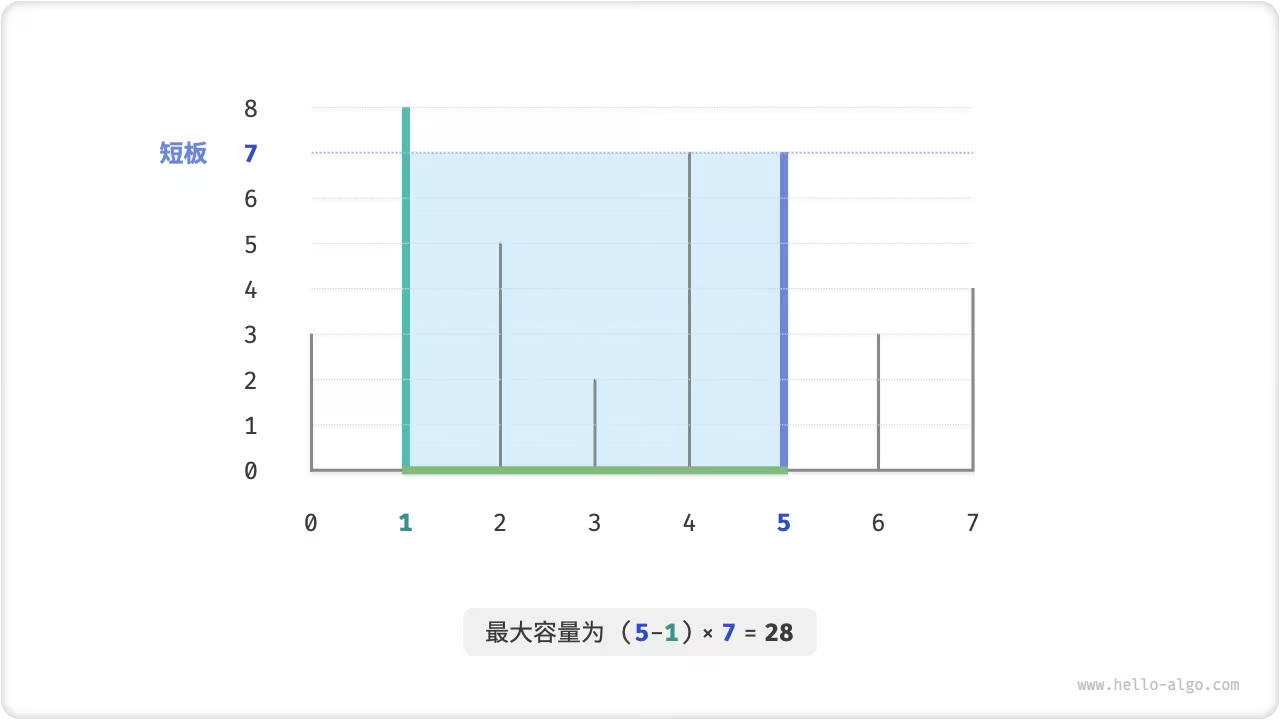
容器由任意两个隔板围成,因此本题的状态为两个隔板的索引,记为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j] 。
根据题意,容量等于高度乘以宽度,其中高度由短板决定,宽度是两隔板的索引之差。设容量为 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 4: cap\̲[̲i, j] ,则可得计算公式:
ParseError: KaTeX parse error: Undefined control sequence: \[ at position 4: cap\̲[̲i, j] = \min(ht…
设数组长度为 ,两个隔板的组合数量(即状态总数)为 个。最直接地,我们可以穷举所有状态,从而求得最大容量,时间复杂度为 。
这道题还有更高效率的解法。如下图所示,现选取一个状态 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲i, j] ,其满足索引 且高度 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 3: ht\̲[̲i] < ht\[j] ,即 为短板、 为长板。
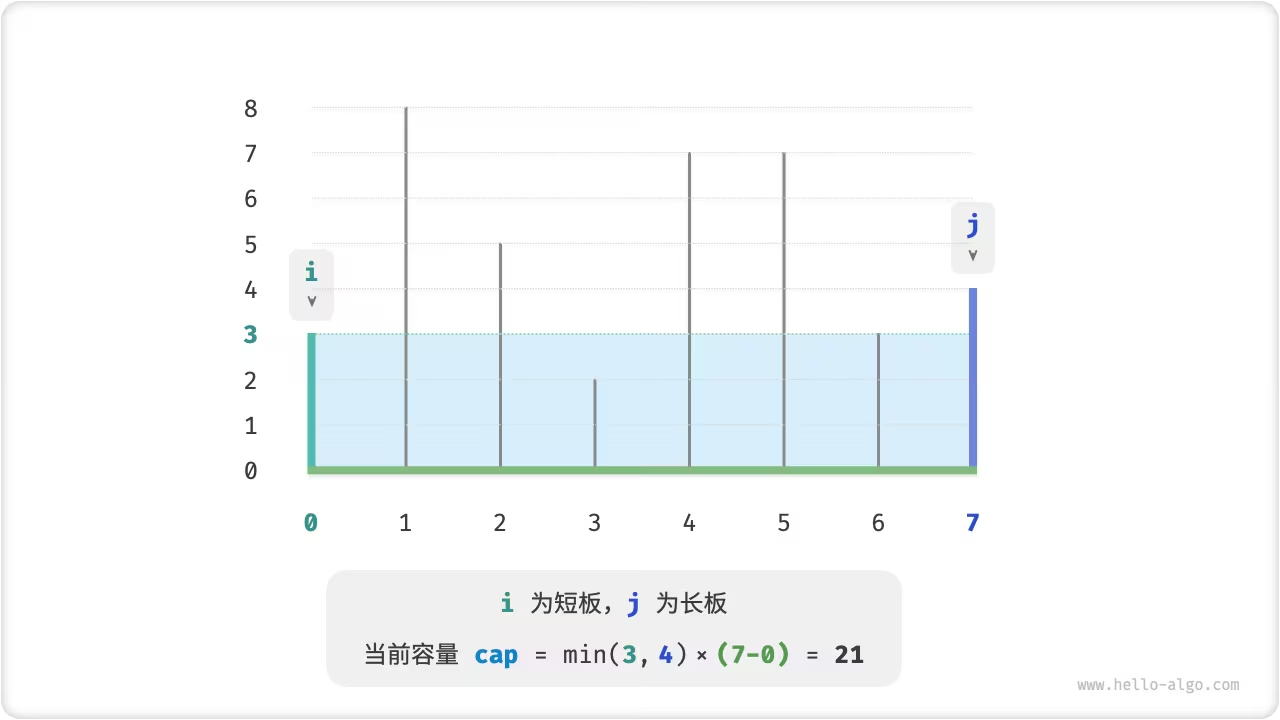
如下图所示,若此时将长板 向短板 靠近,则容量一定变小。
这是因为在移动长板 后,宽度 肯定变小;而高度由短板决定,因此高度只可能不变( 仍为短板)或变小(移动后的 成为短板)。

反向思考,我们只有向内收缩短板 ,才有可能使容量变大。因为虽然宽度一定变小,但高度可能会变大(移动后的短板 可能会变长)。例如在下图中,移动短板后面积变大。

由此便可推出本题的贪心策略:初始化两指针分裂容器两端,每轮向内收缩短板对应的指针,直至两指针相遇。
下图展示了贪心策略的执行过程。
2. 和 3. 步,直至 和 相遇时结束。【GIF】
代码循环最多 轮,因此时间复杂度为 。
变量 、、 使用常数大小额外空间,因此空间复杂度为 。
/* 最大容量:贪心 */int maxCapacity(vector<int> &ht) { // 初始化 i, j 分列数组两端 int i = 0, j = ht.size() - 1; // 初始最大容量为 0 int res = 0; // 循环贪心选择,直至两板相遇 while (i < j) { // 更新最大容量 int cap = min(ht[i], ht[j]) * (j - i); res = max(res, cap); // 向内移动短板 if (ht[i] < ht[j]) { i++; } else { j--; } } return res;}之所以贪心比穷举更快,是因为每轮的贪心选择都会“跳过”一些状态。
比如在状态 ParseError: KaTeX parse error: Undefined control sequence: \[ at position 4: cap\̲[̲i, j] 下, 为短板、 为长板。若贪心地将短板 向内移动一格,会导致下图所示的状态被“跳过”。这意味着之后无法验证这些状态的容量大小。
ParseError: KaTeX parse error: Undefined control sequence: \[ at position 4: cap\̲[̲i, i+1], cap\[i…

观察发现,这些被跳过的状态实际上就是将长板 向内移动的所有状态。而在第二步中,我们已经证明内移长板一定会导致容量变小。也就是说,被跳过的状态都不可能是最优解,跳过它们不会导致错过最优解。
以上的分析说明,移动短板的操作是“安全”的,贪心策略是有效的。
给定一个正整数 ,将其切分为至少两个正整数的和,求切分后所有整数的乘积最大是多少。
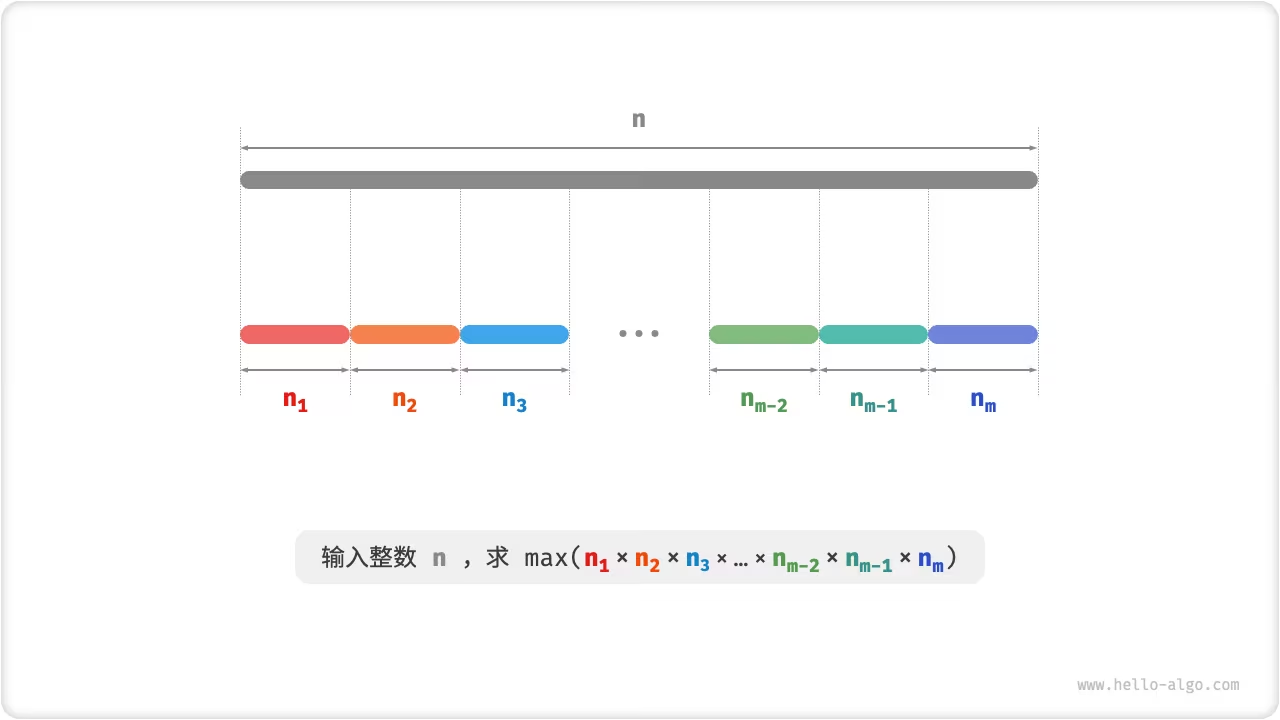
假设我们将 切分为 个整数因子,其中第 个因子记为 ,即
本题目标是求得所有整数因子的最大乘积,即
(这个是连乘符号)
我们需要思考的是:切分数量 应该多大,每个 应该是多少?
根据经验,两个整数的乘积往往比它们的加和更大。假设从 中分出一个因子 ,则它们的乘积为 。我们将该乘积与 作比较:
如下图所示,当 时,切分出一个 后乘积会变大,这说明大于等于 的整数都应该被切分。
贪心策略一:如果切分方案中包含 的因子,那么它就应该被继续切分。最终的切分方案只应出现 、、 这三种因子。

接下来思考哪个因子是最优的。在 、、 这三个因子中,显然 是最差的,因为 恒成立,即切分出 反而会导致乘积减小。
如下图所示,当 时,有 。这意味着切分出 比切分出 更优。
贪心策略二:在切分方案中,最多只应存在两个 。因为三个 总是可以被替换为两个 ,从而获得更大乘积。
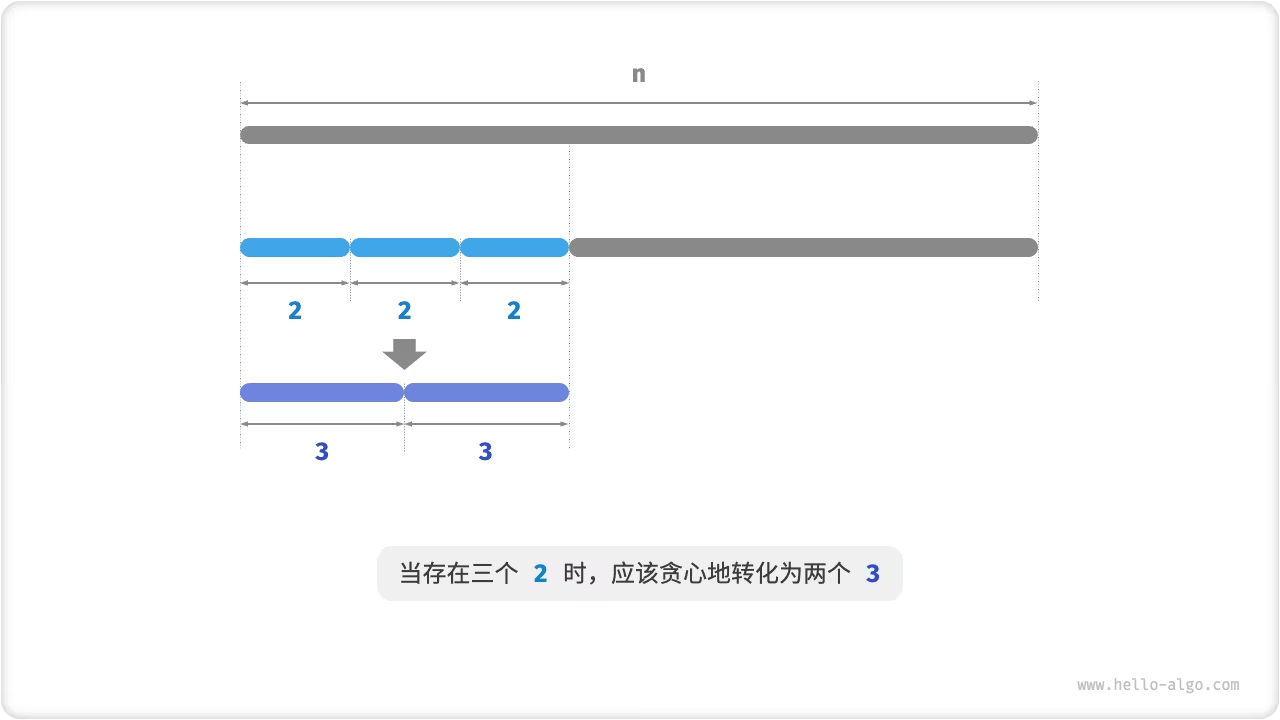
综上所述,可推出以下贪心策略。
如下图所示,我们无须通过循环来切分整数,而可以利用向下整除运算得到 的个数 ,用取模运算得到余数 ,此时有:
注,对于 的边界情况,必须拆分出一个 ,乘积为 。
/* 最大切分乘积:贪心 */int maxProductCutting(int n) { // 当 n <= 3 时,必须切分出一个 1 if (n <= 3) { return 1 * (n - 1); } // 贪心地切分出 3 ,a 为 3 的个数,b 为余数 int a = n / 3; int b = n % 3; if (b == 1) { // 当余数为 1 时,将一对 1 * 3 转化为 2 * 2 return (int)pow(3, a - 1) * 2 * 2; } if (b == 2) { // 当余数为 2 时,不做处理 return (int)pow(3, a) * 2; } // 当余数为 0 时,不做处理 return (int)pow(3, a);}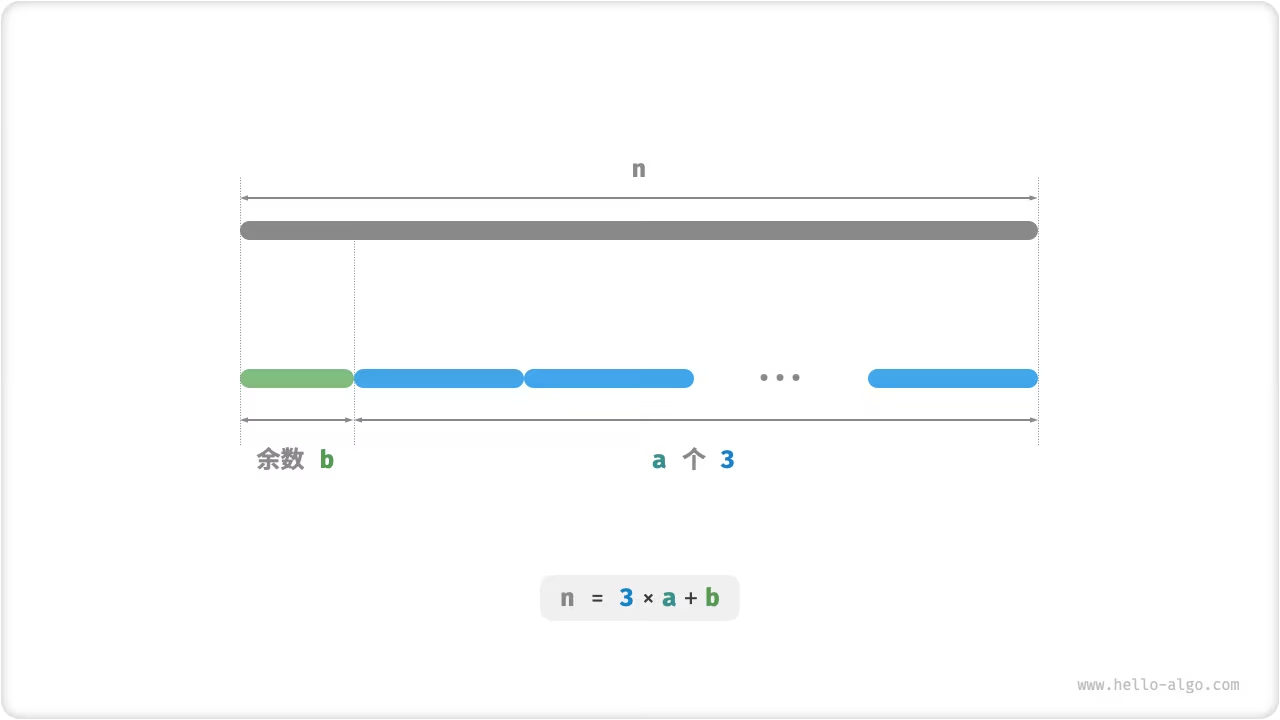
时间复杂度取决于编程语言的幂运算的实现方法。以 Python 为例,常用的幂计算函数有三种。
运算符 ** 和函数 pow() 的时间复杂度均为 。
函数 math.pow() 内部调用 C 语言库的 pow() 函数,其执行浮点取幂,时间复杂度为 。
变量 和 使用常数大小的额外空间,因此空间复杂度为 。
使用反证法,只分析 的情况。
数据结构与算法的重要名词
| 中文 | English | 中文 | English |
|---|---|---|---|
| 算法 | algorithm | 层序遍历 | level-order traversal |
| 数据结构 | data structure | 广度优先遍历 | breadth-first traversal |
| 渐近复杂度分析 | asymptotic complexity analysis | 深度优先遍历 | depth-first traversal |
| 时间复杂度 | time complexity | 二叉搜索树 | binary search tree |
| 空间复杂度 | space complexity | 平衡二叉搜索树 | balanced binary search tree |
| 迭代 | iteration | 平衡因子 | balance factor |
| 递归 | recursion | 堆 | heap |
| 尾递归 | tail recursion | 大顶堆 | max heap |
| 递归树 | recursion tree | 小顶堆 | min heap |
| 大 记号 | big- notation | 优先队列 | priority queue |
| 渐近上界 | asymptotic upper bound | 堆化 | heapify |
| 原码 | sign-magnitude | 图 | graph |
| 反码 | 1’s complement | 顶点 | vertex |
| 补码 | 2’s complement | 无向图 | undirected graph |
| 数组 | array | 有向图 | directed graph |
| 索引 | index | 连通图 | connected graph |
| 链表 | linked list | 非连通图 | disconnected graph |
| 链表节点 | linked list node, list node | 有权图 | weighted graph |
| 列表 | list | 邻接 | adjacency |
| 动态数组 | dynamic array | 路径 | path |
| 硬盘 | hard disk | 入度 | in-degree |
| 内存 | random-access memory (RAM) | 出度 | out-degree |
| 缓存 | cache memory | 邻接矩阵 | adjacency matrix |
| 缓存未命中 | cache miss | 邻接表 | adjacency list |
| 缓存命中率 | cache hit rate | 广度优先搜索 | breadth-first search |
| 栈 | stack | 深度优先搜索 | depth-first search |
| 队列 | queue | 二分查找 | binary search |
| 双向队列 | double-ended queue | 搜索算法 | searching algorithm |
| 哈希表 | hash table | 排序算法 | sorting algorithm |
| 桶 | bucket | 选择排序 | selection sort |
| 哈希函数 | hash function | 冒泡排序 | bubble sort |
| 哈希冲突 | hash collision | 插入排序 | insertion sort |
| 负载因子 | load factor | 快速排序 | quick sort |
| 链式地址 | separate chaining | 归并排序 | merge sort |
| 开放寻址 | open addressing | 堆排序 | heap sort |
| 线性探测 | linear probing | 桶排序 | bucket sort |
| 懒删除 | lazy deletion | 计数排序 | counting sort |
| 二叉树 | binary tree | 基数排序 | radix sort |
| 树节点 | tree node | 分治 | divide and conquer |
| 左子节点 | left-child node | 汉诺塔问题 | hanota problem |
| 右子节点 | right-child node | 回溯算法 | backtracking algorithm |
| 父节点 | parent node | 约束 | constraint |
| 左子树 | left subtree | 解 | solution |
| 右子树 | right subtree | 状态 | state |
| 根节点 | root node | 剪枝 | pruning |
| 叶节点 | leaf node | 全排列问题 | permutations problem |
| 边 | edge | 子集和问题 | subset-sum problem |
| 层 | level | N 皇后问题 | N-queens problem |
| 度 | degree | 动态规划 | dynamic programming |
| 高度 | height | 初始状态 | initial state |
| 深度 | depth | 状态转移方程 | state-trasition equation |
| 完美二叉树 | perfect binary tree | 背包问题 | knapsack problem |
| 完全二叉树 | complete binary tree | 编辑距离问题 | edit distance problem |
| 完满二叉树 | full binary tree | 贪心算法 | greedy algorithm |
| 平衡二叉树 | balanced binary tree | ||
| AVL 树 | AVL tree | ||
| 红黑树 | red-black tree |
记得导出到 html 格式,然后通过判断图片有没有成功打卡来将一些还是指向 hello-algo 的图片改成本地的
kmp 算法
做项目和做算法一个是工程问题,一个是数学问题
在解决项目问题时,一般需要全局思考、协作能力和项目管理技能,考虑到业务需求、用户体验、系统可靠性等方面;而在解决算法题时,需要更注重分析问题的本质、抽象问题、运用逻辑推理和数学思维等能力。
然而,项目开发和算法题实际上是相辅相成的,它们都需要一定的编程技巧、问题解决的能力和逻辑思维。在实践中,可以通过多做项目和算法题,不断提升自己的编程和问题解决能力。
分享你的想法,与大家交流讨论
Twikoo 加载失败
Twikoo 脚本加载失败