Python 笔记
发布于 2026-04-06更新于 2026-11-1411688 字76 分钟 · 阅读时间
这里说的 Python 是 Python3.x
2023-10-12 ~ 202-- 2025-5-5最后更新日期
Python 安装:
官网下载地址:http://www.python.org/download/
记得勾选环境变量,并更改安装路径:
D:/Program Files/Python/Python312
VSCode:
在插件中输入:Python,并安装这个插件
然后按Ctrl+Shift+P打开命令面板,然后输入Python: Select Interpreter,之后选择 Python 安装路径下的 python.exe 程序
{ "name": "Python: 当前文件", //内部打开 "type": "python", "request": "launch", "program": "${file}", "console": "integratedTerminal", "justMyCode": true},{ "name": "Python: 外部打开", "type": "python", "request": "launch", "program": "${file}", "console": "externalTerminal", "justMyCode": true},然后输入第一个程序,运行一下试试:
print('hello world')可以直接在命令行中输入python 然后即可直接在>>>后方运行了,如
PS C:\Users\PYW> pythonPython 3.12.0 (tags/v3.12.0:0fb18b0, Oct 2 2023, 13:03:39) [MSC v.1935 64 bit (AMD64)] on win32Type "help", "copyright", "credits" or "license" for more information.>>> print("hello world")hello world>>>以下为 Python 命令行参数:
| 选项 | 描述 |
|---|---|
| -d | 在解析时显示调试信息 |
| -O | 生成优化代码 ( .pyo 文件 ) |
| -S | 启动时不引入查找 Python 路径的位置 |
| -V | 输出 Python 版本号 |
| -X | 从 1.6 版本之后基于内建的异常(仅仅用于字符串)已过时。 |
| -c cmd | 执行 Python 脚本,并将运行结果作为 cmd 字符串。 |
| file | 在给定的 python 文件执行 python 脚本。 |
使用
C:>python script.py # 用于运行python文件没啥好说的
**编码:**UTF-8
**标识符:**对于 ASCII 和 C 一样,也可以用中文等
保留字/关键字:
>>> import keyword>>> keyword.kwlist['False', 'None', 'True', 'and', 'as', 'assert', 'async', 'await', 'break', 'class', 'continue', 'def', 'del', 'elif', 'else', 'except', 'finally', 'for', 'from', 'global', 'if', 'import', 'in', 'is', 'lambda', 'nonlocal', 'not', 'or', 'pass', 'raise', 'return', 'try', 'while', 'with', 'yield']**注释:**因为可以在命令行中直接写,因此行内注释为#
命令行中:>>> # 第一行注释>>> print("hello,world") # 第二行注释hello,world>>>>>> '''... 第三行注释... 第四行注释... ''''\n第三行注释\第四行注释\n'>>> """... 第五行注释... 第六行注释... """'\n第五行注释\第六行注释\n'-------------------------------------------------------文件中:# 第一行注释print("hello,world") # 第二行注释 '''第三行注释第四行注释''' """第五行注释第六行注释"""输出:hello,world常见问题:'''这是外部的多行注释可以包含一些描述性的内容 ''' 这是尝试嵌套的多行注释 会导致语法错误 '''''' '''这是外部的多行注释可以包含一些描述性的内容 # 这是内部的单行注释# 可以嵌套在多行注释中'''行与缩进:
python 中通过使用缩进来表示代码块
其中该文件的所有缩进的空格要一致,不能一会 4 个一会 3 个
多行语句:
和 C++差不多
# 对于普通语句,可以使用反斜杠 \ 来实现多行语句:total = item_one + \ item_two + \ item_three# 在 [], {}, 或 () 中的多行语句,不需要使用反斜杠 \,例如:total = item_one + \ item_two + \ item_three数据类型:[如下](##2. 数据类型)
**空行:**没有语法作用,仅仅是易读美观
输入:
input("请输入:") # 先输出"请输入:",然后再获取输入input(12345) # 先输出"12345" ,然后再获取输入同一行写多条语句:
通过在两句话之间加分号;来进行
if True: print ("Answer") print ("True")else: print ("Answer");print ("False")输出:
默认是换行输出的
x="a"y="b"# 换行输出print( x )print( y ) print('---------')# 不换行输出print( x, end=" " )print( y, end=" " )print()导入模块(import 与 from...import):
在 python 用 import 或者 from...import 来导入相应的模块。
将整个模块(somemodule)导入,格式为: import somemodule
从某个模块中导入某个函数,格式为: from somemodule import somefunction
从某个模块中导入多个函数,格式为: from somemodule import firstfunc, secondfunc, thirdfunc
将某个模块中的全部函数导入,格式为: from somemodule import *
Q:
from somemodule import *和import somemodule的区别是什么A:在 Python 中,
from somemodule import *和import somemodule有一些重要的区别。让我们来看看它们的区别:
from somemodule import *:
这种语法会导入指定模块(
somemodule)中的所有公开成员(函数、类、变量等),包括以单下划线_开头的成员。但是,不会导入以双下划线__开头的成员。使用
from somemodule import *可能会导致命名空间污染(namespace pollution),因为它将所有公开成员引入当前命名空间,可能覆盖已有的同名变量或函数。import somemodule:
这种语法仅仅是导入指定模块(
somemodule)的命名空间,并不直接将其中的成员引入当前命名空间。在使用模块中的成员时,需要通过somemodule.member的方式进行访问。相比于
from somemodule import *,使用import somemodule可以更好地控制命名空间,避免命名冲突和提高代码的可读性。综上所述,一般来说,推荐使用
import somemodule的方式来导入模块,因为这种方式更加明确,避免了可能的命名空间污染问题。如果只需要导入模块中的少量特定成员,也可以使用from somemodule import member1, member2的方式来选择性地导入所需成员,而不是使用通配符*。
Python 中的变量不需要声明。每个变量在使用前都必须赋值,变量赋值以后该变量才会被创建。
在 Python 中,变量就是变量,它没有类型,我们所说的"类型"是变量所指的内存中对象的类型。
counter = 100 # 整型变量miles = 1000.0 # 浮点型变量name = "sakurakugu" # 字符串 print (counter)print (miles)print (name)这样也是可以的:
a = b = c = 1a, b, c = 1, 2, "Sakura"标准数据类型:
Number(数字)
String(字符串)
bool(布尔类型)
List(列表)
Tuple(元组)
Set(集合)
Dictionary(字典)
其中:
**不可变数据(3 个):**Number(数字)、String(字符串)、Tuple(元组)
**可变数据(3 个):**List(列表)、Dictionary(字典)、Set(集合)
此外还有一些高级的数据类型,如: 字节数组类型(bytes)。
int (整数), 如 1, 只有一种整数类型 int,表示为长整型,没有 python2 中的 Long。
bool (布尔), 如 True。
float (浮点数), 如 1.23、3E-2
complex (复数), 如 1 + 2j、 1.1 + 2.2j
可以用内置的 type() 函数或用 isinstance()来查询变量所指的对象类型。
>>> a, b, c, d = 20, 5.5, True, 4+3j>>> print(type(a), type(b), type(c), type(d))<class 'int'> <class 'float'> <class 'bool'> <class 'complex'>>>> a = 111>>> isinstance(a, int)Trueisinstance 和 type 的区别在于:
type()不会认为子类是一种父类类型。
isinstance()会认为子类是一种父类类型。
Python>>> class A:... pass...>>> class B(A):... pass...>>> isinstance(A(), A)True>>> type(A()) == ATrue>>> isinstance(B(), A)True>>> type(B()) == AFalse
**注意:**Python3 中,bool 是 int 的子类,True 和 False 可以和数字相加, True1、False0 会返回 True,但可以通过 is 来判断类型。
>>> issubclass(bool, int)True>>> True==1True>>> False==0True>>> True+12>>> False+11>>> 1 is TrueFalse>>> 0 is FalseFalse
表示十六进制或八进制的整数:
>>> number = 0xA0F # 十六进制 0X也可>>> number2575 >>> number=0o123 # 八进制 0O也可>>> number83数字类型转换:
>>> a = 1.0>>> int(a)1创建变量与删除变量:
当使用 del 语句删除一个变量引用时,Python 会删除该变量,并释放其占用的内存。如果该变量是对象的唯一引用,那么该对象也会被删除。
var = 100 # 创建一个变量 vardel var # 删除变量 varvar_a = 200var_b = 300del var_a, var_b # 同时删除 var_a 和 var_b数值类型的实例:
| int | float | complex |
|---|---|---|
| 10 | 0.0 | 3.14j |
| 100 | 15.20 | 45.j |
| -786 | -21.9 | 9.322e-36j |
| 080 | 32.3e+18 | .876j |
| -0490 | -90. | -.6545+0J |
| -0x260 | -32.54e100 | 3e+26J |
| 0x69 | 70.2E-12 | 4.53e-7j |
Python 还支持复数,复数由实数部分和虚数部分构成,可以用 a + bj,或者 complex(a,b) 表示, 复数的实部 a 和虚部 b 都是浮点型。
所有的字符串都是 Unicode 字符串
Python 中单引号 ' 和双引号 " 使用完全相同。
使用三引号(''' 或 """)可以指定一个多行字符串。
转义符 ****。
反斜杠可以用来转义,在字符串前使用 r 可以让反斜杠不发生转义。 如 r"this is a line with \n" 则 \n 会显示,并不是换行。
按字面意义级联字符串,如 "this is " "string" "." 会被自动转换为 this is string.。
>>> print("this is " "string" ".")this is string.字符串可以用 + 运算符连接在一起,用 * 运算符重复。
>>> print("this is "+"string" "."*3)this is string.string.string.Python 中的字符串有两种索引方式,从左往右以 0 开始,从右往左以 -1 开始。
-1 为倒数第一个,-2 为倒数第二个Python 中的字符串不能改变。
Python 没有单独的字符类型,一个字符就是长度为 1 的字符串。
字符串的截取的语法格式如下:变量[头下标:尾下标:步长]
ParseError: KaTeX parse error: Undefined control sequence: \[ at position 1: \̲[̲头下标,尾下标) 左闭右开
步长从头下标开始算,包括要输出的值
str='123456789' print(str) # 输出字符串print(str[0:-1]) # 输出第一个到倒数第一个字符之前的所有字符print(str[0:]) # 输出第一个到最后一个字符的所有字符print(str[0]) # 输出字符串第一个字符print(str[-1]) # 输出字符串倒数第一个字符print(str[-2]) # 输出字符串倒数第二个字符print(str[2:5]) # 输出从第三个开始到第六个之前的字符print(str[2:]) # 输出从第三个开始后的所有字符print(str[:5]) # 输出第五个之前的所有字符print(str[1:5:2]) # 输出从第二个开始到第五个且每隔一个的字符(步长为2)print(str[::2]) # 输出从每隔一个的字符(步长为2,包括本身)print(str * 2) # 输出字符串两次print(str + '你好') # 连接字符串 print('------------------------------') print('hello\nworld') # 使用反斜杠(\)+n转义特殊字符print(r'hello\nworld') # 在字符串前面添加一个 r,表示原始字符串,不会发生转义# 输出:123456789123456781234567891983453456789123452413579123456789123456789123456789你好------------------------------helloworldhello\nworld与 C 字符串不同的是,Python 字符串不能被改变。向一个索引位置赋值,比如 word[0] = 'm' 会导致错误。
字符串运算符
下表实例变量 a 值为字符串 "Hello",b 变量值为 "Python":
| 操作符 | 描述 | 实例 |
|---|---|---|
| + | 字符串连接 | a + b 输出结果: HelloPython |
| * | 重复输出字符串 | a*2 输出结果:HelloHello |
| [] | 通过索引获取字符串中字符 | a[1] 输出结果 e |
| [ : ] | 截取字符串中的一部分,遵循左闭右开原则,str[0:2] 是不包含第 3 个字符的。 | a[1:4] 输出结果 ell |
| in | 成员运算符 - 如果字符串中包含给定的字符返回 True | 'H' in a 输出结果 True |
| not in | 成员运算符 - 如果字符串中不包含给定的字符返回 True | 'M' not in a 输出结果 True |
| r/R | 原始字符串 - 原始字符串:所有的字符串都是直接按照字面的意思来使用,没有转义特殊或不能打印的字符。 原始字符串除在字符串的第一个引号前加上字母 r(可以大小写)以外,与普通字符串有着几乎完全相同的语法。 | print( r'\n' ) print( R'\n' ) |
| % | 格式字符串 | 请看下一节内容。 |
#!/usr/bin/python3 a = "Hello"b = "Python" print("a + b 输出结果:", a + b)print("a * 2 输出结果:", a * 2)print("a[1] 输出结果:", a[1])print("a[1:4] 输出结果:", a[1:4]) if( "H" in a) : print("H 在变量 a 中")else : print("H 不在变量 a 中") if( "M" not in a) : print("M 不在变量 a 中")else : print("M 在变量 a 中") print (r'\n')print (R'\n')字符串格式化
这里的%s、%c、%d等都和 C 语言一样
print ("我叫 %s 今年 %.2lf 岁!" % ('小明', 10.125))输出:print ("我叫 %s 今年 %d 岁!" % ('小明', 10.12))格式化操作符辅助指令:
| 符号 | 功能 |
|---|---|
| * | 定义宽度或者小数点精度 |
| - | 用做左对齐 |
| + | 在正数前面显示加号( + ) |
| 在正数前面显示空格 | |
| # | 在八进制数前面显示零('0'),在十六进制前面显示'0x'或者'0X'(取决于用的是'x'还是'X') |
| 0 | 显示的数字前面填充'0'而不是默认的空格 |
| % | '%%'输出一个单一的'%' |
| (var) | 映射变量(字典参数) |
| m.n. | m 是显示的最小总宽度,n 是小数点后的位数(如果可用的话) |
f-string
在 Python 中,f前缀用于创建格式化字符串,也被称为 f-string。f-string 是 Python 3.6 及更高版本中引入的一种新的字符串格式化方法。
在 f-string 中,你可以在字符串内部的大括号{}中直接插入表达式。这些表达式会在运行时被求值,并将结果插入到字符串中。
例如,假设我们有一个变量name,我们可以使用 f-string 来创建一个包含name值的字符串:
name = "Alice"greeting = f"Hello, {name}!"print(greeting) # 输出:Hello, Alice!在这个例子中,{name}是一个表达式,它在运行时被替换为变量name的值。因此,f"Hello, {name}!"会生成字符串"Hello, Alice!"。
用了这种方式明显更简单了,不用再去判断使用 %s,还是 %d。
当然,还可以使用符号=来凭借运算表达式的结果
x = 1print(f'{x+1}') # Python 3.6 新增print(f'{x+1=}') # Python 3.8 新增---------------------------------------------------------------输出:2x+1=2三引号
三引号允许一个字符串跨多行,字符串中可以包含\t、\n等其他特殊字符。
para_str = """这是一个多行字符串的实例多行字符串可以使用制表符TAB ( \t )。也可以使用换行符 [ \n ]。"""print (para_str)a = Trueb = False # 比较运算符print(2 < 3) # Trueprint(2 == 3) # False # 逻辑运算符print(a and b) # Falseprint(a or b) # Trueprint(not a) # False # 类型转换print(int(a)) # 1print(float(b)) # 0.0print(str(a)) # "True"在 Python 中,所有非零的数字和非空的字符串、列表、元组等数据类型都被视为 True,只有 0、空字符串、空列表、空元组
列表是一种有序的集合,可以随时添加和删除其中的元素。
列表用方括号[]来表示,列表中的元素用逗号分隔。列表的元素可以是不同的数据类型,包括数字、字符串、另一个列表等。
my_list = [1, 'hello', 2, 'world']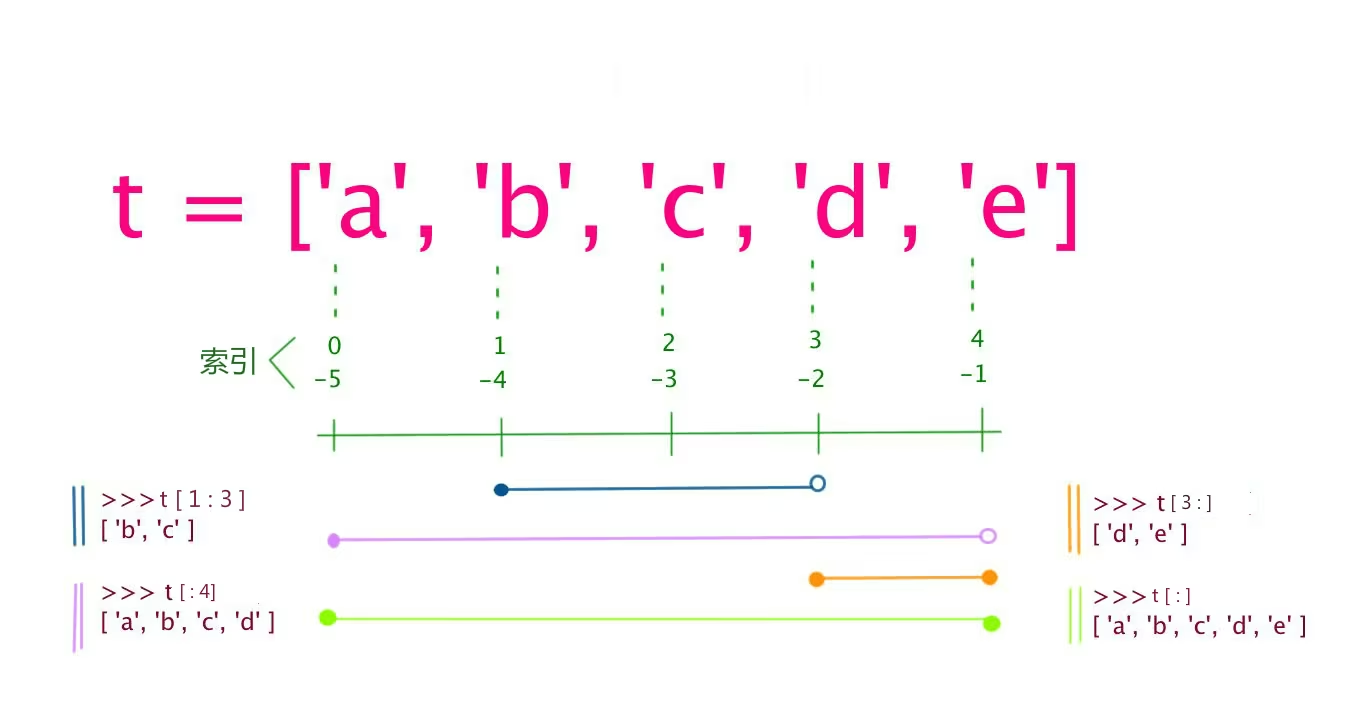
一些操作:
list = ['abcd',786,2.23,'run',70.2] # 定义一个列表tinylist = [123, 'run'] print (list) # 打印整个列表print (list[0]) # 打印列表的第一个元素print (list[1:3]) # 打印列表第二到第三个元素(左闭右开)print (list[2:]) # 打印列表从第三个元素开始到末尾print (tinylist * 2) # 打印tinylist列表两次print (list + tinylist) # 打印两个列表拼接在一起的结果 以上都和String一样的操作 list[1]="sakurakugu"print(list[1])列表截取可以接收第三个参数,参数作用是截取的步长,以下实例在索引 1 到索引 4 的位置并设置为步长为 2(间隔一个位置)来截取字符串:
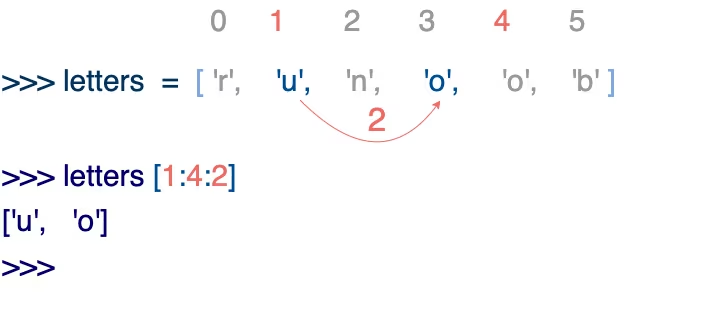
如果第三个参数为负数表示逆向读取,如用于翻转字符串:
list = [ 'abcd', 786 , 2.23, 'sakurakugu', 70.2 ]list.reverse()print(list)--------------------------------------------------------list = [ 'abcd', 786 , 2.23, 'sakurakugu', 70.2 ]list = list[::-1]print(list)列表常见的操作:
Python 包含以下函数:
| 序号 | 函数 |
|---|---|
| 1 | len(list) 列表元素个数 |
| 2 | max(list)返回列表元素最大值 |
| 3 | min(list)返回列表元素最小值 |
| 4 | list(seq)将元组转换为列表 |
以下是一些常见的操作:
| 序号 | 方法 |
|---|---|
| 1 | list.append(obj) 在列表末尾添加新的对象 |
| 2 | list.insert(index, obj) 将对象插入列表 |
| 3 | list.extend(seq) 在列表末尾一次性追加另一个序列中的多个值(用新列表扩展原来的列表) |
| 4 | print(list1[0]) 访问列表的第一个元素 |
| 4 | list.index(obj) 从列表中找出某个值第一个匹配项的索引位置 |
| 5 | list.count(obj) 统计某个元素在列表中出现的次数 |
| 6 | list.pop([index=-1]) 移除列表中的一个元素(默认最后一个元素),并且返回该元素的值 |
| 7 | queue.popleft() 移除列表中的第一个元素,并且返回该元素的值 |
| 8 | list.remove(obj) 移除列表中某个值的第一个匹配项 |
| 9 | list.reverse() 反向列表中元素 |
| 10 | list.sort( key=None, reverse=False) 对原列表进行排序----------------------------------------------------------------------------- random = [(2,2), (3,4), (4,1), (1,3)] 如对于这个列表若key==2,者以第二个元素优先排序若 reverse=True |
| 11 | list.clear() 清空列表 |
| 11 | list.copy() 复制列表 |
因此列表可以当作栈,队列使用
排序 sort:
list.sort( key=None, reverse=False)# key为排序依据,reverse=True为按照降序排序list1 = ['apple', 'banana', 'cherry', 'date']list1.sort(key=len) # 按照字符串的长度排序print(list1) # 输出:['date', 'apple', 'cherry', 'banana']=========================================================# 获取列表的第二个元素def takeSecond(elem): return elem[1] list2 = [(2, 2), (3, 4), (4, 1), (1, 3)]# 指定第二个元素排序list2.sort(key=takeSecond)# 输出类别print ('排序列表:', list2)通过 del 语句按照索引来删除
>>> a = [-1, 1, 66.25, 333, 333, 1234.5]>>> del a[0]>>> a[1, 66.25, 333, 333, 1234.5]>>> del a[2:4]>>> a[1, 66.25, 1234.5]>>> del a[:]>>> a[]>>> del a # 删除实体变量a元组是一种不可变的序列类型,一旦创建就不能修改。元组用圆括号()来表示,元素之间用逗号分隔。
例如,这是一个元组:
my_tuple = ('apple', 'banana', 'cherry')在这个例子中,'apple'、'banana'和'cherry'是元组的元素。
可以通过索引来访问元组中的元素。例如,my_tuple[0]将返回'apple'。
但是,由于元组是不可变的,所以你不能改变元组中的元素。例如,尝试执行my_tuple[0] = 'pear'将会引发一个错误。
元组通常用于存储不应该改变的数据集,例如星期的名称或者一个日期的年、月、日。
可以通过上述的一些操作来操作元组
虽然元组本身是不可变的,但是如果元组中的元素是可变的,比如列表,那么这个元素的内容是可以被修改的。
例如,你可以创建一个包含列表的元组:
my_tuple = (['apple', 'banana'], 'cherry')
然后你可以修改列表的内容:
my_tuple[0][1] = 'pear'
现在,元组变成了:
(['apple', 'pear'], 'cherry')
虽然元组的元素(即列表)的内容发生了变化,但元组的结构(即元素的个数和位置)并没有改变。所以,我们通常说元组是不可变的。
构造包含 0 个或 1 个元素的元组比较特殊,所以有一些额外的语法规则:
tup1 = () # 空元组tup2 = (20,) # 一个元素,需要在元素后添加逗号如果你想创建只有一个元素的元组,需要注意在元素后面添加一个逗号,以区分它是一个元组而不是一个普通的值,这是因为在没有逗号的情况下,Python 会将括号解释为数学运算中的括号,而不是元组的表示。
如果不添加逗号,如下所示,它将被解释为一个普通的值而不是元组:
not_a_tuple = (42)这样的话,not_a_tuple 将是整数类型而不是元组类型。
string、list 和 tuple 都属于 sequence(序列)。
元组的操作:
因为元组是不可变的,因此操作比较少,常见操作与上面列表类似
在 Python 中,集合(set)是一个无序的、不重复的元素集。它的主要用途包括成员检测和消除重复元素。
集合对象还支持像并集、交集、差集和对称差等数学运算。
集合是由一个或数个形态各异的大小整体组成的,构成集合的事物或对象称作元素或是成员。
基本功能是进行成员关系测试和删除重复元素。
可以使用大括号 {} 或者 set() 函数创建集合,注意:创建一个空集合必须用 set() 而不是 {},因为 {} 是用来创建一个空字典。
创建格式:
parame = {value01,value02,...}或者set(value)例如:
basket = {'apple', 'orange', 'apple', 'pear', 'orange', 'banana'}print(basket) # 这里演示的是去重功能输出结果:{'orange', 'banana', 'pear', 'apple'}
注意:集合是无序的,你无法为集合中的元素定义一个固定的位置(即索引)。
常见的一些操作:
add() 方法添加一个元素,或者使用 update() 方法添加多个元素。set1 = {1, 2, 3}set2 = set([4, 5, 6, 7])set1.add(4) # set1 现在是 {1, 2, 3, 4}set1.update([5, 6]) # set1 现在是 {1, 2, 3, 4, 5, 6}remove() 方法删除一个元素,或者使用 discard() 方法删除一个元素但不会引发错误,如果元素不存在。set1 = {1, 2, 3, 4}set1.remove(1) # set1 现在是 {2, 3, 4}set1.discard(2) # set1 现在是 {3, 4}in 关键字来检查一个元素是否存在于集合中。set1 = {1, 2, 3, 4}print(1 in set1) # 输出:Trueunion() 或 |)、交集(intersection() 或 &)、差集(difference() 或 -)和对称差集(symmetric_difference() 或 ^)运算。set1 = {1, 2, 3, 4}set2 = {3, 4, 5, 6}print(set1.union(set2)) # 输出:{1, 2, 3, 4, 5, 6}print(set1.intersection(set2)) # 输出:{3, 4}print(set1.difference(set2)) # 输出:{1, 2}print(set1.symmetric_difference(set2)) # 输出:{1, 2, 5, 6}# set可以进行集合运算a = set('abracadabra')b = set('alacazam') print(a) print(a - b) # a 和 b 的差集print(a | b) # a 和 b 的并集print(a & b) # a 和 b 的交集print(a ^ b) # a 和 b 中不同时存在的元素 输出:{'b', 'c', 'a', 'r', 'd'}{'r', 'b', 'd'}{'b', 'c', 'a', 'z', 'm', 'r', 'l', 'd'}{'c', 'a'}{'z', 'b', 'm', 'r', 'l', 'd'}print(sites)字典(dictionary)是 Python 中另一个非常有用的内置数据类型。
列表是有序的对象集合,字典是无序的对象集合。两者之间的区别在于:字典当中的元素是通过键来存取的,而不是通过偏移存取。
字典是一种映射类型,字典用 { } 标识,它是一个无序的 键(key) : 值(value) 的集合。
键(key)必须使用不可变类型。
在同一个字典中,键(key)必须是唯一的。
实例
dict1 = {}dict1['one'] = "1 - 我的笔记"dict1[2] = "2 - Python好自由" tinydict = {'name': 'sakurakugu','code':1, 'site': 'www.sakurakugu.top'} print(dict1['one']) # 输出键为 'one' 的值print(dict1[2]) # 输出键为 2 的值print(tinydict) # 输出完整的字典print(tinydict.keys()) # 输出所有键print(tinydict.values()) # 输出所有值以上实例输出结果:
1 - 我的笔记2 - Python好自由{'name': 'sakurakugu', 'code': 1, 'site': 'www.sakurakugu.com'}dict_keys(['name', 'code', 'site'])dict_values(['sakurakugu', 1, 'www.sakurakugu.com'])构造函数 dict() 可以直接从键值对序列中构建字典如下:
实例:
>>> dict([('sakurakugu', 1), ('Google', 2), ('Taobao', 3)]){'sakurakugu': 1, 'Google': 2, 'Taobao': 3}>>> {x: x**2 **for** x **in** (2, 4, 6)}{2: 4, 4: 16, 6: 36}>>> dict(sakurakugu=1, Google=2, Taobao=3){'sakurakugu': 1, 'Google': 2, 'Taobao': 3}字典 dict()的常见操作:
dict1 = dict()dict1 = {'key1': 'value1'}dict1['key2'] = 'value2' # dict1 现在是 {'key1': 'value1', 'key2': 'value2'}dict1 = {'key1': 'value1', 'key2': 'value2'}print(dict1['key1']) # 输出:'value1'dict1 = {'key1': 'value1', 'key2': 'value2'}dict1['key1'] = 'new value' # dict1 现在是 {'key1': 'new value', 'key2': 'value2'}del 语句或 pop() 方法删除字典中的键值对。dict1 = {'key1': 'value1', 'key2': 'value2'}del dict1['key1'] # dict1 现在是 {'key2': 'value2'}value = dict1.pop('key2') # dict1 现在是 {},value 是 'value2'in 关键字来检查一个键是否存在于字典中。dict1 = {'key1': 'value1', 'key2': 'value2'}print('key1' in dict1) # 输出:Truekeys() 方法获取所有的键,使用 values() 方法获取所有的值,使用 items() 方法获取所有的键值对。dict1 = {'key1': 'value1', 'key2': 'value2'}print(dict1.keys()) # 输出:dict_keys(['key1', 'key2'])print(dict1.values()) # 输出:dict_values(['value1', 'value2'])print(dict1.items()) # 输出:dict_items([('key1', 'value1'), ('key2', 'value2')])bytes 类型用于表示二进制数据。这种类型的对象是不可变的,一旦创建就不能修改。
bytes 类型常用于处理网络数据、二进制文件(如图片、音频等)等场景,因为这些数据通常以二进制形式存在。
可以使用 bytes() 函数来创建一个 bytes 对象。例如:
b = bytes([1, 2, 3])x = bytes("hello", encoding="utf-8")b = bytes([200, 201, 202])在这个例子中,b 是一个包含三个字节的 bytes 对象。
你也可以使用 b 前缀来创建一个 bytes 对象。例如:
b = b'hello'y = x[1:3] # 切片操作,得到 b"el"z = x + b"world" # 拼接操作,得到 b"helloworld"在这个例子中,b 是一个包含 'hello' 对应的 ASCII 编码的 bytes 对象。
你可以像处理字符串那样处理 bytes 对象,例如切片、迭代等。但是,由于 bytes 对象是不可变的,所以你不能修改 bytes 对象中的元素。
因为 bytes 类型中的元素是整数值,因此在进行比较操作时需要使用相应的整数值
Pythonx = b"hello"**if** x[0] == ord("h"):**print**("The first element is 'h'")其中
ord()函数用于将字符转换为相应的整数值。
分为自动转换与手动转换
| 函数 | 描述 |
|---|---|
| int(x [,base]) | 将 x 转换为一个整数 |
| float(x) | 将 x 转换到一个浮点数 |
| complex(real [,imag]) | 创建一个复数 |
| str(x) | 将对象 x 转换为字符串 |
| repr(x) | 将对象 x 转换为表达式字符串 |
| eval(str) | 用来计算在字符串中的有效 Python 表达式,并返回一个对象 |
| tuple(s) | 将序列 s 转换为一个元组 |
| list(s) | 将序列 s 转换为一个列表 |
| set(s) | 转换为可变集合 |
| dict(d) | 创建一个字典。d 必须是一个 (key, value)元组序列。 |
| frozenset(s) | 转换为不可变集合 |
| chr(x) | 将一个整数转换为一个字符 |
| ord(x) | 将一个字符转换为它的整数值 |
| hex(x) | 将一个整数转换为一个十六进制字符串 |
| oct(x) | 将一个整数转换为一个八进制字符串 |
4 + 5 = 94 和 5 被称为操作数,+ 称为运算符。
分为以下运算符:
算术运算符
比较(关系)运算符
赋值运算符
逻辑运算符
位运算符
成员运算符
身份运算符
运算符优先级
算术运算符
+ - * /(除) //(整除) % **
比较运算符
== != > < >= <=
赋值运算符
= += -= *= /= %= **= //= :=
:= 为"海象运算符" 或 "赋值表达式运算符"
这个运算符允许你在表达式中进行赋值。这意味着你可以在 if 语句、 while 语句或者其他需要表达式的地方进行赋值。
例如,你可以在 if 语句中使用 := 运算符:
if (n := len([1, 2, 3])) > 2: print(f"List has {n} elements.")# 不这样做,在print中 n 就是没定义的# 这样可以避免调用 len() 两次在这个例子中,n := len([1, 2, 3]) 是一个赋值表达式,它计算列表的长度并将结果赋值给 n。然后,if 语句检查 n 是否大于 2。如果 n 大于 2,那么 print 语句将被执行。
这种做法可以使代码更简洁,因为你不需要在 if 语句之前单独进行赋值。
# 传统写法n = 10if n > 5: print(n) # 使用海象运算符if (n := 10) > 5: print(n)位运算符
& | ^ ~ << >>
a = 60 # 60 = 0011 1100b = 13 # 13 = 0000 1101c = 0#==================================c = a & b # 12 = 0000 1100print ("a & b 的值为:", c)#----------------------------------c = a | b # 61 = 0011 1101print ("a | b 的值为:", c)#----------------------------------c = a ^ b # 49 = 0011 0001print ("a ^ b 的值为:", c)#----------------------------------c = ~a # -61 = 1100 0011print ("~a 的值为:", c)#----------------------------------c = a << 2 # 240 = 1111 0000print ("a << 2 的值为:", c)#----------------------------------c = a >> 2 # 15 = 0000 1111print ("a >> 2 的值为:", c)逻辑运算符
and or not <==> && || !
成员运算符
in not in
| 运算符 | 描述 | 实例 |
|---|---|---|
| in | 如果在指定的序列中找到值返回 True,否则返回 False。 | x 在 y 序列中 , 如果 x 在 y 序列中返回 True。 |
| not in | 如果在指定的序列中没有找到值返回 True,否则返回 False。 | x 不在 y 序列中 , 如果 x 不在 y 序列中返回 True。 |
a = 10b = 20list = [1, 2, 3, 4, 5 ]#==================================if ( a in list ): print ("1 - 变量 a 在给定的列表中 list 中")else: print ("1 - 变量 a 不在给定的列表中 list 中")#----------------------------------if ( b not in list ): print ("2 - 变量 b 不在给定的列表中 list 中")else: print ("2 - 变量 b 在给定的列表中 list 中")#----------------------------------# 修改变量 a 的值a = 2if ( a in list ): print ("3 - 变量 a 在给定的列表中 list 中")else: print ("3 - 变量 a 不在给定的列表中 list 中")身份运算符
身份运算符用于比较两个对象的存储单元
| 运算符 | 描述 | 实例 |
|---|---|---|
| is | is 是判断两个标识符是不是引用自一个对象 | x is y, 类似 id(x) == id(y) , 如果引用的是同一个对象则返回 True,否则返回 False |
| is not | is not 是判断两个标识符是不是引用自不同对象 | x is not y , 类似 id(x) != id(y)。如果引用的不是同一个对象则返回结果 True,否则返回 False。 |
# 注: id() 函数用于获取对象内存地址 a = 20b = 20#==================================if ( a is b ): print ("1 - a 和 b 有相同的标识")else: print ("1 - a 和 b 没有相同的标识") if ( id(a) == id(b) ): print ("2 - a 和 b 有相同的标识")else: print ("2 - a 和 b 没有相同的标识")#----------------------------------# 修改变量 b 的值b = 30if ( a is b ): print ("3 - a 和 b 有相同的标识")else: print ("3 - a 和 b 没有相同的标识") if ( a is not b ): print ("4 - a 和 b 没有相同的标识")else: print ("4 - a 和 b 有相同的标识")is 与 == 区别:
is 用于判断两个变量引用对象是否为同一个, == 用于判断引用变量的值是否相等。(在 Python 中,如果两个变量指向的是不可变类型(如整数、字符串、元组),并且这两个变量的值相同,那么它们通常会指向内存中的同一个对象,也就是说它们是同一个引用。)
Python>>>a = [1, 2, 3]>>> b = a>>> b is aTrue>>> b == aTrue>>> b = a[:]>>> b is aFalse>>> b == aTrue但是,对于可变类型(如列表、字典、集合),即使两个变量的值相同,它们也可能指向内存中的不同对象。
Pythonlist1 = [1, 2, 3]list2 = [1, 2, 3]print(list1 is list2) # 输出:False
运算符优先级
| 运算符 | 描述 |
| :--------------------------------------------------------------------------- | :--------------------------------- | --------- |
| (expressions...),[expressions...], {key: value...}, {expressions...} | 圆括号的表达式 |
| x[index], x[index:index], x(arguments...), x.attribute | 读取,切片,调用,属性引用 |
| await x | await 表达式 |
| ** | 乘方(指数) |
| +x, -x, ~x | 正,负,按位非 NOT |
| *, @, /, //, % | 乘,矩阵乘,除,整除,取余 |
| +, - | 加和减 |
| <<, >> | 移位 |
| & | 按位与 AND |
| ^ | 按位异或 XOR |
| | | 按位或 OR |
| in,not in, is,is not, <, <=, >, >=, !=, == | 比较运算,包括成员检测和标识号检测 |
| not x | 逻辑非 NOT |
| and | 逻辑与 AND |
| or | 逻辑或 OR |
| if -- else | 条件表达式 |
| lambda | lambda 表达式 |
| := | 赋值表达式 |
if condition_1: statement_block_1elif condition_2: statement_block_2else: statement_block_3没有else if ... : 如果非要这么写,要写成
a=1if a: print(a)else: if a==3: print(a)def http_error(status): match status: case 400: return "Bad request" case 401|403|404: #设置多个匹配条件 return "Not found" case 418: return "I'm a teapot" case _: return "Something's wrong with the internet" mystatus=400print(http_error(400))---------------------------------------------------------输出结果为:Bad requestn = 100 sum = 0counter = 1while counter <= n: sum = sum + counter counter += 1 print("1 到 %d 之和为: %d" % (n,sum))要注意冒号和缩进。另外,在 Python 中没有 do..while 循环
count = 0while count < 5: print (count, " 小于 5") count = count + 1else: print (count, " 大于或等于 5")---------------------------------------------------------输出:0 小于 51 小于 52 小于 53 小于 54 小于 55 大于或等于 5简单语句组
类似 if 语句的语法,如果你的 while 循环体中只有一条语句,你可以将该语句与 while 写在同一行中
flag = 1while (flag): print ('欢迎sakurakugu!')print ("Good bye!")Python for 循环可以遍历任何可迭代对象,如一个列表或者一个字符串
for <变量> in <对象>: <语句>else: <语句>配合 range() 函数使用:
# 1 到 5 的所有数字:for number in range(1, 6): print(number)同上while...else...
对于 break,若使用了 break,则 for...else...的 else 语句块也不会执行
numbers = [1, 2, 3, 4, 5] for num in numbers: if num == 3: print("Found 3!") breakelse: print("3 was not found in the list")在 Python 中,range()函数用于创建一个整数序列,常用于循环结构中。range()函数可以接受一个、两个或三个参数:
如果只提供一个参数,range(stop),则从 0 开始生成一系列整数,直到 stop-1。
如果提供两个参数,range(start, stop),则从 start 开始生成一系列整数,直到 stop-1。
如果提供三个参数,range(start, stop, step),则从 start 开始以 step 为增量生成一系列整数,直到 stop-1。
range()函数生成的整数序列可以在循环结构中进行迭代,用于控制循环的次数。例如:
# 遍历从0到4的整数序列for i in range(5): print(i) # 遍历从1到5的整数序列for i in range(1, 6): print(i) # 遍历从1到10的整数序列,步长为2for i in range(1, 11, 2): print(i) =========================================================# 遍历一个序列的索引>>>a = ['Google', 'Baidu', 'Runoob', 'Taobao', 'QQ']>>> for i in range(len(a)):... print(i, a[i])...0 Google1 Baidu2 Runoob3 Taobao4 QQ ---------------------------------------------------------# 使用 range() 函数来创建一个列表 range()函数在 Python 中常用于控制循环的次数,以及生成一系列整数用于迭代。
因为 Python 中没有 C 一样通过{}表示空的块,因此有 pass 作为空语句来报错程序结构的完整性
for letter in 'Sakura!': if letter == 'a': pass else: print ('当前字母 :', letter)---------------------------------------------------------输出:当前字母 : S当前字母 : k当前字母 : u当前字母 : r当前字母 : !就是在生成某数据类型的函数中,使用 for 循环来实现快速生成数据
Python 的推导式是一种简洁、高效的创建数据结构的方法。它们可以用于生成列表(列表推导式)、字典(字典推导式)、集合(集合推导式)和生成器(生成器推导式)。
以下是一些例子:
列表推导式:
# 创建一个包含0到9的平方的列表squares = [x**2 for x in range(10)]# [0, 1, 4, 9, 16, 25, 36, 49, 64, 81]字典推导式:
# 创建一个字典,其中键是0到9,值是其平方squares_dict = {x: x**2 for x in range(10)}集合推导式:
# 创建一个集合,其中包含0到9的平方squares_set = {x**2 for x in range(10)}生成器推导式:
# 创建一个生成器,可以生成0到9的平方squares_gen = (x**2 for x in range(10))推导式还可以包含条件语句,例如:
# 创建一个列表,其中包含0到9的偶数平方even_squares = [x**2 for x in range(10) if x % 2 == 0]这些都是 Python 推导式的基本用法,它们可以帮助你更简洁、更高效地处理数据。
Python 的迭代器、指针和引用都是用于访问或操作数据的工具,但它们的工作方式和用途有所不同。
在 Python 中,迭代器是一个实现了迭代器协议的对象,即定义了__iter__()和__next__()方法的对象。迭代器用于遍历容器(如列表、字典、集合等)中的元素。每次调用__next__()方法时,迭代器都会返回容器中的下一个元素,直到所有元素都被遍历完毕。
迭代器有两个基本的方法:iter() 和 next()。
my_list = [1, 2, 3]my_iter = iter(my_list) print(next(my_iter)) # 输出:1print(next(my_iter)) # 输出:2print(next(my_iter)) # 输出:3指针:
指针是 C、C++等语言中的一个概念,它存储了另一个变量的内存地址。通过指针,我们可以直接访问和修改这个地址中存储的值。但是,Python 中并没有指针的概念,因为 Python 的内存管理是自动的,用户无需(也无法)直接操作内存地址。
引用:
在 Python 中,所有的变量都是对对象的引用。当我们创建一个变量并赋值时,Python 会创建一个对象,并让变量引用这个对象。如果多个变量引用同一个对象,对任何一个变量的操作都会影响到这个对象。
a = [1, 2, 3]b = a # b现在引用的是和a同一个列表 b.append(4) # 修改bprint(a) # 输出:[1, 2, 3, 4],a也被修改了总的来说,Python 的迭代器、指针和引用都是用于访问或操作数据的工具,但它们的工作方式和用途有所不同。迭代器用于遍历容器中的元素,指针用于直接访问和修改内存地址中的值,而引用则是 Python 中变量和对象之间的连接。
在 Python 中,生成器是一种特殊的迭代器,它的特点是可以按需生成值,而不是一次性生成所有值。这使得生成器在处理大数据集时非常高效,因为它们不需要一次性将所有数据加载到内存中。
生成器可以通过两种方式创建:
yield关键字的函数。当调用这个函数时,它不会立即执行,而是返回一个生成器对象。每次请求一个值时,函数就会运行,直到遇到yield语句,然后暂停并返回一个值。下次请求值时,函数会从上次暂停的地方继续运行。def count_up_to(n): count = 1 while count <= n: yield count count += 1 for number in count_up_to(5): print(number) # 输出:1, 2, 3, 4, 5()中定义的。squares = (x**2 for x in range(10)) for square in squares: print(square) # 输出:0, 1, 4, 9, ..., 81生成器是 Python 中处理大数据和实现惰性求值的重要工具。
使用 yield 实现斐波那契数列:
import sys def fibonacci(n): # 生成器函数 - 斐波那契 a, b, counter = 0, 1, 0 while True: if (counter > n): return yield a # 这里就通过生成器的特性来防止无限循环 a, b = b, a + b counter += 1f = fibonacci(10) # f 是一个迭代器,由生成器返回生成 while True: try: print (next(f), end=" ") except StopIteration: sys.exit()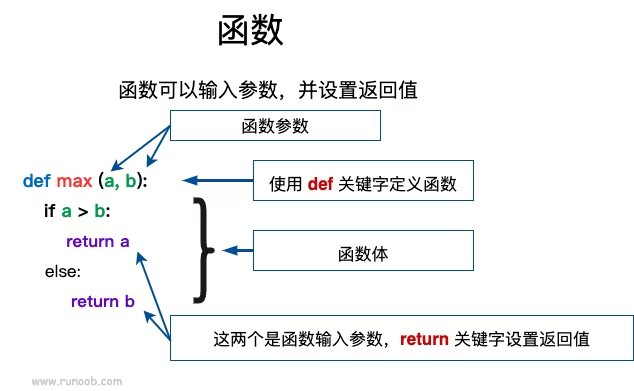
def hello() : print("Hello World!") hello()# 定义函数def printme( str ): # 打印任何传入的字符串 print (str) return # 调用函数printme("我要调用用户自定义函数!")printme("再次调用同一函数")在上述例子中,我们可以发现,传入的参数是没有说明类型的,因为在 Python 中,类型属于对象,对象有不同类型的区分,变量是没有类型的:
a=[1,2,3]print(a)a=1print(a)a="str"print(a)如上,变量 a 是没有类型,它仅仅是一个对象的引用(一个指针),可以是指向 List 类型对象,也可以是指向 String 类型对象
在 python 中,strings, tuples, 和 numbers 是不可更改的对象,而 list,dict 等则是可以修改的对象。
**不可变类型:**变量赋值 a=5 后再赋值 a=10,这里实际是新生成一个 int 值对象 10,再让 a 指向它,而 5 被丢弃,不是改变 a 的值,相当于新生成了 a。
**可变类型:**变量赋值 la=[1,2,3,4] 后再赋值 la[2]=5 则是将 list la 的第三个元素值更改,本身 la 没有动,只是其内部的一部分值被修改了。
python 函数的参数传递:
**不可变类型:**类似 C++ 的值传递,如整数、字符串、元组。如 fun(a),传递的只是 a 的值,没有影响 a 对象本身。如果在 fun(a) 内部修改 a 的值,则是新生成一个 a 的对象。
**可变类型:**类似 C++ 的引用传递,如 列表,字典。如 fun(la),则是将 la 真正的传过去,修改后 fun 外部的 la 也会受影响
python 中一切都是对象,严格意义我们不能说值传递还是引用传递,我们应该说传不可变对象和传可变对象。
实例:
# 对于不可变对象def change(a): print(id(a)) # 指向的是同一个对象 a=10 print(id(a)) # 一个新对象 a=1print(id(a))change(a)a=1print(id(a))---------------------------------------------------------输出:140707422718392140707422718392140707422718680140707422718392# 对于可变对象def changeme( mylist ): "修改传入的列表" mylist.append([1,2,3,4]) print ("函数内取值: ", mylist) return # 调用changeme函数mylist = [10,20,30]changeme( mylist )print ("函数外取值: ", mylist)---------------------------------------------------------输出:函数内取值: [10, 20, 30, [1, 2, 3, 4]]函数外取值: [10, 20, 30, [1, 2, 3, 4]]#可写函数说明def printinfo( name, age=18 ): "打印任何传入的字符串" print ("名字: ", name) print ("年龄: ", age) return #调用printinfo函数printinfo("sakura", 15 ) # "sakura"为必须参数print ("------------------------")printinfo( age=15, name="sakura" ) # 这两为关键字参数,printinfo( name="sakura", age=15 ) # 它们可以调换顺序。print ("------------------------")printinfo( name="sakura" ) # age不传入就使用默认参数age=18不定长参数
加了一个星号 * 的参数会以元组(tuple)的形式导入,存放所有未命名的变量参数
def printinfo( arg1, *vartuple ): "打印任何传入的参数" print (arg1) print (vartuple) for var in vartuple: print (var,end=" ") if len(vartuple):print() # 让“------”不与“60 50”在同一行 print ("------") return # 调用printinfo 函数printinfo( 10 )printinfo( 70, 60, 50 )---------------------------------------------------------输出:10()------70(60, 50)60 50------加了两个星号 ** 的参数会以字典的形式导入
# 可写函数说明def printinfo( arg1, **vardict ): "打印任何传入的参数" print (arg1) print (vardict) # 调用printinfo 函数printinfo(1, a=2,b=3)---------------------------------------------------------输出:1{'a': 2, 'b': 3}如果单独出现星号 *,则星号 * 后的参数必须用关键字传入:
>>> def f(a,b,*,c):... return a+b+c...>>> f(1,2,3) # 报错Traceback (most recent call last): File "<stdin>", line 1, in <module>TypeError: f() takes 2 positional arguments but 3 were given>>> f(1,2,c=3) # 正常6>>>Lambda 函数是 Python 中的一种匿名函数,也就是没有具体名称的函数。它允许你快速定义单行的微型函数,这些函数通常在你希望在程序中快速执行某些小任务时使用。
Lambda 函数的基本语法是:
lambda arguments: expression这里,arguments是一个参数列表,expression是一个关于这些参数的表达式。Lambda 函数可以接受任何数量的参数,但表达式只能是一个。
实例:
sum = lambda a, b: a + bprint(sum(5, 3)) # 输出:8numbers = [1, 2, 3, 4, 5]squared = list(map(lambda x: x**2, numbers))print(squared) # 输出: [1, 4, 9, 16, 25]用于退出函数,若return 不带参数或没有 return 语句,则返回None(这个“None”是关键字,不是字符串)
Python3.8 新增了一个函数形参语法 / 用来指明函数形参必须使用指定位置参数,不能使用关键字参数的形式。
在以下的例子中,形参 a 和 b 必须使用指定位置参数,c 或 d 可以是位置形参或关键字形参,而 e 和 f 要求为关键字形参:
def f(a, b, /, c, d, *, e, f): print(a, b, c, d, e, f)以下使用方法是正确的:
f(10, 20, 30, d=40, e=50, f=60)以下使用方法会发生错误:
f(10, b=20, c=30, d=40, e=50, f=60) # b 不能使用关键字参数的形式f(10, 20, 30, 40, 50, f=60) # e 必须使用关键字参数的形式Python 的装饰器是一个非常强大的工具,允许我们在不修改函数或方法源代码的情况下,为其添加新的功能。装饰器本质上是一个接收函数作为输入并返回一个新的包装过后的函数的对象。
以下是一个简单的装饰器示例:
def my_decorator(func): def wrapper(): print("S这里是在调用原始函数前添加的新功能") func() print("这里是在调用原始函数后添加的新功能") return wrapper # 使用装饰器@my_decoratordef say_hello(): print("Hello!") say_hello()在这个例子中,my_decorator是一个装饰器函数,它将say_hello函数作为参数并返回一个新的函数wrapper。当我们调用say_hello()时,实际上是在调用wrapper()。这样,我们就可以在say_hello()函数执行前后添加额外的代码,而不需要修改say_hello()函数本身。
装饰器的应用场景:
日志记录: 装饰器可用于记录函数的调用信息、参数和返回值。
性能分析: 可以使用装饰器来测量函数的执行时间。
权限控制: 装饰器可用于限制对某些函数的访问权限。
缓存: 装饰器可用于实现函数结果的缓存,以提高性能。
装饰器通过 @ 符号应用在函数定义之前,例如:
@time_loggerdef target_function(): pass等同于:
def target_function(): passtarget_function = time_logger(target_function)装饰器函数也可以接受参数,例如:
def repeat(n): # 传入 3 def decorator(func): # 传入greet()函数 def wrapper(*args, **kwargs): # 传入greet()中的name for _ in range(n): # *arge为传入元组,**kwargs为传入字典 # 这里只传入了{‘Alice',}一个变量 result = func(*args, **kwargs) return result return wrapper return decorator @repeat(3)def greet(name): print(f"Hello, {name}!") # f为f-string greet("Alice")以上代码中 repeat 函数是一个带参数的装饰器,它接受一个整数参数 n,然后返回一个装饰器函数。该装饰器函数内部定义了 wrapper 函数,在调用原始函数之前重复执行 n 次。因此,greet 函数在被 @repeat(3) 装饰后,会打印三次问候语。
关于上例的*args 与**kargs
Pythondef func(*args, **kwargs): print(args) # 打印位置参数 print(kwargs) # 打印关键字参数 func(1, 2, 3, a=4, b=5, c=6)在这个例子中,位置参数 1, 2, 3 会被收集到 args 元组中,关键字参数 a=4, b=5, c=6 会被收集到 kwargs 字典中。
除了函数装饰器,Python 还支持类装饰器。类装饰器是包含 **call** 方法的类,它接受一个函数作为参数,并返回一个新的函数。
class DecoratorClass: def __init__(self, func): self.func = func def __call__(self, *args, **kwargs): # 在调用原始函数之前/之后执行的代码 result = self.func(*args, **kwargs) # 在调用原始函数之后执行的代码 return result @DecoratorClassdef my_function(): pass嵌套使用装饰器
def decorator1(func): def wrapper1(): print("装饰器1开始装饰") func() print("装饰器1结束装饰") return wrapper1 def decorator2(func): def wrapper2(): print("装饰器2开始装饰") func() print("装饰器2结束装饰") return wrapper2 @decorator1@decorator2def say_hello(): print("Hello!") say_hello()--------------------------------------------------------------输出:装饰器1开始装饰装饰器2开始装饰Hello!装饰器2结束装饰装饰器1结束装饰如上,say_hello函数首先被decorator2装饰,然后被decorator1装饰。
因此,执行顺序是从上到下的
Python 的模块是一个包含 Python 定义和语句的文件。模块可以定义函数、类和变量,也可以包含可执行的代码。模块的名称就是文件的名称(不包括.py后缀)。
模块是 Python 程序结构化的一个重要工具,因为它们可以将相关的代码组织在一起,提高代码的可读性和可重用性。你可以使用import语句来在你的程序中使用模块。
例如,假设我们有一个名为mymodule.py的模块,它定义了一个函数say_hello:
# 文件名:mymodule.py def say_hello(name): print(f"Hello, {name}!")我们可以在另一个 Python 文件中导入并使用这个模块:
# 文件名:main.py import mymodule mymodule.say_hello("Alice")在这个例子中,main.py导入了mymodule模块,并使用了它的say_hello函数。
相比于.java 类文件,Python 的模块还可以包含可执行的代码。当模块被导入时,这些代码会被执行。这是 Python 模块的一个独特特性,它允许模块在被导入时执行一些初始化代码。
一个模块只会被导入一次,不管你执行了多少次 import。这样可以防止导入模块被一遍又一遍地执行。
搜索路径的优先级的话,是先当前路径,然后按照
Pythonimport syssys.path这串代码中展示的内容中来搜索
想使用 Python 源文件,只需在另一个源文件里执行 import 语句,语法如下:
import module1[, module2[,... moduleN]当解释器遇到 import 语句,如果模块在当前的搜索路径就会被导入。
==使用
import时,可以使用相对路径吗?==在 Python 中,你可以使用相对路径来导入模块,但这只适用于包内的模块。
在 Python 中,包是一个包含__init__.py文件的目录,它可以包含其他的模块和子包。假设你有以下的目录结构:
Pythonmypackage/__init__.pymodule1.pysubpackage/__init__.pymodule2.py在
module2.py中,你可以使用相对导入来导入module1:Pythonfrom .. import module1在这个例子中,
..表示父目录,所以from .. import module1导入了同一包下的module1模块。然而,相对导入只能在包内部使用。如果你试图在包外部的脚本或交互式解释器中使用相对导入,Python 会抛出
ImportError。如果你想在脚本中导入同一目录下的模块,你只需要直接导入模块名,不需要任何路径。例如,如果
module1.py和你的脚本在同一目录下,你可以这样导入它:Pythonimport module1在包中海可以使用 java 一样的导入方式:
Pythonimport sound.effects.echo# 或from sound.effects import echo
==使用
import时,可以使用绝对路径吗?==
在 Python 中,你不能直接使用文件的绝对路径来导入模块。import语句只接受模块名,而不是文件路径。模块名应该是一个有效的 Python 标识符,它不能包含路径分隔符(如/或\)。然而,你可以通过修改
sys.path来让 Python 在特定的目录中查找模块。sys.path是一个字符串列表,它指定了 Python 解释器查找模块的路径。你可以添加你的目录到sys.path,然后使用模块名来导入模块。例如,假设你有一个模块
mymodule.py在目录/path/to/my/modules下,你可以这样导入它:Pythonimport syssys.path.append('/path/to/my/modules')import mymodule在这个例子中,
'/path/to/my/modules'是你想要添加的目录。你需要替换它为你的实际目录。注意,这种方法只适用于脚本和程序,不适用于交互式解释器。在交互式解释器中,你需要在每次启动解释器时都添加路径。
如果要经常使用一个函数,可以对他进行赋值一个本地的名称:
# 斐波那契数列>>> fib = fibo.fib>>> fib(500)1 1 2 3 5 8 13 21 34 55 89 144 233 377 Python 的 from 语句让你从模块中导入一个指定的部分到当前命名空间中,语法如下:
from modname import name1[, name2[, ... nameN]]例如,要导入模块 fibo 的 fib 函数,使用如下语句:
>>> from fibo import fib, fib2>>> fib(500)1 1 2 3 5 8 13 21 34 55 89 144 233 377这个声明不会把整个 fibo 模块导入到当前的命名空间中,它只会将 fibo 里的 fib 函数引入进来。
把一个模块的所有内容全都导入到当前的命名空间也是可行的,只需使用如下声明:
from modname import *==from somemodule import * 和 import somemodule 的区别是什么==
from somemodule import *:(导入模块中的内容)
这种语法会导入指定模块(
somemodule)中的所有公开成员(函数、类、变量等),包括以单下划线_开头的成员。但是,不会导入以双下划线__开头的成员。使用
from somemodule import *可能会导致命名空间污染(namespace pollution),因为它将所有公开成员引入当前命名空间,可能覆盖已有的同名变量或函数。import somemodule:(导入模块名的指针)
这种语法仅仅是导入指定模块(
somemodule)的命名空间,并不直接将其中的成员引入当前命名空间。在使用模块中的成员时,需要通过somemodule.member的方式进行访问。相比于
from somemodule import *,使用import somemodule可以更好地控制命名空间,避免命名冲突和提高代码的可读性。综上所述,一般来说,推荐使用
import somemodule的方式来导入模块,因为这种方式更加明确,避免了可能的命名空间污染问题。如果只需要导入模块中的少量特定成员,也可以使用from somemodule import member1, member2的方式来选择性地导入所需成员,而不是使用通配符*。
__name__
在 Python 中,__name__是一个内置变量,它表示当前模块的名字。
如果你直接运行一个 Python 文件,那么__name__的值会是'__main__'。这是因为这个文件被当作主程序来运行,所以它的名字是'__main__'。
如果你导入一个模块,那么__name__的值会是这个模块的名字。例如,如果你导入一个名为mymodule的模块,那么在这个模块中,__name__的值会是'mymodule'。
__name__常常被用在下面这样的代码中:
if __name__ == '__main__': # 这里的代码只有在直接运行这个文件时才会执行 main()在这个例子中,main()函数只有在直接运行这个文件时才会被调用。如果这个文件被导入为一个模块,那么main()函数就不会被调用。
__main__
在 Python 中,
__main__是一个特殊的预定义模块名。当你直接运行一个 Python 文件时,Python 解释器会把这个文件的模块名设置为__main__。这意味着,如果你在命令行中运行一个 Python 文件,例如
python myscript.py,那么在myscript.py中,__name__变量的值会是'__main__'。这个特性常常被用来检查一个脚本是被直接运行还是被导入为一个模块。例如,你可能会在你的脚本中看到这样的代码:
# 文件名:using_name.pyimport test if __name__ == '__main__': print('程序自身在运行')else: print('我来自另一模块')------------------------------------------------------------# 文件名:test.pyif __name__ == '__main__': print('程序自身在运行')else: print('我来自另一模块') ============================================================运行using—_name.py ,输出:我来自另一模块程序自身在运行 ------------------------------------------------------------运行test.py ,输出:程序自身在运行 内置的函数 dir() 可以找到模块内定义的所有名称。以一个字符串列表的形式返回:
print("---")import test 牛逼=1 print("---")print(test) # 返回该模块的路径print("---")print(dir(test)) # 返回该模块中的print("---")print(dir()) # 返回当前文件中的 遥遥领先=2 print("---")print(dir()) ============================================================输出:---我来自另一模块---<module 'test' from 'e:\\elric\\Programming\\study\\Python\\test.py'>---['__builtins__', '__cached__', '__doc__', '__file__', '__loader__', '__name__', '__package__', '__spec__']['__annotations__', '__builtins__', '__cached__', '__doc__', '__file__', '__loader__', '__name__', '__package__', '__spec__', 'test', '牛 逼']---['__annotations__', '__builtins__', '__cached__', '__doc__', '__file__', '__loader__', '__name__', '__package__', '__spec__', 'test', '牛 逼', '遥遥领先']print("---")from test import * 牛逼=1'''# 可以发现这种方法导入的话,这两个函数用不了。因为它是直接将其他模块中的内容直接导入到了该模块中,而不是导入test模块的引用'''# print(test)# print(dir(test))print("---")print(dir()) 遥遥领先=2 print("---")print(dir()) ============================================================输出:---我来自另一模块---['__annotations__', '__builtins__', '__cached__', '__doc__', '__file__', '__loader__', '__name__', '__package__', '__spec__', '牛逼']---['__annotations__', '__builtins__', '__cached__', '__doc__', '__file__', '__loader__', '__name__', '__package__', '__spec__', '牛逼', '遥 遥领先']类比自带的头文件
有一个特别的模块 sys ,它内置在每一个 Python 解析器中。变量 sys.ps1 和 sys.ps2 定义了主提示符和副提示符所对应的字符串:
Python>>> import sys>>> sys.ps1'>>> '>>> sys.ps2'... '>>> sys.ps1 = 'C> 'C> print('Runoob!')Runoob!C>
从一个包中导入全部?
分享你的想法,与大家交流讨论
Twikoo 加载失败
Twikoo 脚本加载失败