C 语言笔记
发布于 2026-04-06更新于 2026-11-1413251 字257 分钟 · 阅读时间
第一次:2023-7-28 ~ 2023-8-27
第二次:2023-8-27 ~ 2023-9-7
第三次:2023-10-19 ~ 2023-12-16
吐槽一下,当时我还这么认真的做笔记……,还整理了这么多次
C 语言是一种通用的高级语言
几乎所有的 UNIX 应用程序都是用 C 语言编写的
C 语言是所有编程语言的母语,大多数编译器等都是由 C 语言编写而成的,并且大多遵循 C 语言的语法。如C++,java,c#等
由于 C 语言所产生的代码运行速度与汇编语言编写的代码运行速度几乎一样,所以采用 C 语言作为系统开发语言
通过编辑器创建的文件通常称为源文件,源文件包含程序源代码。C 程序的源文件通常使用扩展名 .c。
可以使用 "vi"、"vim" 或任何其他文本编辑器来编写您的 C 语言程序。
最常用的免费可用的编译器是 GNU 的 C/C++ 编译器(gcc)
计算机思维 :枚举法、二分法 等等
程序设计的三种基础思想:顺序执行、选择执行(判断)、循环执行 (顺序结构,分支结构,循环结构)
C 语言
作为系统编程语言可以编写底层(系统内核,驱动等);
作为程序语言是过程语言(即要一步步写下解决问题的步骤);
作为结构化编程语言(创造函数,将程序模块化);
作为中级编程语言(既支持低层次语言(可转化为汇编代码(机器语言)),又有高级语言的特性)
注:编译语言c++与解释语言java(可类比)
编译型语言相当于提前把你的中国话翻译成一本英语书,你下次运行程序就不要源码了,直接对着英语书就好了。但是换个德国人(换个平台)就看不懂英语书了。
解释型语言相当于个多国翻译官,但是他不给你写书,每次只帮你一句一句翻译,源码不能丢,运行效率低。
面向过程编程与面向对象编程是两种不同的编程范式,它们之间的主要区别在于对待数据和功能的方式。
面向过程编程:
以过程或者函数为中心,按照顺序执行代码。数据和功能分离,通过传递参数来操作数据。
程序由一系列的函数组成,每个函数实现特定的功能。不容易复用和扩展,难以应对复杂的问题。面向对象编程:
以对象为中心,将数据和功能封装在对象内部,通过对象之间的交互来完成任务。封装、继承、多态是面向对象编程的三大特性。
可以更好地模拟现实世界的情况,提高了代码的可维护性、可重用性和可扩展性。面向对象编程更加符合人类的思维方式,能够更好地表达问题的本质。总的来说,面向过程和面向对象的区别在于对待数据和功能的方式,面向对象更加注重数据的封装和抽象,以及对象之间的交互,而面向过程更加注重函数的顺序执行和数据的操作。
主要包括以下部分:
#include <stdio.h>使用命令行来编译 & 执行 C 程序:
保存文件为 hello.c,进入到保存文件所在的目录,进入到保存文件所在的目录,键入 gcc hello.c,输入回车,编译代码(Windows 生成 a.exe) 可执行文件。键入 a.out 来执行程序
$ gcc hello.c$ ./a.outHello, World!如果是多个 c 代码的源码文件,编译方法如下:
$ gcc test1.c test2.c -o main.out$ ./main.outprintf("Hello, World! \n");如上,一个 C 语句包含五个结构
printf("Hello,World! \n"); ;在 C 程序中,分号是语句结束符。也就是说,每个语句必须以分号结束。它表明一个逻辑实体的结束。
// /**/C 语言有两种注释方式:
// 单行注释/* 单行注释 *//* 多行注释 多行注释 多行注释 *///后或/* */中的内容是无用的或是注释
自己给变量、函数、结构等创造的名称叫标识符,其不能等于保留字
命名规则:字母/数字/下划线;其中首字母不能为数字;尽量不超过 31 个字符;要区分大小写;最好有意义
//下面列出几个有效的标识符:mohd zara abc move_name a_123myname50 _temp j a23b9 retVal保留字不能作为标识符名称。
| 关键字 | 说明 |
|---|---|
auto |
声明自动变量 |
break |
跳出当前循环 |
case |
开关语句分支 |
char |
声明字符型变量或函数返回值类型 |
const |
定义常量,如果一个变量被 const 修饰,那么它的值就不能再被改变 |
continue |
结束当前循环,开始下一轮循环 |
default |
开关语句中的"其它"分支 |
do |
循环语句的循环体 |
double |
声明双精度浮点型变量或函数返回值类型 |
else |
条件语句否定分支(与 if 连用) |
enum |
声明枚举类型 |
extern |
声明变量或函数是在其它文件或本文件的其他位置定义 |
float |
声明浮点型变量或函数返回值类型 |
for |
一种循环语句 |
goto |
无条件跳转语句 |
if |
条件语句 |
int |
声明整型变量或函数 |
long |
声明长整型变量或函数返回值类型 |
register |
声明寄存器变量 |
return |
子程序返回语句(可以带参数,也可不带参数) |
short |
声明短整型变量或函数 |
signed |
声明有符号类型变量或函数 |
sizeof |
计算数据类型或变量长度(即所占字节数) |
static |
声明静态变量 |
struct |
声明结构体类型 |
switch |
用于开关语句 |
typedef |
用以给数据类型取别名 |
unsigned |
声明无符号类型变量或函数 |
union |
声明共用体类型 |
void |
声明函数无返回值或无参数,声明无类型指针 |
volatile |
说明变量在程序执行中可被隐含地改变 |
while |
循环语句的循环条件 |
像是printf等是在 C 语言的标准库函数之一,是个函数
_Bool | _Complex | _Imaginary | inline | restrict |
_Alignas | _Alignof | _Atomic | _Generic | _Noreturn |
_Static_assert | _Thread_local |
只包含空格的行,被称为空白行,可能带有注释,C 编译器会完全忽略它。
在 C 中,空格用于描述空白符、制表符、换行符和注释。空格分隔语句的各个部分,让编译器能识别语句中的某个元素(比如 int)在哪里结束,下一个元素在哪里开始。因此,在下面的语句中:
int age;上文的 int 和 age 之间必须至少有一个空格字符(通常是一个空白符),这样编译器才能够区分它们。另一方面,在下面的语句中:
fruit = apples + oranges; // 获取水果的总数上文的所有空格字符不是必需的,但是为了增强可读性,您可以根据需要适当增加一些空格。
用于定义小房子的类型与大小
C 中的类型可分为以下几种:
| 序号 | 类型与描述 |
|---|---|
| 1 | 基本数据类型 它们是算术类型,包括整型(int)、字符型(char)、浮点型(float)和双精度浮点型(double)。 |
| 2 | 枚举类型: 它们也是算术类型,被用来定义在程序中只能赋予其一定的离散整数值的变量。 |
| 3 | void 类型: 通常用于函数返回值。 |
| 4 | 派生类型: 数组、指针、结构体、共用体 |
数组类型+结构类型=聚合类型
函数类型=函数返回值的类型
64 位系统中,int 和 long 的范围是一样的
| 类型 | 存储大小 | 值范围 |
|---|---|---|
| char | 1 字节 | -128 ~ 127 或 0 ~ 255 |
| unsigned char | 1 字节 | 0 ~ 255 |
| signed char | 1 字节 | -128 ~ 127 |
| int | 2 或 4 字节 | -32,768 ~ 32,767 或 -2,147,483,648 ~ 2,147,483,647 (64 位) |
| unsigned int 或 unsigned short |
2 或 4 字节 | 0 ~ 65,535 |
| short 或 short int 或 signed short 或 signed short int |
2 字节 | -32,768 ~ 32,767 |
| unsigned short 或 unsigned short int |
2 字节 | 0 ~ 65,535 |
| long 或 long int 或 signed long int |
4 字节 | -2,147,483,648 ~ 2,147,483,647 |
| unsigned long 或 unsigned long int |
4 字节 | 0 ~ 4,294,967,295 |
| long long 或 long long int |
-9223372036854775808 ~ 9223372036854775807 (10^19^) |
注意,各种类型的存储大小与系统位数有关,但目前通用的以 64 位系统为主。
以下列出了 32 位系统与 64 位系统的存储大小的差别(windows 相同):
| 类型 | Windows vc12 (win32) | Windows vc12 (x64) | Linux gcc-5.3.1 (i686) | Linux gcc-5.3.1 (x86_64) |
|---|---|---|---|---|
| char | 1 | 1 | 1 | 1 |
| unsigned char | 1 | 1 | 1 | 1 |
| short | 2 | 2 | 2 | 2 |
| unsigned short | 2 | 2 | 2 | 2 |
| int | 4 | 4 | 4 | 4 |
| unsigned int | 4 | 4 | 4 | 4 |
| long | 4 | 4 | 4 | 8 |
| unsigned long | 4 | 4 | 4 | 8 |
| float | 4 | 4 | 4 | 4 |
| double | 8 | 8 | 8 | 8 |
| long int | 4 | 4 | 4 | 8 |
| long long | 8 | 8 | 8 | 8 |
| long double | 8 | 8 | 12 | 16 |
为了得到某个类型或某个变量在特定平台上的准确大小,可以使用 sizeof 运算符。使用 sizeof(类型) 得到对象或类型的存储字节大小。
//%lu 为 32 位无符号整数printf("int 存储大小 : %lu \n", sizeof(int));//输出:int 存储大小 : 4short和longshort 和 long 用于表示较大的数字与较较大的数字
long a; /*储存大整数*/ | short d; /*储存小整数*/long long b; /*储存大整数*/ |long double c; /*储存浮点数*/ |signed和unsignedsigned 和 unsigned (有符号的(整数,正数也可以有加号) 和 没符号的(非负数))
unsigned int x;| 类型 | 存储大小 | 值范围 | 精度 |
|---|---|---|---|
| float | 4 字节 | 1.2E-38 ~ 3.4E+38 | 6 位有效位 |
| double | 8 字节 | 2.3E-308 ~ 1.7E+308 | 15 位有效位 |
| long double | 16 字节 | 3.4E-4932 ~ 1.1E+4932 | 19 位有效位 |
头文件 float.h 定义了宏,在程序中可以使用这些值和其他有关实数二进制表示的细节。下面的实例将输出浮点类型占用的存储空间以及它的范围值:
#include <stdio.h>#include <float.h> //%E 为以指数形式输出单、双精度实数printf("float 存储最大字节数 : %lu \n", sizeof(float));printf("float 最小值: %E\n", FLT_MIN );printf("float 最大值: %E\n", FLT_MAX );printf("精度值: %d\n", FLT_DIG );//输出:float 存储最大字节数 : 4float 最小值: 1.175494E-38float 最大值: 3.402823E+38精度值: 6英文:空白,这里指无类型或空类型(空值)
| 序号 | 类型与描述 |
|---|---|
| 1 | 函数返回为空 就是函数不返回任何东西 |
| 2 | 函数参数为空 就是函数不接受参数 如: int main(void){} 或 int main(){}这样()中为空 |
| 3 | 指针指向 void 类型为 void * 的指针代表对象的地址,而不是类型。可以通过指向 void 的指针获取函数的地址 |
就是改变数据类型,同时也改变值
(类型名称),//隐式int i = 10;float f = 3.14;double d = i + f; // 隐式将int类型转换为double类型//显式double d = 3.14159;int i = (int)d; // 显式将double类型转换为int类型变量:保存可改变的数据的小房子(容器)
变量属于标识符,和它的命名规则一样
| 类型 | 描述 |
|---|---|
| char | 通常是一个字节(八位), 这是一个整数类型。 |
| int | 整型,4 个字节,取值范围 -2147483648 到 2147483647。 |
| float | 单精度浮点值。单精度是这样的格式,1 位符号,8 位指数,23 位小数。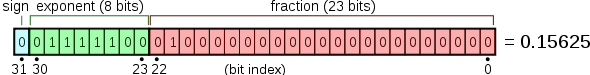 |
| double | 双精度浮点值。双精度是 1 位符号,11 位指数,52 位小数。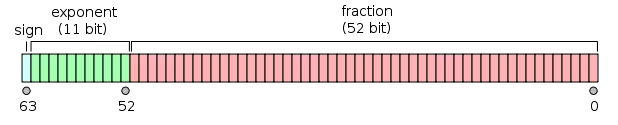 |
| void | 表示类型的缺失。 |
用于告诉编译器在何处如何创建小房子
类型 变量名,变量名; // 类型可以是自己定义的结构呀等对象实例:
int age;float salary;char grade;int *ptr;int i, j, k;赋予变量初始值
类型 变量名=值;实例:
int x = 10;float pi = 3.14;char ch = 'A';// d 和 f 的声明与初始化// 这里是声明有d和f在内存中,但定义在别的文件中extern int d = 3, f = 5;// 定义并初始化 d 和 fint d = 3, f = 5;// 定义并初始化 zbyte z = 22;给变量赋值:
类型 变量名; // 定义变量变量名=值; // 赋值变量实例:
float pi;pi = 3.14159;建议定义局部变量时初始化,因为它没定义前可能包含内存中任意垃圾值
但全局变量或静态变量自带默认初始值,为 0 (0 / 0.0 / '\0' / NULL)
就是告诉编译器变量以存在,这样编译器在不需要知道变量完整细节的情况下也能继续进一步的编译。
变量的声明有两种情况:
同时声明与定义 int a; (要建立存储空间)
通过 extern 只声明 extern int a (不用建立存储空间) 其中变量 a 可以在别的文件中定义的。
就是没有 extern 都是第一种类型
extern int i; //声明不定义int i; //声明并定义实例:
#include <stdio.h> // 函数外定义变量 x 和 yint x;int y;int add(){ // 函数内声明变量 x 和 y 为外部变量 extern int x; extern int y; // 给外部变量(全局变量)x 和 y 赋值 x = 1; y = 2; return x+y;} int main(){ int ans; // 调用函数 add ans = add(); printf(ans 为: %d",ans); return 0;}//输出:ans 为: 3如果要在一个源文件中引用另外一个源文件中定义的变量,我们只需在引用的文件中将变量加上 extern 关键字的声明即可。
//add.c 文件代码#include <stdio.h>/*外部变量声明*/extern int x ;extern int y ;int add(){ return x+y;}//test.c 文件代码#include <stdio.h> /*定义两个全局变量*/int x=1;int y=2;int add();int main(void){ int result; result = add(); printf("result 为: %d\n",ans); return 0;}# 编译:$ gcc addtwonum.c test.c -o main$ ./main# 输出:ans 为: 3若这两个文件在同一个项目中,编辑器会自动将整个项目编译在一起
C 中有两种类型的表达式:
int g;g = 20; // √ 10 = 20; // ×常量:不能更改的量,是固定值,在程序执行期间不会改变,也不能进行修改。
这些固定的值,又叫做字面量。
字面量:小房子里的的数,也可直接使用(如1、2.5、'c' )
整数: 十进制: 0, -9, 22
八进制: 021, 077, 033 (八进制以 0 开头)
十六进制: 0x7f, 0x2a, 0x521 (十六进制以 0x 开头)
浮点数:小数或科学计数法的数(如-2.0、-0.22E-5)
注:E-5 = 10-5
字符:ascii 字符,要在单引号内(如:'a'、'2')
转义序列:不能通过键盘输入的或有特殊含义的字符(如问号,制表符)
字符串字面量(字符串):用双引号括起来的(如"good")
int number = 42; //42是一个整数字面量double pi = 3.14; //3.14是一个浮点数字面量char letter = 'A'; //'A'是一个字符字面量String greeting = "Hello"; //"Hello"是一个字符串字面量boolean flag = true; //true是一个布尔字面量Object obj = null; //null是一个空字面量字面量可以直接在代码中使用,也可以通过定义常量来使用。
int(integer 整数) 用以声明一个或多个整数变量 输出整数%d
整数常量可以是十进制、八进制或十六进制的常量。
前缀指定基数:0x 或 0X 表示十六进制,0 表示八进制,不带前缀则默认表示十进制,当输出时可能不会默认带前缀。
整数常量也可以带一个后缀,后缀是 U 和 L 的组合,U 表示无符号整数(unsigned),L 表示长整数(long)。后缀可以是大写,也可以是小写,U 和 L 的顺序任意。
实例:
212 /* 合法的 */215u /* 合法的 */0xFeeL /* 合法的 */078 /* 非法的:8 不是八进制的数字 */032UU /* 非法的:不能重复后缀 */85 /* 十进制 */0213 /* 八进制 */0x4b /* 十六进制 */30 /* 整数 */30u /* 无符号整数 */30l /* 长整数 */30ul /* 无符号长整数 */整数常量可以带有一个后缀表示数据类型,如:
int myInt = 10;long myLong = 100000L;unsigned int myUnsignedInt = 10U; cout<<myInt<<"\n"<<myLong<<"\n"<<myUnsignedInt;// 输出:// 10// 100000// 10float 和 double(float 单精度浮点数)(double float 双精度浮点数)(float 浮动 ==> 浮点数,即小数) 输出小数%f 用%lf来输出双精度小数(lf=long float)
用于保存实数与小数
实例:
3.14159 /* 合法的 */314159E-5L /* 合法的 */510E /* 非法的:不完整的指数 */210f /* 非法的:没有小数或指数 */.e55 /* 非法的:缺少整数或分数 */// 注:e可大写也可小写浮点数常量可以带有一个后缀表示数据类型,例如:
float myFloat = 3.14f;double myDouble = 3.14159;注:常量不是数组,数组是派生类型
char声明字符类型(character 字符)
字符常量可以是:一个普通的 ascii 字符,要在单引号内(例如 'x');一个转义序列(例如 '\t');或一个通用的字符(例如 '\u02C0')。
反斜杠\用于打出特殊字符或本身有意义的字符
转义序列:不能通过键盘输入的或有特殊含义的字符(如问号,制表符)
| 转义序列 | 含义 |
|---|---|
\\ |
\ 字符(反斜杠) |
\' |
' 字符(单引号) |
\" |
" 字符(双引号) |
\? |
? 字符(问号) |
\0 |
0 字符(空字符/NUL 字符) (ascii 数值为 0) |
\a |
警报铃声 |
\b |
退格键 |
\f |
换页符 |
\n |
换行符 |
\r |
回车 |
\t |
水平制表符 |
\v |
垂直制表符 |
\ooo |
一到三位的八进制数 |
\xhh . . . |
一个或多个数字的十六进制数 |
下面的实例显示了一些转义序列字符:
#include <stdio.h> int main(){ printf("Hello\tWorld\n\n"); return 0;} //输出://Hello World//字符常量的 ASCII 值可以通过强制类型转换转换为整数值。
char myChar = 'a';int myAsciiValue = (int) myChar; // 将 myChar 转换为 ASCII 值 97字符串:用" " 括起来的。包含很多单引号字符:普通的字符、转义序列和通用的字符。
使用\做分隔符,可以把一个很长的字符串常量进行分行。
下面这三种形式所显示的字符串是相同的。
"hello, dear" "hello,\ dear" "hello, " "d" "ear"字符串常量在内存中以 null 终止符 \0 结尾。例如:
char myString[] = "Hello, world!"; //系统对字符串常量自动加一个 '\0'习惯将常量用大写字母定义,用以区分
下面是使用 #define 预处理器定义常量的形式:
#define 常量名 常量值如:
#define PI 3.14159在程序中使用该常量时,编译器会将所有的 PI 替换为 3.14159。
实例:
#define NEWLINE '\n' printf("%c123", NEWLINE); // 输出://// 123(const 常量)
下面的代码定义了一个名为 PI 的常量:
const double PI = 3.14159;在程序中使用该常量时,其值将始终为 100,并且不能被修改。
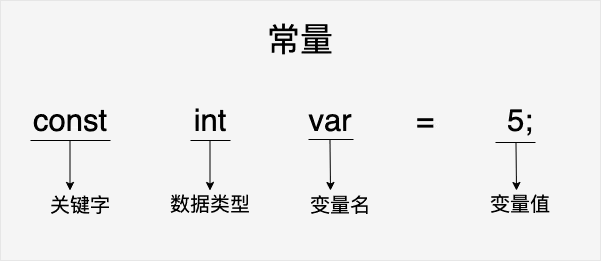
const 声明常量要在一个语句内完成:
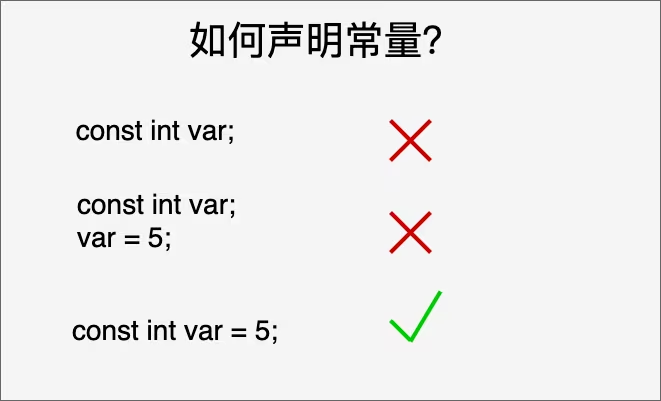
const 是声明一个常量,#define 是文本替换
存储类定义变量/函数的存储位置、生命周期和作用域。
这些说明符要放置在它们所修饰的类型之前。
auto 用于局部变量(只能用在函数内),让这个变量作用域在代码块内。
已被废弃,但作为保留字,auto 仍然存在于 C 语言的语法规范中。以防止用户将其作为标识符来使用。
定义在函数中的变量默认为 auto 存储类。
{ int a; <==> auto int a; //因为加不加auto都不影响,所以被废弃了}register 将局部变量定义在寄存器(cpu 中的内存)中,可以让变量的访问速度更快,因为不是在内存(RAM)中,因此也没有了内存地址,无法使用&。
{ register int miles;}编译器会自动进行寄存器分配和优化,将频繁使用的变量存储在寄存器中,因此手动使用 register 存储类的效果有限。还有
是否实际将变量存储在寄存器中是由编译器决定的,它可能会根据具体情况忽略 register 关键字。
static:静止的,静态的
使用它声明的变量叫做静态变量
static
如:
#include <stdio.h> // 函数声明void func1(void);// 只作用于当前文件中static int count=10; int main(){ while (count--) { func1(); } return 0;} void func1(void){ // 只作用于当前块中,但直到程序结束时才会被销毁 static int thingy=5; thingy++; printf(" thingy 为 %d , count 为 %d\n", thingy, count);} // 输出: thingy 为 6 , count 为 9 thingy 为 7 , count 为 8 thingy 为 8 , count 为 7 thingy 为 9 , count 为 6 thingy 为 10 , count 为 5 thingy 为 11 , count 为 4 thingy 为 12 , count 为 3 thingy 为 13 , count 为 2 thingy 为 14 , count 为 1 thingy 为 15 , count 为 0extern 用于声明一个全局变量/函数,这个函数在其他文件中定义的,通过它在这个文件中声明,也可以让这个文件在内存中引用其他文件定义的变量/函数,以减少重复定义
如:
第一个文件:main.c
#include <stdio.h> int count ;extern void write_extern(); int main(){ count = 5; write_extern();}第二个文件:support.c
#include <stdio.h> extern int count; void write_extern(void){ printf("count is %d\n", count);}在这里,第二个文件中的 extern 关键字用于声明已经在第一个文件 main.c 中定义的 count。编译这两个文件,如下所示:
$ gcc main.c support.c这会产生 a.out 可执行程序,当程序被执行时,它会产生下列结果:
// 输出count is 5int A=10,B=20;
| 运算符 | 描述 | 实例 |
|---|---|---|
| + | 把两个操作数相加 | A + B 将得到 30 |
| - | 从第一个操作数中减去第二个操作数 | A - B 将得到 -10 |
| * | 把两个操作数相乘 | A * B 将得到 200 |
| / | 分子除以分母 | B / A 将得到 2 |
| % | 取模运算符,整除后的余数 | B % A 将得到 0 |
| ++ | 自增运算符,整数值增加 1 | A++ 将得到 11 |
| -- | 自减运算符,整数值减少 1 | A-- 将得到 9 |
int A=10,B=20;
| 运算符 | 描述 | 实例 |
|---|---|---|
| == | 检查两个操作数的值是否相等, 如果相等则条件为真。 |
(A == B) 为假 |
| != | 检查两个操作数的值是否相等, 如果不相等则条件为真。 |
(A != B) 为真 |
| > | 检查左操作数的值是否**>**右操作数的值, 如果是则条件为真。 |
(A > B) 为假 |
| < | 检查左操作数的值是否**<**右操作数的值, 如果是则条件为真。 |
(A < B) 为真 |
| >= | 检查左操作数的值是否**≥**右操作数的值, 如果是则条件为真。 |
(A >= B) 为假 |
| <= | 检查左操作数的值是否**≤**右操作数的值, 如果是则条件为真。 |
(A <= B) 为真 |
int A=1,B=0;
| 运算符 | 描述 | 实例 |
|---|---|---|
| && | 逻辑与运算符。 如果两个操作数都非零,则条件为真。 |
(A && B) 为假 |
| || | 逻辑或运算符。 如果两个操作数中有任意一个非零,则条件为真。 |
(A || B) 为真 |
| ! | 逻辑非运算符。 用来逆转操作数的逻辑状态。如果条件为真则逻辑非运算符将使其为假。 |
!(A && B) 为真 |
位运算就是直接对二进制数按每一位进行操作,而不考虑整体含义,
就是将二进制的 0 或 1 看成逻辑的真或假来向竖式一样进行逻辑运算
C 语言中的位运算符包括:
此外,还有移位运算符:
例如 1(位运算符):
对于二进制数a=1010和b=1111,(10 和 15)
其按位与运算的结果为 1010 & 1111 = 1010,(a & b)
按位或运算的结果为 1010 | 1111 = 1111,(a | b)
异或运算的结果为 1010 ^ 1111 = 0101,(a ^ b)(0101:5)
取反运算的结果为 ~1010 = 0101。 (~a)
例如 2(移位运算符):
对于二进制数a=1010,
其左移 1 位的结果为 10100,(a<<1)(10100:20)
右移 1 位的结果为 101。 (a>>1) (101:5)
注:1. << >> 还是输入输出流的分隔符
2. 其实上面的位移结果在内存中是
0000 0000 0000 0000 0000 0000 0001 0100和
0000 0000 0000 0000 0000 0000 0000 0101
3. 其实
a<<n 就相当于 a×2 的 n 次方,
a>>n 就相当于 a 整除 2 的 n 次方。
4. ~A=-A-1 (这里的 A 是一个二进制数,而非一个像上面一样的变量)
下表显示了 C 语言位运算符。
int A=60,B=13;
| 运算符 | 描述 | 实例 |
| :----- | :--------------------------------------------------------------------------------------------------- | :------------------------------------------------ | ------------ | ------------ | ----- | ---------------------------------- |
| & | 与
运算规则:0&0=0;0&1=0;1&0=0;1&1=1; | (A & B) 将得到 12,即为 0000 1100 |
| | | 或
运算规则:0 | 0=0;0 | 1=1;1 | 0=1;1 | 1=1; | (A | B) 将得到 61,即为 0011 1101 |
| ^ | 异或
运算规则:0^0=0;0^1=1;1^0=1;1^1=0; | (A ^ B) 将得到 49,即为 0011 0001 |
| ~ | 取反
运算规则:~1=-2;~0=-1; | (~A ) 将得到 -61,
即为 1100 0011,(补码)。 |
| << | 二进制左移运算符
将一个运算对象的各二进制位全部左移若干位
(左边的二进制位丢弃,右边补 0)。 | A << 2 将得到 240,
即为 1111 0000 |
| >> | 二进制右移运算符
将一个数的各二进制位全部右移若干位,
(正数左补 0,负数左补 1,右边丢弃) | A >> 2 将得到 15,
即为 0000 1111 |
| 运算符 | 描述 | 实例 |
|---|---|---|
| = | 简单的赋值运算符 | C = A + B 将把 A + B 的值赋给 C |
| += | 加且赋值运算符 | C += A <==> C = C + A |
| -= | 减且赋值运算符 | C -= A <==> C = C - A |
| *= | 乘且赋值运算符 | C _= A <==> C = C _ A |
| /= | 除且赋值运算符 | C /= A <==> C = C / A |
| %= | 求模且赋值运算符 | C %= A <==> C = C % A |
| <<= | 左移且赋值运算符 | C <<= 2 <==> C = C << 2 |
| >>= | 右移且赋值运算符 | C >>= 2 <==> C = C >> 2 |
| &= | 按位与且赋值运算符 | C &= 2 <==> C = C & 2 |
| ^= | 按位异或且赋值运算符 | C ^= 2 <==> C = C ^ 2 |
| |= | 按位或且赋值运算符 | C |= 2 <==> C = C | 2 |
下表列出了 C 语言支持的其他一些重要的运算符,包括 sizeof 和 ? :。
| 运算符 | 描述 | 实例 |
|---|---|---|
| sizeof() | 返回变量的大小。 | sizeof(a) 将返回 4,其中 a 是整数。 |
| & | 返回变量的地址。 | &a; 将给出变量的实际地址。 |
| * | 指向一个变量。 | *a; 将指向一个变量。 |
| ? : | 条件表达式 | 如果条件为真 ? 则值为 X : 否则值为 Y |
请看下面的实例,了解 C 语言中所有可用的杂项运算符:
#include <stdio.h> int main(){ int a = 4; short b; double c; int* ptr; /* sizeof 运算符实例 */ printf("Line 1 - 变量 a 的大小 = %lu\n", sizeof(a) ); printf("Line 2 - 变量 b 的大小 = %lu\n", sizeof(b) ); printf("Line 3 - 变量 c 的大小 = %lu\n", sizeof(c) ); /* & 和 * 运算符实例 */ ptr = &a; /* 'ptr' 现在包含 'a' 的地址 */ printf("a 的值是 %d\n", a); printf("*ptr 是 %d\n", *ptr); /* 三元运算符实例 */ a = 10; b = (a == 1) ? 20: 30; printf( "b 的值是 %d\n", b ); b = (a == 10) ? 20: 30; printf( "b 的值是 %d\n", b );}//输出:Line 1 - 变量 a 的大小 = 4Line 2 - 变量 b 的大小 = 2Line 3 - 变量 c 的大小 = 8a 的值是 4*ptr 是 4b 的值是 30b 的值是 20从高到低的优先级
| 优先级 | 运算符 | 含义 | 类 | 结合律 |
|---|---|---|---|---|
| 16 | 简单记号 | 主 | 无 | |
| [] | 数组取下标 | 后缀 | 从左到右 | |
| f(...) | 函数调用 | 后缀 | ||
| . | 结构/联合成员 | 后缀 | ||
| -> | 结构/联合间接成员 | 后缀 | ||
| ++ | 自增 | 后缀 | ||
| -- | 自减 | 后缀 | ||
| (type name) (init) | 复合字面值(C99) | 后缀 | ||
| 15 | ++ | 自增 | 前缀 | 从右到左 |
| -- | 自减 | 前缀 | ||
| sizeof | 数据类型长度 | 一元 | ||
| ~ | 按位 取反 | 一元 | ||
| ! | 逻辑 非 | 一元 | ||
| - | 负号 | 一元 | ||
| + | 正号 | 一元 | ||
| & | 取地址 | 一元 | ||
| * | 间接访问 | 一元 | ||
| 14 | (type name) | 类型转换 | 一元 | 从右到左 |
| 13 | * | 乘法 | 二元 | 从左到右 |
| / | 除法 | 二元 | ||
| % | 求余 | 二元 | ||
| 12 | + | 加法 | 二元 | 从左到右 |
| - | 减法 | 二元 | ||
| 11 | << | 左移 | 二元 | 从左到右 |
| >> | 右移 | 二元 | ||
| 10 | <、>、<=、>= | 小于、大于、小于等于、大于等于 | 二元 | 从左到右 |
| 9 | ==、!= | 相等、不相等 | 二元 | 从左到右 |
| 8 | & | 按位 与 | 二元 | 从左到右 |
| 7 | ^ | 按位 异或 | 二元 | 从左到右 |
| 6 | || | 按位 或 | 二元 | 从左到右 |
| 5 | && | 逻辑 与 | 二元 | 从左到右 |
| 4 | || | 逻辑 或 | 二元 | 从左到右 |
| 3 | ?: | 条件 | 三元 | 从右到左 |
| 2 | =、+=、-=、*=、/=、%=、<<=、>>=、&=、^=、|= | 赋值 | 二元 | 从右到左 |
| 1 | , | 逗号运算符(顺序求值) | 二元 | 从左到右 |
C 语言把任何非零和非空的值假定为 true,把零或 null 假定为 false。
下面是大多数编程语言中典型的判断结构的一般形式:
st=>start: 开始op=>operation: 条件代码cond=>condition: 条件Ae=>end: 结束st->condcond(no)->econd(yes)->op->eC 语言提供了以下类型的判断语句。点击链接查看每个语句的细节。
| 语句 | 描述 |
|---|---|
| if 语句 | 一个 if 语句 由一个布尔表达式后跟一个或多个语句组成。 |
| if...else 语句 | 一个 if 语句 后可跟一个可选的 else 语句,else 语句在布尔表达式为假时执行。 |
| 嵌套 if 语句 | 您可以在一个 if 或 else if 语句内使用另一个 if 或 else if 语句。 |
| switch 语句 | 一个 switch 语句允许测试一个变量等于多个值时的情况。 |
| 嵌套 switch 语句 | 您可以在一个 switch 语句内使用另一个 switch 语句。 |
条件运算符 ? :,可以用来替代 if...else 语句。
条件 ? 真的结果 : 假的结果;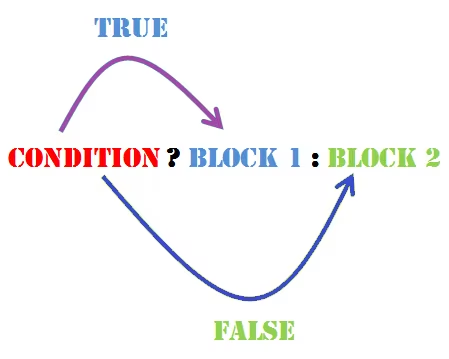
以下实例通过输入一个数字来判断它是否为奇数或偶数
int gcd(int x,int y){return y?gcd(y,x%y):x;}C 语言中 if 语句的语法:
if(条件){ /* 如果表达式为真将执行的语句 */}st=>start: 开始sub=>subroutine: 块内代码cond=>condition: if条件e=>end: 结束st->condcond(no)->econd(yes)->sub->e一个 if 语句 后可跟一个可选的 else 语句,else 语句在布尔表达式为 false 时执行。
C 语言中 if...else 语句的语法:
if条件){ /* 如果表达式为真将执行的语句 */}else{ /* 如果表达式为假将执行的语句 */}st=>start: 开始sub1=>subroutine: if代码块Bsub2=>subroutine: else代码块cond=>condition: if条件Ae=>end: 结束st->condcond(no)->sub2->econd(yes)->sub1->e#include <stdio.h> int main (){ /* 局部变量定义 */ int a = 100; /* 检查布尔条件 */ if( a < 20 ) { /* 如果条件为真,则输出下面的语句 */ printf("a 小于 20\n" ); } else { /* 如果条件为假,则输出下面的语句 */ printf("a 大于 20\n" ); } printf("a 的值是 %d\n", a); return 0;}//输出:a 大于 20a 的值是 100一个 if 语句后可跟一个可选的 else if...else 语句,这可用于测试多种条件。
当使用 if...else if...else 语句时,以下几点需要注意:
C 语言中的 if...else if...else 语句的语法:
if(条件){ /* 当布尔表达式 1 为真时执行 */}else if(条件2){ /* 当布尔表达式 2 为真时执行 */}else if(条件3){ /* 当布尔表达式 3 为真时执行 */}else{ /* 当上面条件都不为真时执行 */}#include <stdio.h> int main (){ /* 局部变量定义 */ int a = 100; /* 检查布尔条件 */ if( a == 10 ) { /* 如果 if 条件为真,则输出下面的语句 */ printf("a 的值是 10\n" ); } else if( a == 20 ) { /* 如果 else if 条件为真,则输出下面的语句 */ printf("a 的值是 20\n" ); } else if( a == 30 ) { /* 如果 else if 条件为真,则输出下面的语句 */ printf("a 的值是 30\n" ); } else { /* 如果上面条件都不为真,则输出下面的语句 */ printf("没有匹配的值\n" ); } printf("a 的准确值是 %d\n", a ); return 0;}//输出:没有匹配的值a 的准确值是 100一个 switch 语句允许测试一个变量等于多个值时的情况。每个值称为一个 case,且被测试的变量会对每个 switch case 进行检查。
C 语言中 switch 语句的语法:
switch (day){ case 1: printf("Monday\n"); // 语句 break; case 2: printf("Tuesday\n"); // 语句 break; ...... default: printf("Invalid day\n");// 默认语句(Invalid day无效的日期)}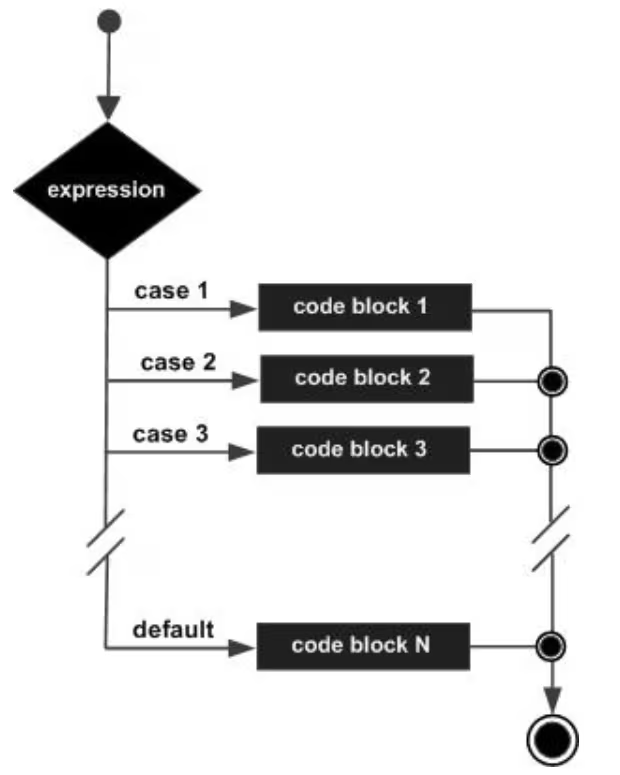
#include <stdio.h> int main (){ /* 局部变量定义 */ char grade = 'B'; switch(grade) { case 'A' : printf("很棒!\n" ); break; case 'B' : case 'C' : printf("做得好\n" ); break; case 'D' : printf("您通过了\n" ); break; case 'F' : printf("最好再试一下\n" ); break; default : printf("无效的成绩\n" ); } printf("您的成绩是 %c\n", grade ); return 0;}//输出:做得好您的成绩是 B可以把一个 switch 作为一个外部 switch 的语句序列的一部分,即可以在一个 switch 语句内使用另一个 switch 语句。即使内部和外部 switch 的 case 常量包含共同的值,也没有矛盾。
C 语言中 嵌套 switch 语句的语法:
switch(ch1) { case 'A': printf("这个 A 是外部 switch 的一部分" ); switch(ch2) { case 'A': printf("这个 A 是内部 switch 的一部分" ); break; case 'B': /* 内部 B case 代码 */ } break; case 'B': /* 外部 B case 代码 */}#include <stdio.h> int main (){ /* 局部变量定义 */ int a = 100; int b = 200; switch(a) { case 100: printf("这是外部 switch 的一部分\n"); switch(b) { case 200: printf("这是内部 switch 的一部分\n"); } } printf("a 的准确值是 %d\n", a ); printf("b 的准确值是 %d\n", b ); return 0;}//输出:这是外部 switch 的一部分这是内部 switch 的一部分a 的准确值是 100b 的准确值是 200有的时候,我们可能需要多次执行同一块代码。一般情况下,语句是按顺序执行的:函数中的第一个语句先执行,接着是第二个语句,依此类推。
编程语言提供了更为复杂执行路径的多种控制结构。
循环语句允许我们多次执行一个语句或语句组,下面是大多数编程语言中循环语句的流程图:
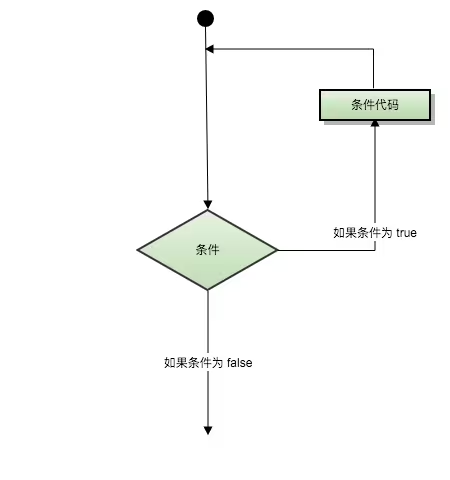
C 语言提供了以下几种循环类型。点击链接查看每个类型的细节。
| 循环类型 | 描述 |
|---|---|
| while 循环 | 当给定条件为真时,重复语句或语句组。它会在执行循环主体之前测试条件。 |
| for 循环 | 多次执行一个语句序列,简化管理循环变量的代码。 |
| do...while 循环 | 除了它是在循环主体结尾测试条件外,其他与 while 语句类似。 |
| 嵌套循环 | 您可以在 while、for 或 do..while 循环内使用一个或多个循环。 |
循环控制语句改变你代码的执行顺序。通过它你可以实现代码的跳转。
C 提供了下列的循环控制语句。点击链接查看每个语句的细节。
| 控制语句 | 描述 |
|---|---|
| break 语句 | 终止循环或 switch 语句,程序流将继续执行紧接着循环或 switch 的下一条语句。 |
| continue 语句 | 告诉一个循环体立刻停止本次循环迭代,重新开始下次循环迭代。 |
| goto 语句 | 将控制转移到被标记的语句。但是不建议在程序中使用 goto 语句。 |
如果条件永远不为假,则循环将变成无限循环。for 循环在传统意义上可用于实现无限循环。由于构成循环的三个表达式中任何一个都不是必需的,您可以将某些条件表达式留空来构成一个无限循环。
实例
#include <stdio.h> int main (){ for( ; ; ) { printf("该循环会永远执行下去!\n"); } return 0;}当条件表达式不存在时,它被假设为真。或达不到条件也会一直循环下去
**注:**可以按 Ctrl + C 键终止一个无限循环。
和do...while`循环while( ){ }//当小括号中为真,执行大括号中的内容,否则不执行 //其中int i=1;while (i<=100) <==> for(int i=1;i<=100;i++ ){ { 内容; 内容; i++; }}do{ }whlie( )//先执行,再判断真假,看看是否执行下一次//因此,它与while的区别是它至少会执行一次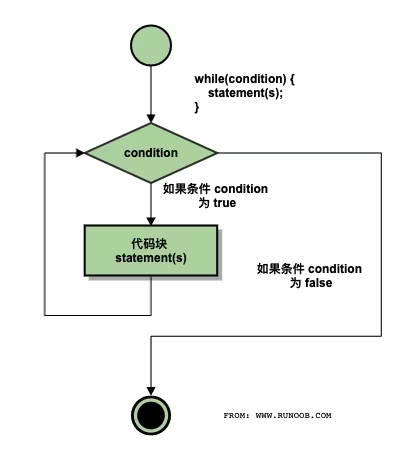
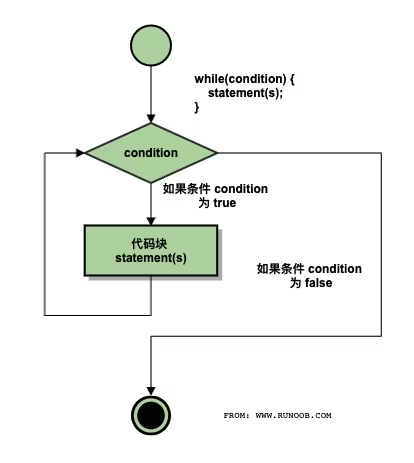
for 循环允许您编写一个执行指定次数的循环控制结构。
for( ; ; ){ }for
(
初始化语句(仅执行一次);
评估测试表达式(如果命题为假,则终止循环);
更新表达式(一般用于改变循环控制变量的值)
)
{先执行测试完为真后,执行大括号中的语句;之后才执行更新表达式(如 i++)}
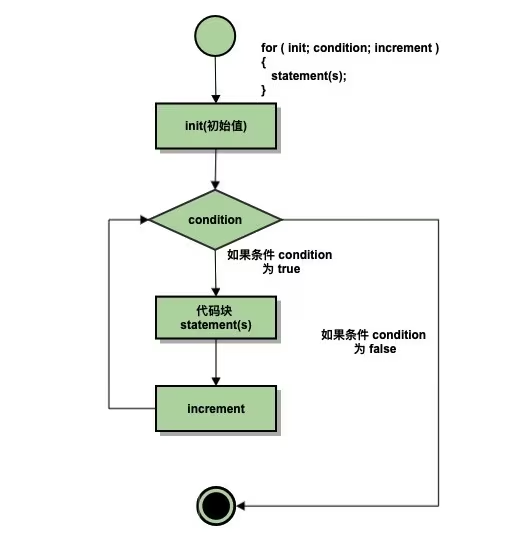
循环中套循环
嵌套 for 循环流程图:
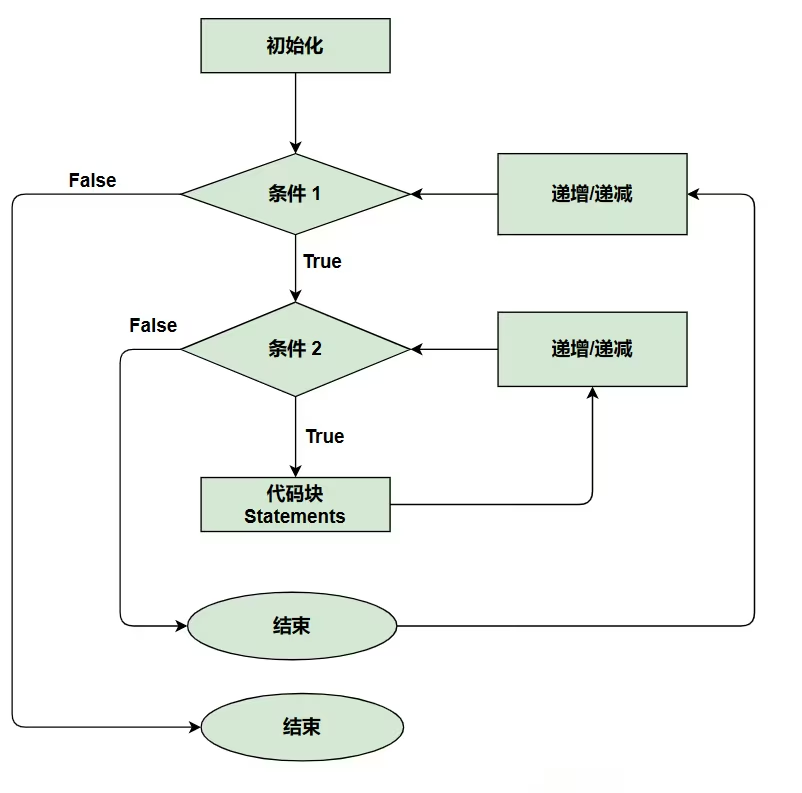
嵌套 while 循环流程图:
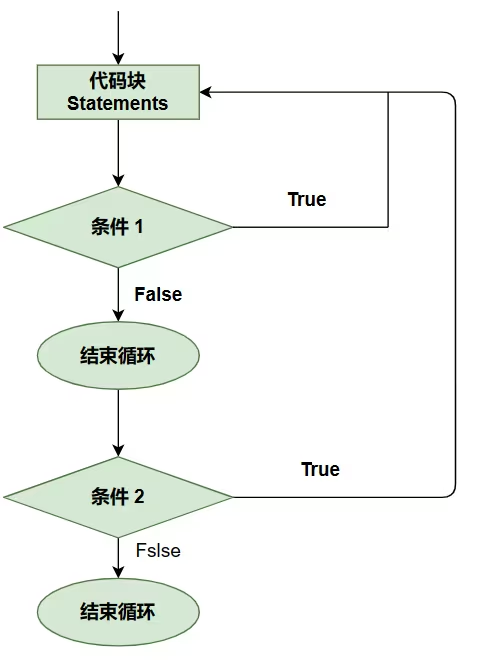
break和continue语句当读到break,立刻跳出循环(立刻结束当前所在的循环)
当读到continue,跳过当前迭代(的剩余代码),立刻进行下一个迭代(循环)
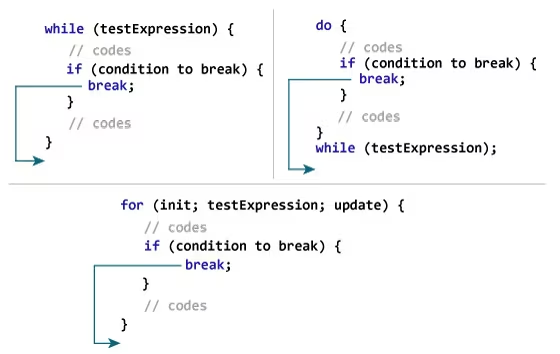
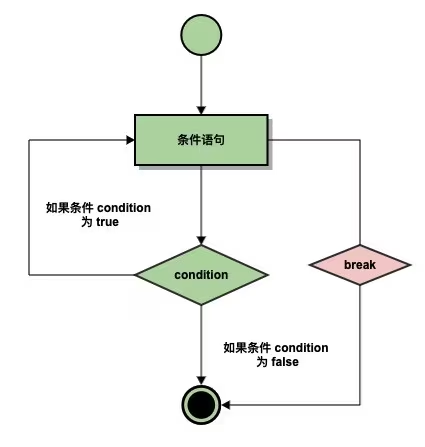
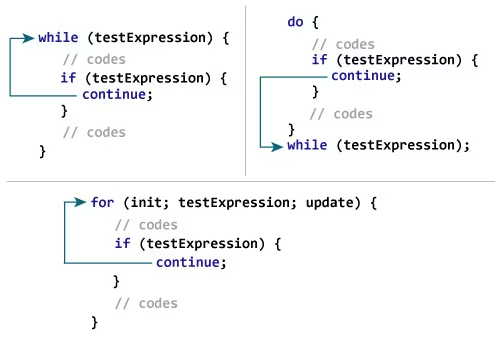
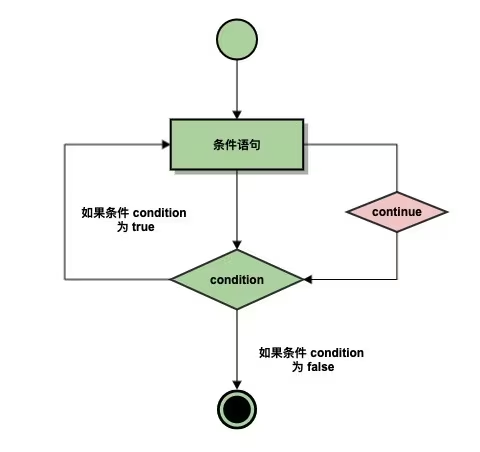
goto语句goto abc;……abc:通过goto,将直接跳转到标签abc处,并让程序从abc处开始执行,
标签abc可在goto前,也可在后;
一般用于打破嵌套循环,用到其他地方后,可能会让代码很难理解,最好少用
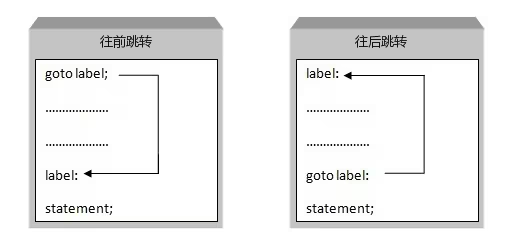
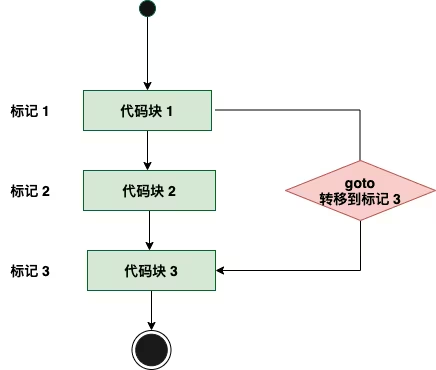
函数是一组一起执行一个任务的语句。
每个 C 程序都至少有一个函数,即主函数 main() ,所有简单的程序都可以定义其他额外的函数。
可以把代码划分到不同的函数中,以优化重构代码
函数声明告诉编译器函数的名称、返回类型和参数。函数定义提供了函数的实际主体。
其包含声明函数,调用函数,定义函数三个方面,其中声明和定义可以一起,只要在前面
C 标准库提供了大量的内置函数。如:printf() scanf()
当然也可以自己定义函数
函数还有很多叫法,比如方法、子例程或程序,等等。
函数定义:
如求和函数:
void sum(int begin,int end) //这是函数头//sum是函数名//void是返回类型 (void是”没有“不返回任何东西)//函数头中的括号部分是参数表。若是空的表示不接受任何函数//下面是函数体{ int i; int sum=0; for(i=begin; i<=end;i++) { sum+=1; } printf("%d到%d的和是%d\n",begin,end,sum);}void:不返回任何东西(其后不能用带值的return(可用return;)或可以没有return)
int :返回return后的结果(如return i,则返回i中的值)
return后停止这个函数的运行,并返回一个值(一个函数可以出现多个函数)
把函数放在int main上面是因为 c 的编译器是自上而下分析代码,它必须要先看到自创的函数才能运用,
或者将函数头复制一遍并搬到前面去并加;,从而对编译器进行一次“原型声明”,告知它有这个代码
如:
void sum(~);int main(~){~}void sum(~){~}若调用函数时给的参数类型不匹配,c 语言会悄悄改好,但 c++,java 等不会(如double 2.4 ==>int 2)
当您在一个源文件中定义函数且在另一个文件中调用函数时,函数声明是必需的。在这种情况下,您应该在调用函数的文件顶部声明函数。
函数名(参数值);
()起到了表示函数调用的重要作用
即使没有参数也需要()
如果有参数,则需给出正确的数量与顺序,这些值会被按照顺序依次初始化函数中的参数
注:返回值的类型也要匹配
这些变量称为函数的形式参数。
形式参数就像函数内的其他局部变量,在进入函数时被创建,退出函数时被销毁。
当调用函数时,有两种向函数传递参数的方式:
| 调用类型 | 描述 |
|---|---|
| 传值调用 | 传递参数本身,不会改变原值 (复制传递) |
| 引用调用 | 传递参数的指针,会改变原值 (传递地址) |
默认使用传值调用来传递参数,除非传递指针 (传值调用又称值传递)
有如下两种方式:
&: 函数(int &a) main (a) *: 函数(int *a) main (&a)使用 & 和 * 的引用传递有以下不同之处:
& 引用传递:使用 & 表示引用传递时,函数参数接收的是原始变量的引用。在函数内部对该引用进行操作时,实际上是直接对原始变量进行操作。这意味着对引用的修改会直接反映到原始变量上。* 指针传递:使用 * 表示指针传递时,函数参数接收的是原始变量的指针。在函数内部对该指针进行操作时,需要通过解引用操作 * 来访问原始变量的值。通过指针传递,可以在函数内部修改指针所指向的数据,从而间接修改原始变量的值。总结起来,& 引用传递直接操作原始变量,而 * 指针传递通过指针间接操作原始变量。引用传递更直观、方便,而指针传递更灵活、具有更多的控制权。
任何一种编程中,作用域是程序中定义的变量所存在的区域,超过该区域变量就不能被访问。C 语言中有三个地方可以声明变量:
只能在代码块{}中使用
全局变量在整个程序生命周期内都是有效的,可以被任何函数访问。
在程序中,局部变量和全局变量的名称可以相同,但是在函数内,如果两个名字相同,会使用局部变量值,全局变量不会被使用。
函数的参数,形式参数,被当作该函数内的局部变量,如果与全局变量同名它们会优先使用。
全局变量与局部变量在内存中的区别:
- 全局变量保存在内存的全局存储区中,占用静态的存储单元;
- 局部变量保存在栈中,只有在所在函数被调用时才动态地为变量分配存储单元。
全局变量或静态变量自带默认初始值,为 0
| 数据类型 | 初始化默认值 |
|---|---|
| int | 0 |
| char | '\0' |
| float | 0 |
| double | 0 |
| pointer | NULL |
建议定义局部变量时初始化,因为它没定义前可能包含内存中任意垃圾值
数组是可以储存多个值的变量
(即多个小房子 如a[5]={1,100,2,5,44}等等)
| a[5]分为 | a[0] | a[1] | a[2] | a[3] | a[4] |
|---|---|---|---|---|---|
| \ |
数组的第一个索引(值)为 0,所以要访问最后一个元素,要使用 n-1;
假设起始地址mark[0]是 2120d,则mark[1]的地址将是 2124d,同样的,mark[2]的地址是 2128d 以此类推
如下:
double balance[10];在声明期间可以初始化数组,
如:
int mark[5] = {19, 10, 8, 17, 9};//初始前五个数组,若数值(中括号中的)为5个就初始五个。若大括号的数多余五个,则五个后面的都省略或:
int mark[] = {19, 10, 8, 17, 9};//虽然没指定大小,但编译器会知道大小是5更改数组元素中的值:
用赋值号(等于号)
访问元素超过范围:
若定义a[10](即定义了 a[0]~a[9]),但尝试访问了 a[10]呀、a[12]呀等等,就会导致访问错误(栈错误)
数组长度可以使用 sizeof 运算符来获取数组的长度,例如:
int numbers[] = {1, 2, 3, 4, 5};int length = sizeof(numbers) / sizeof(numbers[0]);在 C 语言中,数组名表示数组的地址,即数组首元素的地址。
我们可以使用&运算符来获取数组的地址,如下:
int myArray[5] = {10, 20, 30, 40, 50};int *ptr = &myArray[0]; // 或者直接写作 int *ptr = myArray;在 C 中,数组是非常重要的,我们需要了解更多有关数组的细节。下面列出了 C 程序员必须清楚的一些与数组相关的重要概念:
| 概念 | 描述 |
|---|---|
| 多维数组 | C 支持多维数组。多维数组最简单的形式是二维数组。 |
| 传递数组给函数 | 您可以通过指定不带索引的数组名称来给函数传递一个指向数组的指针。 |
| 从函数返回数组 | C 允许从函数返回数组。 |
| 指向数组的指针 | 您可以通过指定不带索引的数组名称来生成一个指向数组中第一个元素的指针。 |
| 静态数组与动态数组 | 静态数组在编译时分配内存,大小固定,而动态数组在运行时手动分配内存,大小可变。 |
C 语言支持多维数组。多维数组声明的一般形式如下:
type name[size1][size2]...[sizeN];例如,下面的声明创建了一个三维 5 . 10 . 4 整型数组:
int threedim[5][10][4];二位数组:如:a[x][y]; 例:
a[4][3] |
a[x][0] |
a[x][1] |
a[x][2] |
a[x][3] |
|---|---|---|---|---|
a[0][x] |
a[0][0] |
a[0][1] |
a[0][2] |
a[0][3] |
a[1][x] |
a[1][0] |
a[1][1] |
a[1][2] |
a[1][3] |
a[2][x] |
a[2][0] |
a[2][1] |
a[2][2] |
a[2][3] |
三维数组:如:a[x][y][z];
初始二维数组:
int c[2][3] = {{1, 3, 0}, {-1, 5, 9}};int c[][3] = {{1, 3, 0}, {-1, 5, 9}};int c[2][3] = {1, 3, 0, -1, 5, 9};初始三维数组:
int test[2][3][4] = { {{03, 4, 02, 3}, {0, -3, 9, 11}, {23, 12, 23, 2}} , {{13, 4, 56, 3}, {5, 09, 3, 05}, {03, 01, 04, 9}} }; int test[2][3][4] = { {{03, 4, 02, 3}, {0, -3, 9, 11}, {23, 12, 23, 2}} ,
{{13, 4, 56, 3}, {5,09, 3, 05}, {03, 01, 04, 9}} };
// 行是三行排,之前把列与行的定义搞反了// 反正记住二维数组是先竖着多少个,然后横着多少个int main(){ int a[3][4] ={ {1,2,3,4}, {3,4,5,5}, {67,3,9,6} }; for(int i=0;i<3;i++) { for(int j=0;j<4;j++) cout<<a[i][j]<<' '; cout<<endl; } return 0;}// 输出:1 2 3 43 4 5 567 3 9 6例:a[10]
若要传递数组的一部分元素,只要传递“数组加中括号内的数”(传a[1]、a[3]等)
若要传递整个数组,直接传递数组名(传a)
当然,函数的值也要是数组,如float calculateSum(float age[])
若是多维数组,也同理
用指针也可以传递(本身名字就是地址,接收指针就行了)
但是,是不能从函数中返回数组的,除非用指针或结构体
除了以下方法,直接传递数组的地址也可以改变数组的值(当然这就是直接改变而不是返回了)
如果您想要从函数返回一个一维数组,您必须声明一个返回指针的函数,如下:
int * myFunction(){...}另外,C 不支持在函数外返回局部变量的地址,除非定义局部变量为 static 变量。
现在,让我们来看下面的函数,它会生成 10 个随机数,并使用数组来返回它们,具体如下:
#include <stdio.h>#include <stdlib.h>#include <time.h> /* 要生成和返回随机数的函数 */int * getRandom( ){ static int r[10]; int i; /* 设置种子 */ srand( (unsigned)time( NULL ) ); for ( i = 0; i < 10; ++i) { r[i] = rand(); printf( "r[%d] = %d\n", i, r[i]); } return r;} /* 要调用上面定义函数的主函数 */int main (){ /* 一个指向整数的指针 */ int *p; int i; p = getRandom(); for ( i = 0; i < 10; i++ ) { printf( "*(p + %d) : %d\n", i, *(p + i)); } return 0;}当上面的代码被编译和执行时,它会产生下列结果:
r[0] = 313959809r[1] = 1759055877r[2] = 1113101911r[3] = 2133832223r[4] = 2073354073r[5] = 167288147r[6] = 1827471542r[7] = 834791014r[8] = 1901409888r[9] = 1990469526*(p + 0) : 313959809*(p + 1) : 1759055877*(p + 2) : 1113101911*(p + 3) : 2133832223*(p + 4) : 2073354073*(p + 5) : 167288147*(p + 6) : 1827471542*(p + 7) : 834791014*(p + 8) : 1901409888*(p + 9) : 1990469526在 C 语言中,有两种类型的数组:
静态数组的生命周期与作用域相关,而动态数组的生命周期由程序员控制。
在使用动态数组时,需要注意合理地分配和释放内存,以避免内存泄漏和访问无效内存的问题。
一般使用的数组
C++中已经用`
动态数组是在运行时通过动态内存分配函数(如 malloc 和 calloc)手动分配内存的数组。
动态数组特点如下:
malloc、calloc 等函数来申请内存,并使用 free 函数来释放内存。realloc 函数来重新分配内存,并改变数组的大小。动态数组的声明、内存分配和释放实例:
int size = 5;int *dynamicArray = (int *)malloc(size * sizeof(int)); // 动态数组内存分配// 使用动态数组free(dynamicArray); // 动态数组内存释放动态分配的数组,可以在动态分配内存时保存数组长度,并在需要时使用该长度,例如:
int size = 5; // 数组长度int *array = malloc(size * sizeof(int)); // 使用数组 free(array); // 释放内存以上代码我们使用 malloc 函数动态分配了一个整型数组,并将长度保存在变量 size 中。然后可以根据需要使用这个长度进行操作,在使用完数组后,使用 free 函数释放内存。
**注意:**动态数组的使用需要注意内存管理的问题,确保在不再需要使用数组时释放内存,避免内存泄漏和访问无效的内存位置。
以上是一个简单的动态数组使用实例:
#include <stdio.h>#include <stdlib.h> int main() { int size = 5; int *dynamicArray = (int *)malloc(size * sizeof(int)); // 动态数组内存分配 if (dynamicArray == NULL) { printf("Memory allocation failed.\n"); return 1; } printf("Enter %d elements: ", size); for (int i = 0; i < size; i++) { scanf("%d", &dynamicArray[i]); } printf("Dynamic Array: "); for (int i = 0; i < size; i++) { printf("%d ", dynamicArray[i]); } printf("\n"); free(dynamicArray); // 动态数组内存释放 return 0;}以上实例中,我们首先声明了一个变量 size 来指定动态数组的大小。
然后使用 malloc 函数为动态数组分配内存,并通过 sizeof 运算符计算所需的内存大小。
接下来,通过循环和 scanf 函数,从用户输入中读取元素值并存储到动态数组中。
最后,使用循环遍历并打印动态数组的元素。在程序结束时,使用 free 函数释放动态数组所占用的内存。
请注意,在使用动态数组时,需要检查内存分配是否成功(即 dynamicArray 是否为 NULL),以避免在内存分配失败时发生错误。
enum)枚举类型是 int 整数常量的数据类型
enum 名称 //这个名称又称变量的蓝图{ 第一个选项, 第二个选项, 第三个选项//默认每个选项的值为从小到大,从0,1,2,...开始排//但可以人为定义,如对于第二个选项club:“club=0,”};//和结构体一样, enum boolean {false, true}; enum boolean check; // 声明一个枚举变量//或 enum boolean {false, true} check;#include <stdio.h> enum week {Sunday, Monday, Tuesday, Wednesday, Thursday, Friday, Saturday}; int main(){ //创建枚举week类型的today变量 enum week today; today = Wednesday; printf("Day %d",today+1); return 0;}让维护性和可读性提高,文字总比数字清晰呀
可以通过以下三种方式来定义枚举变量
1、定义类型+后定义变量
enum DAY{ MON=1, TUE, WED, THU, FRI, SAT, SUN};enum DAY day;2、定义类型+变量
enum DAY{ MON=1, TUE, WED, THU, FRI, SAT, SUN} day;3、省略枚举名称,直接定义枚举变量
enum{ MON=1, TUE, WED, THU, FRI, SAT, SUN} day;可以使用 for switch 来使用枚举,但如果它对应的数值不是连续的,就不可以用 for
实例
#include <stdio.h>#include <stdlib.h> int main(){ enum day { saturday, sunday, monday, tuesday, wednesday, thursday, friday } workday; int a = 1; enum day weekend; weekend = ( enum day ) a; //类型转换 //weekend = a; //错误 printf("weekend:%d",weekend); return 0;}// 输出:weekend:1指针是 C 语言和 C++中强大的功能 (ptr:pointer:指针)
对于变量 a,则用&a 给 a 赋予一个地址
(取址符&用于获取变量的地址,并返回指向该对象变量的指针)
指针(指针变量)是用于储存地址而非值的特殊变量
(用于储存别的小房子的门牌号而非小房子中的数的小房子,所以指针也可以储存指针)
指针语法:
int *ptr1, *ptr2;int* p; int *p;//int* p1, p2;声明的是一个指针p1和一个普通变量p2int *a,b=5; a=&b; //记住这第二个a没有星号int c; c=*a; //c的值就是5了//星号*相当于让程序获取地址指向的小房子的值而非地址的值*a=10; 或b=10; //这时b的值为10了//几种错误用法:int c, *pc;pc = c; //pc是地址,但c不是*pc = &c; //&c是地址,但* pc不是pc = &c; //&c和pc都是地址*pc = c; //c和*pc值 //但这样是可以的:int *p = &c; //这相当于:int *p;p = &c; //所以,为了避免这种情况,我们常用:int* p=&c;数组是一个顺序数据块
其中,a[n]的数组中,a与a[0]的地址相等,因为变量名x指向数组的第一个元素,即x[0]
所以,x[i]的地址等于x+i的
即&x[i]等同于x+i ; x[i]等同于*(x+i)。
例:
#include <stdio.h> //运行该程序时,输出为:int main() //输入6个数字: 2 3 4 4 12 4{ //总和 = 29 int i, x[6], sum = 0; printf("输入6个数字:"); for( =0;i<6 ++i) { scanf("%d", x+i); //等效于scanf("%d", &x[i]); sum += *(x+i); //等同于 sum += x[i] } printf("总和 = %d", sum); return 0;}例:
#include <stdio.h> //运行该程序时,输出为:int main() //*ptr = 3{ //*(ptr+1) = 4 int x[5] = {1,2,3,4,5}; //*(ptr-1) = 2 int* ptr;*(ptr-1) = 2 ptr = &x[2]; //ptr被分配了第三个元素的地址 printf("*ptr = %d \n", *ptr); //3 printf("*(ptr+1) = %d \n", *(ptr+1)); //4 printf("*(ptr-1) = %d", *(ptr-1)); //2 return 0;}所以说,*(x-i)也可以
将地址作为参数传递给函数,有叫“引用调用”
在主函数中的函数中用&x,在函数中接收*x
如:
#include<stdio.h> void aaaaa(int *n1){ printf("%d",*n1);} int main(){ int num1=5; aaaaa( &num1); return 0;} 输出为:5这个就是直接传递地址
如:
#include<stdio.h> void aaaaa(int *n1){ printf("%d",*n1);} int main(){ int num1=5; int* p=&num1; aaaaa( p); return 0;} 输出为:5这个就是传递指针变量
sizeof()运输符sizeof(size of:~的大小)
用于获取变量,数据类型,数组的大小(以字节为单位)
如:
int a=sizeof(x);printf(“%d”, sizeof(int) );sizeof(a[10]);注意:输出在不同的机器上可能会有所不同,例如在 32 位操作系统上将显示不同的输出,在 64 位操作系统上将显示相同数据类型的不同输出。
void指针指向void的指针便是可以指向任何数据类型的通用指针
因此可以将任何数据类型的地址分配给void指针,并且可以将void指针分配给任何类 型的指针,而无需执行任何显式的类型转换。
malloc和relloc函数返回的指针都是void*类型
由于void指针没有指定的类型信息,因此在使用它时需要进行类型转换,以确保正确地访问指针所指向的内存内容。如可以用(int*等等强制转换)
当使用void指针访问内存时需要小心类型错误和越界访问等问题。
为什么我们使用void指针?
如果函数需要接受多种类型的指针作为参数,可以使用 void 指针来实现
例:
#include<stdio.h>int main() //输出结果:{ //a的值为 : 56 int a=56; //初始化一个整数变量'a'。 //b的值为 : 4.500000 float b=4.5; //浮点变量'b'的初始化。 //c的值为 : k char c='k'; //字符变量'c'的初始化。 void *ptr; //声明空指针。 //为变量“a”分配地址。 ptr=&a; printf("a的值为 : %d",*((int*)ptr)); //为变量'b'分配地址。 ptr=&b; printf("\nb的值为 : %f",*((float*)ptr)); //为变量'c'分配地址。 ptr=&c; printf("\n c的值为 : %c",*((char*)ptr)); return 0;}132312123312
在 C 中,有很多指针相关的概念,这些概念都很简单,但是都很重要。下面列出了 C 程序员必须清楚的一些与指针相关的重要概念:
| 概念 | 描述 |
|---|---|
| 指针的算术运算 | 可以对指针进行四种算术运算:++、--、+、- |
| 指针比较 | 可以使用== > <等符号来比较 |
| 指向指针的指针 | C 允许指向指针的指针。 |
| 传递指针给函数 | 通过引用或地址传递参数,使传递的参数在调用函数中被改变。 |
| 从函数返回指针 | C 允许函数返回指针到局部变量、静态变量和动态内存分配。 |
指向指针的指针是一种多级间接寻址的形式,或者说是一个指针链。通常,一个指针包含一个变量的地址。当我们定义一个指向指针的指针时,第一个指针包含了第二个指针的地址,第二个指针指向包含实际值的位置。
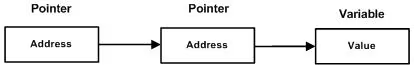
一个指向指针的指针变量必须如下声明,即在变量名前放置两个星号。例如,下面声明了一个指向 int 类型指针的指针:
int **var;当一个目标值被一个指针间接指向到另一个指针时,访问这个值需要使用两个星号运算符,如下面实例所示:
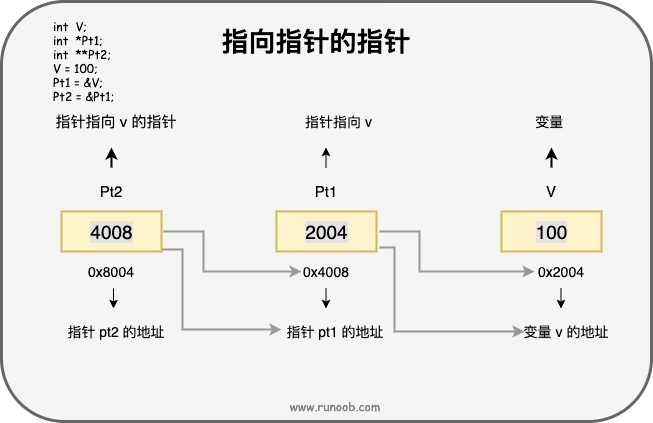
#include <stdio.h> int main (){ int V; int *Pt1; int **Pt2; V = 100; /* 获取 V 的地址 */ Pt1 = &V; /* 使用运算符 & 获取 Pt1 的地址 */ Pt2 = &Pt1; /* 使用 pptr 获取值 */ printf("var = %d\n", V ); printf("Pt1 = %p\n", Pt1 ); printf("*Pt1 = %d\n", *Pt1 ); printf("Pt2 = %p\n", Pt2 ); printf("**Pt2 = %d\n", **Pt2); return 0;}当上面的代码被编译和执行时,它会产生下列结果:
var = 100Pt1 = 0x7ffee2d5e8d8*Pt1 = 100Pt2 = 0x7ffee2d5e8d0**Pt2 = 100C 语言允许您传递指针给函数,只需要简单地声明函数参数为指针类型即可。
下面的实例中,我们传递一个无符号的 long 型指针给函数,并在函数内改变这个值:
#include <stdio.h>#include <time.h> void getSeconds(unsigned long *par); int main (){ unsigned long sec; getSeconds( &sec ); /* 输出实际值 */ printf("Number of seconds: %ld\n", sec ); return 0;} void getSeconds(unsigned long *par){ /* 获取当前的秒数 */ *par = time( NULL ); return;}当上面的代码被编译和执行时,它会产生下列结果:
Number of seconds :1294450468能接受指针作为参数的函数,也能接受数组作为参数,如下所示:
#include <stdio.h> /* 函数声明 */double getAverage(int *arr, int size); int main (){ /* 带有 5 个元素的整型数组 */ int balance[5] = {1000, 2, 3, 17, 50}; double avg; /* 传递一个指向数组的指针作为参数 */ avg = getAverage( balance, 5 ) ; /* 输出返回值 */ printf("Average value is: %f\n", avg ); return 0;} double getAverage(int *arr, int size){ int i, sum = 0; double avg; for (i = 0; i < size; ++i) { sum += arr[i]; } avg = (double)sum / size; return avg;}当上面的代码被编译和执行时,它会产生下列结果:
Average value is: 214.40000在上一章中,我们已经了解了 C 语言中如何从函数返回数组,类似地,C 允许您从函数返回指针。为了做到这点,您必须声明一个返回指针的函数,如下所示:
int * myFunction(){...}另外,C 语言不支持在调用函数时返回局部变量的地址,除非定义局部变量为 static 变量。
现在,让我们来看下面的函数,它会生成 10 个随机数,并使用表示指针的数组名(即第一个数组元素的地址)来返回它们,具体如下:
#include <stdio.h>#include <time.h>#include <stdlib.h> /* 要生成和返回随机数的函数 */int * getRandom( ){ static int r[10]; int i; /* 设置种子 */ srand( (unsigned)time( NULL ) ); for ( i = 0; i < 10; ++i) { r[i] = rand(); printf("%d\n", r[i] ); } return r;} /* 要调用上面定义函数的主函数 */int main (){ /* 一个指向整数的指针 */ int *p; int i; p = getRandom(); for ( i = 0; i < 10; i++ ) { printf("*(p + [%d]) : %d\n", i, *(p + i) ); } return 0;}当上面的代码被编译和执行时,它会产生下列结果:
15231980531187214107110830097843049495914213012769309710841232504841069321401604461820149169022*(p + [0]) : 1523198053*(p + [1]) : 1187214107*(p + [2]) : 1108300978*(p + [3]) : 430494959*(p + [4]) : 1421301276*(p + [5]) : 930971084*(p + [6]) : 123250484*(p + [7]) : 106932140*(p + [8]) : 1604461820*(p + [9]) : 149169022函数指针是指向函数的指针变量。
通常我们说的指针变量是指向一个整型、字符型或数组等变量,而函数指针是指向函数。
函数指针可以像一般函数一样,用于调用函数、传递参数。
函数指针变量的声明:
typedef int (*fun_ptr)(int,int); // 声明一个指向同样参数、返回值的函数指针类型以下实例声明了函数指针变量 p,指向函数 max:
#include <stdio.h> int max(int x, int y){ return x > y ? x : y;} int main(void){ /* p 是函数指针 */ int (* p)(int, int) = & max; // &可以省略 int a, b, c, d; printf("请输入三个数字:"); scanf("%d %d %d", & a, & b, & c); /* 与直接调用函数等价,d = max(max(a, b), c) */ d = p(p(a, b), c); printf("最大的数字是: %d\n", d); return 0;}编译执行,输出结果如下:
请输入三个数字:1 2 3最大的数字是: 3函数指针变量可以作为某个函数的参数来使用的,回调函数就是一个通过函数指针调用的函数。
简单讲:回调函数是由别人的函数执行时调用你实现的函数。
以下是来自知乎作者常溪玲的解说:
你到一个商店买东西,刚好你要的东西没有货,于是你在店员那里留下了你的电话,过了几天店里有货了,店员就打了你的电话,然后你接到电话后就到店里去取了货。在这个例子里,你的电话号码就叫回调函数,你把电话留给店员就叫登记回调函数,店里后来有货了叫做触发了回调关联的事件,店员给你打电话叫做调用回调函数,你到店里去取货叫做响应回调事件。
实例中 populate_array() 函数定义了三个参数,其中第三个参数是函数的指针,通过该函数来设置数组的值。
实例中我们定义了回调函数 getNextRandomValue(),它返回一个随机值,它作为一个函数指针传递给 populate_array() 函数。
populate_array() 将调用 10 次回调函数,并将回调函数的返回值赋值给数组。
#include <stdlib.h>#include <stdio.h> void populate_array(int *array, size_t arraySize, int (*getNextValue)(void)){ for (size_t i=0; i<arraySize; i++) array[i] = getNextValue();} // 获取随机值int getNextRandomValue(void){ return rand();} int main(void){ int myarray[10]; /* getNextRandomValue 不能加括号,否则无法编译,因为加上括号之后相当于传入此参数时传入了 int , 而不是函数指针*/ populate_array(myarray, 10, getNextRandomValue); for(int i = 0; i < 10; i++) { printf("%d ", myarray[i]); } printf("\n"); return 0;}编译执行,输出结果如下:
16807 282475249 1622650073 984943658 1144108930 470211272 101027544 1457850878 1458777923 2007237709C 语言中,字符串是以null字符(即字符\0)结尾(\0的 ASCII 码为0)
char s[5]; //就是声明一个有五个字符的字符串,包括“\0”char c[] = "abcd";char c[50] = "abcd";char c[] = {'a','b','c','d','\0'};char c[5] = {'a','b','c','d','\0'};//若输入char c[4] = "abcd";则会数据溢出C 语言中不支持用赋值运算符(等于号)赋值
但可以用 strcpy,ctrncpy 来复制字符串
用scanf():
char name[20];scanf(“%s”,name);//当读到空格(空格,换行符,制表符等)就不读了若要读一整行,用fgets(),并可以用puts(),printf(“%s”,str)来显示字符串
也可以用gets(),但可能让数据溢出,所以不推荐使用(现已被删除)
fgets() (get string from file:从文件中获取字符串)
语法:
fgets(str, sizeof(str), stdin);puts() (puts: 字符串输出)
语法:
put (str);//它在输出后会返回”字符+\0”的数目,即字符数+1如:
char str[] = "Hello,world!";int count = puts(str); //count=13像数组一样直接传(即直接传字符串名字),接收时也像数组一样用str[]
如:
hanshu(char str[];)类似数组,字符串名字就是指针,用法也和数组一样
C 中有大量操作字符串的函数:
| 序号 | 函数 & 目的 |
|---|---|
| 1 | strcpy(s1, s2); 复制字符串 s2 到字符串 s1。 |
| 2 | strcat(s1, s2); 连接字符串 s2 到字符串 s1 的末尾。 |
| 3 | strlen(s1); 返回字符串 s1 的长度。 |
| 4 | strcmp(s1, s2); 如果 s1 和 s2 是相同的,则返回 0;如果 s1<s2 则返回小于 0;如果 s1>s2 则返回大于 0。 |
| 5 | strchr(s1, ch); 返回一个指针,指向字符串 s1 中字符 ch 的第一次出现的位置。 |
| 6 | strstr(s1, s2); 返回一个指针,指向字符串 s1 中字符串 s2 的第一次出现的位置。 |
strlwr() 将字符串转换为小写strupr() 将字符串转换为大写C 语言结构体:
结构是 C 语言中另一种用户自定义的一种数据类型,可用于储存不同数据类型的数据
定义结构:
要用 struct 关键字,使用方法如下:
语法:
一、 | 二、struct 结构体名称 | struct 结构体名称{ | { 数据类型 成员1; | 数据类型 成员1; 数据类型 成员2; | 数据类型 成员2; // ... | // ...}; | }变量名1,变量名2;//这是只声明有一个叫“结构体名称” | //这是同时声明结构体与变量//之后才声明一个叫xxx的结构体变量 |struct 结构体名称 变量名1, 变量名2;|当然结构体中可以嵌套结构体,或指向自己的指针
嵌套结构体用于如:
可能需要在结构中存储实体员工的地址。而地址也可以包含其他信 息,例如街道编号,城市,地区和密码。
如下使用方法:
//此结构体的声明包含了其他的结构体 | 或以下,等方法struct COMPLEX | struct Employee{ | { char string[100]; | int id; struct SIMPLE a; | char name[20];}; | struct Date | {/*此结构体的声明包含了指向自己类型的指针*/| int dd;struct NODE | int mm;{ | int yyyy; char string[100]; | }doj; struct NODE *next_node; | }e1;}; |如果两个结构体相互包含,则要对其中一个结构体进行不完整声明
如:
struct B; //对结构体B进行不完整声明 //结构体A中包含指向结构体B的指针struct A{ struct B *partner; //通过此方法创建结构体指针 //other members;}; //结构体B中包含指向结构体A的指针,在A声明完后,B也随之进行声明struct B{ struct A *partner; //other members;};有点像数组的方法
#include <stdio.h>struct Books{ char title[50]; char author[50]; char subject[100]; int book_id;} book = {"C 语言", "nhooo", "编程语言", 123456};int main(){//若要在函数中声明,按如下来//struct Books book = {"C语言","nhooo","编程语言",123456}; printf(...);}为了访问结构成员,要使用“成员访问运算符(.)”(就是一个英文句号)
使用方法:
结构体变量名+.+成员名
这样就可以访问其中的成员了
#include <stdio.h>#include <string.h>struct Books{ char title[50]; char author[50]; char subject[100]; int book_id;};int main( ){//方法一: struct Books Book[2];/* 声明 Book数组,类型为 Books */ /* Book 详述 */ strcpy( Book[1].title, "C语言"); strcpy( Book[1].author, "Nuha Ali"); strcpy( Book[1].subject, "C语言教程"); Book1.book_id = 6495407; strcpy( Book[2].title, "JAVA语言"); strcpy( Book[2].author, "Seagull Ali"); strcpy( Book[2].subject, "JAVA语言教程"); Book[2].book_id = 6495700; //或者: struct Books Book[2]= { {"C语言", "Nuha Ali", "C语言教程",6495407}, {"JAVA语言", "Seagull Ali", "JAVA语言教程",6495700}; return 0;}如:
void printBook( struct Books book ){......};int main(){struct Books Book1;printBook( Book1 );}指向结构的指针:
定义方法与其他类型相似
如:
//复用的是上上个的代码struct Books *sp; //定义指针变量sp = &Book1; //赋予结构体Book1的地址sp->title; //让指针访问Book1中的”title”这个成员使用“->”运算符访问结构体中的成员,如上
例:
printBook( &Book1 ); //主函数中传递地址 void printBook( struct Books *book ) //定义指针并接受地址{ printf( "Book 书名: %s\n", book->title); printf( "Book 编号: %d\n", book->book_id);}又叫“位段”,是一种在结构体中以位为单位分配存储空间的特性,用于节省空间
struct 位域结构名{ 类型说明符 位域名:位域长度;}如:
struct bs{ int a:8; // 占8个位(位(bit),一般8个位一字节(byte)) int b:2; // 占2个位 int c:6; // 占6个位}data; //data变量,共占两个字节(8+2+6=16)一个位域存储在同一个字节中,如一个字节所剩空间不够存放另一位域时,则会从下一单元起存放该位域。也可以有意使某位域从下一单元开始。例如:
struct bs{ unsigned a:4; unsigned :4; /* 空域 或叫 无名位域,只用来作填充或调整位置,是不能使用的 */ unsigned b:5; /* 从下一单元开始存放 */ unsigned c:3;}在这个位域定义中,a 占第一字节的 4 位,后 4 位填 0 表示不使用,b 从第二字节开始,占用 5 位,c 占用 3 位。
由于位域不允许跨两个字节(最长为 8 位,一个字节),如unsigned int flag3 : 10;占 10 各位就不行,因为可能发生溢出错误
从以上分析可以看出,位域在本质上就是一种结构类型,不过其成员是按二进位分配的。
如:
int main(){ struct bs{ unsigned a:1; unsigned b:3; unsigned c:4; } bit,*pbit; bit.a=1; /* 给位域赋值(应注意赋值不能超过该位域的允许范围) */ bit.b=7; /* 给位域赋值(应注意赋值不能超过该位域的允许范围) */ bit.c=15; /* 给位域赋值(应注意赋值不能超过该位域的允许范围) */ printf("%d,%d,%d\n",bit.a,bit.b,bit.c); /* 以整型量格式输出三个域的内容 */ pbit=&bit; /* 把位域变量 bit 的地址送给指针变量 pbit */ pbit->a=0; /* 用指针方式给位域 a 重新赋值,赋为 0 */ pbit->b&=3; /* 使用了复合的位运算符 "&=",相当于:pbit->b=pbit->b&3,位域 b 中原有值为 7,与 3 作按位与运算的结果为 3(111&011=011,十进制值为 3) */ pbit->c|=1; /* 使用了复合位运算符"|=",相当于:pbit->c=pbit->c|1,其结果为 15 */ printf("%d,%d,%d\n",pbit->a,pbit->b,pbit->c); /* 用指针方式输出了这三个域的值 */}//上例程序中定义了位域结构 bs,三个位域为 a、b、c。说明了 bs 类型的变量 bit 和指向 bs 类型的指针变量 pbit。这表示位域也是可以使用指针的主要用于简化结构的语法
如下:
struct Distance{ | typedef struct Distance{ int feet; | int feet; float inch; 等同于 | float inch;}; | } distances; |int main(){ | int main(){ struct Distance d1, d2; | distances d1, d2;} | }结构嵌套结构:
struct complex{ int imag; float real;}; struct number{ struct complex comp; int integers;} num1, num2;若要设置 num2 的变量 imag 值为 11,可如下做:
num2.comp.imag = 11;创建指针,分配内存与其他的变量一样,用变量名
从函数中返回结构就直接“return 结构变量名”即可
或通过引用的方法(传递地址接收指针)
共用体又称联合体,和结构体共同属于 C 语言数据类型中的结构类型
union car{ char name[50]; //名字 int price; //价格};union car{……}; int main(){ union car car1,car2,*car3;//创建变量car1,car2,和指针car3}对于 car1 的价格(price),用car1.price
对于 car3 的价格(price),用(*car3).price 或 car3->price
注:结构体的指针同理这两种方法,但->更常用一些
结构体的内存是所有的总和,而共用体是取最大的那个
因为共用体是所有数据类型都共用一块内存空间,而结构体是每一种用一块空间
也因此,更改共用体中的一种数据,另一种也会更改
比如:
#include <stdio.h> union Data { int num; char letter;}; int main() { union Data data; data.num = 65; printf("Letter: %c\n", data.letter); //输出“A” 此时num=65 lettere=”A” data.letter = 'B'; printf("Number: %d\n", data.num); //输出“66”此时num=66 lettere=”B” return 0;}更改整数,浮点数,字符等的数据类型呀
在嵌入式系统中,更方便的操作硬件寄存器
等等
当然,我们也可以将 typedef 用于共用体,或者指针等等
结构体和共用体也可以用数组,如下:
#include <stdio.h>#include <strings.h>// 定义一个包含不同类型的共用体union Data { int i; float f; char str[20]; };int main() { // 定义一个共用体数组 union Data dataArr[3]; // 第一个元素为整数 dataArr[0].i = 10; printf("dataArr[0].i = %d\n", dataArr[0].i); // 第二个元素为浮点数 dataArr[1].f = 3.14; printf("dataArr[1].f = %.2f\n", dataArr[1].f); // 第三个元素为字符串 strcpy(dataArr[2].str, "Hello"); printf("dataArr[2].str = %s\n", dataArr[2].str); return 0;} //在vscode中调试一下就知道了共用体也像结构体一样可以嵌套,如下:
#include <stdio.h>// 定义一个嵌套共用体union InnerData { int i; float f; };// 定义一个外部共用体,其中包含嵌套共用体作为成员之一union OuterData { char c; union InnerData inner; };int main() { // 定义一个外部共用体变量 union OuterData data; // 使用嵌套共用体的成员 data.c = 'A'; printf("data.c = %c\n", data.c); data.inner.i = 10; printf("data.inner.i = %d\n", data.inner.i); data.inner.f = 3.14; printf("data.inner.f = %.2f\n", data.inner.f); return 0;} //同上试试就知道了C 语言的位域(bit-field)是一种特殊的结构体成员,允许我们按位对成员进行定义,指定其占用的位数。
如果程序的结构中包含多个开关的变量,即变量值为 TRUE/FALSE,如下:
struct{ unsigned int widthValidated; unsigned int heightValidated;} status;这种结构需要 8 字节的内存空间,但在实际上,在每个变量中,我们只存储 0 或 1,在这种情况下,C 语言提供了一种更好的利用内存空间的方式。如果您在结构内使用这样的变量,您可以定义变量的宽度来告诉编译器,您将只使用这些字节。例如,上面的结构可以重写成:
struct{ unsigned int widthValidated : 1; unsigned int heightValidated : 1;} status;现在,上面的结构中,status 变量将占用 4 个字节的内存空间,但是只有 2 位被用来存储值。如果您用了 32 个变量,每一个变量宽度为 1 位,那么 status 结构将使用 4 个字节,但只要您再多用一个变量,如果使用了 33 个变量,那么它将分配内存的下一段来存储第 33 个变量,这个时候就开始使用 8 个字节。让我们看看下面的实例来理解这个概念:
#include <stdio.h>#include <string.h> /* 定义简单的结构 */struct{ unsigned int widthValidated; unsigned int heightValidated;} status1; /* 定义位域结构 */struct{ unsigned int widthValidated : 1; unsigned int heightValidated : 1;} status2; int main( ){ printf( "Memory size occupied by status1 : %d\n", sizeof(status1)); printf( "Memory size occupied by status2 : %d\n", sizeof(status2)); return 0;}当上面的代码被编译和执行时,它会产生下列结果:
Memory size occupied by status1 : 8Memory size occupied by status2 : 4位域的特点和使用方法如下:
int、unsigned int、signed int 等整数类型,也可以是枚举类型。.)来实现的,与普通的结构体成员访问方式相同。有些信息在存储时,并不需要占用一个完整的字节,而只需占几个或一个二进制位。例如在存放一个开关量时,只有 0 和 1 两种状态,用 1 位二进位即可。为了节省存储空间,并使处理简便,C 语言又提供了一种数据结构,称为"位域"或"位段"。
所谓"位域"是把一个字节中的二进位划分为几个不同的区域,并说明每个区域的位数。每个域有一个域名,允许在程序中按域名进行操作。这样就可以把几个不同的对象用一个字节的二进制位域来表示。
典型的实例:
位域定义与结构定义相仿,其形式为:
struct 位域结构名{ 位域列表 };其中位域列表的形式为:
type [member_name] : width ;下面是有关位域中变量元素的描述:
| 元素 | 描述 |
|---|---|
| type | 只能为 int(整型),unsigned int(无符号整型),signed int(有符号整型) 三种类型,决定了如何解释位域的值。 |
| member_name | 位域的名称。 |
| width | 位域中位的数量。宽度必须小于或等于指定类型的位宽度。 |
带有预定义宽度的变量被称为位域。位域可以存储多于 1 位的数,例如,需要一个变量来存储从 0 到 7 的值,您可以定义一个宽度为 3 位的位域,如下:
struct{ unsigned int age : 3;} Age;上面的结构定义指示 C 编译器,age 变量将只使用 3 位来存储这个值,如果您试图使用超过 3 位,则无法完成。
struct bs{ int a:8; int b:2; int c:6;}data;以上代码定义了一个名为 struct bs 的结构体,data 为 bs 的结构体变量,共占四个字节:
对于位域来说,它们的宽度不能超过其数据类型的大小,在这种情况下,int 类型的大小通常是 4 个字节(32 位)。
相邻位域字段的类型相同,且其位宽之和小于类型的 sizeo f 大小,则后面的字段将紧邻前一个字段存储,直到不能容纳为止。
让我们再来看一个实例:
struct packed_struct { unsigned int f1:1; unsigned int f2:1; unsigned int f3:1; unsigned int f4:1; unsigned int type:4; unsigned int my_int:9;} pack;以上代码定义了一个名为 packed_struct 的结构体,其中包含了六个成员变量,pack 为 packed_struct 的结构体变量。
在这里,packed_struct 包含了 6 个成员:四个 1 位的标识符 f1..f4、一个 4 位的 type 和一个 9 位的 my_int。
让我们来看下面的实例:
#include <stdio.h> struct packed_struct { unsigned int f1 : 1; // 1位的位域 unsigned int f2 : 1; // 1位的位域 unsigned int f3 : 1; // 1位的位域 unsigned int f4 : 1; // 1位的位域 unsigned int type : 4; // 4位的位域 unsigned int my_int : 9; // 9位的位域}; int main() { struct packed_struct pack; pack.f1 = 1; pack.f2 = 0; pack.f3 = 1; pack.f4 = 0; pack.type = 7; pack.my_int = 255; printf("f1: %u\n", pack.f1); printf("f2: %u\n", pack.f2); printf("f3: %u\n", pack.f3); printf("f4: %u\n", pack.f4); printf("type: %u\n", pack.type); printf("my_int: %u\n", pack.my_int); return 0;}以上实例定义了一个名为 packed_struct 的结构体,其中包含了多个位域成员。
在 main 函数中,创建了一个 packed_struct 类型的结构体变量 pack,并分别给每个位域成员赋值。
然后使用 printf 语句打印出每个位域成员的值。
输出结果为:
f1: 1f2: 0f3: 1f4: 0type: 7my_int: 255#include <stdio.h> struct example1 { int a : 4; int b : 5; int c : 7;}; int main() { struct example1 ex1; printf("Size of example1: %lu bytes\n", sizeof(ex1)); return 0;}当上面的代码被编译时,它会带有警告,当上面的代码被执行时,它会产生下列结果:
Sizeof( Age ) : 4Age.age : 4Age.age : 7Age.age : 0计算字节数:
#include <stdio.h> struct example1 { int a : 4; int b : 5; int c : 7;}; int main() { struct example1 ex1; printf("Size of example1: %lu bytes\n", sizeof(ex1)); return 0;}以上实例中,example1 结构体包含三个位域成员 a,b 和 c,它们分别占用 4 位、5 位和 7 位。
通过 sizeof 运算符计算出 example1 结构体的字节数,并输出结果:
Size of example1: 4 bytes对于位域的定义尚有以下几点说明:
一个位域存储在同一个字节中,如一个字节所剩空间不够存放另一位域时,则会从下一单元起存放该位域。也可以有意使某位域从下一单元开始。例如:
struct bs{ unsigned a:4; unsigned :4; /* 空域 */ unsigned b:4; /* 从下一单元开始存放 */ unsigned c:4}在这个位域定义中,a 占第一字节的 4 位,后 4 位填 0 表示不使用,b 从第二字节开始,占用 4 位,c 占用 4 位。
位域的宽度不能超过它所依附的数据类型的长度,成员变量都是有类型的,这个类型限制了成员变量的最大长度,: 后面的数字不能超过这个长度。
位域可以是无名位域,这时它只用来作填充或调整位置。无名的位域是不能使用的。例如:
struct k{ int a:1; int :2; /* 该 2 位不能使用 */ int b:3; int c:2;};从以上分析可以看出,位域在本质上就是一种结构类型,不过其成员是按二进位分配的。
位域的使用和结构成员的使用相同,其一般形式为:
位域变量名.位域名位域变量名->位域名位域允许用各种格式输出。
请看下面的实例:
#include <stdio.h> int main(){ struct bs{ unsigned a:1; unsigned b:3; unsigned c:4; } bit,*pbit; bit.a=1; /* 给位域赋值(应注意赋值不能超过该位域的允许范围) */ bit.b=7; /* 给位域赋值(应注意赋值不能超过该位域的允许范围) */ bit.c=15; /* 给位域赋值(应注意赋值不能超过该位域的允许范围) */ printf("%d,%d,%d\n",bit.a,bit.b,bit.c); /* 以整型量格式输出三个域的内容 */ pbit=&bit; /* 把位域变量 bit 的地址送给指针变量 pbit */ pbit->a=0; /* 用指针方式给位域 a 重新赋值,赋为 0 */ pbit->b&=3; /* 使用了复合的位运算符 "&=",相当于:pbit->b=pbit->b&3,位域 b 中原有值为 7,与 3 作按位与运算的结果为 3(111&011=011,十进制值为 3) */ pbit->c|=1; /* 使用了复合位运算符"|=",相当于:pbit->c=pbit->c|1,其结果为 15 */ printf("%d,%d,%d\n",pbit->a,pbit->b,pbit->c); /* 用指针方式输出了这三个域的值 */}上例程序中定义了位域结构 bs,三个位域为 a、b、c。说明了 bs 类型的变量 bit 和指向 bs 类型的指针变量 pbit。这表示位域也是可以使用指针的。
C 语言提供了 typedef 关键字,您可以使用它来为类型取一个新的名字。下面的实例为单字节数字定义了一个术语 BYTE:
typedef unsigned char BYTE;在这个类型定义之后,标识符 BYTE 可作为类型 unsigned char 的缩写,例如:
BYTE b1, b2;按照惯例,定义时会大写字母,以便提醒用户类型名称是一个象征性的缩写,但您也可以使用小写字母,如下:
typedef unsigned char byte;您也可以使用 typedef 来为用户自定义的数据类型取一个新的名字。例如,您可以对结构体使用 typedef 来定义一个新的数据类型名字,然后使用这个新的数据类型来直接定义结构变量,如下:
#include <stdio.h>#include <string.h> typedef struct Books{ char title[50]; char author[50]; char subject[100]; int book_id;} Book; int main( ){ Book book; strcpy( book.title, "C 教程"); strcpy( book.author, "Runoob"); strcpy( book.subject, "编程语言"); book.book_id = 12345; printf( "书标题 : %s\n", book.title); printf( "书作者 : %s\n", book.author); printf( "书类目 : %s\n", book.subject); printf( "书 ID : %d\n", book.book_id); return 0;}当上面的代码被编译和执行时,它会产生下列结果:
书标题 : C 教程书作者 : Runoob书类目 : 编程语言书 ID : 12345#define 是 C 指令,用于为各种数据类型定义别名,与 typedef 类似,但是它们有以下几点不同:
下面是 #define 的最简单的用法:
#include <stdio.h> #define TRUE 1#define FALSE 0 int main( ){ printf( "TRUE 的值: %d\n", TRUE); printf( "FALSE 的值: %d\n", FALSE); return 0;}当上面的代码被编译和执行时,它会产生下列结果:
TRUE 的值: 1FALSE 的值: 0(I/O)是“输入/输出”的缩写
C 语言提供了一系列内置的函数来输入输出
标准文件(Standard Files)是指与程序进行输入输出交互的三个流对象,即标准输入(stdin)、标准输出(stdout)和标准错误(stderr)。这些流对象被定义为 C 标准库中的全局变量,并通过相应的流对象来进行读取和写入操作。
文件指针是访问文件的方式,本节将讲解如何从键盘上读取值以及如何把结果输出到屏幕上。
通常使用 printf() 和 scanf()
scanf() 函数用于从标准输入(键盘)读取并格式化,
printf() 函数发送格式化输出到标准输出(屏幕)。
格式化:
printf()(print 打印;输出)
//头文件,用于引入外部库 [炒菜工具]#include<iostream>//主函数(main 主要的)[炒菜动作]int main() //可以被解释为“最后返回一个整数”的意思{ //用于输出语句 printf("I love Sakurakugu"); //返回一个0,说明程序正常运行结束,它是可选的 return 0;}printf("Number = %d", testInteger);//引号内的%d将替换为testInteger的值输出浮点数:
要打印float,我们使用%f格式说明符。同样,我们还是要了%lf打印double值。
(注:lf=long float)
输出字符:
要打印 char,我们使用%c 格式说明符。
scanf()(scan 扫描;输入(一定不要忘记加&))
输入整数:scanf("%d", &a);
其中的&是取址符,
用于获取小房子 a 的地址,让scanf以%d(int格式)将输入储存进去
输入浮点数:
float 和 double 我们分别使用%f和%lf格式说明符
当然%lf也可以用于float的输入输出
输入字符:
用%c 格式说明符
字符本身不会被存储。而是存储一个整数值(ASCII 值)。
当我们使用%c,将显示输入的字符。如果用%d,则将其 ASCII 值打印出来。
输入多个值:
scanf("%d%f", &a, &b); //输入整数a、浮点数bscanf("%d %f", &a, &b); //输入整数a、空格、浮点数b| 转换说明 | 输 出 | 转换说明 | 输 出 |
|---|---|---|---|
| %a | 浮点数、十六进制数字和 p-记数法 (C99) | %G | 根据数值不同自动选择%f 或者%E。%E 格式在指数小于-4 或者大于等于精度时使用 |
| %A | 浮点数、十六进制数字和 P-记数法 (C99) | %i | 有符号十进制整数 (与%d 相同) |
| %c | 一个字符 | %o | 无符号八进制整数 |
| %d | 有符号十进制整数 | %p | 指针(就是指地址) |
| %e | 浮点数、e-记数法 | %s | 字符串 |
| %E | 浮点数、E-记数法 | %u | 无符号十进制整数 |
| %f | 浮点数,十进制记数法 | %x | 使用十六进制数字 0f 的无符号十六进制整数 |
| %g | 根据数值不同自动选择%f 或者%e。%e 格式在指数小于-4 或者大于等于精度时使用 | %X | 使用十六进制数字 0F 的无符号十六进制整数 |
| %% | 打印一个百分号 |
printf()修饰符| 修饰符 | 意 义 |
|---|---|
| 标志 | 五种标志 (-、+、空格、# 和 0) 都将在表三中描述,可以使用零个或多个标志 |
| digit(s) | 字段宽度的最小值。如果该字段不能容纳要打印的数或者字符串,系统会使用更宽的字段。示例:“%4d” |
| .digit(s) | 精度。对于%e、%E 和%f 转换,是将要在小数点的右边打印的数字的位数。对于%g 和%G 转换,是有效数字的最大位数。对于%s 转换,是将要打印的字符的最大数目。对于整数转换,是将要打印的数字的最小位数;如果必要,要使用前导零来达到这个位数。只使用“.”表示其后跟随一个零,所以%.f 与%.0f 相同。示例:“%5.2f”打印一个浮点数,他的字段宽度为 5 个字符,小数点后有两个数字。 |
| h | 和整数转换说明符一起使用,表示一个 short int 或者 unsigned short int 类型数值。示例:“%hu”、“%hx”和“%6.4hd” |
| hh | 和整数转换说明符一起使用,表示一个 signed char 或者 unsigned char 类型数值。示例:“%hhu”、“%hhx”和“%6.4hhd” |
| j | 和整数转换说明符一起使用,表示一个 intmax_t 或 uintmax_t 值。示例:“%jd”和“%8jX” |
| l | 和整数说明符一起使用,表示一个 long int 或者 unsigned long int 类型值。示例:“%ld”和“%8lu” |
| ll | 和整数说明符一起使用,表示一个 long long int 或 unsigned long long int 类型值 (C99)。示例:“%lld”和“%8llu” |
| L | 和浮点转换说明符一起使用,表示一个 long double 值。示例:“%Lf”和“%10.4Le” |
| t | 和整数转换说明符一起使用,表示一个 ptrdiff_t 值(与两个指针之间的差相对应的类型) (C99)示例:“%td”和“%12ti” |
| z | 和整数转换说明符一起使用,表示一个 size_t 值(sizeof 返回的类型) (C99)。示例:“%zd”和“%12zx” |
| 修饰符 | 意 义 |
|---|---|
| - | 项目是左对齐的,也就是说,会把项目打印在字段的左侧开始处。示例:“%-20s” |
| + | 有符号的值若为正,则显示带加号的符号;若为负,则带减号的符号。示例:“%+6.2f” |
| (空格) | 有符号的值若为正,则显示时带前导空格(但是不显示符号);若为负,则带减号符号。+标志会覆盖空格标志。示例:“% 6.2f” |
| # | 使用转换说明的可选形式。若为%o 格式,则以 0 开始;若为%x 和%X 格式,则以 0x 或 0X 开始,对于所有的浮点形式,#保证了即使不限任何数字,也打印一个小数点字符。对于%g 和%G 格式,它防止尾随零被删除。示例:“%#o”、“%#8.0f”和“%+#10.3E” |
| 0 | 对于所有的数字格式,用前导零而不是用空格填充字段宽度。如果出现-标志或者指定了精度(对于整数)则忽略该标志。示例:“%010d”和“%08.3f” |
scanf()的转换说明符| 转换说明符 | 意 义 | 转换说明符 | 意 义 |
|---|---|---|---|
| %c | 把输入解释成一个字符 | %o | 把输入解释成一个有符号八进制数 |
| %d | 把输入解释成一个有符号十进制整数 | %p | 把输入解释成一个指针(地址) |
| %e,%f,%g, %a | 把输入解释成一个浮点数 (%a 是 C99 标准) | %s | 把输入解释成一个字符串;输入的内容以一个非空白字符作为开始,并且包含知道下一个空白字符的全部字符 |
| %E,%F,%G,%A | 把输入解释成一个浮点数 (%A 是 C99 标准) | %u | 把输入解释成一个无符号十进制整数 |
| %i | 把输入解释成一个有符号十进制整数 | %x,%X | 把输入解释成一个有符号十六进制整数 |
scanf()的转换修饰符| 修饰符 | 意 义 |
|---|---|
| * | 滞后赋值。示例:“%*d” |
| digit(s) | 最大字段宽度;在达到最大字段宽度或者遇到第一个空白字符时(不管哪一个先发生都一样)停止对输入项的读取。示例:“%10s” |
| hh | 把整数读作 signed char 或 unsigned char 。示例:“%hhd”“%hhu” |
| ll | 把整数读作 long long 或者 unsigned long long (C99)。示例:“%lld”“%llu” |
| h,l 或 L | “%hd”和“hi”指示该值将会存储在一个 short int 中。“%ho”“%hx”和“%hu”指示该值将会存储在一个 unsigned short int 中。“%ld”和“%li”指示该值将会存储在一个 long 中。“%lo”“%lx”和“%lu”指示该值将会存储在一个 unsigned long 中。“%le”“%lf”和“%lg”指示该值以 double 类型存储。将 L(而非 l)与 e、f 和 g 一起使用指示该值以 long double 类型存储。如果没有这些修饰符,d、i、o 和 x 指示 int 类型,而 e、f 和 g 指示 float 类型。 |
int getchar(void) 读取一个可用的字符,并返回一个整数。
int putchar(int c) 把一个字符输出到屏幕上,并返回相同的字符。
char *gets(char *s) 从 stdin 读取一行到 s 所指向的缓冲区,直到一个终止符或 EOF。
int puts(const char *s) 函数把字符串 s 和一个尾随的换行符写入到 stdout。
int scanf(const char *format, ...) 函数从标准输入流 stdin 读取输入,并根据提供的 format 来浏览输入。
int printf(const char *format, ...) 函数把输出写入到标准输出流 stdout ,并根据提供的格式产生输出。
format 可以是一个简单的常量字符串,但是您可以分别指定 %s、%d、%c、%f 等来输出或读取字符串、整数、字符或浮点数。还有许多其他可用的格式选项,可以根据需要使用。如需了解完整的细节,可以查看这些函数的参考手册。现在让我们通过下面这个简单的实例来加深理解:
如fprintf()、fscanf()、fwrite()、fseek()等
因为可以保留数据,以便更方便的储存和读取
文本文件
二进制文件
(1) 就是.txt文件
(1) 就是计算机中的.bin文件
(2) 并非以纯文本格式,而是以二进制格式(0 和 1)存储数据
(3) 它相比于文本文件,可以容纳更多的数据,但不易读取,因此安全性也高
也是用指针
文件与程序之间的通信需要此声明:
FILE *fptr; (这个fptr指针变量表示文件对象)
fscanf()作用:从文件中按照指定格式读取数据并赋值给变量。
示例:
int num;fscanf(file, "%d", &num); //从文件中按照%d的格式读取数据并存储在num变量fprintf()作用:按照指定格式将数据写入文件。
示例:
int num = 123;fprintf(file, "The number is: %d\n", num); // 将字符串和num的值写入文件您可以使用 fopen( ) 函数来创建一个新的文件或者打开一个已有的文件,这个调用会初始化类型 FILE 的一个对象,类型 FILE 包含了所有用来控制流的必要的信息。下面是这个函数调用的原型:
FILE *fopen( const char *filename, const char *mode );fopen()函数可以打开文件。
fptr (文件指针)=fopen(“路径+文件名.后缀”,“打开方式(模式)”);
路径如:E:\cprogram\newprogram.txt E:\cprogram\oldprogram.bin
若不写路径,则是打开与这一 C 文件同一件夹下的文件
当然也可以把“双引号+文件路径、名称”先以一个char或string的字符串记 下,然后直接用那个字符串就好了
| 打开方式 | 模式的含义 | 文件不存在期间 |
|---|---|---|
| r | 以只读方式打开 | 如果文件不存在,则fopen()返回 NULL |
| rb | 打开以二进制模式读取 | 如果文件不存在,则fopen()返回 NULL |
| w | 打开文本文件,允许写入文件 | 打开一个文本文件,允许写入文件。如果文件不存在,则会创建一个新文件在这里,您的程序会从文件的开头写入内容如果文件存在,则该会被截断为零长度,重新写入 |
| wb | 打开文件以二进制方式写入 | 如果文件存在,其内容将被覆盖 如果文件不存在,将创建它 |
| a | 打开进行追加。 数据添加到文件末尾 | 如果文件不存在,将创建它 |
| ab | 打开以二进制方式追加数据添加到文件末尾。 | 如果文件不存在,将创建它 |
| r+ | 开放供阅读和写作。 | 如果文件不存在,则fopen()返回 NULL |
| rb+ | 打开以二进制方式读取和写入 | 如果文件不存在,则fopen()返回 NULL |
| w+ | 打开一个文本文件,允许读写文件 | 如果文件存在,其内容将被覆盖如果文件不存在,将创建它 |
| wb+ | 打开以二进制方式读取和写入 | 如果文件存在,其内容将被覆盖 如果文件不存在,将创建它 |
| a+ | 打开以阅读和追加 | 如果该文件不存在,它将被创建 |
| ab+ | 打开以二进制模式读取和追加 | 如果文件不存在,将创建它 |
读取/写入后,应关闭文件,用 fclose( ) 函数。函数的原型如下:
int fclose( FILE *fp );如果成功关闭文件,fclose( ) 函数返回零,如果关闭文件时发生错误,函数返回 EOF。这个函数实际上,会清空缓冲区中的数据,关闭文件,并释放用于该文件的所有内存。EOF 是一个定义在头文件 stdio.h 中的常量。
fclose(fptr(文件指针));C 标准库提供了各种函数来按字符或者以固定长度字符串的形式读写文件。
下面是把字符写入到流中的最简单的函数:
int fputc( int c, FILE *fp );函数 fputc() 把参数 c 的字符值写入到 fp 所指向的输出流中。如果写入成功,它会返回写入的字符,如果发生错误,则会返回 EOF。您可以使用下面的函数来把一个以 null 结尾的字符串写入到流中:
int fputs( const char *s, FILE *fp );函数 fputs() 把字符串 s 写入到 fp 所指向的输出流中。如果写入成功,它会返回一个非负值,如果发生错误,则会返回 EOF。您也可以使用 int fprintf(FILE *fp,const char *format, ...) 函数把一个字符串写入到文件中。尝试下面的实例:
**注意:**请确保您有可用的 tmp 目录,如果不存在该目录,则需要在您的计算机上先创建该目录。
/tmp 一般是 Linux 系统上的临时目录,如果你在 Windows 系统上运行,则需要修改为本地环境中已存在的目录,例如: C:\tmp、D:\tmp等。
fputc() (file put character:文件存放字符)作用:将字符写入指定文件。
示例:
int ch = 'A';fputc(ch, file); // 将字符'A'写入文件fputs()作用:向文件中写入一个字符串。
示例:
char s[] = "Hello, world!";fputs(s, file); // 将字符串"Hello, world!"写入文件#include <stdio.h> int main(){ FILE *fp = NULL; fp = fopen("/tmp/test.txt", "w+"); fprintf(fp, "This is testing for fprintf...\n"); fputs("This is testing for fputs...\n", fp); fclose(fp);}当上面的代码被编译和执行时,它会在 /tmp 目录中创建一个新的文件 test.txt,并使用两个不同的函数写入两行。接下来让我们来读取这个文件。
下面是从文件读取单个字符的最简单的函数:
int fgetc( FILE * fp );fgetc() 函数从 fp 所指向的输入文件中读取一个字符。返回值是读取的字符,如果发生错误则返回 EOF。下面的函数允许您从流中读取一个字符串:
char *fgets( char *buf, int n, FILE *fp );函数 fgets() 从 fp 所指向的输入流中读取 n - 1 个字符。它会把读取的字符串复制到缓冲区 buf,并在最后追加一个 null 字符来终止字符串。
如果这个函数在读取最后一个字符之前就遇到一个换行符 '\n' 或文件的末尾 EOF,则只会返回读取到的字符,包括换行符。您也可以使用 int fscanf(FILE *fp, const char *format, ...) 函数来从文件中读取字符串,但是在遇到第一个空格和换行符时,它会停止读取。
fgetc() (注:fgetchar 是从键盘中读取一个字符)作用:从指定文件中读取一个字符并返回其整数表示。
示例:
int ch;ch = fgetchar(file); // 从文件中读取一个字符并赋值给变量chfgets()作用:从指定文件中读取一行文本(包括换行符),并将其存储在字符串数组中。
示例:
char buffer[100];fgets(buffer, sizeof(buffer), file); // 从文件中读取一行文本并存储在buffer中#include <stdio.h> int main(){ FILE *fp = NULL; char buff[255]; fp = fopen("/tmp/test.txt", "r"); fscanf(fp, "%s", buff); printf("1: %s\n", buff ); fgets(buff, 255, (FILE*)fp); printf("2: %s\n", buff ); fgets(buff, 255, (FILE*)fp); printf("3: %s\n", buff ); fclose(fp); }当上面的代码被编译和执行时,它会读取上一部分创建的文件,产生下列结果:
1: This2: is testing for fprintf... 3: This is testing for fputs...首先,fscanf() 方法只读取了 This,因为它在后边遇到了一个空格。其次,调用 fgets() 读取剩余的部分,直到行尾。最后,调用 fgets() 完整地读取第二行。
下面两个函数用于二进制输入和输出:
size_t fread(void *ptr, size_t size_of_elements, size_t number_of_elements, FILE *a_file); size_t fwrite(const void *ptr, size_t size_of_elements, size_t number_of_elements, FILE *a_file);这两个函数都是用于存储块的读写 - 通常是数组或结构体。
fread()作用:从文件中读取二进制数据,并将其存储在指定的内存块中。
示例:
int buffer[100];fread(buffer, sizeof(int), 100, file); // 从文件中读取100个整数到buffer中以二进制的形式fwrite()作用:将二进制数据从指定的内存块写入文件。
示例:
int buffer[100];fwrite(buffer, sizeof(int), 100, file); // 将buffer中的100个整数写入文件以二进制的形式fseek()获取数据为了不浪费大量时间,内存获取文件中特定位置的记录,可以使用fseek来访问
fseek()函数用于设置文件指针的位置。它可以将文件指针移动到文件中的特定位置,以便对文件进行随机访问
使用方法:
int fseek(fptr, long offset, int origin);int fseek(指向文件的指针,要查找的记录的位置,起始位置)| 位置 | 含义 |
|---|---|
| SEEK_SET | 起始位置为文件开头(顺序) |
| SEEK_END | 起始位置为文件末尾(倒序) |
| SEEK_CUR | 起始位置为文件指针当前位置(读完后停下来的位置) |
fseek(fptr, 10, SEEK_SET);// 将文件指针从开头向后偏移10个字节fseek(fptr, -2*sizeof(struct threeNum), SEEK_CUR);//将文件指针fptr从当前位置向前移动两个struct threeNum结构体的大小//若是2,则是向后移动两个结构体的大小//若是加二+2,而非乘二*2,则是多向后移动两个字节的大小,当然也有除2 等等rewind()函数用于将文件指针倒回到文件开头(将文件位置指示器重新定位到文件的起始位置)
用法:
rewind(fptr);用于获取文件位置指示器的当前位置(从前往后数)
用法:
int len= ftell (fptr);C 预处理器不是编译器的组成部分,但是它是编译过程中一个单独的步骤。简言之,C 预处理器只不过是一个文本替换工具而已,它们会指示编译器在实际编译之前完成所需的预处理。我们将把 C 预处理器(C Preprocessor)简写为 CPP。
所有的预处理器命令都是以井号(#)开头。它必须是第一个非空字符,为了增强可读性,预处理器指令应从第一列开始。下面列出了所有重要的预处理器指令:
| 指令 | 描述 |
|---|---|
| #define | 定义宏 |
| #include | 包含一个源代码文件 |
| #undef | 取消已定义的宏 |
| #ifdef | 如果宏已经定义,则返回真 |
| #ifndef | 如果宏没有定义,则返回真 |
| #if | 如果给定条件为真,则编译下面代码 |
| #else | #if 的替代方案 |
| #elif | 如果前面的 #if 给定条件不为真,当前条件为真,则编译下面代码 |
| #endif | 结束一个 #if……#else 条件编译块 |
| #error | 当遇到标准错误时,输出错误消息 |
| #pragma | 使用标准化方法,向编译器发布特殊的命令到编译器中 |
有:
| #endif | |
|---|---|
| #error | 当遇到标准错误时,输出错误消息 |
| #pragma | 使用标准化方法,向编译器发布特殊的命令到编译器中 |
分析下面的实例来理解不同的指令。
#define MAX_ARRAY_LENGTH 20这个指令告诉 CPP 把所有的 MAX*ARRAY_LENGTH 定义为 20。使用 *#define_ 定义常量来增强可读性。
#include <stdio.h>#include "myheader.h"这些指令告诉 CPP 从系统库中获取 stdio.h,并添加文本到当前的源文件中。下一行告诉 CPP 从本地目录中获取 myheader.h,并添加内容到当前的源文件中。
#undef FILE_SIZE#define FILE_SIZE 42这个指令告诉 CPP 取消已定义的 FILE_SIZE,并定义它为 42。
#ifndef MESSAGE #define MESSAGE "You wish!"#endif这个指令告诉 CPP 只有当 MESSAGE 未定义时,才定义 MESSAGE。
#ifdef DEBUG /* Your debugging statements here */#endif这个指令告诉 CPP 如果定义了 DEBUG,则执行处理语句。在编译时,如果您向 gcc 编译器传递了 -DDEBUG 开关量,这个指令就非常有用。它定义了 DEBUG,您可以在编译期间随时开启或关闭调试。
#define#define PI 3.14159//定义一个作用于全局的常量,用于方便之后修改和提高可读性#define MAX(a, b) ((a) > (b) ? (a) : (b))//宏定义中可以包含表达式和逻辑运算符。#define PRINT_MESSAGE printf("Hello, World!")//将标准输出函数printf()的调用作为替代文本,在代码中使用PRINT_MESSAGE时,相当于插入了printf("Hello, World!")这段代码。#include#include <stdio.h> //尖括号用于引入系统级头文件#include "myheader.h" //双引号用于引入自定义的,包括自己定义打包的函数,在当前目录//其实就是搜索顺序不同了,用错没问题,但不符合规范,可能也会有冲突#undef#undef FILE_SIZE#define FILE_SIZE 42//取消已定义的 FILE_SIZE,并定义它为 42#if类#ifndef MESSAGE #define MESSAGE "You wish!"#endif//这个指令告诉 CPP 只有当 MESSAGE 未定义时,才定义 MESSAGE就是被预定义的宏
| 宏 | 描述 |
|---|---|
__DATE__ |
当前日期,一个以 "MMM DD YYYY" 格式表示的字符常量。 |
__TIME__ |
当前时间,一个以 "HH:MM:SS" 格式表示的字符常量。 |
__FILE__ |
这会包含当前文件名,一个字符串常量。 |
__LINE__ |
这会包含当前行号,一个十进制常量。 |
__STDC__ |
当编译器以 ANSI 标准编译时,则定义为 1。 |
例:
//在文件test.c中:#include <stdio.h>main(){ printf("File :%s\n", __FILE__ ); printf("Date :%s\n", __DATE__ ); printf("Time :%s\n", __TIME__ ); printf("Line :%d\n", __LINE__ ); printf("ANSI :%d\n", __STDC__ );}返回:File :test.c //文件名Date :Jun 2 2012 //当前日期Time :03:36:24 //当前时间Line :7 //这条语句在第几行ANSI :1 //看是按什么来编译的就是宏专用的运算符
用于将一行写不下的宏分成两行
#define message_for(a, b) \ printf(#a " and " #b ": We love you!\n")就是将#后面的参数转换为字符串常量
#include <stdio.h>#define message_for(a, b) printf(#a " and " #b ": We love you!\n")int main(void){ message_for(Carole, Debra); return 0;}当上面的代码被编译和执行时,它会产生下列结果:
Carole and Debra: We love you!用于将两个标记合并为一个标记,但只能在宏定义中使用
#include <stdio.h>#define tokenpaster(n) printf ("token" #n " = %d", token##n)int main(void){ int token34 = 40; tokenpaster(34); //寻找token与34合并在一起的单词,并输出 //等于printf ("token34 = %d", token34); return 0;}当上面的代码被编译和执行时,它会产生下列结果:
token34 = 40这是怎么发生的,因为这个实例会从编译器产生下列的实际输出:
printf ("token34 = %d", token34);这个实例演示了 token##n 会连接到 token34 中,在这里,我们使用了字符串常量化运算符(#)和标记粘贴运算符(##)。
常与#if一起用于检查宏是否已被定义,当然了,已经有了简化的#ifdef和#ifndef
#include <stdio.h> #if !defined (MESSAGE) #define MESSAGE "You wish!"#endif int main(void){ printf("Here is the message: %s\n", MESSAGE); return 0;}当上面的代码被编译和执行时,它会产生下列结果:
Here is the message: You wish!就是宏定义中可以包含表达式和逻辑运算符啦
int square(int x){ return x * x;}//等于#define square(x) ((x) * (x))在使用带有参数的宏之前,必须使用 #define 指令定义。参数列表是括在圆括号内,且必须紧跟在宏名称的后边。宏名称和左圆括号之间不允许有空格。例如:
#include <stdio.h> #define MAX(x,y) ((x) > (y) ? (x) : (y)) int main(void){ printf("Max between 20 and 10 is %d\n", MAX(10, 20)); return 0;}当上面的代码被编译和执行时,它会产生下列结果:
Max between 20 and 10 is 20头文件与源文件的区别:
头文件就是#include后的内容,源文件就是你写的xxx.c的代码
头文件是扩展名为 .h 的文件,包含了 C 函数声明和宏定义,被多个源文件中引用共享。有两种类型的头文件:程序员编写的头文件和编译器自带的头文件。
在程序中要使用头文件,需要使用 C 预处理指令 #include 来引用它。前面我们已经看过 stdio.h 头文件,它是编译器自带的头文件。
引用头文件相当于复制头文件的内容,但是我们不会直接在源文件中复制头文件的内容,因为这么做很容易出错,特别在程序是由多个源文件组成的时候。
A simple practice in C 或 C++ 程序中,建议把所有的常量、宏、系统全局变量和函数原型写在头文件中,在需要的时候随时引用这些头文件。
使用预处理指令 #include 可以引用用户和系统头文件。它的形式有以下两种:
#include <file>这种形式用于引用系统头文件。它在系统目录的标准列表中搜索名为 file 的文件。在编译源代码时,您可以通过 -I 选项把目录前置在该列表前。
#include "file"这种形式用于引用用户头文件。它在包含当前文件的目录中搜索名为 file 的文件。在编译源代码时,您可以通过 -I 选项把目录前置在该列表前。
#include 指令会指示 C 预处理器浏览指定的文件作为输入。预处理器的输出包含了已经生成的输出,被引用文件生成的输出以及 #include 指令之后的文本输出。例如,如果您有一个头文件 header.h,如下:
char *test (void);和一个使用了头文件的主程序 program.c,如下:
int x;#include "header.h" int main (void){ puts (test ());}编译器会看到如下的代码信息:
int x;char *test (void); int main (void){ puts (test ());}如果一个头文件被引用两次,编译器会处理两次头文件的内容,这将产生错误。为了防止这种情况,标准的做法是把文件的整个内容放在条件编译语句中,如下:
#ifndef HEADER_FILE#define HEADER_FILE the entire header file file #endif这种结构就是通常所说的包装器 #ifndef。当再次引用头文件时,条件为假,因为 HEADER_FILE 已定义。此时,预处理器会跳过文件的整个内容,编译器会忽略它。
有时需要从多个不同的头文件中选择一个引用到程序中。例如,需要指定在不同的操作系统上使用的配置参数。您可以通过一系列条件来实现这点,如下:
#if SYSTEM_1 # include "system_1.h"#elif SYSTEM_2 # include "system_2.h"#elif SYSTEM_3 ...#endif但是如果头文件比较多的时候,这么做是很不妥当的,预处理器使用宏来定义头文件的名称。这就是所谓的有条件引用。它不是用头文件的名称作为 #include 的直接参数,您只需要使用宏名称代替即可:
#define SYSTEM_H "system_1.h" ... #include SYSTEM_HSYSTEM_H 会扩展,预处理器会查找 system_1.h,就像 #include 最初编写的那样。SYSTEM_H 可通过 -D 选项被您的 Makefile 定义。
在有多个 .h 文件和多个 .c 文件的时候,往往我们会用一个 global.h 的头文件来包括所有的 .h 文件,然后在除 global.h 文件外的头文件中 包含 global.h 就可以实现所有头文件的包含,同时不会乱。方便在各个文件里面调用其他文件的函数或者变量。
#ifndef _GLOBAL_H#define _GLOBAL_H#include <fstream>#include <iostream>#include <math.h>#include <Config.h>C 语言中 include <> 与 include "" 的区别?
#include < > 引用的是编译器的类库路径里面的头文件。
#include " " 引用的是你程序目录的相对路径中的头文件,如果在程序目录没有找到引用的头文件则到编译器的类库路径的目录下找该头文件。
强制类型转换是把变量从一种类型转换为另一种数据类型。例如,如果您想存储一个 long 类型的值到一个简单的整型中,您需要把 long 类型强制转换为 int 类型。您可以使用强制类型转换运算符来把值显式地从一种类型转换为另一种类型,如下所示:
(type_name) expression请看下面的实例,使用强制类型转换运算符把一个整数变量除以另一个整数变量,得到一个浮点数:
#include <stdio.h> int main(){ int sum = 17, count = 5; double mean; mean = (double) sum / count; printf("Value of mean : %f\n", mean ); }当上面的代码被编译和执行时,它会产生下列结果:
Value of mean : 3.400000这里要注意的是强制类型转换运算符的优先级大于除法,因此 sum 的值首先被转换为 double 型,然后除以 count,得到一个类型为 double 的值。
类型转换可以是隐式的,由编译器自动执行,也可以是显式的,通过使用强制类型转换运算符来指定。在编程时,有需要类型转换的时候都用上强制类型转换运算符,是一种良好的编程习惯。
整数提升是指把小于 int 或 unsigned int 的整数类型转换为 int 或 unsigned int 的过程。请看下面的实例,在 int 中添加一个字符:
#include <stdio.h> int main(){ int i = 17; char c = 'c'; /* ascii 值是 99 */ int sum; sum = i + c; printf("Value of sum : %d\n", sum ); }当上面的代码被编译和执行时,它会产生下列结果:
Value of sum : 116在这里,sum 的值为 116,因为编译器进行了整数提升,在执行实际加法运算时,把 'c' 的值转换为对应的 ascii 值。
常用的算术转换是隐式地把值强制转换为相同的类型。编译器首先执行整数提升,如果操作数类型不同,则它们会被转换为下列层次中出现的最高层次的类型:

常用的算术转换不适用于赋值运算符、逻辑运算符 && 和 ||。让我们看看下面的实例来理解这个概念:
#include <stdio.h> int main(){ int i = 17; char c = 'c'; /* ascii 值是 99 */ float sum; sum = i + c; printf("Value of sum : %f\n", sum ); }当上面的代码被编译和执行时,它会产生下列结果:
Value of sum : 116.000000在这里,c 首先被转换为整数,但是由于最后的值是 float 型的,所以会应用常用的算术转换,编译器会把 i 和 c 转换为浮点型,并把它们相加得到一个浮点数。
C 语言不提供对错误处理的直接支持,但是作为一种系统编程语言,它以返回值的形式允许您访问底层数据。在发生错误时,大多数的 C 或 UNIX 函数调用返回 1 或 NULL,同时会设置一个错误代码 errno,该错误代码是全局变量,表示在函数调用期间发生了错误。您可以在 errno.h 头文件中找到各种各样的错误代码。
所以,C 程序员可以通过检查返回值,然后根据返回值决定采取哪种适当的动作。开发人员应该在程序初始化时,把 errno 设置为 0,这是一种良好的编程习惯。0 值表示程序中没有错误。
C 语言提供了 perror() 和 strerror() 函数来显示与 errno 相关的文本消息。
让我们来模拟一种错误情况,尝试打开一个不存在的文件。您可以使用多种方式来输出错误消息,在这里我们使用函数来演示用法。另外有一点需要注意,您应该使用 stderr 文件流来输出所有的错误。
#include <stdio.h>#include <errno.h>#include <string.h> extern int errno ; int main (){ FILE * pf; int errnum; pf = fopen ("unexist.txt", "rb"); if (pf == NULL) { errnum = errno; fprintf(stderr, "错误号: %d\n", errno); perror("通过 perror 输出错误"); fprintf(stderr, "打开文件错误: %s\n", strerror( errnum )); } else { fclose (pf); } return 0;}当上面的代码被编译和执行时,它会产生下列结果:
错误号: 2通过 perror 输出错误: No such file or directory打开文件错误: No such file or directory在进行除法运算时,如果不检查除数是否为零,则会导致一个运行时错误。
为了避免这种情况发生,下面的代码在进行除法运算前会先检查除数是否为零:
#include <stdio.h>#include <stdlib.h> int main(){ int dividend = 20; int divisor = 0; int quotient; if( divisor == 0){ fprintf(stderr, "除数为 0 退出运行...\n"); exit(-1); } quotient = dividend / divisor; fprintf(stderr, "quotient 变量的值为 : %d\n", quotient ); exit(0);}当上面的代码被编译和执行时,它会产生下列结果:
除数为 0 退出运行...通常情况下,程序成功执行完一个操作正常退出的时候会带有值 EXIT_SUCCESS。在这里,EXIT_SUCCESS 是宏,它被定义为 0。
如果程序中存在一种错误情况,当您退出程序时,会带有状态值 EXIT_FAILURE,被定义为 -1。所以,上面的程序可以写成:
#include <stdio.h>#include <stdlib.h> main(){ int dividend = 20; int divisor = 5; int quotient; if( divisor == 0){ fprintf(stderr, "除数为 0 退出运行...\n"); exit(EXIT_FAILURE); } quotient = dividend / divisor; fprintf(stderr, "quotient 变量的值为: %d\n", quotient ); exit(EXIT_SUCCESS);}当上面的代码被编译和执行时,它会产生下列结果:
quotient 变量的值为 : 4调用自身的函数叫递归函数。并且,这种技术称为递归。
举个例子:
从前有座山,山里有座庙,庙里有个老和尚,正在给小和尚讲故事呢!故事是什么呢?"从前有座山,山里有座庙,庙里有个老和尚,正在给小和尚讲故事呢!故事是什么呢?'从前有座山,山里有座庙,庙里有个老和尚,正在给小和尚讲故事呢!故事是什么呢?……'"
语法如下:
void recurse(){ …… recurse(); ……} int main(){ …… recurse(); ……}//递归将继续进行,直到满足某些条件让递归终止流程图:

C 语言支持递归,即一个函数可以调用其自身。但在使用递归时,程序员需要注意定义一个从函数退出的条件,否则会进入死循环。
递归函数在解决许多数学问题上起了至关重要的作用,比如计算一个数的阶乘、生成斐波那契数列,等等。
递归使程序更优雅,但更慢,并常用于数据结构与算法中
下面的实例使用递归函数计算一个给定的数的阶乘:
#include <stdio.h> double factorial(unsigned int i){ if(i <= 1) { return 1; } return i * factorial(i - 1);}int main(){ int i = 15; printf("%d 的阶乘为 %f\n", i, factorial(i)); return 0;}当上面的代码被编译和执行时,它会产生下列结果:
15 的阶乘为 1307674368000.000000下面的实例使用递归函数生成一个给定的数的斐波那契数列:
#include <stdio.h> int fibonaci(int i){ if(i == 0) { return 0; } if(i == 1) { return 1; } return fibonaci(i-1) + fibonaci(i-2);} int main(){ int i; for (i = 0; i < 10; i++) { printf("%d\t\n", fibonaci(i)); } return 0;}当上面的代码被编译和执行时,它会产生下列结果:
0112358132134有时,您可能会碰到这样的情况,您希望函数带有可变数量的参数,而不是预定义数量的参数。
C 语言为这种情况提供了一个解决方案,它允许您定义一个函数,能根据具体的需求接受可变数量的参数。
声明方式为:
int func_name(int arg1, ...);其中,省略号 ... 表示可变参数列表。
下面的实例演示了这种函数的使用:
int func(int, ... ) { . . .} int main() { func(2, 2, 3); func(3, 2, 3, 4);}请注意,函数 func() 最后一个参数写成省略号,即三个点号(...),省略号之前的那个参数是 int,代表了要传递的可变参数的总数。为了使用这个功能,您需要使用 stdarg.h 头文件,该文件提供了实现可变参数功能的函数和宏。具体步骤如下:
常用的宏有:
**va_start(ap, last_arg)**:初始化可变参数列表。ap 是一个 va_list 类型的变量,last_arg 是最后一个固定参数的名称(也就是可变参数列表之前的参数)。该宏将 ap 指向可变参数列表中的第一个参数。**va_arg(ap, type)**:获取可变参数列表中的下一个参数。ap 是一个 va_list 类型的变量,type 是下一个参数的类型。该宏返回类型为 type 的值,并将 ap 指向下一个参数。**va_end(ap)**:结束可变参数列表的访问。ap 是一个 va_list 类型的变量。该宏将 ap 置为 NULL。现在让我们按照上面的步骤,来编写一个带有可变数量参数的函数,并返回它们的平均值:
#include <stdio.h>#include <stdarg.h> double average(int num,...){ va_list valist; double sum = 0.0; int i; /* 为 num 个参数初始化 valist */ va_start(valist, num); /* 访问所有赋给 valist 的参数 */ for (i = 0; i < num; i++) { sum += va_arg(valist, int); } /* 清理为 valist 保留的内存 */ va_end(valist); return sum/num;} int main(){ printf("Average of 2, 3, 4, 5 = %f\n", average(4, 2,3,4,5)); printf("Average of 5, 10, 15 = %f\n", average(3, 5,10,15));}在上面的例子中,average() 函数接受一个整数 num 和任意数量的整数参数。函数内部使用 va_list 类型的变量 va_list 来访问可变参数列表。在循环中,每次使用 va_arg() 宏获取下一个整数参数,并输出。最后,在函数结束时使用 va_end() 宏结束可变参数列表的访问。
当上面的代码被编译和执行时,它会产生下列结果。应该指出的是,函数 average() 被调用两次,每次第一个参数都是表示被传的可变参数的总数。省略号被用来传递可变数量的参数。
Average of 2, 3, 4, 5 = 3.500000Average of 5, 10, 15 = 10.000000本章将讲解 C 中的动态内存管理。C 语言为内存的分配和管理提供了几个函数。这些函数可以在 <stdlib.h> 头文件中找到。
在 C 语言中,内存是通过指针变量来管理的。指针是一个变量,它存储了一个内存地址,这个内存地址可以指向任何数据类型的变量,包括整数、浮点数、字符和数组等。C 语言提供了一些函数和运算符,使得程序员可以对内存进行操作,包括分配、释放、移动和复制等。
| 序号 | 函数和描述 |
|---|---|
| 1 | void *calloc(int num, int size); 在内存中动态地分配 num 个长度为 size 的连续空间,并将每一个字节都初始化为 0。所以它的结果是分配了 num*size 个字节长度的内存空间,并且每个字节的值都是 0。 |
| 2 | void free(void *address); 该函数释放 address 所指向的内存块,释放的是动态分配的内存空间。 |
| 3 | void *malloc(int num); 在堆区分配一块指定大小的内存空间,用来存放数据。这块内存空间在函数执行完成后不会被初始化,它们的值是未知的。 |
| 4 | void *realloc(void *address, int newsize); 该函数重新分配内存,把内存扩展到 newsize。 |
**注意:**void _ 类型表示未确定类型的指针。C、C++ 规定 void _ 类型可以通过类型转换强制转换为任何其它类型的指针。
用<stdlib.h>中的malloc(),calloc(),free(),realloc()
当编译器不能自动分配好内存时,用手动分配好内存就是动态分配内存
编程时,如果您预先知道数组的大小,那么定义数组时就比较容易。例如,一个存储人名的数组,它最多容纳 100 个字符,所以您可以定义数组,如下所示:
char name[100];但是,如果您预先不知道需要存储的文本长度,例如您想存储有关一个主题的详细描述。在这里,我们需要定义一个指针,该指针指向未定义所需内存大小的字符,后续再根据需求来分配内存,如下所示:
#include <stdio.h>#include <stdlib.h>#include <string.h> int main(){ char name[100]; char *description; strcpy(name, "Zara Ali"); /* 动态分配内存 */ description = (char *)malloc( 200 * sizeof(char) ); if( description == NULL ) { fprintf(stderr, "Error - unable to allocate required memory\n"); } else { strcpy( description, "Zara ali a DPS student in class 10th"); } printf("Name = %s\n", name ); printf("Description: %s\n", description );}当上面的代码被编译和执行时,它会产生下列结果:
Name = Zara AliDescription: Zara ali a DPS student in class 10th上面的程序也可以使用 calloc() 来编写,只需要把 malloc 替换为 calloc 即可,如下所示:
calloc(200, sizeof(char));当动态分配内存时,您有完全控制权,可以传递任何大小的值。而那些预先定义了大小的数组,一旦定义则无法改变大小。
当程序退出时,操作系统会自动释放所有分配给程序的内存,但是,建议您在不需要内存时,都应该调用函数 free() 来释放内存。
或者,您可以通过调用函数 realloc() 来增加或减少已分配的内存块的大小。让我们使用 realloc() 和 free() 函数,再次查看上面的实例:
#include <stdio.h>#include <stdlib.h>#include <string.h> int main(){ char name[100]; char *description; strcpy(name, "Zara Ali"); /* 动态分配内存 */ description = (char *)malloc( 30 * sizeof(char) ); if( description == NULL ) { fprintf(stderr, "Error - unable to allocate required memory\n"); } else { strcpy( description, "Zara ali a DPS student."); } /* 假设您想要存储更大的描述信息 */ description = (char *) realloc( description, 100 * sizeof(char) ); if( description == NULL ) { fprintf(stderr, "Error - unable to allocate required memory\n"); } else { strcat( description, "She is in class 10th"); } printf("Name = %s\n", name ); printf("Description: %s\n", description ); /* 使用 free() 函数释放内存 */ free(description);}当上面的代码被编译和执行时,它会产生下列结果:
Name = Zara AliDescription: Zara ali a DPS student.She is in class 10th您可以尝试一下不重新分配额外的内存,strcat() 函数会生成一个错误,因为存储 description 时可用的内存不足。
malloc()(主要用于分配单个元素)
malloc(memory allocation:内存分配)
使用 malloc()分配内存的一般步骤如下:
确定需要分配的内存大小。
调用 malloc() 函数,并传入要分配的内存大小作为参数。
检查分配是否成功,即检查返回的指针是否为 NULL。如果返回的指针为 NULL,则说明内存分配失败。
如果分配成功,则可以使用返回的指针来访问和操作分配的内存。
在不再需要使用分配的内存时,使用 free() 函数释放该内存,以便系统可以重新利用它。
例:
#include <stdio.h>#include <stdlib.h> int main() { int size = 5; int* numbers = (int*)malloc(size * sizeof(int)); //分配20字节的内存 (5x4(int四字节)) if (numbers == NULL){ //分配失败返回NULL指针 printf("内存分配失败\n"); return 1; } for (int i = 0; i < size; i++) { numbers[i] = i + 1; } for (int i = 0; i < size; i++) { printf("%d ", numbers[i]); } free(numbers); //释放内存 return 0;}在上述示例中,我们分配了一个可以容纳 5 个 int 类型元素的内存空间(1 个 20 字节)(或叫 1 个占用 5 个地址的内存空间)(或 n 个占用 4 个字节的内存空间),并通过指针 numbers 进行访问。
在使用完毕后,我们使用 free() 函数释放了这块动态分配的内存。
注:在使用 malloc() 或calloc()分配内存后,一定记得及时释放内存,以避免内存泄漏问题。主要是它们都不会自己释放内存
calloc()(主要用于分配数组)
calloc(contiguous allocation: 连续分配)
它会将内容初始化为 0
例:
ptr = (float*) calloc(25, sizeof(float)); //ptr为指针//这分配了25个可以容纳1个float类型元素的内存空间(25个4字节的空间)ptr = (float*) calloc(25, 3*sizeof(float)); //(25个12字节的空间)//若分配的ptr不是数组的起始地址,而是一个指针,那么后面将是连续的内存空间,可供您自由使用。具体内容取决于您在代码中对 ptr 以及后续内存空间的操作free()free(free:释放 -->释放内存)
语法:
free(ptr);//因为malloc,calloc都是返回指针变量,所以free清空的也是指针变量的内存指针可以是任何类型的变量realloc()realloc(reallocate:重新分配;再指派)
用于重新分配内存
语法:
ptr = realloc(ptr, x);例:
ptr = realloc(ptr, 5* sizeof(int));执行程序时,可以从命令行传值给 C 程序。这些值被称为命令行参数,它们对程序很重要,特别是当您想从外部控制程序,而不是在代码内对这些值进行硬编码时,就显得尤为重要了。
命令行参数是使用 main() 函数参数来处理的,其中,argc 是指传入参数的个数,argv[] 是一个指针数组,指向传递给程序的每个参数。下面是一个简单的实例,检查命令行是否有提供参数,并根据参数执行相应的动作:
#include <stdio.h> int main( int argc, char *argv[] ){ if( argc == 2 ) { printf("The argument supplied is %s\n", argv[1]); } else if( argc > 2 ) { printf("Too many arguments supplied.\n"); } else { printf("One argument expected.\n"); }}使用一个参数,编译并执行上面的代码,它会产生下列结果:
$./a.out testingThe argument supplied is testing使用两个参数,编译并执行上面的代码,它会产生下列结果:
$./a.out testing1 testing2Too many arguments supplied.不传任何参数,编译并执行上面的代码,它会产生下列结果:
$./a.outOne argument expected应当指出的是,argv[0] 存储程序的名称,argv[1] 是一个指向第一个命令行参数的指针,*argv[n] 是最后一个参数。如果没有提供任何参数,argc 将为 1,否则,如果传递了一个参数,argc 将被设置为 2。
多个命令行参数之间用空格分隔,但是如果参数本身带有空格,那么传递参数的时候应把参数放置在双引号 "" 或单引号 '' 内部。让我们重新编写上面的实例,有一个空间,那么你可以通过这样的观点,把它们放在双引号或单引号""""。让我们重新编写上面的实例,向程序传递一个放置在双引号内部的命令行参数:
#include <stdio.h> int main( int argc, char *argv[] ){ printf("Program name %s\n", argv[0]); if( argc == 2 ) { printf("The argument supplied is %s\n", argv[1]); } else if( argc > 2 ) { printf("Too many arguments supplied.\n"); } else { printf("One argument expected.\n"); }}使用一个用空格分隔的简单参数,参数括在双引号中,编译并执行上面的代码,它会产生下列结果:
$./a.out "testing1 testing2" Progranm name ./a.outThe argument supplied is testing1 testing2其他:
main 的两个参数的参数名如下:
int main( int argc, char *argv[] )并不一定这样写,只是约定俗成罢了。但是亦可以写成下面这样:
int main( int test_argc, char *test_argv[] )任意你喜欢的名字。
但是大部分人还是写成开头那样的,如下:
int main( int argc, char *argv[] )Linux 下我们可使用 getopt 和 getopt_long 来对命令行参数进行解析,例如:
int main(int argc, char *argv[]){ char *optstr = "p:n:m:c:"; struct option opts[] = { {"path", 1, NULL, 'p'}, {"name", 1, NULL, 'n'}, {"mtime", 1, NULL, 'm'}, {"ctime", 1, NULL, 'c'}, {0, 0, 0, 0}, }; int opt; while((opt = getopt_long(argc, argv, optstr, opts, NULL)) != -1){ switch(opt) { case 'p': strcpy(path, optarg); break; case 'n': strcpy(targetname, optarg); break; case 'm': modifiedtime = atoi(optarg); break; case 'c': changetime = atoi(optarg); break; case '?': if(strchr(optstr, optopt) == NULL){ fprintf(stderr, "unknown option '-%c'\n", optopt); }else{ fprintf(stderr, "option requires an argument '-%c'\n", optopt); } return 1; } } findInDir(path); return 0;}冒泡排序(英语:Bubble Sort)是一种简单的排序算法。它重复地走访过要排序的数列,一次比较两个元素,如果他们的顺序(如从大到小、首字母从 A 到 Z)错误就把他们交换过来。
过程演示:
#include <stdio.h>void bubble_sort(int arr[], int len) { int i, j, temp; for (i = 0; i < len - 1; i++) for (j = 0; j < len - 1 - i; j++) if (arr[j] > arr[j + 1]) { temp = arr[j]; arr[j] = arr[j + 1]; arr[j + 1] = temp; }}int main() { int arr[] = { 22, 34, 3, 32, 82, 55, 89, 50, 37, 5, 64, 35, 9, 70 }; int len = (int) sizeof(arr) / sizeof(*arr); bubble_sort(arr, len); int i; for (i = 0; i < len; i++) printf("%d ", arr[i]); return 0;}选择排序(Selection sort)是一种简单直观的排序算法。它的工作原理如下。首先在未排序序列中找到最小(大)元素,存放到排序序列的起始位置,然后,再从剩余未排序元素中继续寻找最小(大)元素,然后放到已排序序列的末尾。以此类推,直到所有元素均排序完毕。
过程演示:


void selection_sort(int a[], int len){ int i,j,temp; for (i = 0 ; i < len - 1 ; i++) { int min = i; // 记录最小值,第一个元素默认最小 for (j = i + 1; j < len; j++) // 访问未排序的元素 { if (a[j] < a[min]) // 找到目前最小值 { min = j; // 记录最小值 } } if(min != i) { temp=a[min]; // 交换两个变量 a[min]=a[i]; a[i]=temp; } /* swap(&a[min], &a[i]); */ // 使用自定义函数交換 }} /*void swap(int *a,int *b) // 交换两个变量{ int temp = *a; *a = *b; *b = temp;}*/插入排序(英语:Insertion Sort)是一种简单直观的排序算法。它的工作原理是通过构建有序序列,对于未排序数据,在已排序序列中从后向前扫描,找到相应位置并插入。插入排序在实现上,通常采用 in-place 排序(即只需用到 {\displaystyle O(1)} {\displaystyle O(1)}的额外空间的排序),因而在从后向前扫描过程中,需要反复把已排序元素逐步向后
挪位,为最新元素提供插入空间。
过程演示:

void insertion_sort(int arr[], int len){ int i,j,temp; for (i=1;i<len;i++){ temp = arr[i]; for (j=i;j>0 && arr[j-1]>temp;j--) arr[j] = arr[j-1]; arr[j] = temp; }}希尔排序,也称递减增量排序算法,是插入排序的一种更高效的改进版本。希尔排序是非稳定排序算法。
希尔排序是基于插入排序的以下两点性质而提出改进方法的:
过程演示:

void shell_sort(int arr[], int len) { int gap, i, j; int temp; for (gap = len >> 1; gap > 0; gap = gap >> 1) for (i = gap; i < len; i++) { temp = arr[i]; for (j = i - gap; j >= 0 && arr[j] > temp; j -= gap) arr[j + gap] = arr[j]; arr[j + gap] = temp; }}把数据分为两段,从两段中逐个选最小的元素移入新数据段的末尾。
可从上到下或从下到上进行。
过程演示:

int min(int x, int y) { return x < y ? x : y;}void merge_sort(int arr[], int len) { int* a = arr; int* b = (int*) malloc(len * sizeof(int)); int seg, start; for (seg = 1; seg < len; seg += seg) { for (start = 0; start < len; start += seg + seg) { int low = start, mid = min(start + seg, len), high = min(start + seg + seg, len); int k = low; int start1 = low, end1 = mid; int start2 = mid, end2 = high; while (start1 < end1 && start2 < end2) b[k++] = a[start1] < a[start2] ? a[start1++] : a[start2++]; while (start1 < end1) b[k++] = a[start1++]; while (start2 < end2) b[k++] = a[start2++]; } int* temp = a; a = b; b = temp; } if (a != arr) { int i; for (i = 0; i < len; i++) b[i] = a[i]; b = a; } free(b);}void merge_sort_recursive(int arr[], int reg[], int start, int end) { if (start >= end) return; int len = end - start, mid = (len >> 1) + start; int start1 = start, end1 = mid; int start2 = mid + 1, end2 = end; merge_sort_recursive(arr, reg, start1, end1); merge_sort_recursive(arr, reg, start2, end2); int k = start; while (start1 <= end1 && start2 <= end2) reg[k++] = arr[start1] < arr[start2] ? arr[start1++] : arr[start2++]; while (start1 <= end1) reg[k++] = arr[start1++]; while (start2 <= end2) reg[k++] = arr[start2++]; for (k = start; k <= end; k++) arr[k] = reg[k];}void merge_sort(int arr[], const int len) { int reg[len]; merge_sort_recursive(arr, reg, 0, len - 1);}在区间中随机挑选一个元素作基准,将小于基准的元素放在基准之前,大于基准的元素放在基准之后,再分别对小数区与大数区进行排序。
过程演示:

typedef struct _Range { int start, end;} Range;Range new_Range(int s, int e) { Range r; r.start = s; r.end = e; return r;}void swap(int *x, int *y) { int t = *x; *x = *y; *y = t;}void quick_sort(int arr[], const int len) { if (len <= 0) return; // 避免len等於負值時引發段錯誤(Segment Fault) // r[]模擬列表,p為數量,r[p++]為push,r[--p]為pop且取得元素 Range r[len]; int p = 0; r[p++] = new_Range(0, len - 1); while (p) { Range range = r[--p]; if (range.start >= range.end) continue; int mid = arr[(range.start + range.end) / 2]; // 選取中間點為基準點 int left = range.start, right = range.end; do { while (arr[left] < mid) ++left; // 檢測基準點左側是否符合要求 while (arr[right] > mid) --right; //檢測基準點右側是否符合要求 if (left <= right) { swap(&arr[left],&arr[right]); left++;right--; // 移動指針以繼續 } } while (left <= right); if (range.start < right) r[p++] = new_Range(range.start, right); if (range.end > left) r[p++] = new_Range(left, range.end); }}void swap(int *x, int *y) { int t = *x; *x = *y; *y = t;}void quick_sort_recursive(int arr[], int start, int end) { if (start >= end) return; int mid = arr[end]; int left = start, right = end - 1; while (left < right) { while (arr[left] < mid && left < right) left++; while (arr[right] >= mid && left < right) right--; swap(&arr[left], &arr[right]); } if (arr[left] >= arr[end]) swap(&arr[left], &arr[end]); else left++; if (left) quick_sort_recursive(arr, start, left - 1); quick_sort_recursive(arr, left + 1, end);}void quick_sort(int arr[], int len) { quick_sort_recursive(arr, 0, len - 1);}| 序号 | 头文件 | 描述 |
|---|---|---|
| 1 | stdio.h | 这是一个标准的输入/输出头文件。它包含有关标准输入/输出的所有库函数。 |
| 2 | conio.h | 这是一个控制台输入/输出头文件。 |
| 3 | string.h | 它包含所有与字符串相关的库函数,例如gets(),puts()等。 |
| 4 | stdlib.h | 该头文件包含所有通用库函数,例如malloc(),calloc(),exit()等。 |
| 5 | math.h | 该头文件包含所有与数学运算相关的函数,例如sqrt(),pow()等。 |
| 6 | time.h | 该头文件包含所有与时间有关的函数。 |
| 7 | ctype.h | 该头文件包含所有字符处理函数。 |
| 8 | stdarg.h | 变量参数函数在此头文件中定义。 |
| 9 | signal.h | 所有信号处理函数都在此头文件中定义。 |
| 10 | setjmp.h | 该文件包含所有跳转函数。 |
| 11 | locale.h | 该文件包含语言环境函数。 |
| 12 | errno.h | 该文件包含错误处理函数。 |
| 13 | assert.h | 该文件包含诊断函数。 |
C 标准库 -<assert.h>
C 标准库 -<ctype.h>:
| 序号 | 函数 & 描述 |
|---|---|
| 1 | int isalnum(int c) 该函数检查所传的字符是否是字母和数字。 |
| 2 | int isalpha(int c) 该函数检查所传的字符是否是字母。 |
| 3 | int iscntrl(int c) 该函数检查所传的字符是否是控制字符。 |
| 4 | int isdigit(int c) 该函数检查所传的字符是否是十进制数字。 |
| 5 | int isgraph(int c) 该函数检查所传的字符是否有图形表示法。 |
| 6 | int islower(int c) 该函数检查所传的字符是否是小写字母。 |
| 7 | int isprint(int c) 该函数检查所传的字符是否是可打印的。 |
| 8 | int ispunct(int c) 该函数检查所传的字符是否是标点符号字符。 |
| 9 | int isspace(int c) 该函数检查所传的字符是否是空白字符。 |
| 10 | int isupper(int c) 该函数检查所传的字符是否是大写字母。 |
| 11 | int isxdigit(int c) 该函数检查所传的字符是否是十六进制数字。 |
标准库还包含了两个转换函数,它们接受并返回一个 "int"
| 序号 | 函数 & 描述 |
|---|---|
| 1 | int tolower(int c) 该函数把大写字母转换为小写字母。 |
| 2 | int toupper(int c) 该函数把小写字母转换为大写字母。 |
字符类
| 序号 | 字符类 & 描述 |
|---|---|
| 1 | 数字 完整的数字集合 { 0, 1, 2, 3, 4, 5, 6, 7, 8, 9 } |
| 2 | 十六进制数字 集合 { 0 1 2 3 4 5 6 7 8 9 A B C D E F a b c d e f } |
| 3 | 小写字母 集合 { a b c d e f g h i j k l m n o p q r s t u v w x y z } |
| 4 | 大写字母 集合 {A B C D E F G H I J K L M N O P Q R S T U V W X Y Z } |
| 5 | 字母 小写字母和大写字母的集合 |
| 6 | 字母数字字符 数字、小写字母和大写字母的集合 |
| 7 | 标点符号字符 集合 ! " # $ % & ' ( ) * + , - . / : ; < = > ? @ [ \ ] ^ _ ` { | } ~ |
| 8 | 图形字符 字母数字字符和标点符号字符的集合 |
| 9 | 空格字符 制表符、换行符、垂直制表符、换页符、回车符、空格符的集合。 |
| 10 | 可打印字符 字母数字字符、标点符号字符和空格字符的集合。 |
| 11 | 控制字符 在 ASCII 编码中,这些字符的八进制代码是从 000 到 037,以及 177(DEL)。 |
| 12 | 空白字符 包括空格符和制表符。 |
| 13 | 字母字符 小写字母和大写字母的集合。 |
C 标准库 -<errno.h>
C 标准库 -<float.h>
C 标准库 -<limits.h>
C 标准库 -<locale.h>
C 标准库 -<math.h>
| 序号 | 函数 & 描述 |
|---|---|
| 1 | double acos(double x) 返回以弧度表示的 x 的反余弦。 |
| 2 | double asin(double x) 返回以弧度表示的 x 的反正弦。 |
| 3 | double atan(double x) 返回以弧度表示的 x 的反正切。 |
| 4 | double atan2(double y, double x) 返回以弧度表示的 y/x 的反正切。y 和 x 的值的符号决定了正确的象限。 |
| 5 | double cos(double x) 返回弧度角 x 的余弦。 |
| 6 | double cosh(double x) 返回 x 的双曲余弦。 |
| 7 | double sin(double x) 返回弧度角 x 的正弦。 |
| 8 | double sinh(double x) 返回 x 的双曲正弦。 |
| 9 | double tanh(double x) 返回 x 的双曲正切。 |
| 10 | double exp(double x) 返回 e 的 x 次幂的值。 |
| 11 | double frexp(double x, int *exponent) 把浮点数 x 分解成尾数和指数。返回值是尾数,并将指数存入 exponent 中。所得的值是 x = mantissa * 2 ^ exponent。 |
| 12 | double ldexp(double x, int exponent) 返回 x 乘以 2 的 exponent 次幂。 |
| 13 | double log(double x) 返回 x 的自然对数(基数为 e 的对数)。 |
| 14 | double log10(double x) 返回 x 的常用对数(基数为 10 的对数)。 |
| 15 | double modf(double x, double *integer) 返回值为小数部分(小数点后的部分),并设置 integer 为整数部分。 |
| 16 | double pow(double x, double y) 返回 x 的 y 次幂。 |
| 17 | double sqrt(double x) 返回 x 的平方根。 |
| 18 | double ceil(double x) 返回大于或等于 x 的最小的整数值。 |
| 19 | double fabs(double x) 返回 x 的绝对值。 |
| 20 | double floor(double x) 返回小于或等于 x 的最大的整数值。 |
| 21 | double fmod(double x, double y) 返回 x 除以 y 的余数。 |
C 标准库 -<setjmp.h>
C 标准库 -<signal.h>
C 标准库 -<stdarg.h>
C 标准库 - <stddef.h>
C 标准库 -<stdio.h>
| 序号 | 函数 & 描述 |
|---|---|
| 1 | int fclose(FILE *stream) 关闭流 stream。刷新所有的缓冲区。 |
| 2 | void clearerr(FILE *stream) 清除给定流 stream 的文件结束和错误标识符。 |
| 3 | int feof(FILE *stream) 测试给定流 stream 的文件结束标识符。 |
| 4 | int ferror(FILE *stream) 测试给定流 stream 的错误标识符。 |
| 5 | int fflush(FILE *stream) 刷新流 stream 的输出缓冲区。 |
| 6 | int fgetpos(FILE *stream, fpos_t *pos) 获取流 stream 的当前文件位置,并把它写入到 pos。 |
| 7 | FILE *fopen(const char *filename, const char *mode) 使用给定的模式 mode 打开 filename 所指向的文件。 |
| 8 | size_t fread(void *ptr, size_t size, size_t nmemb, FILE *stream) 从给定流 stream 读取数据到 ptr 所指向的数组中。 |
| 9 | FILE *freopen(const char *filename, const char *mode, FILE *stream) 把一个新的文件名 filename 与给定的打开的流 stream 关联,同时关闭流中的旧文件。 |
| 10 | int fseek(FILE *stream, long int offset, int whence) 设置流 stream 的文件位置为给定的偏移 offset,参数 offset 意味着从给定的 whence 位置查找的字节数。 |
| 11 | int fsetpos(FILE *stream, const fpos_t *pos) 设置给定流 stream 的文件位置为给定的位置。参数 pos 是由函数 fgetpos 给定的位置。 |
| 12 | long int ftell(FILE *stream) 返回给定流 stream 的当前文件位置。 |
| 13 | size_t fwrite(const void *ptr, size_t size, size_t nmemb, FILE *stream) 把 ptr 所指向的数组中的数据写入到给定流 stream 中。 |
| 14 | int remove(const char *filename) 删除给定的文件名 filename,以便它不再被访问。 |
| 15 | int rename(const char *old_filename, const char *new_filename) 把 old_filename 所指向的文件名改为 new_filename。 |
| 16 | void rewind(FILE *stream) 设置文件位置为给定流 stream 的文件的开头。 |
| 17 | void setbuf(FILE *stream, char *buffer) 定义流 stream 应如何缓冲。 |
| 18 | int setvbuf(FILE *stream, char *buffer, int mode, size_t size) 另一个定义流 stream 应如何缓冲的函数。 |
| 19 | FILE *tmpfile(void)创建临时文件。 |
| 20 | char *tmpnam(char *str) 生成并返回一个有效的临时文件名,该文件名之前是不存在的。 |
| 21 | int fprintf(FILE *stream, const char *format, ...) 发送格式化输出到流 stream 中。 |
| 22 | int printf(const char *format, ...) 发送格式化输出到标准输出 stdout。 |
| 23 | int sprintf(char *str, const char *format, ...) 发送格式化输出到字符串。 |
| 24 | int vfprintf(FILE *stream, const char *format, va_list arg) 使用参数列表发送格式化输出到流 stream 中。 |
| 25 | int vprintf(const char *format, va_list arg) 使用参数列表发送格式化输出到标准输出 stdout。 |
| 26 | int vsprintf(char *str, const char *format, va_list arg) 使用参数列表发送格式化输出到字符串。 |
| 27 | int fscanf(FILE *stream, const char *format, ...) 从流 stream 读取格式化输入。 |
| 28 | int scanf(const char *format, ...) 从标准输入 stdin 读取格式化输入。 |
| 29 | int sscanf(const char *str, const char *format, ...) 从字符串读取格式化输入。 |
| 30 | int fgetc(FILE *stream) 从指定的流 stream 获取下一个字符(一个无符号字符),并把位置标识符往前移动。 |
| 31 | char *fgets(char *str, int n, FILE *stream) 个字符时,或者读取到换行符时,或者到达文件末尾时,它会停止,具体视情况而定。 |
| 32 | int fputc(int char, FILE *stream) 把参数 char 指定的字符(一个无符号字符)写入到指定的流 stream 中,并把位置标识符往前移动。 |
| 33 | int fputs(const char *str, FILE *stream) 把字符串写入到指定的流 stream 中,但不包括空字符。 |
| 34 | int getc(FILE *stream) 从指定的流 stream 获取下一个字符(一个无符号字符),并把位置标识符往前移动。 |
| 35 | int getchar(void) 从标准输入 stdin 获取一个字符(一个无符号字符)。 |
| 36 | char *gets(char *str) 从标准输入 stdin 读取一行,并把它存储在 str 所指向的字符串中。当读取到换行符时,或者到达文件末尾时,它会停止,具体视情况而定。 |
| 37 | int putc(int char, FILE *stream) 把参数 char 指定的字符(一个无符号字符)写入到指定的流 stream 中,并把位置标识符往前移动。 |
| 38 | int putchar(int char) 把参数 char 指定的字符(一个无符号字符)写入到标准输出 stdout 中。 |
| 39 | int puts(const char *str) 把一个字符串写入到标准输出 stdout,直到空字符,但不包括空字符。换行符会被追加到输出中。 |
| 40 | int ungetc(int char, FILE *stream) 把字符 char(一个无符号字符)推入到指定的流 stream 中,以便它是下一个被读取到的字符。 |
| 41 | void perror(const char *str) 把一个描述性错误消息输出到标准错误 stderr。首先输出字符串 str,后跟一个冒号,然后是一个空格。 |
| 42 | int snprintf(char *str, size_t size, const char *format, ...) 格式字符串到 str 中。 |
其中还有库宏,宏变量等等没有写
C 标准库 -<stdlib.h>
| 序号 | 函数 & 描述 |
|---|---|
| 1 | double atof(const char *str) 把参数 str 所指向的字符串转换为一个浮点数(类型为 double 型)。 |
| 2 | int atoi(const char *str) 把参数 str 所指向的字符串转换为一个整数(类型为 int 型)。 |
| 3 | long int atol(const char *str) 把参数 str 所指向的字符串转换为一个长整数(类型为 long int 型)。 |
| 4 | double strtod(const char *str, char **endptr) 把参数 str 所指向的字符串转换为一个浮点数(类型为 double 型)。 |
| 5 | long int strtol(const char *str, char **endptr, int base) 把参数 str 所指向的字符串转换为一个长整数(类型为 long int 型)。 |
| 6 | unsigned long int strtoul(const char *str, char **endptr, int base) 把参数 str 所指向的字符串转换为一个无符号长整数(类型为 unsigned long int 型)。 |
| 7 | void *calloc(size_t nitems, size_t size) 分配所需的内存空间,并返回一个指向它的指针。 |
| 8 | void free(void *ptr) 释放之前调用 calloc、malloc 或 realloc 所分配的内存空间。 |
| 9 | void *malloc(size_t size) 分配所需的内存空间,并返回一个指向它的指针。 |
| 10 | void *realloc(void *ptr, size_t size) 尝试重新调整之前调用 malloc 或 calloc 所分配的 ptr 所指向的内存块的大小。 |
| 11 | void abort(void) 使一个异常程序终止。 |
| 12 | int atexit(void (*func)(void)) 当程序正常终止时,调用指定的函数 func。 |
| 13 | void exit(int status) 使程序正常终止。 |
| 14 | char *getenv(const char *name) 搜索 name 所指向的环境字符串,并返回相关的值给字符串。 |
| 15 | int system(const char *string) 由 string 指定的命令传给要被命令处理器执行的主机环境。 |
| 16 | void *bsearch(const void *key, const void *base, size_t nitems, size_t size, int (*compar)(const void *, const void *)) 执行二分查找。 |
| 17 | void qsort(void *base, size_t nitems, size_t size, int (*compar)(const void *, const void*)) 数组排序。 |
| 18 | int abs(int x) 返回 x 的绝对值。 |
| 19 | div_t div(int numer, int denom) 分子除以分母。 |
| 20 | long int labs(long int x) 返回 x 的绝对值。 |
| 21 | ldiv_t ldiv(long int numer, long int denom) 分子除以分母。 |
| 22 | int rand(void) 返回一个范围在 0 到 RAND_MAX 之间的伪随机数。 |
| 23 | void srand(unsigned int seed) 该函数播种由函数 rand 使用的随机数发生器。 |
| 24 | int mblen(const char *str, size_t n) 返回参数 str 所指向的多字节字符的长度。 |
| 25 | size_t mbstowcs(schar_t *pwcs, const char *str, size_t n) 把参数 str 所指向的多字节字符的字符串转换为参数 pwcs 所指向的数组。 |
| 26 | int mbtowc(whcar_t *pwc, const char *str, size_t n) 检查参数 str 所指向的多字节字符。 |
| 27 | size_t wcstombs(char *str, const wchar_t *pwcs, size_t n) 把数组 pwcs 中存储的编码转换为多字节字符,并把它们存储在字符串 str 中。 |
| 28 | int wctomb(char *str, wchar_t wchar) 检查对应于参数 wchar 所给出的多字节字符的编码。 |
C 标准库 - <string.h>
| 序号 | 函数 & 描述 |
|---|---|
| 1 | void *memchr(const void *str, int c, size_t n) 在参数 str 所指向的字符串的前 n 个字节中搜索第一次出现字符 c(一个无符号字符)的位置。 |
| 2 | int memcmp(const void *str1, const void *str2, size_t n) 把 str1 和 str2 的前 n 个字节进行比较。 |
| 3 | void *memcpy(void *dest, const void *src, size_t n) 从 src 复制 n 个字符到 dest。 |
| 4 | void *memmove(void *dest, const void *src, size_t n) 另一个用于从 src 复制 n 个字符到 dest 的函数。 |
| 5 | void *memset(void *str, int c, size_t n) 复制字符 c(一个无符号字符)到参数 str 所指向的字符串的前 n 个字符。 |
| 6 | char *strcat(char *dest, const char *src) 把 src 所指向的字符串追加到 dest 所指向的字符串的结尾。 |
| 7 | char *strncat(char *dest, const char *src, size_t n) 把 src 所指向的字符串追加到 dest 所指向的字符串的结尾,直到 n 字符长度为止。 |
| 8 | char *strchr(const char *str, int c) 在参数 str 所指向的字符串中搜索第一次出现字符 c(一个无符号字符)的位置。 |
| 9 | int strcmp(const char *str1, const char *str2) 把 str1 所指向的字符串和 str2 所指向的字符串进行比较。 |
| 10 | int strncmp(const char *str1, const char *str2, size_t n) 把 str1 和 str2 进行比较,最多比较前 n 个字节。 |
| 11 | int strcoll(const char *str1, const char *str2) 把 str1 和 str2 进行比较,结果取决于 LC_COLLATE 的位置设置。 |
| 12 | char *strcpy(char *dest, const char *src) 把 src 所指向的字符串复制到 dest。 |
| 13 | char *strncpy(char *dest, const char *src, size_t n) 把 src 所指向的字符串复制到 dest,最多复制 n 个字符。 |
| 14 | size_t strcspn(const char *str1, const char *str2) 检索字符串 str1 开头连续有几个字符都不含字符串 str2 中的字符。 |
| 15 | char *strerror(int errnum) 从内部数组中搜索错误号 errnum,并返回一个指向错误消息字符串的指针。 |
| 16 | size_t strlen(const char *str) 计算字符串 str 的长度,直到空结束字符,但不包括空结束字符。 |
| 17 | char *strpbrk(const char *str1, const char *str2) 检索字符串 str1 中第一个匹配字符串 str2 中字符的字符,不包含空结束字符。也就是说,依次检验字符串 str1 中的字符,当被检验字符在字符串 str2 中也包含时,则停止检验,并返回该字符位置。 |
| 18 | char *strrchr(const char *str, int c) 在参数 str 所指向的字符串中搜索最后一次出现字符 c(一个无符号字符)的位置。 |
| 19 | size_t strspn(const char *str1, const char *str2) 检索字符串 str1 中第一个不在字符串 str2 中出现的字符下标。 |
| 20 | char *strstr(const char *haystack, const char *needle) 在字符串 haystack 中查找第一次出现字符串 needle(不包含空结束字符)的位置。 |
| 21 | char *strtok(char *str, const char *delim) 分解字符串 str 为一组字符串,delim 为分隔符。 |
| 22 | size_t strxfrm(char *dest, const char *src, size_t n) 根据程序当前的区域选项中的 LC_COLLATE 来转换字符串 src 的前 n 个字符,并把它们放置在字符串 dest 中。 |
C 标准库 -<time.h>
| 序号 | 函数 & 描述 |
|---|---|
| 1 | char *asctime(const struct tm *timeptr) 返回一个指向字符串的指针,它代表了结构 timeptr 的日期和时间。 |
| 2 | clock_t clock(void) 返回程序执行起(一般为程序的开头),处理器时钟所使用的时间。 |
| 3 | char *ctime(const time_t *timer) 返回一个表示当地时间的字符串,当地时间是基于参数 timer。 |
| 4 | double difftime(time_t time1, time_t time2)。 |
| 5 | struct tm *gmtime(const time_t *timer) timer 的值被分解为 tm 结构,并用协调世界时(UTC)也被称为格林尼治标准时间(GMT)表示。 |
| 6 | struct tm *localtime(const time_t *timer) timer 的值被分解为 tm 结构,并用本地时区表示。 |
| 7 | time_t mktime(struct tm *timeptr) 把 timeptr 所指向的结构转换为一个依据本地时区的 time_t 值。 |
| 8 | size_t strftime(char *str, size_t maxsize, const char *format, const struct tm *timeptr) 根据 format 中定义的格式化规则,格式化结构 timeptr 表示的时间,并把它存储在 str 中。 |
| 9 | time_t time(time_t *timer) 计算当前日历时间,并把它编码成 time_t 格式。 |
.c和.h文件在 C 语言中,通常将函数的声明和定义分别放在不同的文件中。函数的定义通常放在以.c 为后缀的源代码文件中,而函数的声明通常放在以.h 为后缀的头文件中。
.c 文件包含了函数的实现代码,它们被编译成目标代码并链接成可执行文件。.h 文件包含了函数的声明,它们告诉编译器函数的名称、参数类型和返回类型等信息,以便在编译时进行类型检查和错误检查。
因此,.c 文件和.h 文件的主要区别在于它们包含的内容不同:
当你在一个源代码文件中调用另一个源代码文件中定义的函数时,需要包含该函数的声明。这可以通过包含该函数所在的头文件来实现。
例如,如果你有一个名为 "myfunc.c" 的源代码文件,其中包含了一个名为 "myfunc" 的函数的实现代码:
// myfunc.c #include "myfunc.h" int myfunc(int a, int b) { return a + b;}你可以在一个名为 "main.c" 的源代码文件中调用 "myfunc" 函数,但是你需要包含该函数的声明。这可以通过包含 "myfunc.h" 头文件来实现:
// main.c #include "myfunc.h" int main() { int result = myfunc(1, 2); return 0;}"myfunc.h" 头文件包含了 "myfunc" 函数的声明:
c复制代码// myfunc.h int myfunc(int a, int b);这样做可以确保在编译时进行类型检查和错误检查,并且可以避免命名冲突和重复定义。
| ASCII中的0~31为控制字符;32~126为打印字符(可显示字符);127为Delete(删除)命令 | |||||||
|---|---|---|---|---|---|---|---|
| 0 | NUL(空) | 32 | (space) | 64 | @ | 96 | ` |
| 1 | SOH(头标开始) | 33 | ! | 65 | A | 97 | a |
| 2 | STX(正文开始) | 34 | " | 66 | B | 98 | b |
| 3 | ETX(正文结束) | 35 | # | 67 | C | 99 | c |
| 4 | EOT(传输结束) | 36 | $ | 68 | D | 100 | d |
| 5 | ENQ(查询) | 37 | % | 69 | E | 101 | e |
| 6 | ACK(确认) | 38 | & | 70 | F | 102 | f |
| 7 | BEL(震铃) | 39 | ' | 71 | G | 103 | g |
| 8 | BSK(backspace) | 40 | ( | 72 | H | 104 | h |
| 9 | HTK(水平制表符) | 41 | ) | 73 | I | 105 | i |
| 10 | LFK(换行/新行) | 42 | * | 74 | J | 106 | j |
| 11 | VTK(竖直制表符) | 43 | + | 75 | K | 107 | k |
| 12 | FFK(换页/新页) | 44 | , | 76 | L | 108 | l |
| 13 | CRK(回车) | 45 | - | 77 | M | 109 | m |
| 14 | SOK(移出) | 46 | . | 78 | N | 110 | n |
| 15 | SIK(移入) | 47 | / | 79 | 0 | 111 | o |
| 16 | DLE(数据链路转意) | 48 | 0 | 80 | P | 112 | p |
| 17 | DCI(设备控制1) | 49 | 1 | 81 | Q | 113 | q |
| 18 | DC2(设备控制2) | 50 | 2 | 82 | R | 114 | r |
| 19 | DC3(设备控制3) | 51 | 3 | 83 | S | 115 | s |
| 20 | DC4(设备控制4) | 52 | 4 | 84 | T | 116 | t |
| 21 | NAK(反确认) | 53 | 5 | 85 | U | 117 | u |
| 22 | SYN( 同步空闲) | 54 | 6 | 86 | V | 118 | v |
| 23 | TBK(传输块结束) | 55 | 7 | 87 | W | 119 | w |
| 24 | CAN(取消) | 56 | 8 | 88 | X | 120 | x |
| 25 | EMK(媒体结束) | 57 | 9 | 89 | Y | 121 | y |
| 26 | SUB(替换) | 58 | : | 90 | Z | 122 | z |
| 27 | ESC(转意) | 59 | ; | 91 | [ | 123 | { |
| 28 | FSK(文件分隔符) | 60 | < | 92 | \ | 124 | | |
| 29 | GSK(组分隔符) | 61 | = | 93 | ] | 125 | } |
| 30 | RSK(记录分隔符) | 62 | > | 94 | ^ | 126 | ~ |
| 31 | USK(单元分隔符) | 63 | ? | 95 | _ | 127 | DEL |
| ASCII扩展字符(EBCDIC 编码)(IBM制定)——(为了适应更多字符) 128~255,或者-128~ | |||||||
| 128(-128) | Ç | 160(-96) | á | 192(-64) | └ | 224(-32) | α |
| 129(-127) | ü | 161(-95) | í | 193(-63) | ┴ | 225(-31) | ß |
| 130(-126) | é | 162(-94) | ó | 194(-62) | ┬ | 226(-30) | Γ(γ) |
| 131(-125) | â | 163(-93) | ú | 195(-61) | ├ | 227(-29) | π |
| 132(-124) | ä | 164(-92) | ñ | 196(-60) | ─ | 228(-28) | Σ |
| 133(-123) | à | 165(-91) | Ñ | 197(-59) | ┼ | 229(-27) | σ |
| 134(-122) | å | 166(-90) | ª | 198(-58) | ╞ | 230(-26) | μ |
| 135(-121) | ç | 167(-89) | º | 199(-57) | ╟ | 231(-25) | Τ |
| 136(-120) | ê | 168(-88) | ¿ | 200(-56) | ╚ | 232(-24) | Φ |
| 137(-119) | ë | 169(-87) | ┌ | 201(-55) | ╔ | 233(-23) | Θ |
| 138(-118) | è | 170(-86) | ┐ | 202(-54) | ╩ | 234(-22) | Ω |
| 139(-117) | ï | 171(-85) | ½ | 203(-53) | ╦ | 235(-21) | δ |
| 140(-116) | î | 172(-84) | ¼ | 204(-52) | ╠ | 236(-20) | ∞ |
| 141(-115) | ì | 173(-83) | ¡ | 205(-51) | ═ | 237(-19) | φ |
| 142(-114) | Ä | 174(-82) | « | 206(-50) | ╬ | 238(-18) | ϵ |
| 143(-113) | Å | 175(-81) | » | 207(-49) | ╧ | 239(-17) | ∩ |
| 144(-112) | É | 176(-80) | ░ | 208(-48) | ╨ | 240(-16) | ≡ |
| 145(-111) | æ | 177(-79) | ▒ | 209(-47) | ╤ | 241(-15) | ± |
| 146(-110) | Æ | 178(-78) | ▓ | 210(-46) | ╥ | 242(-14) | ≥ |
| 147(-109) | ô | 179(-77) | │ | 211(-45) | ╙ | 243(-13) | ≤ |
| 148(-108) | ö | 180(-76) | ┤ | 212(-44) | Ô | 244(-12) | ⌠ |
| 149(-107) | ò | 181(-75) | ╡ | 213(-43) | ╒ | 245(-11) | ⌡ |
| 150(-106) | û | 182(-74) | ╢ | 214(-42) | ╓ | 246(-10) | ÷ |
| 151(-105) | ù | 183(-73) | ╖ | 215(-41) | ╫ | 247(-9) | ≈ |
| 152(-104) | ÿ | 184(-72) | ╕ | 216(-40) | ╪ | 248(-8) | º |
| 153(-103) | Ö | 185(-71) | ╣ | 217(-39) | ┘ | 249(-7) | • |
| 154(-102) | Ü | 186(-70) | ║ | 218(-38) | ┌ | 250(-6) | ∙ |
| 155(-101) | ¢ | 187(-69) | ╗ | 219(-37) | █ | 251(-5) | √ |
| 156(-100) | £ | 188(-68) | ╝ | 220(-36) | ▄ | 252(-4) | ⁿ |
| 157(-99) | ¥ | 189(-67) | ╜ | 221(-35) | ▌ | 253(-3) | ² |
| 158(-98) | ₧(₧) | 190(-66) | ╛ | 222(-34) | ▐ | 254(-2) | ■ |
| 159(-97) | ƒ | 191(-65) | ┐ | 223(-33) | ▄ | 255(-1) | ÿ |
| ASCII扩展字符(Windows-1252)——(为了适应更多字符) 128~255,或者-128~-1,其中,-128对应128,依次递增对应 | |||||||
| 128(-128) | € | 160(-96) | 192(-64) | À | 224(-32) | à | |
| 129(-127) | 161(-95) | ¡ | 193(-63) | Á | 225(-31) | á | |
| 130(-126) | ‚ | 162(-94) | ¢ | 194(-62) | Â | 226(-30) | â |
| 131(-125) | ƒ | 163(-93) | £ | 195(-61) | Ã | 227(-29) | ã |
| 132(-124) | „ | 164(-92) | ¤ | 196(-60) | Ä | 228(-28) | ä |
| 133(-123) | … | 165(-91) | ¥ | 197(-59) | Å | 229(-27) | å |
| 134(-122) | † | 166(-90) | ¦ | 198(-58) | Æ | 230(-26) | æ |
| 135(-121) | ‡ | 167(-89) | § | 199(-57) | Ç | 231(-25) | ç |
| 136(-120) | ˆ | 168(-88) | ¨ | 200(-56) | È | 232(-24) | è |
| 137(-119) | ‰ | 169(-87) | © | 201(-55) | É | 233(-23) | é |
| 138(-118) | Š | 170(-86) | ª | 202(-54) | Ê | 234(-22) | ê |
| 139(-117) | ‹ | 171(-85) | « | 203(-53) | Ë | 235(-21) | ë |
| 140(-116) | Œ | 172(-84) | ¬ | 204(-52) | Ì | 236(-20) | ì |
| 141(-115) | 173(-83) | 205(-51) | Í | 237(-19) | í | ||
| 142(-114) | Ž | 174(-82) | ® | 206(-50) | Î | 238(-18) | î |
| 143(-113) | 175(-81) | ¯ | 207(-49) | Ï | 239(-17) | ï | |
| 144(-112) | 176(-80) | ° | 208(-48) | Ð | 240(-16) | ð | |
| 145(-111) | ‘ | 177(-79) | ± | 209(-47) | Ñ | 241(-15) | ñ |
| 146(-110) | ’ | 178(-78) | ² | 210(-46) | Ò | 242(-14) | ò |
| 147(-109) | “ | 179(-77) | ³ | 211(-45) | Ó | 243(-13) | ó |
| 148(-108) | ” | 180(-76) | ´ | 212(-44) | Ô | 244(-12) | ô |
| 149(-107) | • | 181(-75) | µ | 213(-43) | Õ | 245(-11) | õ |
| 150(-106) | – | 182(-74) | ¶ | 214(-42) | Ö | 246(-10) | ö |
| 151(-105) | — | 183(-73) | Æ | 215(-41) | × | 247(-9) | ÷ |
| 152(-104) | ˜ | 184(-72) | ¸ | 216(-40) | Ø | 248(-8) | ø |
| 153(-103) | ™ | 185(-71) | ¹ | 217(-39) | Ù | 249(-7) | ù |
| 154(-102) | š | 186(-70) | º | 218(-38) | Ú | 250(-6) | ú |
| 155(-101) | › | 187(-69) | » | 219(-37) | Û | 251(-5) | û |
| 156(-100) | œ | 188(-68) | ¼ | 220(-36) | Ü | 252(-4) | ü |
| 157(-99) | 189(-67) | ½ | 221(-35) | Ý | 253(-3) | ý | |
| 158(-98) | ž | 190(-66) | ¾ | 222(-34) | Þ | 254(-2) | þ |
| 159(-97) | Ÿ | 191(-65) | ¿ | 223(-33) | ß | 255(-1) | ÿ |
!= NULL 和 != EOF!= NULL 和 != EOF 是两种不同的比较方式,它们用于不同的上下文。
!= NULL:这个比较通常用于检查指针是否为空。在 C 语言中,指针变量可以包含空值(NULL),表示指针不指向任何有效的内存位置。因此,当我们想要检查一个指针是否为空时,可以使用 != NULL。比如,ptr != NULL 表示指针 ptr 不为 NULL。
示例代码:
int* ptr = NULL;if (ptr != NULL) { // 指针不为空} else { // 指针为空}!= EOF:这个比较通常用于检查文件读取操作是否成功。在 C 语言中,EOF 是一个特殊的宏,表示文件结束符。当我们使用类似 fgetc 或 fgets 等函数从文件中读取字符时,它们会返回读取的字符或 EOF。因此,在读取文件时,我们可以用 != EOF 来检查读取操作是否成功。
示例代码:
FILE* file = fopen("data.txt", "r");int ch;while ((ch = fgetc(file)) != EOF) { // 成功读取一个字符}总结来说,!= NULL 用于指针是否为空的判断,而!= EOF则用于文件读取操作是否成功的判断。它们分别适用于不同的场景和目的。
systemsystem函数 (位于 <stdlib.h> 头文件中)
//cls (clear+s 清理+复数)清屏system("cls")//color 改颜色system("color 0f")//第一个0~f为背景色,第二个为文字颜色,若只有一个字符,则是文字颜色)| 0=黑色 | 1 =蓝色 | 2 =绿色 | 3 =浅蓝色 | 4=红色 | 5 =紫色 | 6 =黄色 | 7=白色 |
|---|---|---|---|---|---|---|---|
| 8 =灰色 | 9 =淡蓝色 | a=淡绿色 | b =淡浅绿色 | c=淡红色 | d=淡紫色 | e=淡黄色 | f=亮白色 |
randrand 产生随机数(random 随机)(伪随机数生成函数)
用rand()时要如此用:
int a;srand((unsigned)time(NULL));a=rand();//其中,//srand()是用于初始化随机数发生器的种子,这里用于获取当前时间值为数值的种子,//括号中的是种子;// unsigned:无符号的;// NULL空值(这里也可改成0);// time()调用现在的时间。 //或写成:srand(time(0));int a=rand();有返回值的意思是它可以放在表达式中
scanf的返回值是输入数据的个数(就是几个%)
分享你的想法,与大家交流讨论
Twikoo 加载失败
Twikoo 脚本加载失败