ACM算法比赛做题小技巧笔记
发布于 2026-04-06更新于 2026-11-141092 字14 分钟 · 阅读时间
#include <iostream>#include <algorithm> int main() { int array[] = {1, 2, 3, 4, 5}; if (std::is_sorted(array, array + 5)) { std::cout << "数组已按升序排列" << std::endl; } else { std::cout << "数组未按升序排列" << std::endl; } return 0;} 加法(a+b)与异或(a^b)的奇偶性相同
一直将一个数相减,就是指相除或求余
// 从第零个开始执行,但第零个默认执行,其他的要根据第二个判断来判断if (!i || /*条件2*/ )tuple 与 pair
加上一个负数,肯定比原数小,
// 如果sum<0: sum=0,sum+=a[i] > sum+=a[i]for(int i=0;i<n;i++){ cin>>x>>y;// 普通左边,横坐标向右,竖坐标向下 a[x-y+MAXNN]++;// 左下到右上的对角线坐标 b[x+y-1]++;// 左上到右下的对角线坐标}// MAXNN为这个正方形网格的边长,记得要从1开始,对角线数组的长度>2*边长+10 比较好打比赛时要关了 copilot 他在干扰思路方面远远大于补充的作用,学习等时候再打开(副驾驶只是辅助(学习)的,但要是直接去开车的话,有个人在旁边哔哔哔,可能会扰乱思路)
有时候,要假设某种最低限度的情况是否成立,如果成立,则也成立,这也是一种贪心呀
还有分开一个数的时候,不仅仅只有二分,还有平均分。平均分分的个数有时候要小于二分的 (前一个数要小于后一个数(任意分两瓣的犯法))
还有,如果一个题一直错,要想想是不是自己的思路错了,而不是一直犟着同一种思路不放
数组是先行后列 a[i][j] ,i 表示行,j 表示列
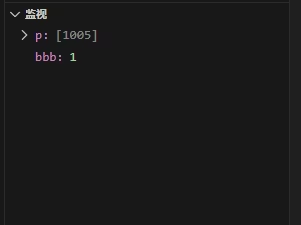
// 行是三行排,之前把列与行的定义搞反了// 反正记住二维数组是先竖着多少个,然后横着多少个int main(){ int a[3][4] ={ {1,2,3,4}, {3,4,5,5}, {67,3,9,6} }; for(int i=0;i<3;i++) { for(int j=0;j<4;j++) cout<<a[i][j]<<' '; cout<<endl; } return 0;}// 输出:1 2 3 43 4 5 567 3 9 6VSCode 中可以通过“调试”中的“监视”中,添加全局变量名称来查看它(数组也写变量名即可)
模运算性质
(a+b)%n = (a%n + b%n)%n
``(ab)%n = ((a%n)(b%n))%n`
逆元
逆元是数学中的一个概念,主要在代数和数论中使用。在模运算中,给定一个整数 a 和一个正整数 n,如果存在一个整数 b,使得 (a*b) mod n = 1,那么我们就说 b 是 a 模 n 的乘法逆元
如:
ParseError: KaTeX parse error: Undefined control sequence: \* at position 13: \begin{align\̲*̲}\label{2} & ∵(…
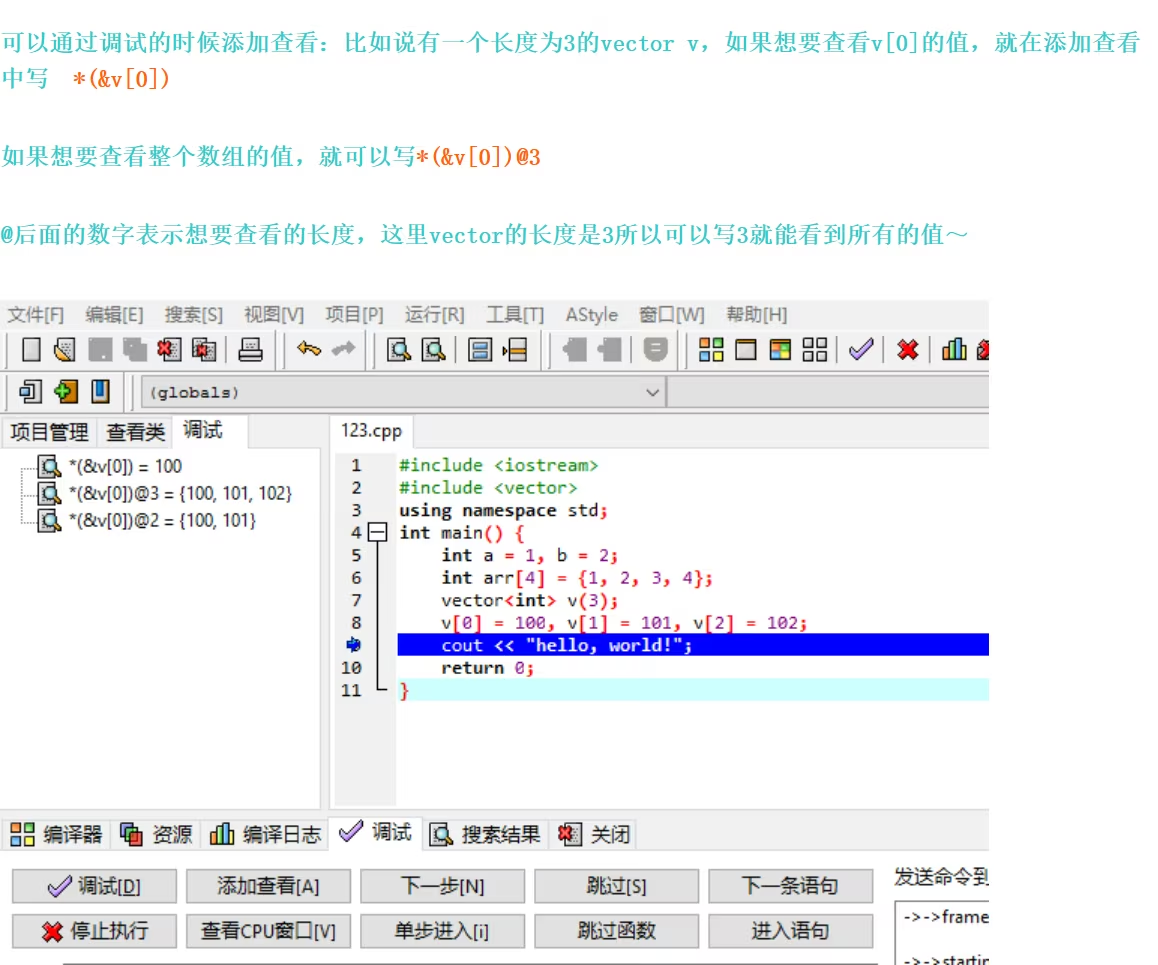
使用 Dev-C++查看 vector 数组中的变量值
vector<int> a[100000];// 就是邻接表辣~//它声明了一个名为 a 的数组,数组中有 100,000 个元素,每个元素都是一个 vector<int> 类型的对象lcm 与 gcd 算法的两个数输入是没有顺序的
如何在 DevC++中使用 g++11
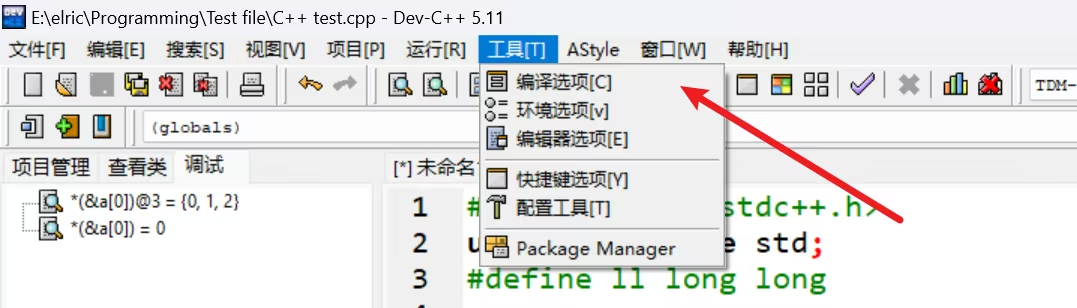
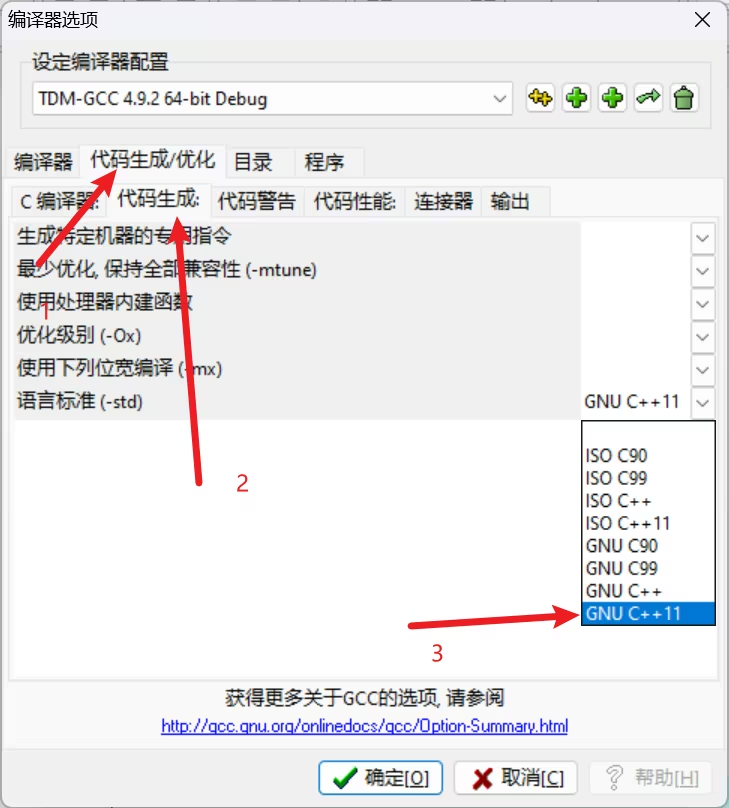
int match[MAXN];// 下面的是同一个意思memset(match, -1, sizeof(match)); fill(match, match + MAXN, -1);fill_n(match, MAXN, -1);对于std::vector,它的迭代器支持以下几种操作:
++和--:这两个操作分别用于将迭代器向前或向后移动一个位置。例如,如果it是一个迭代器,那么++it会将it向前移动一个位置,--it会将it向后移动一个位置。+和-:这两个操作用于将迭代器向前或向后移动多个位置。例如,it + n会返回一个新的迭代器,这个迭代器指向it当前指向的元素后面的第 n 个元素。同样,it - n会返回一个新的迭代器,这个迭代器指向it当前指向的元素前面的第 n 个元素。*:这个操作用于获取迭代器当前指向的元素的引用。例如,*it就是it当前指向的元素。==和!=:这两个操作用于比较两个迭代器是否相等。如果两个迭代器指向同一个元素,那么它们相等;否则,它们不相等若要对负数取模,都要先+mod,再%mod
mp.erase(s);和mp[t].clear()有什么区别
mp.erase(s);和mp[t].clear();这两个操作在 C++中的std::map上有着不同的含义和效果。
mp.erase(s);是用来删除键为s的元素。如果mp中存在键为s的元素,那么这个元素会被删除,mp的大小会减 1。如果mp中不存在键为s的元素,那么这个操作不会有任何效果。
std::map<int, int> mp;mp[1] = 100;mp[2] = 200;mp.erase(1); // 删除键为1的元素mp[t].clear();这个操作首先会找到键为t的元素,然后调用这个元素的clear方法。这个操作通常用于std::map的值是容器(如std::vector,std::string等)的情况。如果mp中不存在键为t的元素,那么会插入一个键为t的元素,然后调用这个新插入元素的clear方法。
std::map<int, std::vector<int>> mp;mp[1] = {100, 200, 300};mp[1].clear(); // 清空键为1的元素的值如果mp的值不是容器,那么mp[t].clear();这个操作可能会导致编译错误,因为不是所有的类型都有clear方法。
最大公因数又叫最大公约数,这样就好理解了
二维都变长的二维容器数组
1、在 C++中,可以这样初始化一个二维 vector 数组并指定大小:
cppvector<vector<int>> vec(3, vector<int>(4));这个代码会创建一个 3 行 4 列的二维 vector 数组,每个元素初始化为 0:vec =
[0 0 0 0]
[0 0 0 0]
[0 0 0 0]
2、你也可以在初始化时指定每个元素的值:
cppvector<vector<int>> vec(3, vector<int>(4, 1));这个会创建一个 3 行 4 列的二维 vector,每个元素初始化为 1:vec =
[1 1 1 1]
[1 1 1 1]
[1 1 1 1]
3、如果你想指定每个 vector 的大小,并手动初始化每个元素,可以这样写:
cppvector<vector<int>> vec;vec.resize(3); // 3行 vec[0].resize(4); // 第一行4列vec[0] = {1, 2, 3, 4}; vec[1].resize(2); // 第二行2列vec[1] = {5, 6}; vec[2].resize(3); // 第三行3列vec[2] = {7, 8, 9};这个会创建:
vec =
[1 2 3 4]
[5 6 0 0]
[7 8 9 0]
总结
所以总结一下,初始化一个二维 vector 数组并指定大小的方法有:
一维长度固定,二维长度可变的二维容器数组
vector
// 初始化一个一维长度为3的vectorvector<vector<int>> vec(3); // 为每个一维vector初始化不同长度vec[0] = vector<int>(5);vec[1] = vector<int>(10);vec[2] = vector<int>(2); // 打印vecfor (int i = 0; i < vec.size(); ++i) { for(int j = 0; j < vec[i].size(); ++j) { cout << vec[i][j] << " "; } cout << endl;}补充:一维容器的初始化
vector<int> v(n)`表示声明一个容器v,并给他预定存储空间。每一个单元初始化为0,因此,`vector<int> v(n)`也等同于`vector<int> v(n, 0)`。当然,如果想要初始化为其他值,也可以改为`vector<int> v(n, val)vector
cout << v.size() << endl;
for (int i = 0; i < v.size(); i++) {
cout << v[i] << " ";
}
cout << endl;
vector
for (int i = 0; i < w.size(); i++) {
cout << w[i] << " ";
}
获取一个数组中最大值
int maxsize = *max_element(a.begin(), a.end());=============================================================std::vector<int> v = {1, 2, 3, 4, 5};auto max_iter = std::max_element(v.begin(), v.end());int max_value = *max_iter;std::cout << max_value << std::endl; // 输出:5gcd(a, b, c) = gcd(gcd(a, b), c)
next_permutation 是 C++ 标准库中的一个函数,它用于重新排列范围内的元素,以生成下一个字典序更大的排列。如果能够生成这样的排列,则函数返回 true;如果这已经是最大的排列(即没有更大的排列),则函数重新排列为最小的排列(字典序最小)并返回 false。
这个函数通常用于生成给定序列的所有排列,或者在需要按字典序处理序列的情况下找到下一个排列。
函数原型如下:
bool next_permutation(BidirectionalIterator first, BidirectionalIterator last);这里,first 和 last 是双向迭代器,分别指向序列的开始和结束。
使用 next_permutation 的一个简单示例:
#include <algorithm>#include <vector>#include <iostream> int main() { std::vector<int> vec = {1, 2, 3}; do { for (int num : vec) { std::cout << num << " "; } std::cout << "\n"; } while (std::next_permutation(vec.begin(), vec.end())); return 0;}这段代码会打印出向量 {1, 2, 3} 的所有排列:
1 2 31 3 22 1 32 3 13 1 23 2 1next_permutation "c:/TDM-GCC-64/lib/gcc/x86_64-w64-mingw32/10.3.0/include/c++/bits/stl_algo.h") 通过比较和交换元素来工作,不需要额外的存储空间。
在5~10分钟之内可以快速的编写 直接的模拟
在5~10分钟之内可以快速的编写 暴力思路
在纸上或大脑中将问题分为某些情况 (n=2,n=3,n>=4)
一道题15分钟都找不到解决方案就去换下一题
acwing算法基础课的内容就已经足够到1900分cf了(大一上的知识点)
想上高分主要是要多刷对应分值的题
线段树及以上的中阶算法可以让你从1900上到2200分
这时想要上分就要多去打虚拟赛
这时还要多备用一些算法模板库,越全越好(要自己写的)
要在div1比赛中成功解决只有不到100人才能解决的难题
最少要解决4000道题
每周最少思考一次许多较为困难的问题
训练赛咋样无所谓,重要是做题
心理问题是竞争对手竞争中最常见的问题之一。即使对我来说,直到2个月前,因为害怕在一场比赛中降低100+评分,我在超过9个月的时间里不能参加任何CF评分比赛。此外,有几个比赛,我甚至不能阅读后面的问题,因为我不能解决更容易的问题,失去了我的冷静。
错误也是一个很好的学习机会,没有一个人不会犯任何错误。甚至连游
客在AtCoder世界巡回赛决赛中也犯了一个错误。
总之,不要在比赛中有太多的压力,玩得开心!
每天2~3h的虚拟赛
每周一次,从2200~2800中选择5个问题,并在2~4h中解决
分享你的想法,与大家交流讨论
Twikoo 加载失败
Twikoo 脚本加载失败